
เปิดตัว OlmoEarth: แพลตฟอร์มวิเคราะห์ข้อมูลดาวเทียมระดับโลกด้วย AI สเกลระดับทวีป
🌍 เรียนรู้เพิ่มเติมเกี่ยวกับแพลตฟอร์ม OlmoEarth: https://allenai.org/olmoearth
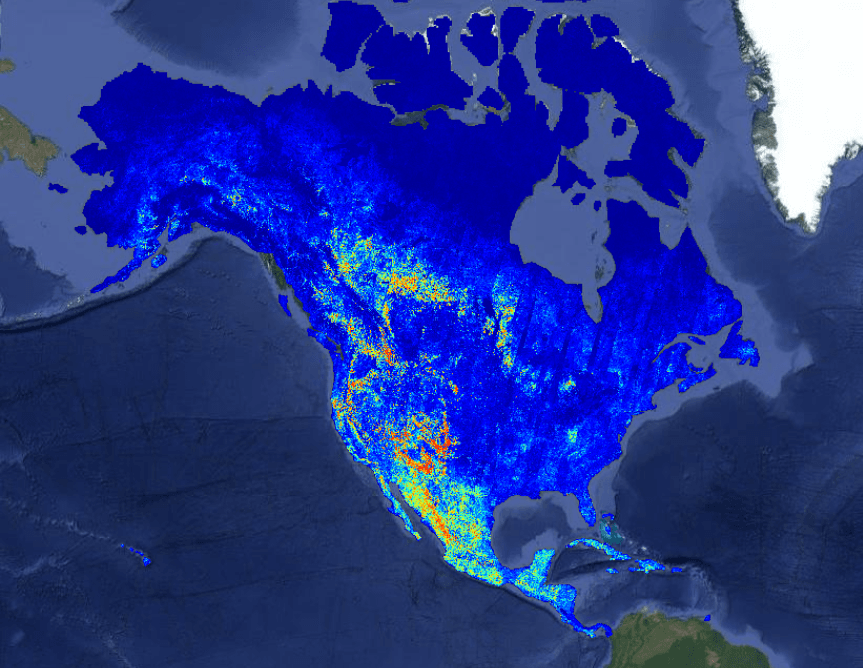
โมเดล OlmoEarth คือตระกูลโมเดลพื้นฐานเพื่อการสำรวจโลก (Earth observation) ที่ผ่านการฝึกฝนเบื้องต้นด้วยข้อมูลดาวเทียมแบบต่อเนื่อง (Multimodal) ขนาด 10 เทราไบต์ ปัจจุบันรัฐบาลและองค์กร NGO หลายแห่งเริ่มนำ OlmoEarth ไปปรับใช้ในงานสำคัญ เช่น การตรวจสอบการตัดไม้ทำลายป่า ความมั่นคงทางอาหาร และการประเมินความเสี่ยงจากไฟป่า
ที่ Ai2 เรามีความเชี่ยวชาญในการสร้างและปล่อยโมเดลโอเพนซอร์สที่ทรงพลัง แม้องค์กรที่มีวิศวกรเก่งๆ จะนำโมเดลไปใช้ต่อได้ทันที แต่สำหรับองค์กรด้านสิ่งแวดล้อมส่วนใหญ่ซึ่งเป็นกลุ่มเป้าหมายหลัก กลับขาดแคลนโครงสร้างพื้นฐานในการจัดการวงจรชีวิตของงานทั้งหมด ตั้งแต่การทำ Labeling ข้อมูล การทำ Fine-tuning ไปจนถึงการประมวลผลขนาดใหญ่ (Inference)
จากประสบการณ์กว่าทศวรรษในการบริหารแพลตฟอร์มอย่าง Skylight และ EarthRanger เราได้เรียนรู้ว่าการสร้างผลลัพธ์ที่ใช้งานได้จริงต้องอาศัยการรันโมเดลที่คุ้มค่า การตรวจสอบประสิทธิภาพที่แม่นยำ และการเปลี่ยนข้อมูลดิบให้เป็นข้อมูลเชิงลึกที่นำไปปฏิบัติได้จริง
นี่คือเหตุผลที่เราสร้าง แพลตฟอร์ม OlmoEarth ขึ้นมาเพื่อเป็นโครงสร้างพื้นฐานที่เปลี่ยนโมเดลภูมิสารสนเทศจากการทดสอบในห้องแล็บ ไปสู่การใช้งานจริงในสเกลระดับโลก
การประมวลผลในระดับนี้มีความท้าทายเฉพาะตัว เพราะต้องดึงภาพถ่ายจากผู้ให้บริการหลายราย ปรับตำแหน่งพิกัดและความละเอียดที่แตกต่างกันให้ตรงกัน ก่อนจะนำผลลัพธ์มาเย็บรวมเป็นแผนที่เดียวกันอย่างต่อเนื่อง โดยระบบต้องรองรับความล้มเหลวที่อาจเกิดขึ้นจากการประมวลผลแบบกระจายตัว (Distributed computing) ได้ตลอดเวลา
ปัจจุบันแพลตฟอร์มสามารถรันการประมวลผลครอบคลุมพื้นที่ระดับทวีปได้ภายในเวลาประมาณหนึ่งวัน โดยประมวลผลข้อมูลภาพหลายสิบเทราไบต์ด้วยต้นทุนเพียงเศษเสี้ยวของเพนนีต่อตารางกิโลเมตร ซึ่งถือเป็นการก้าวข้ามขีดจำกัดทางวิศวกรรมที่ระบบภูมิสารสนเทศขนาดใหญ่ส่วนใหญ่มักประสบ
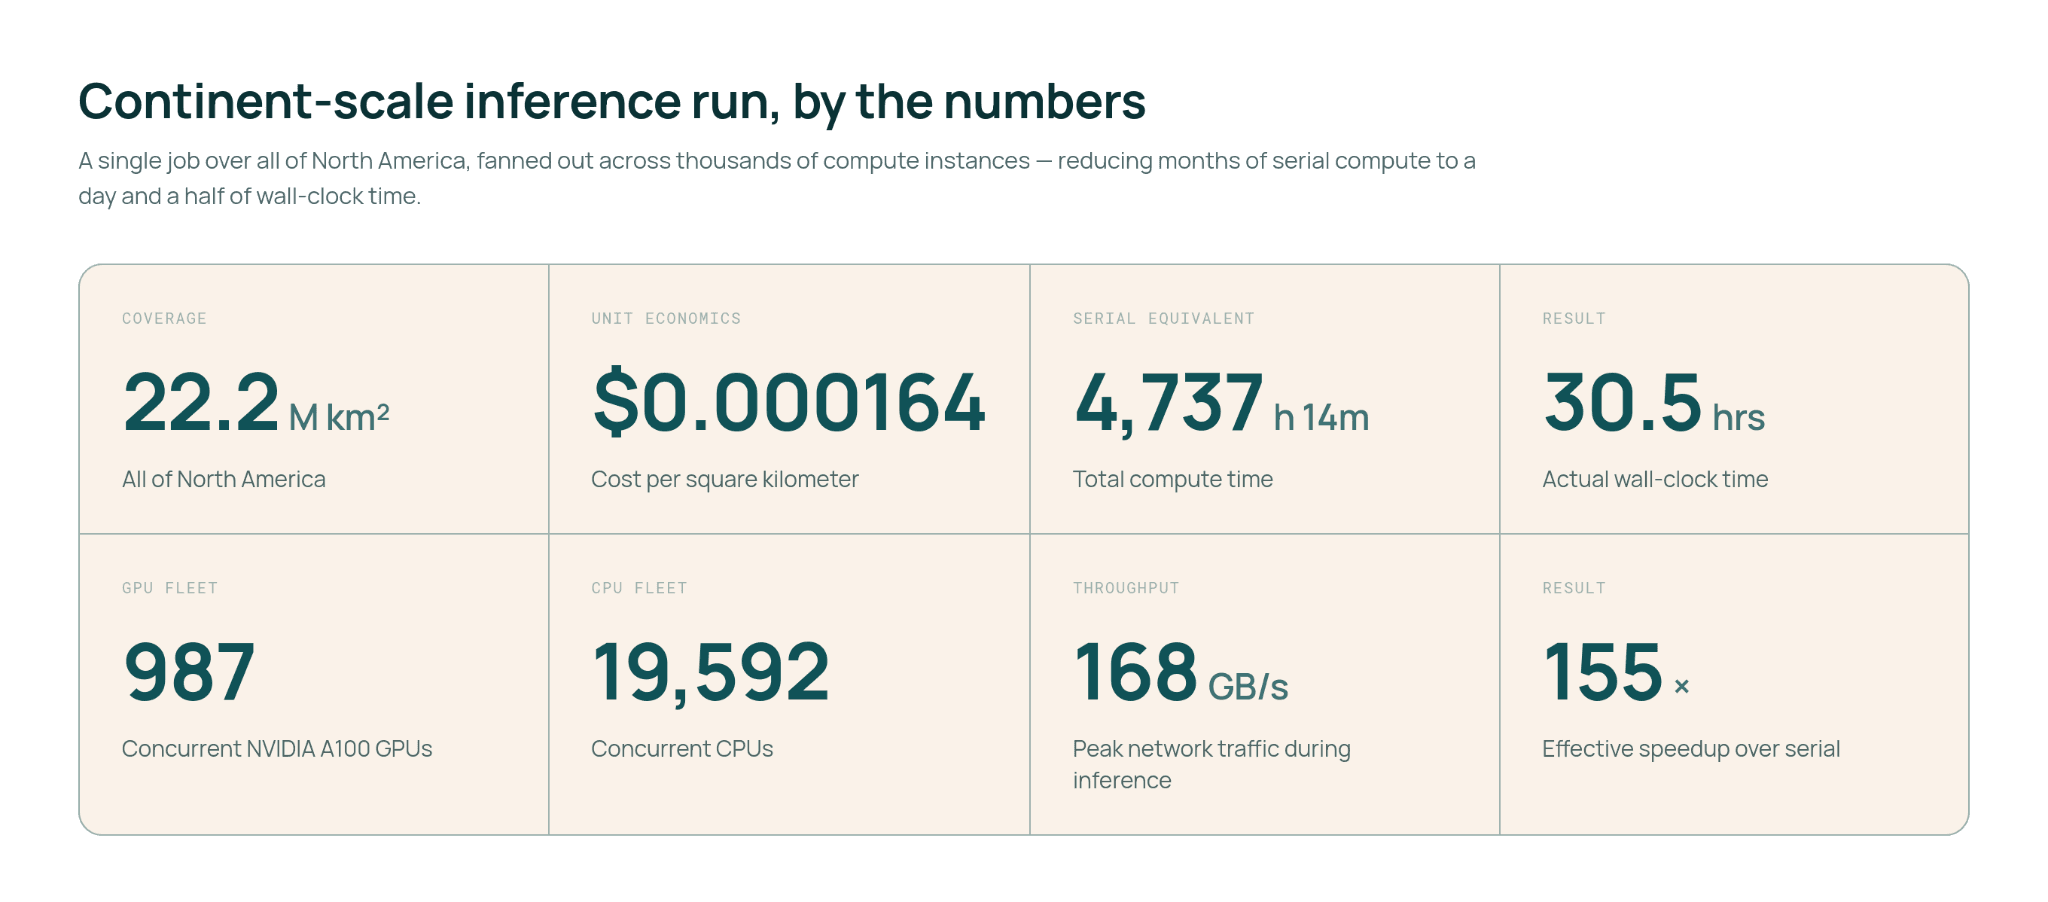
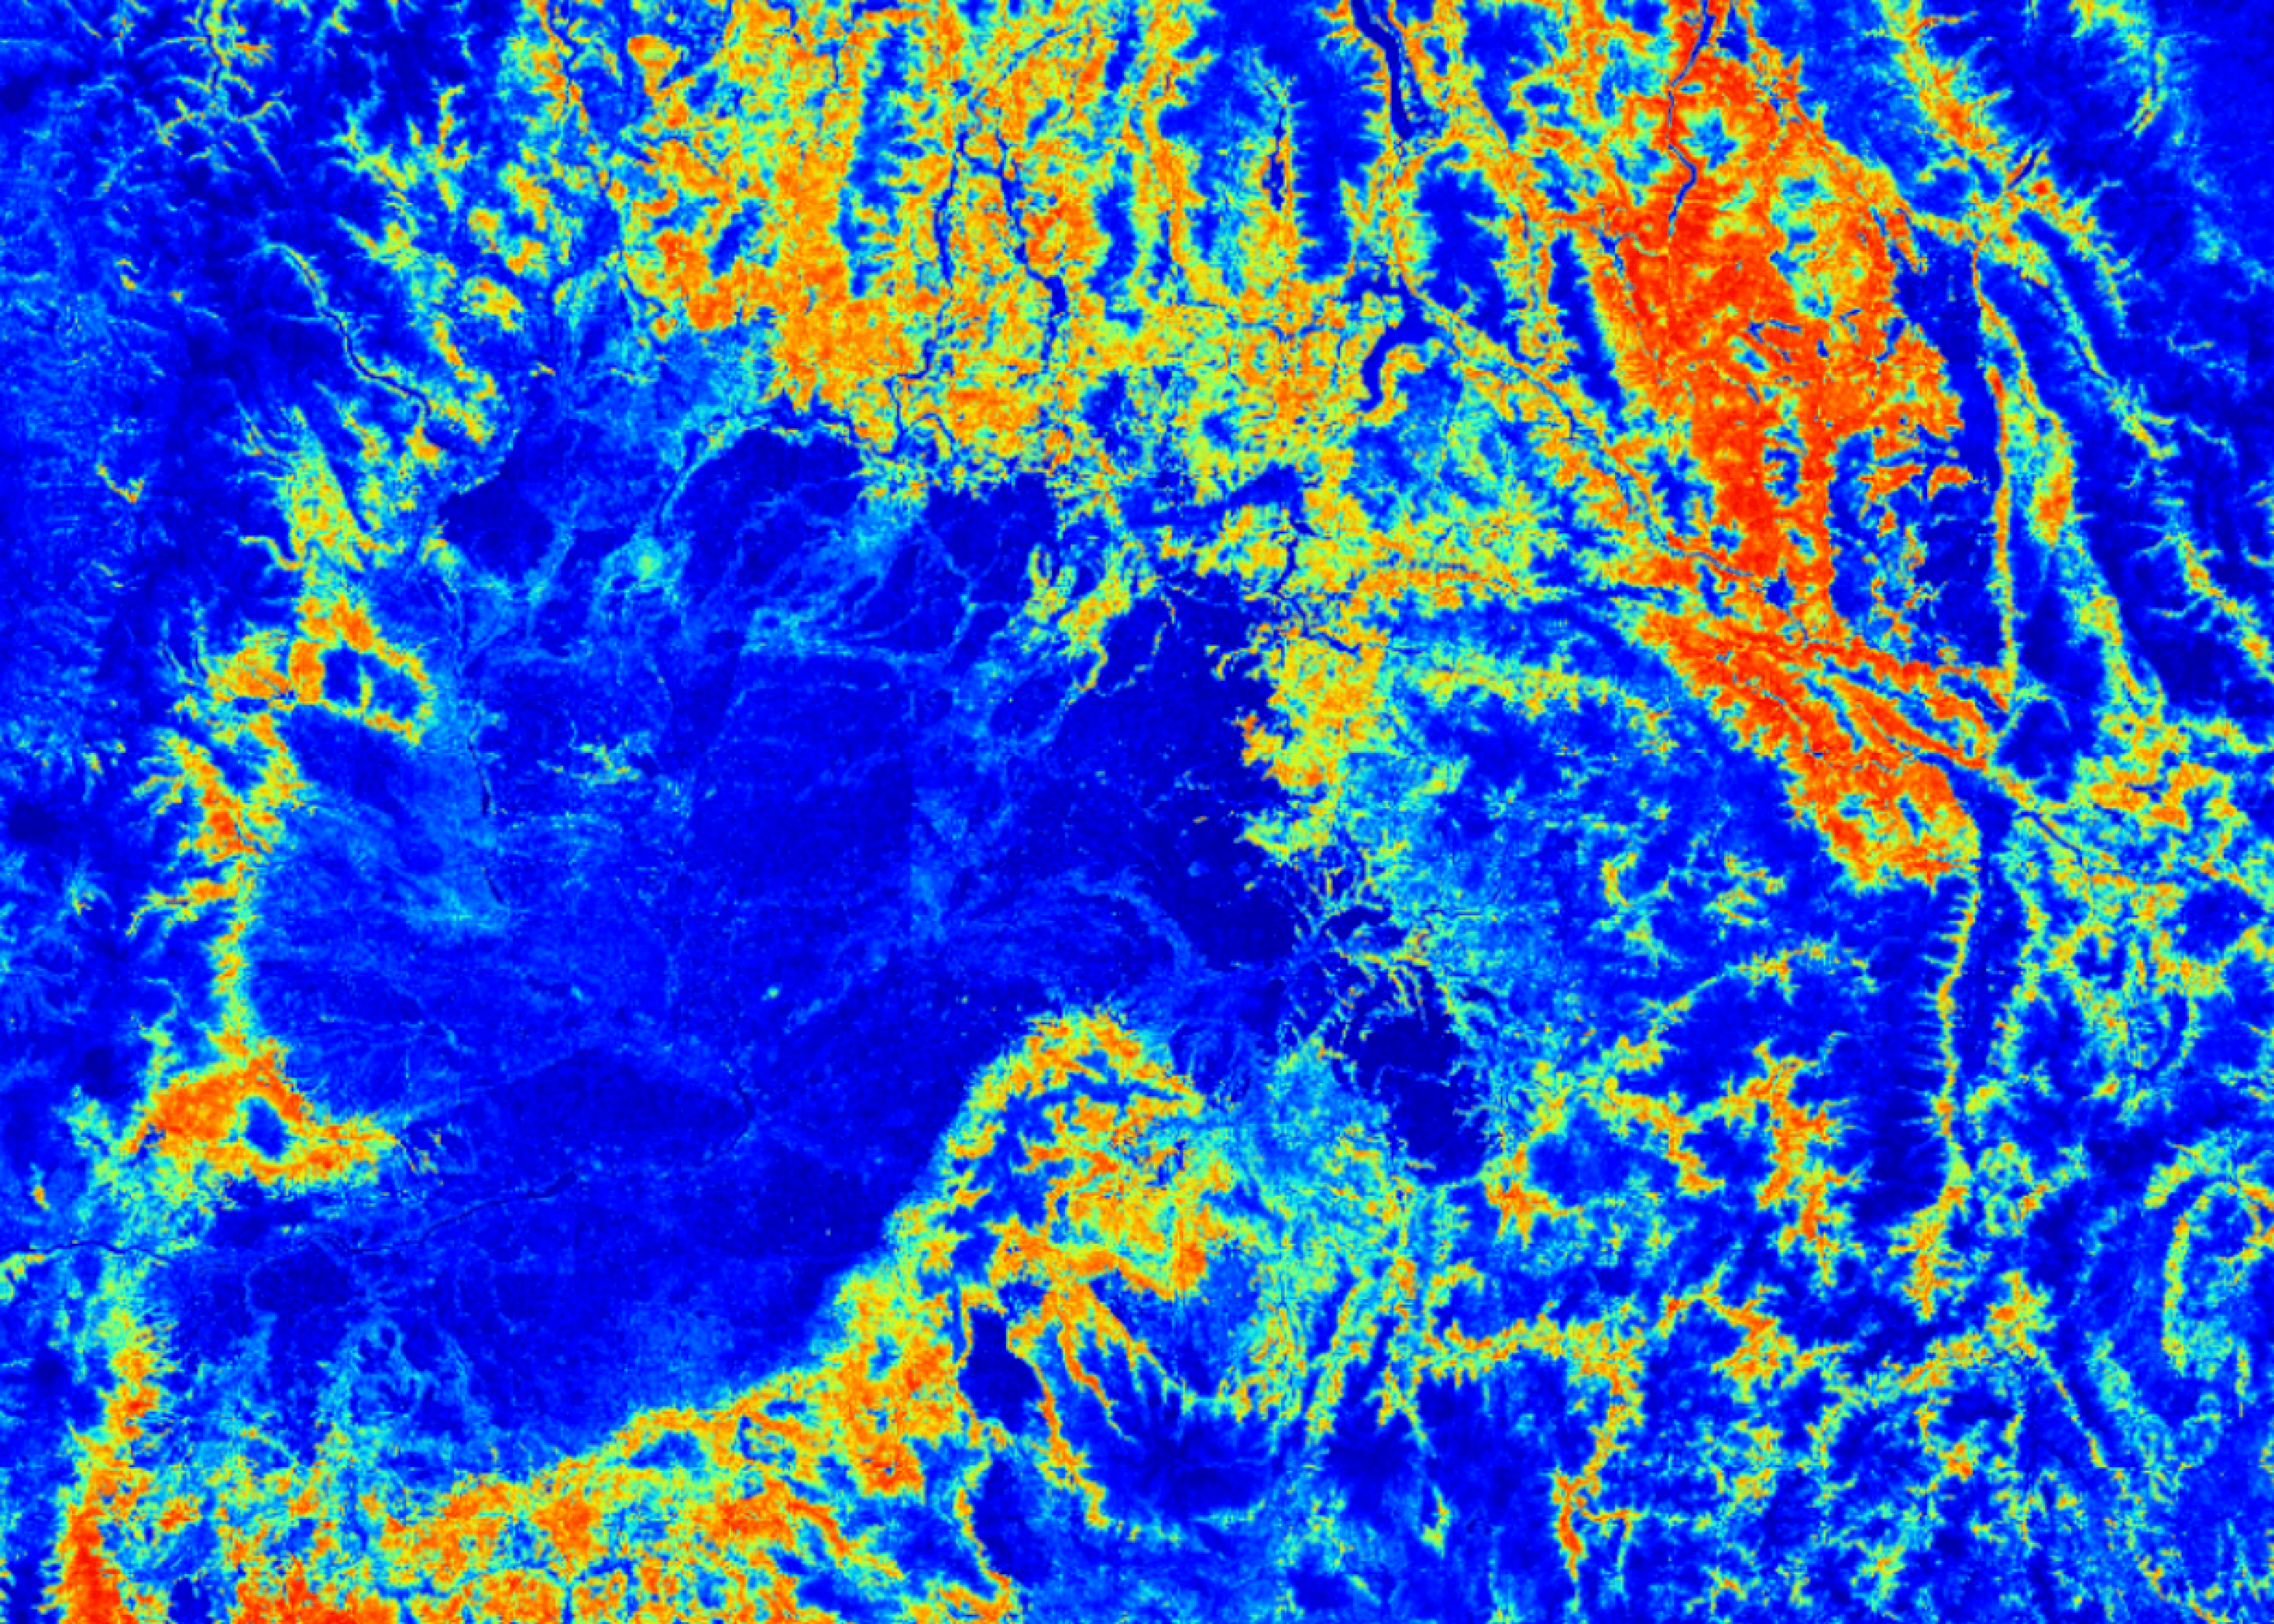
แผนที่ความเสี่ยงจากไฟป่าล่าสุดที่สร้างขึ้นบนแพลตฟอร์ม OlmoEarth พร้อมสถิติ
ทำไมการอนุมานข้อมูลดาวเทียมถึงมีความท้าทาย
โมเดล ML ทั่วไปอาจประมวลผลข้อมูลเพียงไม่กี่เมกะไบต์ แต่การสำรวจโลกทำงานในสเกลที่ต่างออกไป งานหนึ่งอาจต้องเคลื่อนย้ายข้อมูลหลายเทราไบต์และใช้เวลารันนานหลายชั่วโมง ข้อมูลนำเข้ามีทั้งย่านความถี่สเปกตรัมที่หลากหลาย ประเภทเซนเซอร์ที่ต่างกัน และปัญหาข้อมูลขาดหายจากเมฆบดบัง โดยผลลัพธ์สุดท้ายที่เป็นแผนที่ต้องมีความสอดคล้องแม่นยำในทุกพิกัด
แม้แต่การดึงข้อมูลก็เป็นอุปสรรคใหญ่ เพราะบ่อยครั้งขั้นตอนการดาวน์โหลดและเตรียมรูปภาพใช้เวลานานกว่าการรันโมเดลจริงเสียอีก ดังนั้นไปป์ไลน์ข้อมูลที่มีประสิทธิภาพจึงสำคัญมาก เพื่อรองรับ I/O ปริมาณมหาศาลพร้อมกับพลังประมวลผลในการปรับพิกัด (Reproject) และสุ่มตัวอย่างภาพใหม่ (Resample)
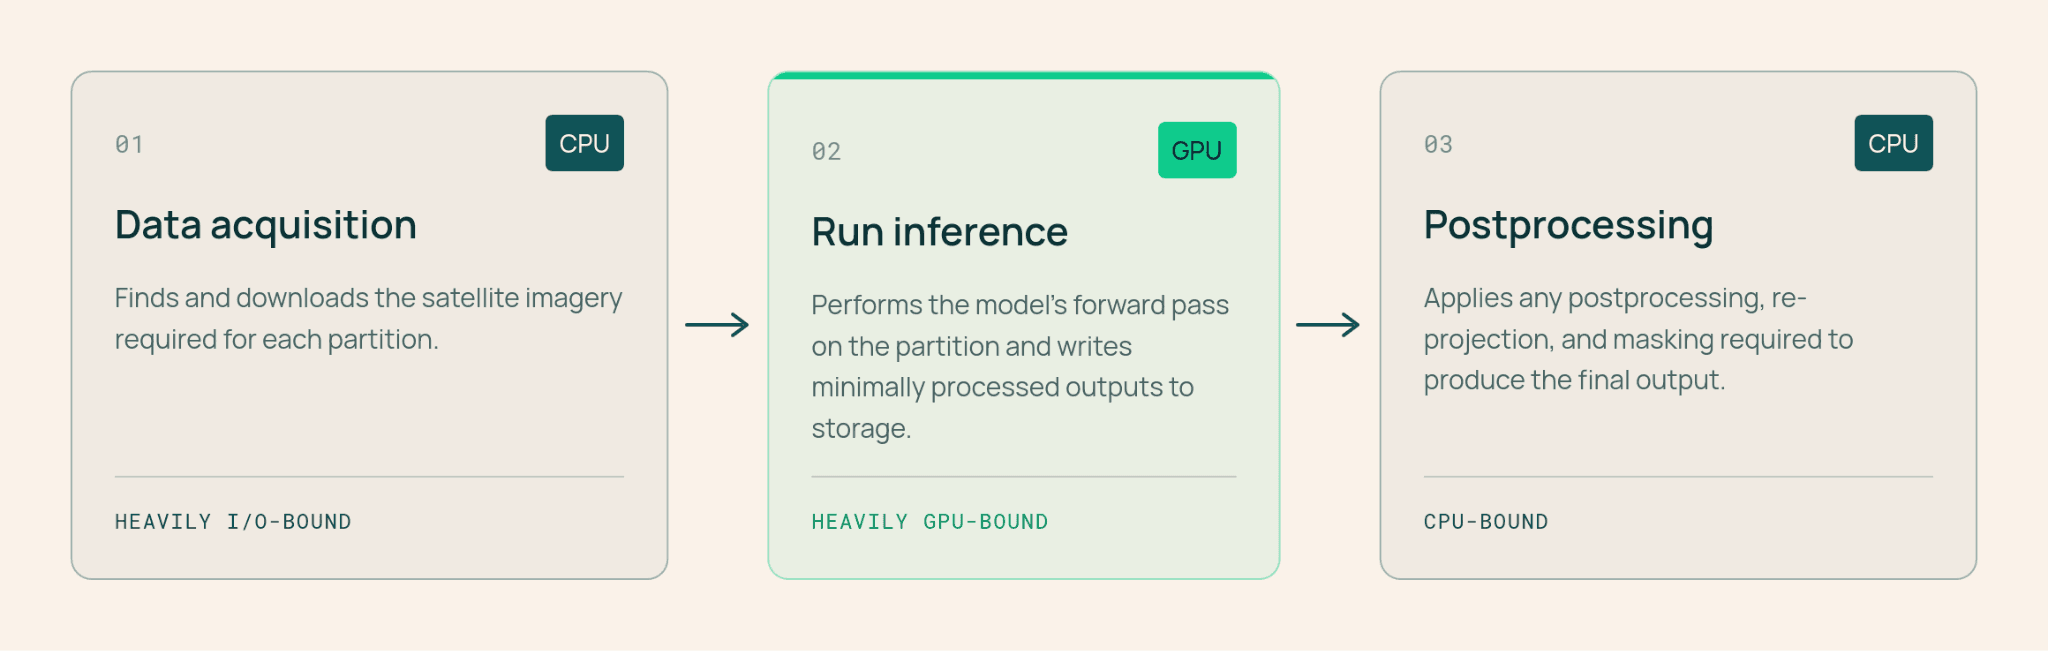
ฮาร์ดแวร์ที่เหมาะสมสำหรับงานที่เหมาะสม เพื่อไม่ให้ GPU ซึ่งเป็นฮาร์ดแวร์ราคาแพงต้องมาเสียเวลาทำงานที่ CPU ทำได้ดีกว่า เราจึงแบ่งงานออกเป็น 3 ขั้นตอนตามประเภทฮาร์ดแวร์:
- การเตรียมข้อมูล (CPU, I/O สูง): ดึงข้อมูล ปรับพิกัด และแปลงค่าภาพให้เป็นมาตรฐาน
- การอนุมาน (GPU): รันโมเดลและบันทึกผลลัพธ์เบื้องต้นลงหน่วยจัดเก็บข้อมูลโดยตรง
- การประมวลผลหลังการอนุมาน (CPU): เย็บผลลัพธ์เข้าด้วยกันและส่งออกในรูปแบบที่ใช้งานง่าย เช่น Zarr, GeoTIFF หรือ GeoJSON
แพลตฟอร์ม OlmoEarth จะกระจายงานเหล่านี้ไปยังเครื่องจำนวนมากเพื่อให้ GPU ทำงานเต็มประสิทธิภาพตลอดเวลา โดยมีการสตรีมข้อมูลไปยัง Blob storage โดยตรง
ระบบประมวลผลแบบขนานนับพันชุด
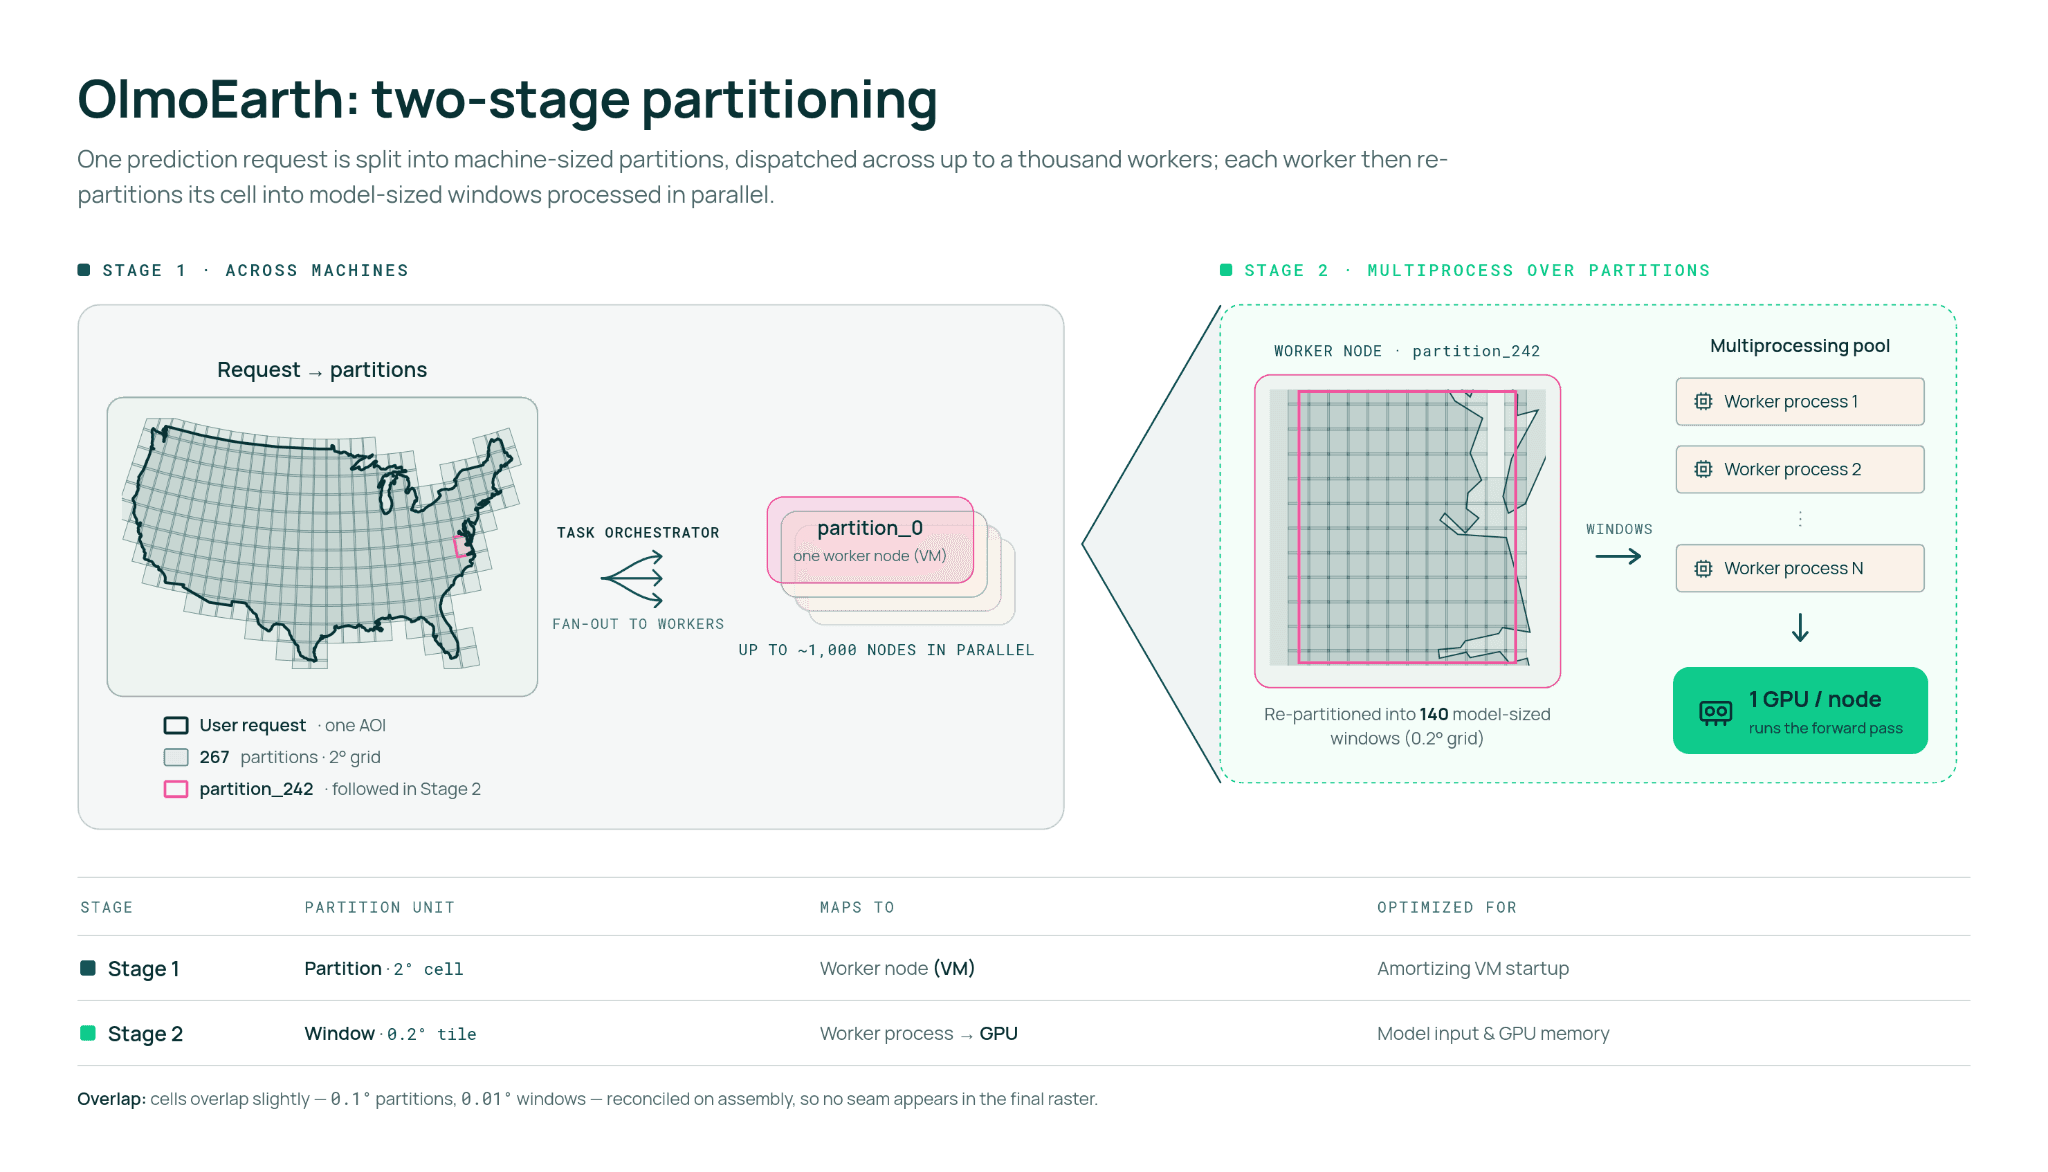
OlmoEarth Run จะแบ่งพื้นที่ภูมิศาสตร์ออกเป็นส่วนย่อยๆ (Partitions) ที่เหมาะกับเครื่องประมวลผลแต่ละเครื่อง จากนั้นแบ่งย่อยลงไปอีกเป็นหน้าต่างขนาดเล็กที่โมเดลสามารถจัดการได้ ทำให้สามารถรันงานในส่วนต่างๆ ของแผนที่พร้อมกันได้โดยไม่ต้องรอกัน
ในการรันระดับทวีป ระบบสามารถกระจายงานไปยังอินสแตนซ์ประมวลผลนับพันได้พร้อมกัน ตัวอย่างเช่น การสร้างแผนที่ความเสี่ยงไฟป่าในอเมริกาเหนือล่าสุด เราใช้ CPU กว่า 19,600 ตัว และ GPU 994 ตัว ทำงานคู่ขนานกัน ช่วยลดเวลาประมวลผลจากที่คาดการณ์ไว้ 4,737 ชั่วโมง เหลือเพียง 30.5 ชั่วโมง หรือเร็วขึ้นถึง 155 เท่า
อย่างไรก็ตาม การขยายตัว (Fan-out) ต้องมีการปรับสมดุลตามโควต้าคลาวด์และงบประมาณ โดยผู้ใช้สามารถปรับแต่งความละเอียดของข้อมูล ขนาดโมเดล และการทำแคช เพื่อให้เหมาะสมกับความต้องการและค่าใช้จ่าย
การดึงข้อมูลพิกเซลที่แม่นยำ
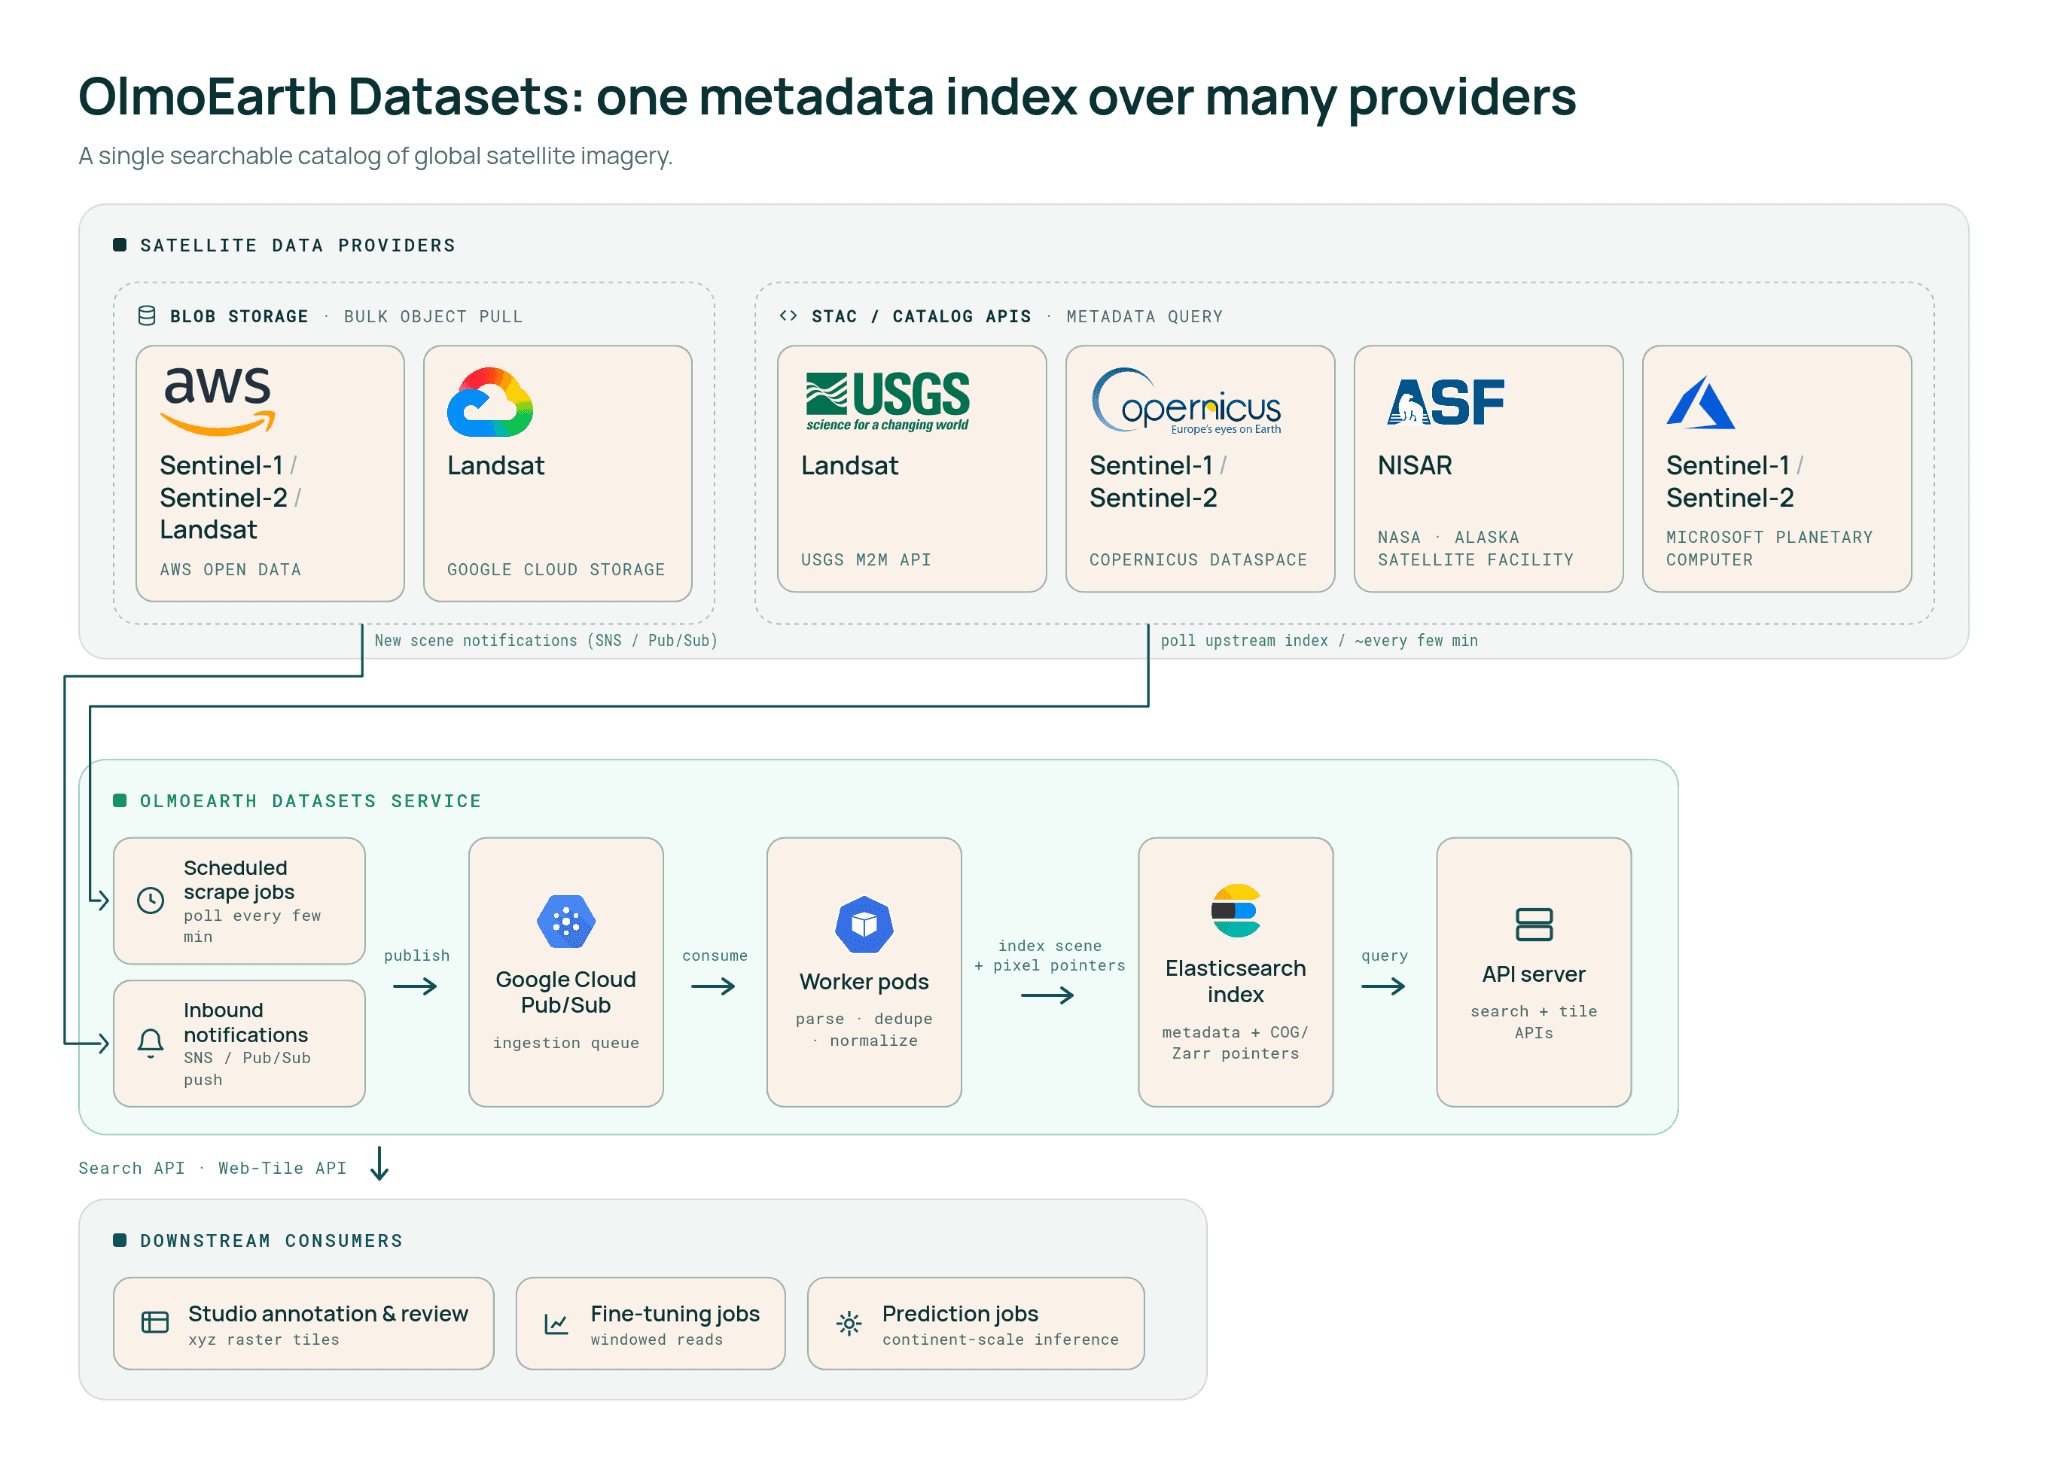
อันดับแรกแพลตฟอร์มต้องระบุว่าฉากดาวเทียมใดที่ควรนำมาใช้ โดยพิจารณาจากเกณฑ์ต่างๆ เช่น ปริมาณเมฆน้อยที่สุดสำหรับภาพถ่ายเชิงแสง หรือช่องสัญญาณโพลาไรเซชันสำหรับภาพเรดาร์ เนื่องจากงานสเกลใหญ่มีการดึงข้อมูลมหาศาล OlmoEarth จึงสร้างดัชนีเมทาดาทา (Metadata index) ของตัวเองเพื่อลดภาระของบริการ STAC APIs ภายนอก
ดัชนีนี้จะคอยอัปเดตเมื่อมีภาพใหม่ผ่านการแจ้งเตือน SNS (สำหรับ AWS Open Data) หรือการสุ่มตรวจ (Polling) ช่วยให้การรันงานเป็นไปอย่างสม่ำเสมอ แพลตฟอร์มจะเลือกแหล่งข้อมูลที่ดีที่สุดและอ่านเฉพาะไบต์ที่จำเป็น (Windowed reads) แทนการดาวน์โหลดภาพทั้งฉาก
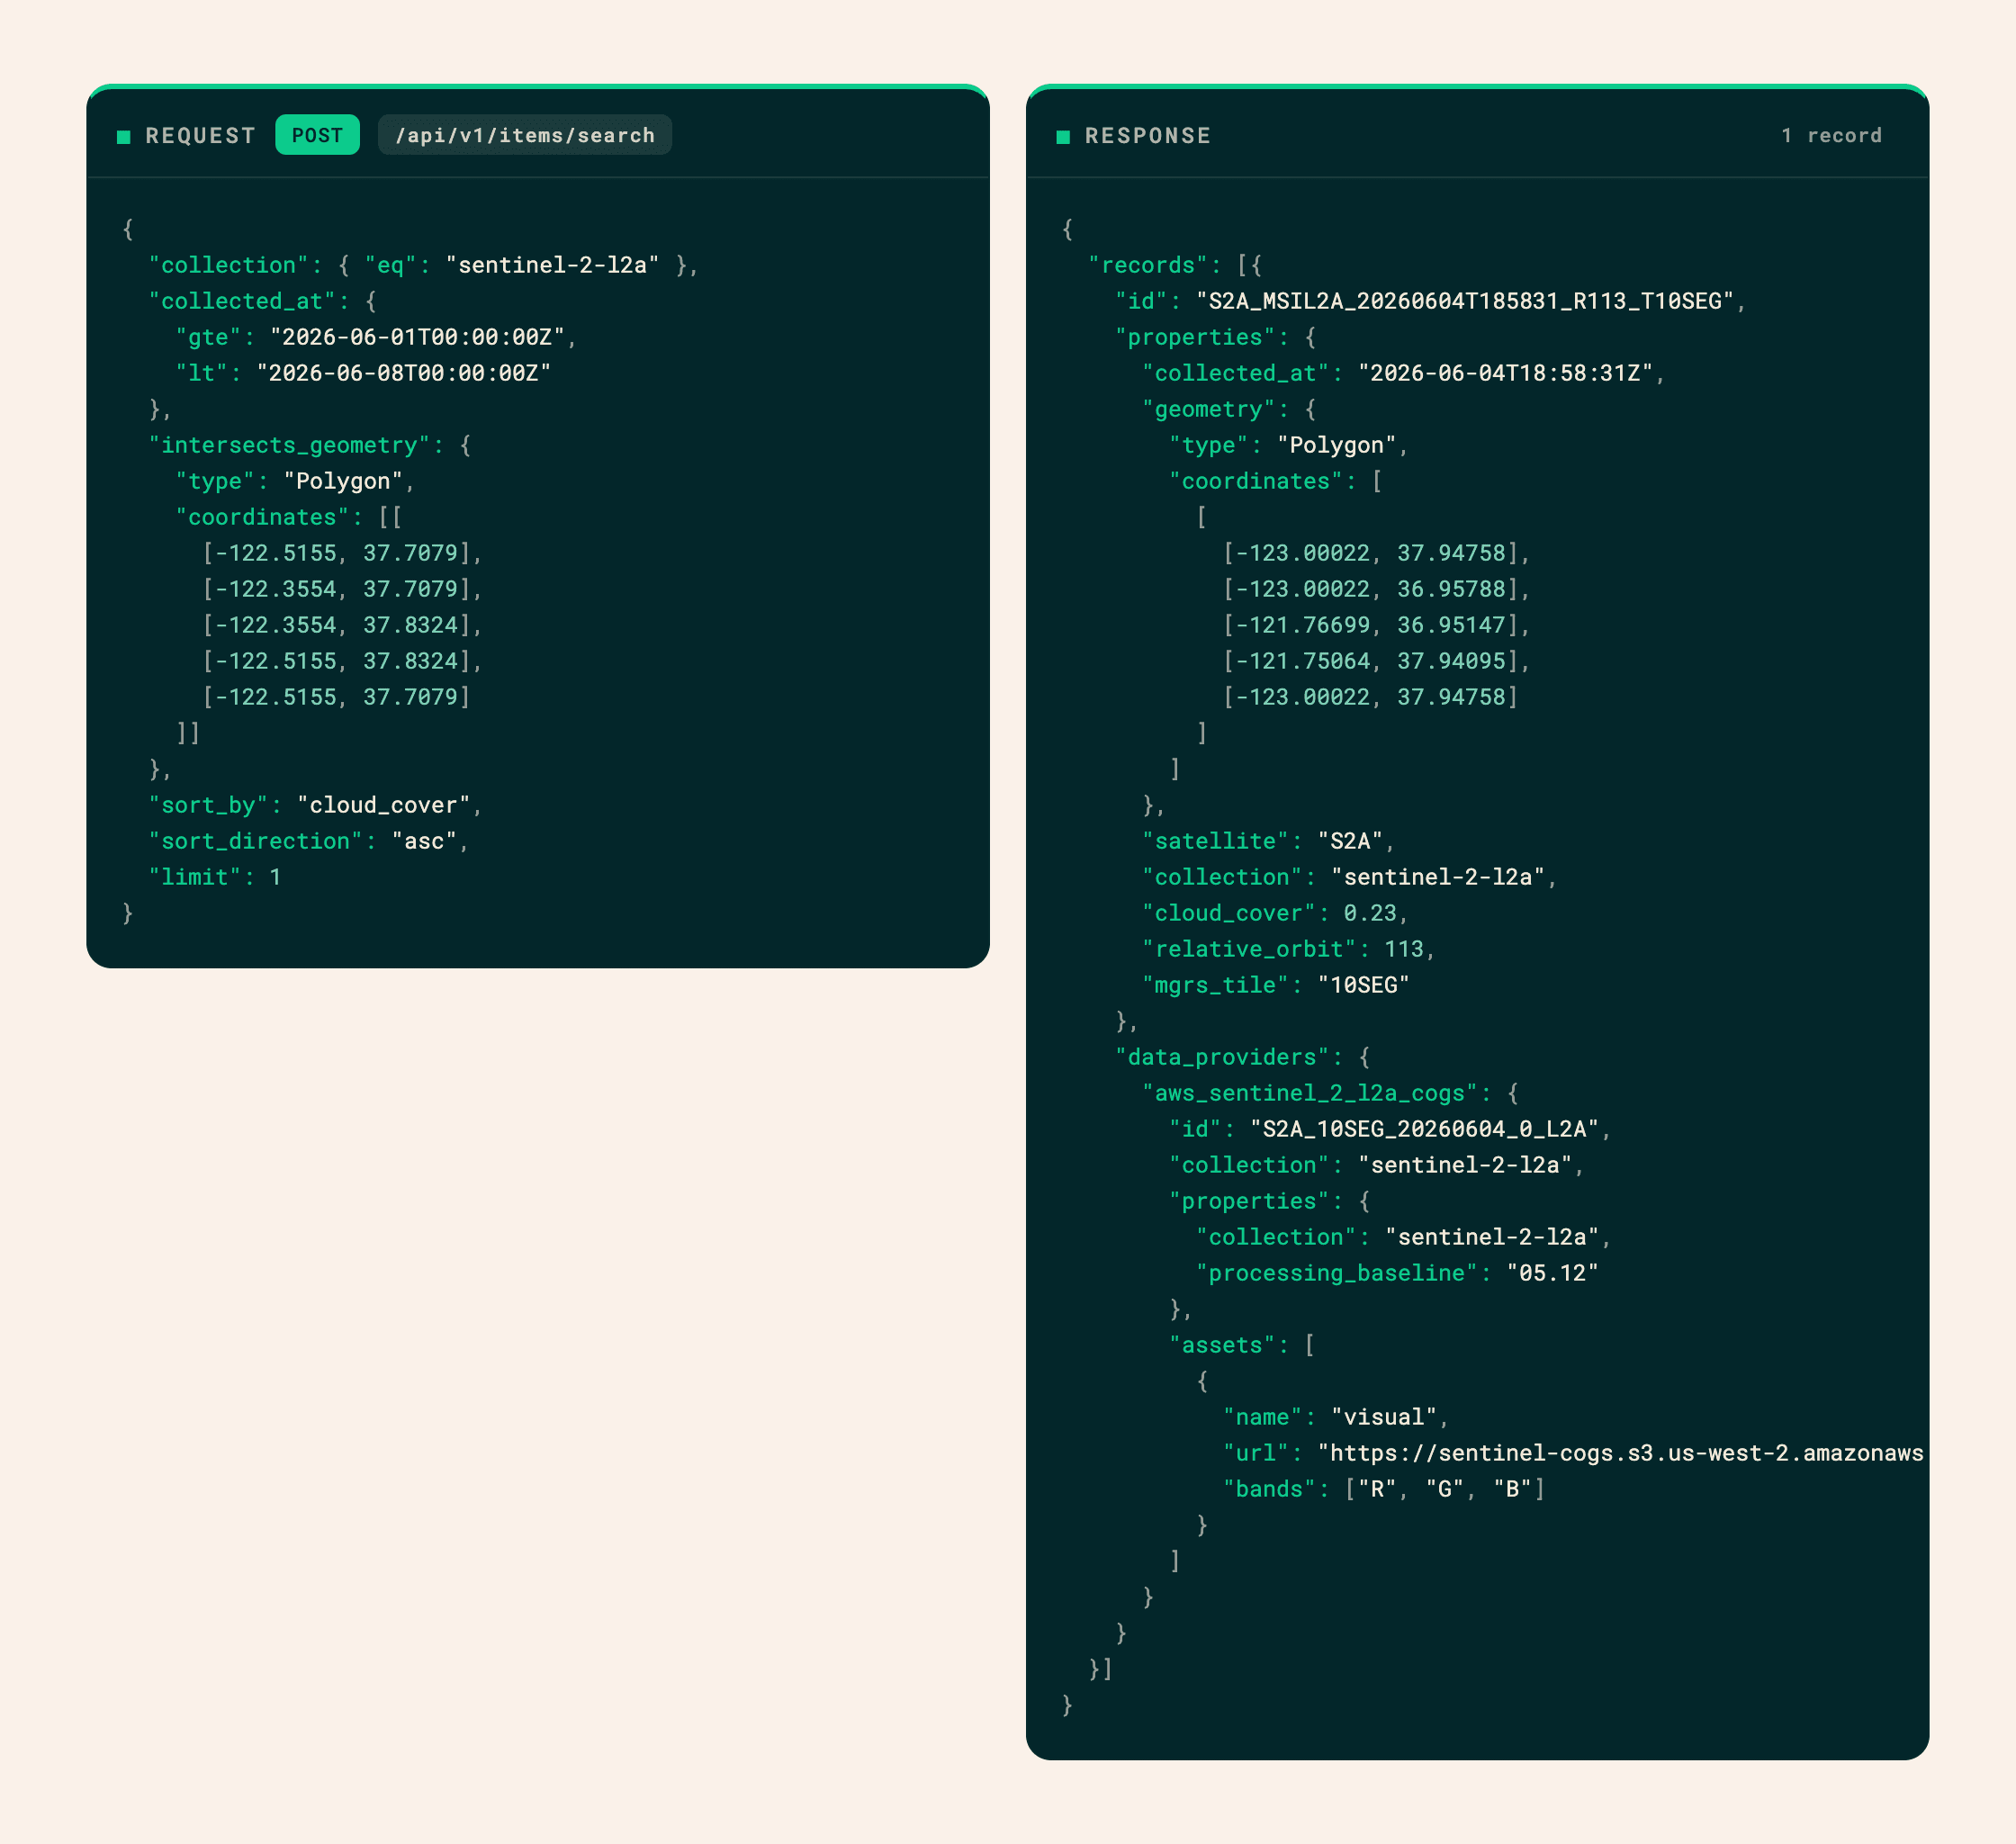
ตัวอย่างการค้นหาภาพ Sentinel-2 ในซานฟรานซิสโกผ่าน API ของ OlmoEarth
การจัดการความล้มเหลวอัตโนมัติ
ระบบถูกออกแบบมาให้กู้คืนข้อมูลโดยอัตโนมัติผ่าน Docker container ที่จัดสรรเครื่องแบบไดนามิก เนื่องจากงานแต่ละส่วนสามารถรันซ้ำได้โดยไม่เกิดผลเสีย (Idempotent) หากเกิดความผิดพลาดจากผู้ให้บริการหรือระบบเครือข่าย แพลตฟอร์มจะทำการลองใหม่ (Retry) หรือสลับไปใช้ผู้ให้บริการสำรองทันที
อนาคตของ OlmoEarth
เรากำลังพัฒนาระบบให้ก้าวหน้ายิ่งขึ้นในหลายด้าน เช่น:
- การรันโมเดลอัตโนมัติ: เมื่อตรวจพบภาพถ่ายใหม่ในพื้นที่ที่กำหนด
- การแจ้งเตือนการเปลี่ยนแปลง: ส่งการแจ้งเตือนทันทีเมื่อพบการตัดไม้ทำลายป่าหรือน้ำท่วม
- เครื่องมือแบบ Agentic: ใช้ AI Agent ช่วยลดความซับซ้อนในการวิจัยข้อมูล
- การรองรับหลายคลาวด์: ออกแบบสถาปัตยกรรมให้รันได้ทุกที่ ทั้ง Google Cloud และสภาพแวดล้อมของพาร์ทเนอร์เอง
นี่เป็นเพียงจุดเริ่มต้นในการปิดช่องว่างระหว่างเทคโนโลยี AI ขั้นสูง กับองค์กรด้านการอนุรักษ์และบรรเทาสาธารณภัยที่ต้องการเครื่องมือเหล่านี้มากที่สุด เพื่อให้พวกเขาสามารถทำความเข้าใจและปกป้องโลกของเราได้อย่างมีประสิทธิภาพมากขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร