
ครั้งแรกของ Global South! Open ASR Leaderboard เพิ่มภาษาอินเดียและระบบวัดผลแบบใหม่ลดความเหลื่อมล้ำ
Voice Arena และ Hugging Face ร่วมมือกันเปิดตัวการประเมิน ASR แบบเปิดสำหรับภาษาฮินดีและภาษาอังกฤษสำเนียงอินเดีย
เกณฑ์มาตรฐาน (Benchmarks) คือตัวกำหนดทิศทางการสร้างเทคโนโลยี โดยโมเดลที่ทำคะแนนได้ดีบน Open ASR Leaderboard มักจะได้รับการพัฒนาต่อ ในขณะที่ความสามารถที่ตารางคะแนนไม่ได้วัดผลมักถูกละเลย งานล่าสุดบน Leaderboard จึงมุ่งเน้นไปที่การทำให้ตัวชี้วัดการประเมินน่าเชื่อถือมากขึ้น
การพัฒนาล่าสุดประกอบด้วยการใช้ ชุดข้อมูลส่วนตัวที่แยกไว้ (Held-out private splits), การวิเคราะห์ความเหมาะสมของเกณฑ์มาตรฐาน (Benchmark-fitting analysis) เพื่อตรวจสอบว่าโมเดลจดจำเสียงได้จริงหรือแค่เลียนแบบสคริปต์ และการปรับปรุงตัวปรับค่ามาตรฐาน (normalisers) เพื่อไม่ให้คำตอบที่ถูกต้องถูกตัดคะแนนอย่างไม่เป็นธรรม
แม้การปรับปรุงเหล่านี้จะทำให้ค่า WER (Word Error Rate) ปั่นคะแนนได้ยากขึ้น แต่มันก็ยังเป็นเพียงตัวเลขเดียว งานวิจัยระบุว่าความแม่นยำของ ASR กระจายตัวอย่างไม่เท่าเทียม โดย ความเหลื่อมล้ำทางเชื้อชาติในการจดจำเสียงอัตโนมัติ พบว่าระบบทำงานกับผู้พูดผิวดำได้แย่กว่าผู้พูดผิวขาวถึงสองเท่า และ การวัดความลำเอียงในการจดจำเสียงอัตโนมัติ ยังพบความแตกต่างตามเพศ อายุ และสำเนียง ซึ่งที่ผ่านมา Leaderboard ไม่สามารถสะท้อนภาพนี้ได้เพราะชุดทดสอบขาดข้อมูลเกี่ยวกับผู้พูด เพื่อปิดช่องว่างดังกล่าว เราจึงขอแนะนำชุดการประเมินใหม่สองชุดเข้าสู่ Open ASR Leaderboard ได้แก่ Monsoon en-IN และ Monsoon hi-IN สำหรับภาษาฮินดีซึ่งมีผู้พูดมากกว่าห้าร้อยล้านคน ถือเป็นภาษาแรกจากอินเดียในแท็บพหุภาษา (multilingual) โดยชุดข้อมูลนี้ครอบคลุมผู้พูดที่ไม่ซ้ำกัน 4,888 คน พร้อมบันทึกคุณลักษณะของผู้พูดไว้ถึง 12 ประการ
การออกแบบการรวบรวมข้อมูล
ชุดทดสอบทั่วไปมักใช้เสียงอะไรก็ได้ที่หาได้ง่าย แต่ Monsoon ถูกออกแบบให้มีความหลากหลายใน 9 แกนหลัก ได้แก่ ภูมิศาสตร์, อายุ, เพศ, คำศัพท์, อุปกรณ์, สภาพแวดล้อมทางเสียง, ประเภทของคำพูด, อัตราการพูด และการมีสคริปต์อ้างอิงหลายรูปแบบ เพื่อป้องกันไม่ให้ค่าเฉลี่ย WER อำพรางความล้มเหลวในประชากรบางกลุ่ม
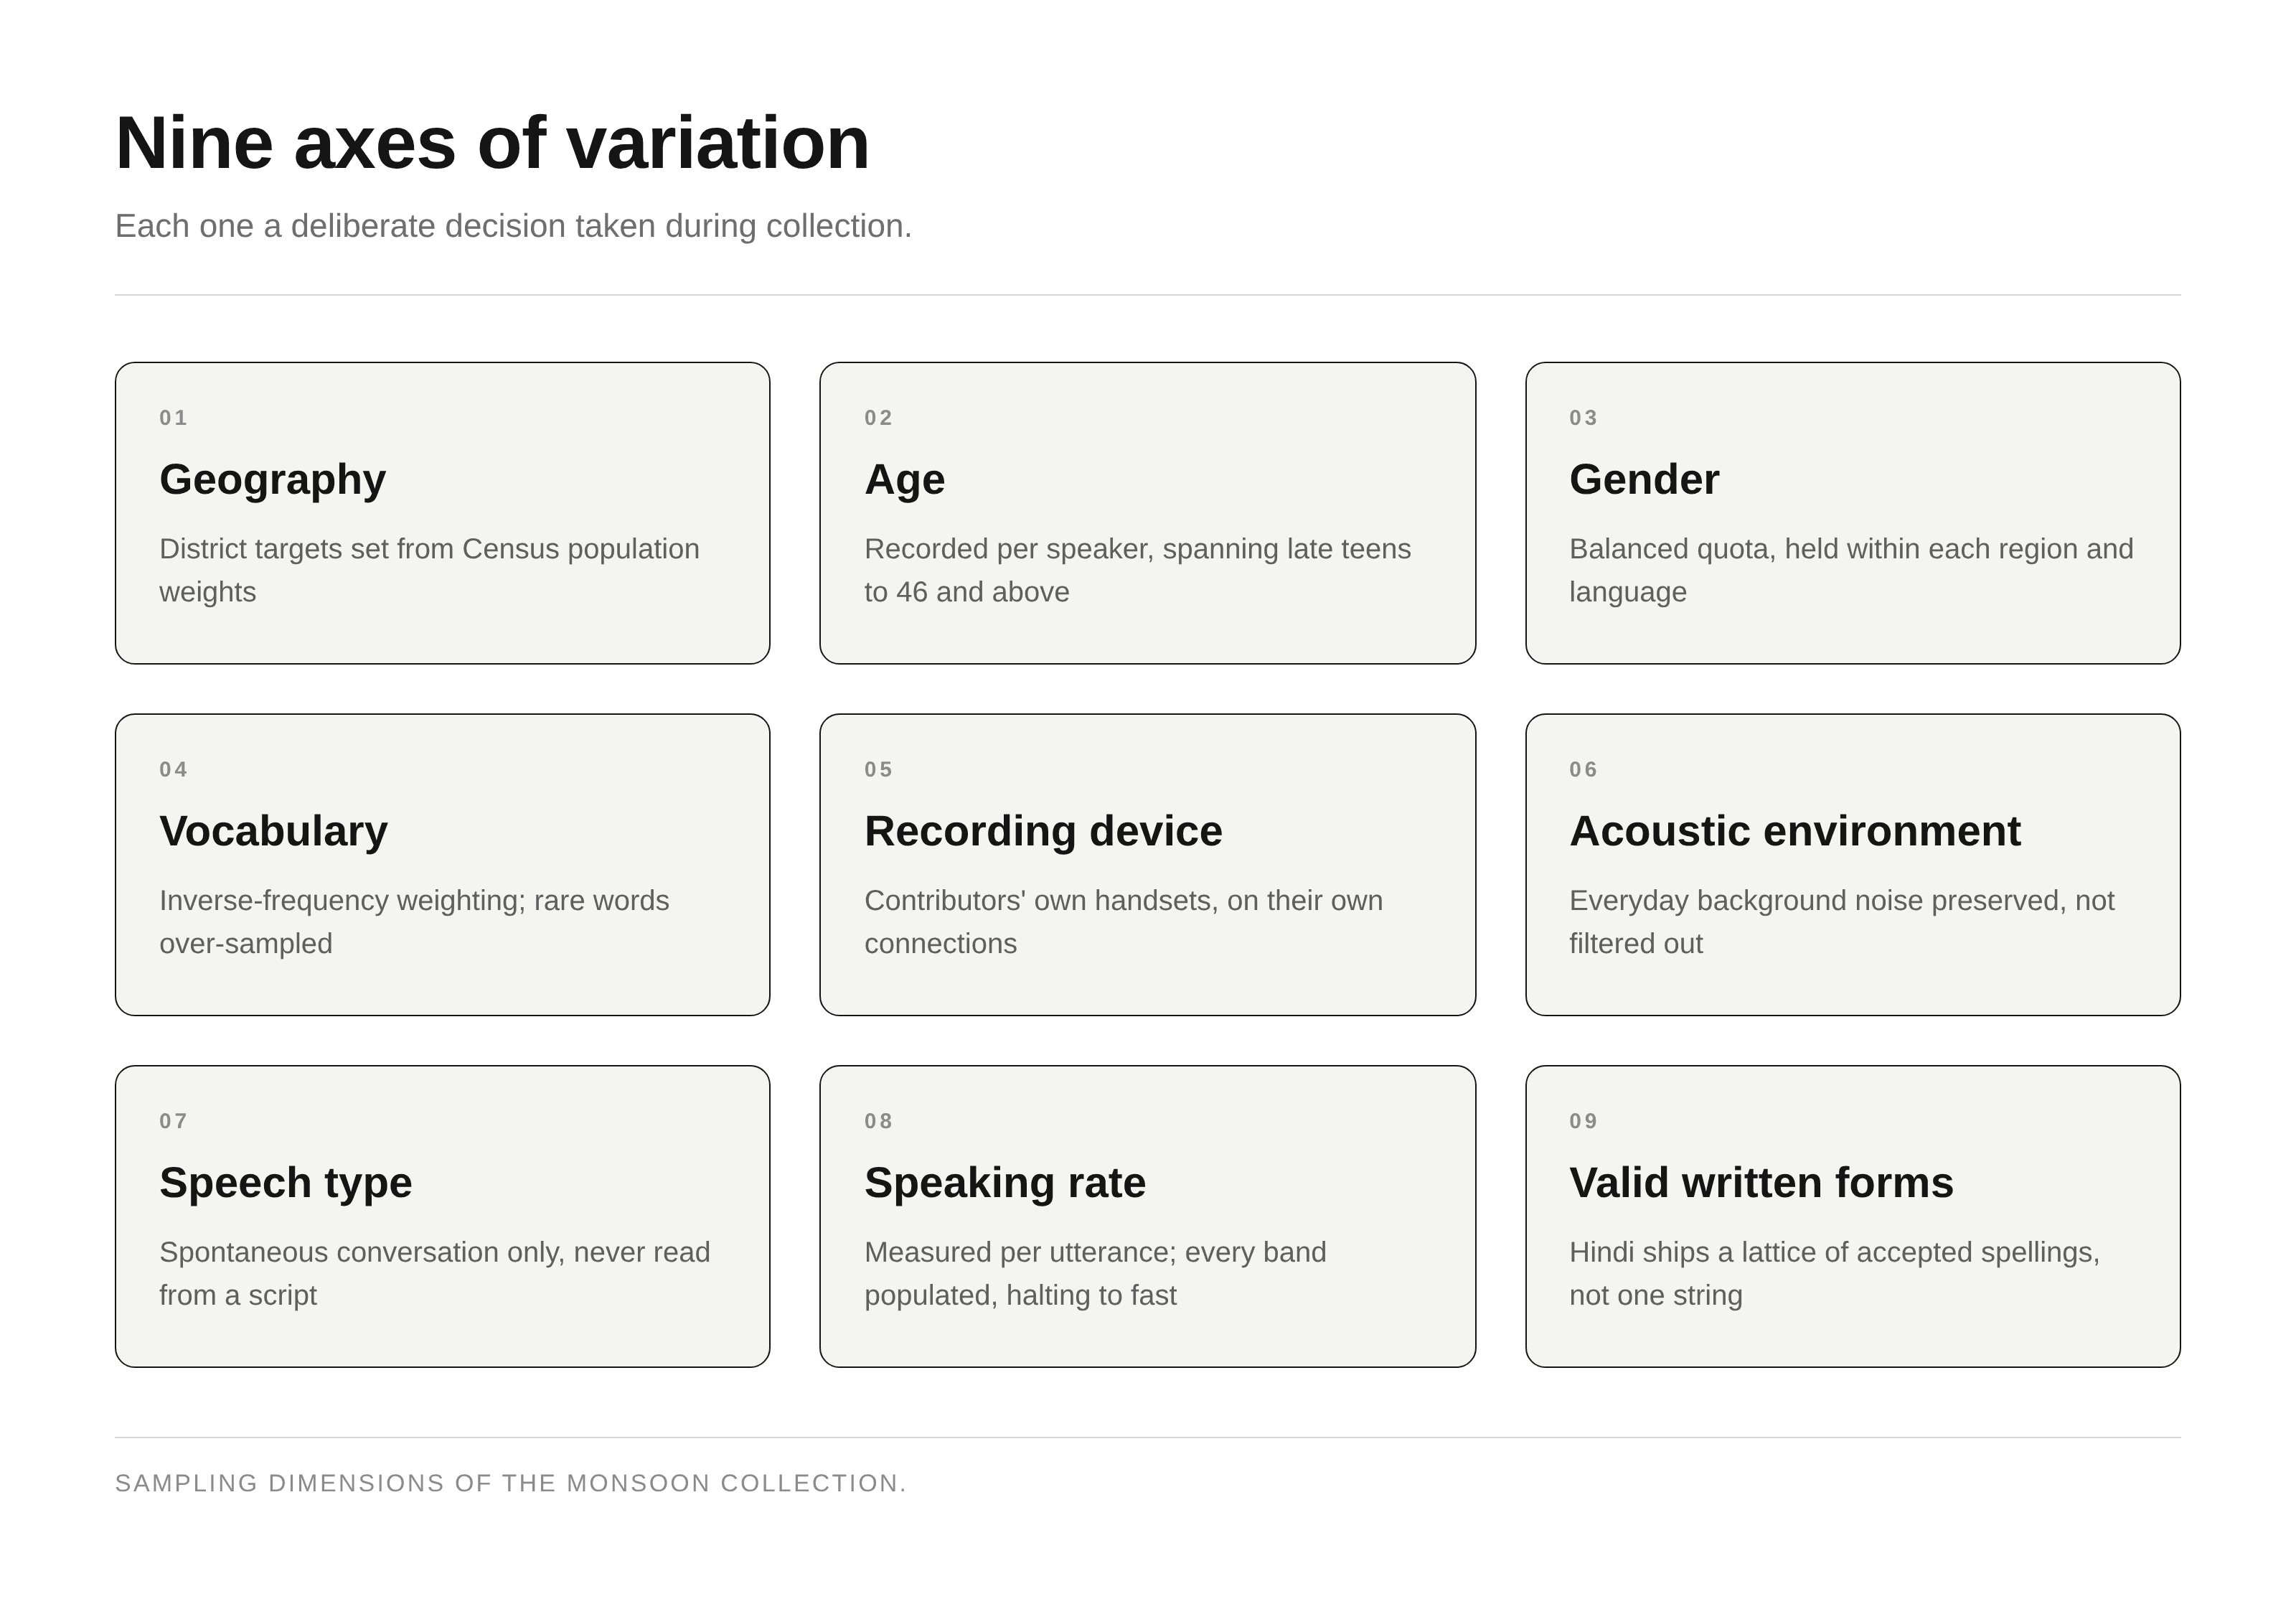
แนวทางการรวบรวมข้อมูลเน้นความสมจริงดังนี้:
- ภูมิศาสตร์: รับสมัครผู้พูดจากหลายร้อยเขตทั่วอินเดีย
- อุปกรณ์และสภาพทางเสียง: ใช้โทรศัพท์ส่วนตัวของผู้พูดในสภาพแวดล้อมจริง แทนการใช้อุปกรณ์มาตรฐานในห้องเงียบ
- ประเภทของคำพูด: เน้นการสนทนาในชีวิตประจำวัน การเล่าเรื่อง และการตอบโต้ที่เป็นธรรมชาติ ซึ่งมักพบชื่อเฉพาะและคำศัพท์ที่ไม่ได้เตรียมการล่วงหน้า
องค์ประกอบของชุดข้อมูล
ชุดข้อมูลทั้งสี่ชุดถูกรวบรวมผ่านกระบวนการเดียวกัน ครอบคลุมสองภาษาหลัก:
| ชุดข้อมูล | ภาษา | ระยะเวลา | ผู้พูด | ความยาวคลิป (เฉลี่ย / มัธยฐาน) | ชาย/หญิง | เขต | รัฐ/UTs | อุปกรณ์ | รูปแบบ | การถอดความ |
|---|---|---|---|---|---|---|---|---|---|---|
| Monsoon en-IN public | ภาษาอังกฤษอินเดีย | 5.62 ชม. | 1,444 | 9.6ว / 10.4ว | 50/50 | 428 | 24/6 | 556 | การสนทนา, ธรรมชาติ | ปรับมาตรฐาน, มีคำติดอ่าง |
| Monsoon en-IN private | ภาษาอังกฤษอินเดีย | 5.58 ชม. | 1,405 | 9.6ว / 10.4ว | 45/55 | 420 | 24/6 | 560 | การสนทนา, ธรรมชาติ | ปรับมาตรฐาน, มีคำติดอ่าง |
| Monsoon hi-IN public | ภาษาฮินดี | 1.33 ชม. | 468 | 6.4ว / 5.0ว | 54/46 | 202 | 11/3 | 315 | การสนทนา, ธรรมชาติ | Lattice (ยอมรับการสะกดที่หลากหลาย) |
| Monsoon hi-IN private | ภาษาฮินดี | 4.47 ชม. | 1,571 | 6.6ว / 5.3ว | 55/45 | 295 | 12/3 | 582 | การสนทนา, ธรรมชาติ | Lattice (ยอมรับการสะกดที่หลากหลาย) |
ข้อมูลมาจากการสนทนาธรรมชาติแบบสองช่องทาง (dual-channel) โดยแต่ละคลิปจะเก็บข้อมูลเมตา (metadata) ของผู้พูดไว้อย่างละเอียด เช่น อาชีพ การศึกษา สถานภาพการสมรส รายได้ และอุปกรณ์ที่ใช้ ตัวอย่างเช่น หญิงอายุ 29 ปี จาก West Tripura ใช้อุปกรณ์ Samsung หรือชายอายุ 57 ปี จาก Puducherry ที่ทำงานเอกชน
สำหรับชุดภาษาฮินดีมีความท้าทายเรื่องความแปรผันของการสะกดสูงมากจนตัวปรับมาตรฐานทั่วไปแก้ไม่ได้ เราจึงใช้ระบบ Lattice ในการถอดความ ซึ่งจะรวบรวมรายการสะกดคำที่ยอมรับได้ทั้งหมดสำหรับแต่ละช่วงเวลา เพื่อให้การประเมินเป็นธรรมที่สุด
ความครอบคลุมของผู้พูด
จุดเด่นของ Monsoon ไม่ใช่จำนวนชั่วโมงที่มหาศาล แต่เป็นความหลากหลายของผู้พูดซึ่งสร้างมูลค่าสูงสุดให้กับเกณฑ์มาตรฐานนี้
ความเข้มข้นและความหลากหลายของผู้พูด
| Monsoon hi-IN public | Monsoon hi-IN private | Monsoon en-IN public | Monsoon en-IN private | |
|---|---|---|---|---|
| จำนวนเซกเมนต์ต่อผู้พูด (เฉลี่ย) | 1.61 | 1.56 | 1.46 | 1.48 |
| ผู้พูดที่มีเพียงเซกเมนต์เดียว | 261 | 994 | 956 | 924 |
| เสียงต่อผู้พูด (มัธยฐาน) | 8.34 ว | 8.28 ว | 12.36 ว | 12.39 ว |
| ส่วนแบ่งจากผู้พูด 10 อันดับแรก | 6.8% | 3.1% | 2.8% | 2.9% |
| เมืองปัจจุบัน | 289 | 814 | 641 | 584 |
| ผู้ผลิตอุปกรณ์ | 18 | 25 | 23 | 20 |
การออกแบบนี้ทำให้มั่นใจได้ว่าไม่มีเสียงใดเสียงหนึ่งควบคุมคะแนนรวม และไม่มีภูมิภาคหรือรุ่นมือถือใดผูกขาดคลังข้อมูล ช่วยป้องกันปัญหาโมเดล Overfit หรือจดจำได้ดีแค่กับลักษณะไมโครโฟนบางรุ่น ภาษาอังกฤษอินเดียในชุดข้อมูลนี้ยังครอบคลุมทุกโซนของประเทศ ไม่ได้จำกัดอยู่แค่สำเนียงของภูมิภาคใดภูมิภาคหนึ่ง
ฟิลด์ข้อมูลเมตา (Metadata fields)
Monsoon ให้ข้อมูลถึง 18 คอลัมน์ต่อเซกเมนต์ โดยมีข้อมูลเมตา 12 คอลัมน์ ซึ่งหาได้ยากในชุดทดสอบสาธารณะทั่วไป:
| กลุ่ม | ฟิลด์ |
|---|---|
| เซกเมนต์ | id, audio, audio_length_s, language |
| ข้อมูลอ้างอิง | lattice (ฮินดี) หรือ text (อังกฤษอินเดีย) |
| ผู้พูด | speaker_id, gender, date_of_birth |
| พื้นหลัง | occupation, educational_background, marital_status, income |
| ภูมิศาสตร์ | native_district, native_state, current_city, years_spent_in_current_district |
| การบันทึก | device_manufacturer, device_model |
ข้อมูลเหล่านี้ช่วยให้นักพัฒนาวิเคราะห์เจาะลึกได้ว่า โมเดลทำงานได้แย่ลงในบางพื้นที่หรือกับประชากรบางกลุ่มหรือไม่ เช่น ในอดีตพบว่าอัตราข้อผิดพลาดในระดับเขตอาจต่างกันได้ตั้งแต่ 4% ถึง 44% ซึ่ง Monsoon จะทำให้การวิเคราะห์แบบนี้ทำได้บน Leaderboard สาธารณะ
การรวบรวมและการควบคุมคุณภาพ
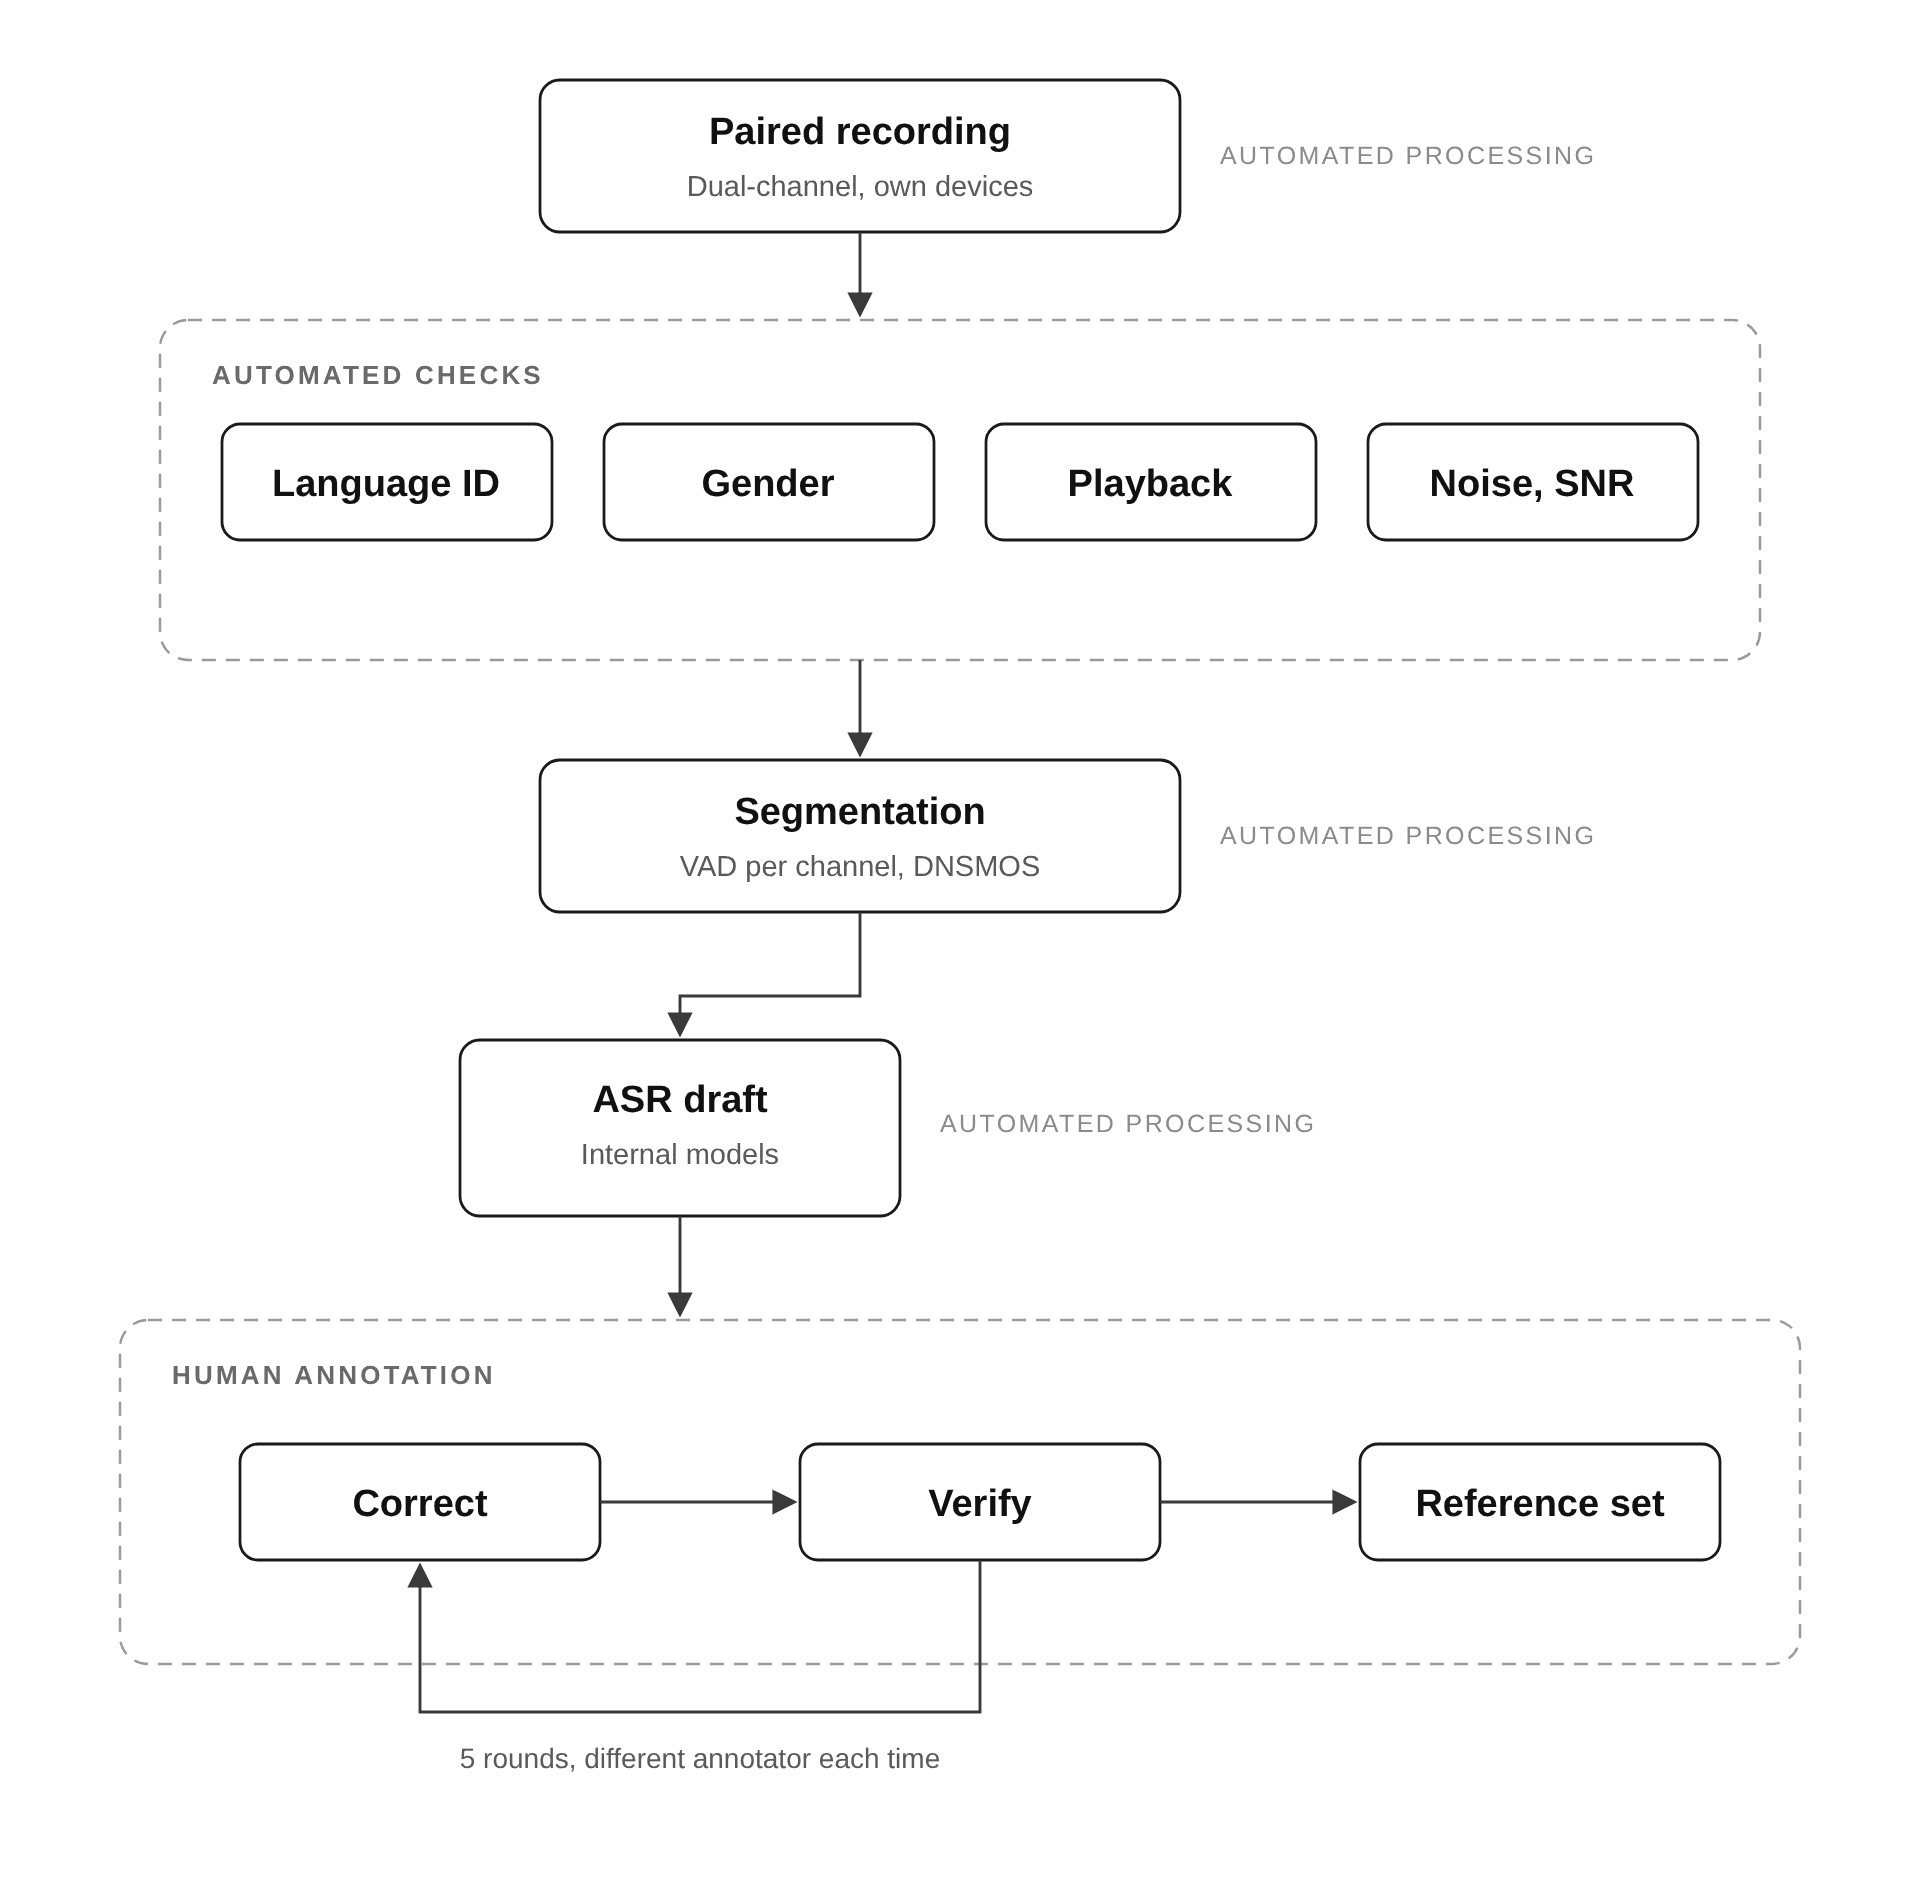
เพื่อให้ได้ข้อมูลที่ครอบคลุมและมีคุณภาพสูง เราใช้วิธีการดังนี้:
- การสรรหา: ผ่านชุมชน Voice Arena เพื่อเข้าถึงพื้นที่ห่างไกล โดยผู้เข้าร่วมต้องผ่านการคัดกรองความชำนาญทางภาษาและให้ความยินยอมอย่างถูกต้อง
- การดึงข้อมูล: ใช้ LLM ช่วยสร้างหัวข้อสนทนาที่หลากหลายและเป็นธรรมชาติ แล้วให้นักภาษาศาสตร์เจ้าของภาษาตรวจสอบอีกครั้ง
- การควบคุมคุณภาพ: ใช้โมเดล LID ตรวจสอบภาษา, ตัวจำแนกเพศ, และระบบตรวจจับเสียงรบกวน รวมถึงการแบ่งเซกเมนต์ด้วย VAD และการตรวจสอบด้วย DNSMOS P.808
- การถอดความ: ใช้มนุษย์ถอดความและตรวจสอบแบบ 5 ระดับ (Five-level protocol) โดยไม่มีผู้ถอดความคนใดตรวจสอบงานของตัวเอง เพื่อให้แน่ใจว่าสคริปต์ถูกต้องแม่นยำที่สุด
ความแปรผันรายภูมิภาค
จากการทดสอบกับโมเดลบน Leaderboard พบว่า แม้คะแนน WER รวมจะดูใกล้เคียงกัน แต่เมื่อแยกตามภูมิภาคกลับให้ผลที่ต่างกันอย่างชัดเจน เช่น openai/whisper-large-v3-turbo มีความแปรผันในแต่ละโซนเพียง 0.46 จุด ในขณะที่บางโมเดลมีความแปรผันสูงถึง 1.68 จุด สะท้อนว่าความแม่นยำของบางระบบขึ้นอยู่กับว่าผู้พูดมาจากไหนเป็นสำคัญ
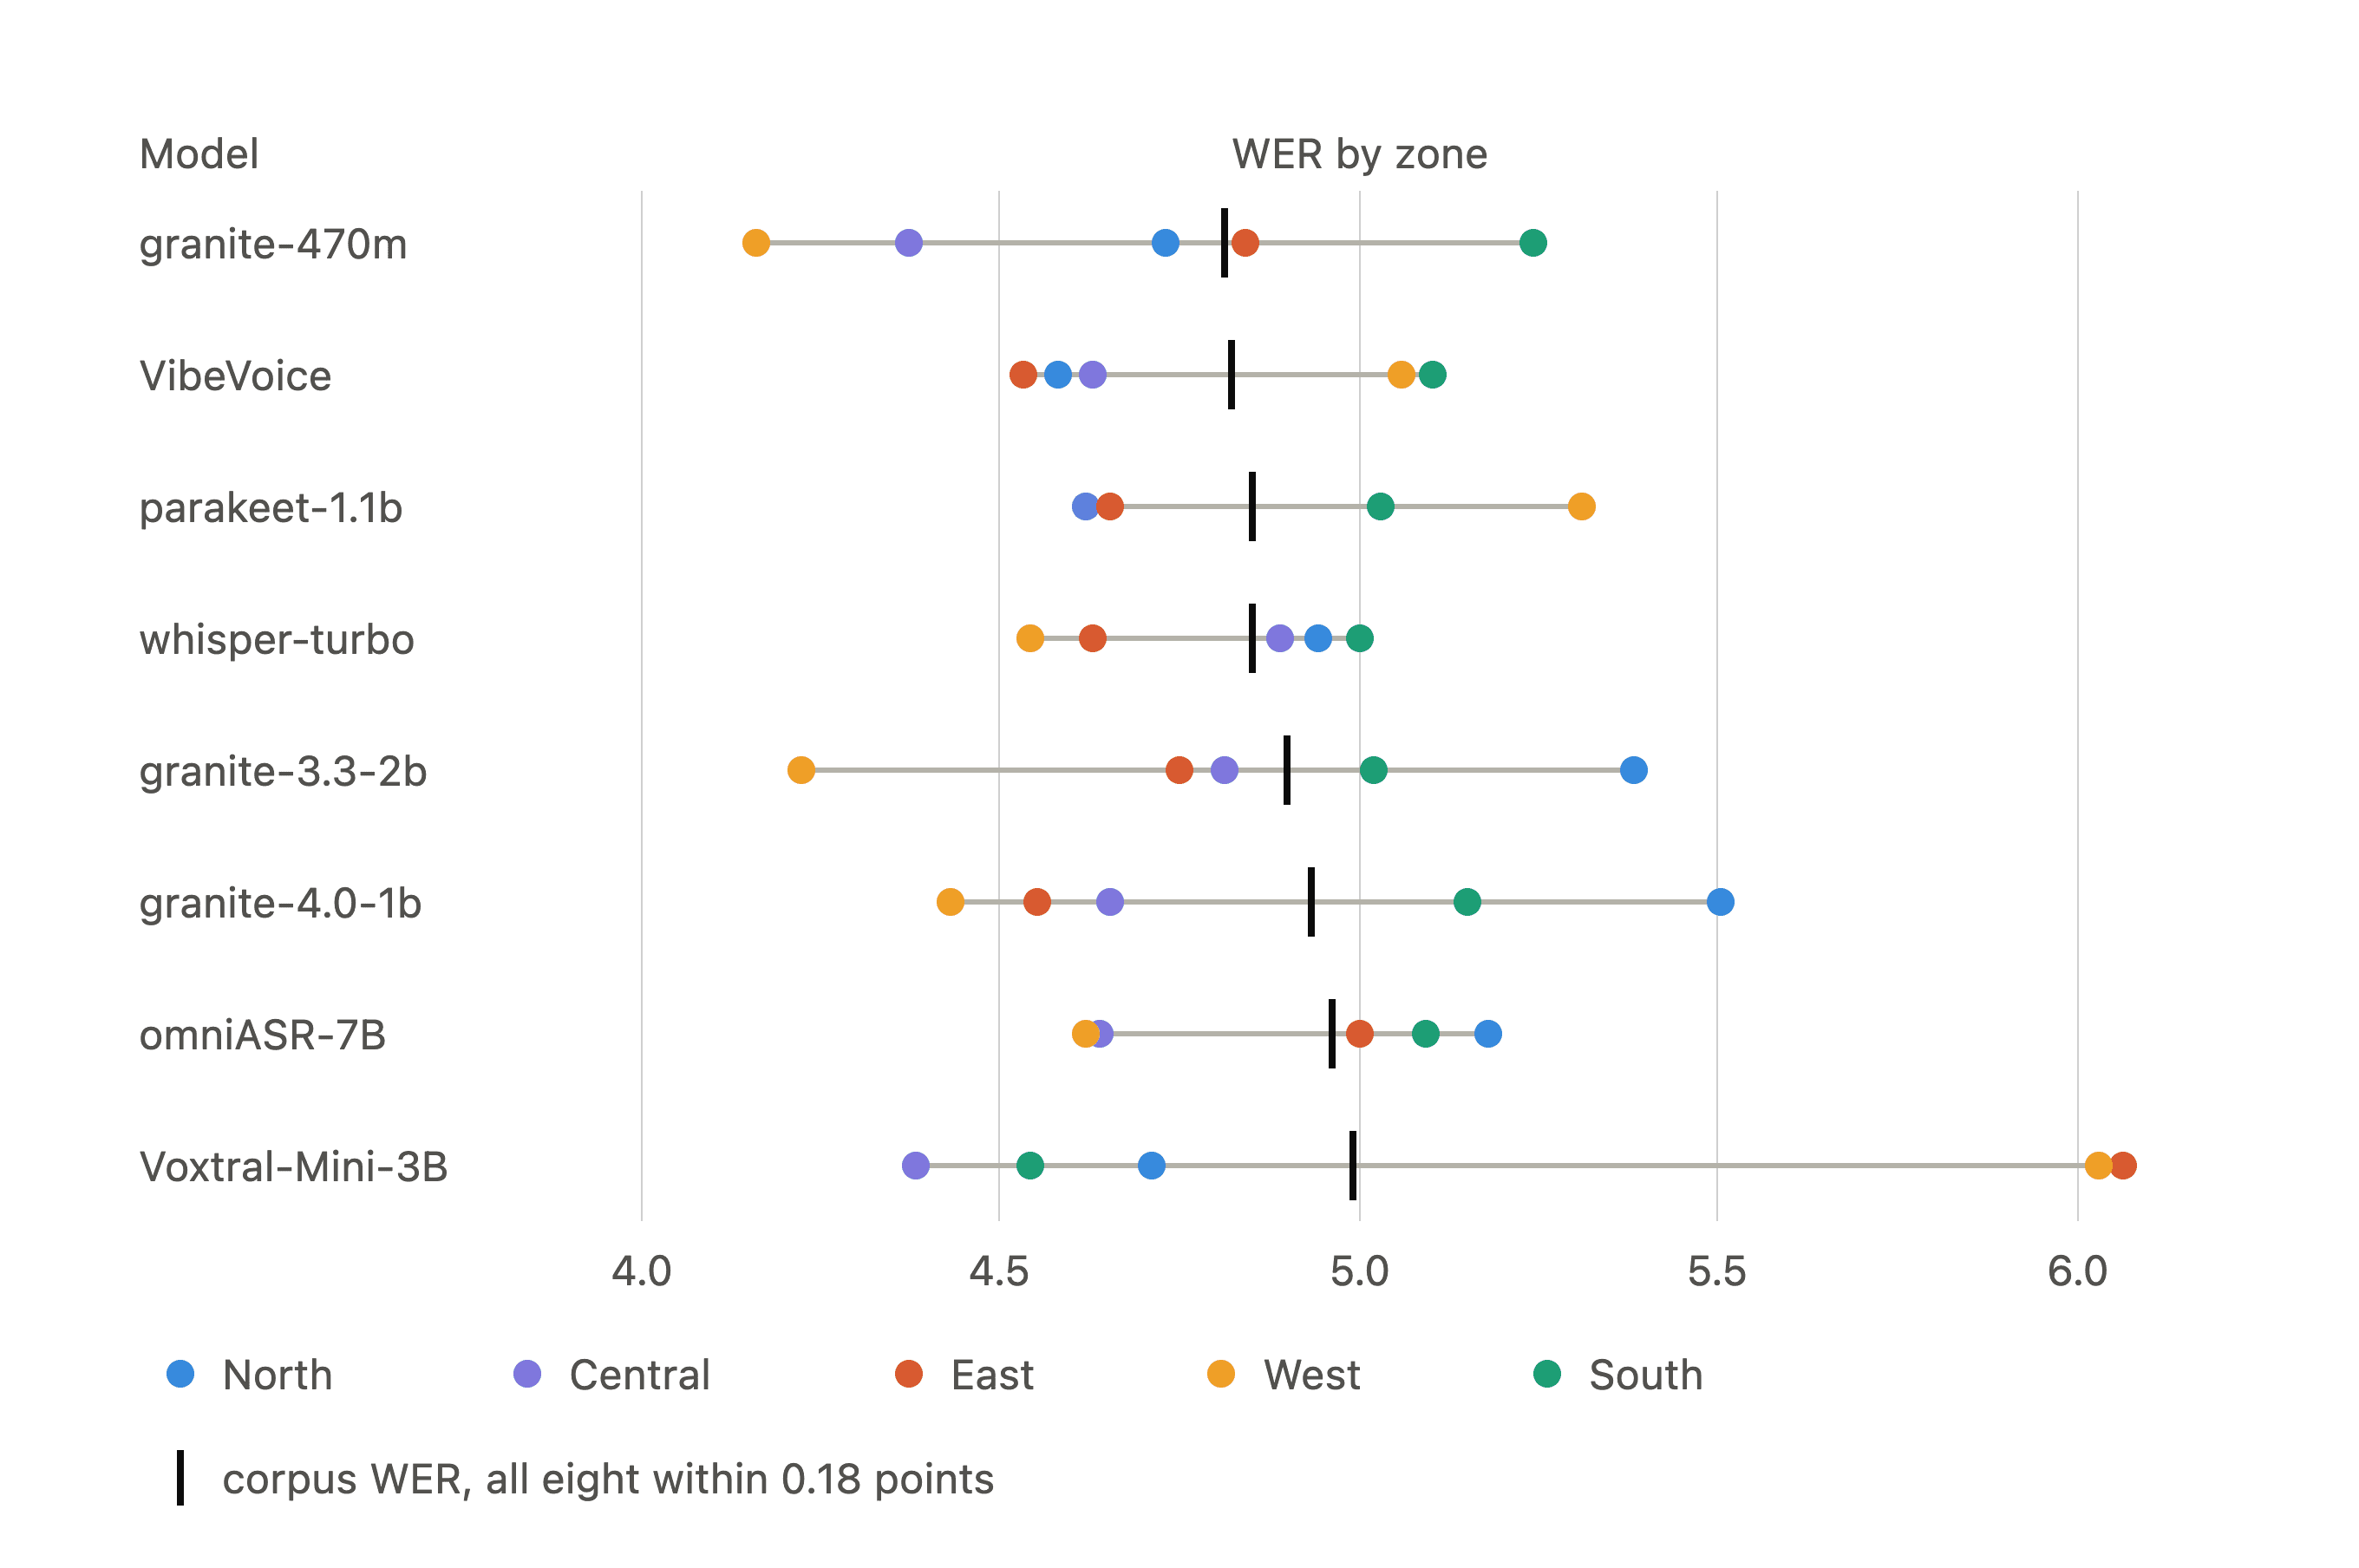
ความแตกต่างเหล่านี้จะไม่สามารถมองเห็นได้เลยหากใช้ชุดทดสอบแบบเดิมที่บันทึกเพียงคำพูด แต่ข้อมูลเมตาใน Monsoon ช่วยชี้เป้าปัญหาของโมเดลแต่ละตัวได้แม่นยำขึ้น
ความแปรผันของการสะกดในภาษาฮินดี
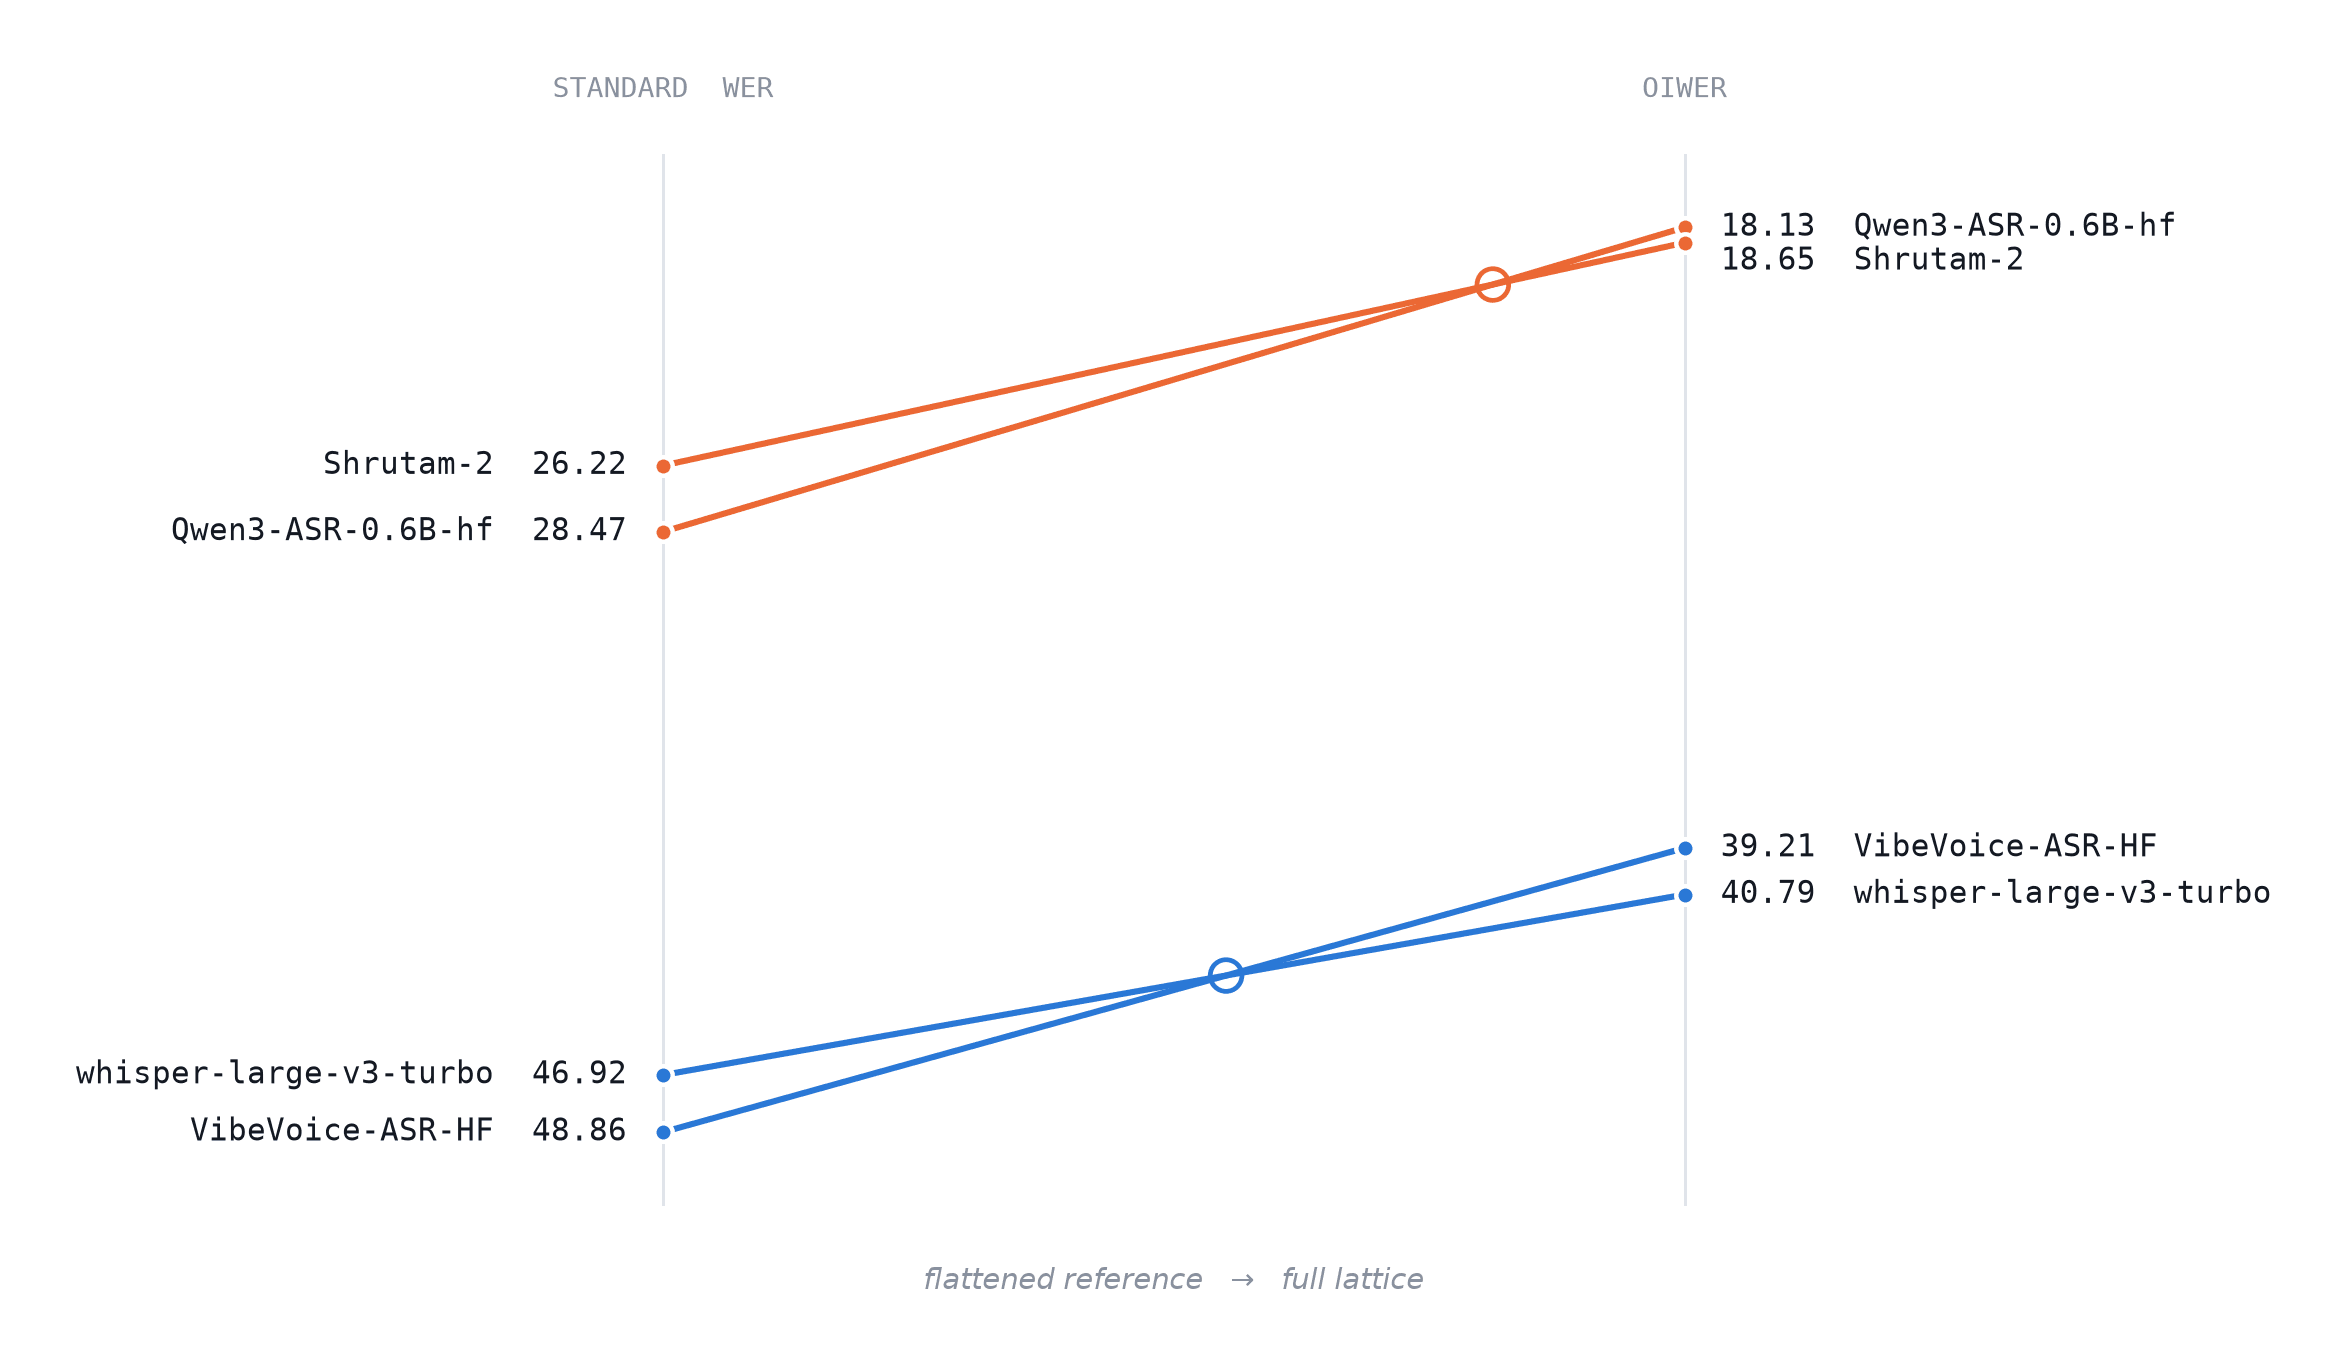
ภาษาฮินดีมีความท้าทายเรื่องการสลับรหัสภาษาและการเขียนคำทับศัพท์ภาษาอังกฤษ ซึ่งไม่มีรูปแบบตายตัว ชุดข้อมูลนี้จึงเปลี่ยนไปใช้ค่า Orthographically-Informed Word Error Rate (OIWER) และระบบ Lattice แทน เพื่อไม่ให้ระบบถูกตัดคะแนนจากความแปรผันของการสะกดที่ไม่ส่งผลต่อความหมาย
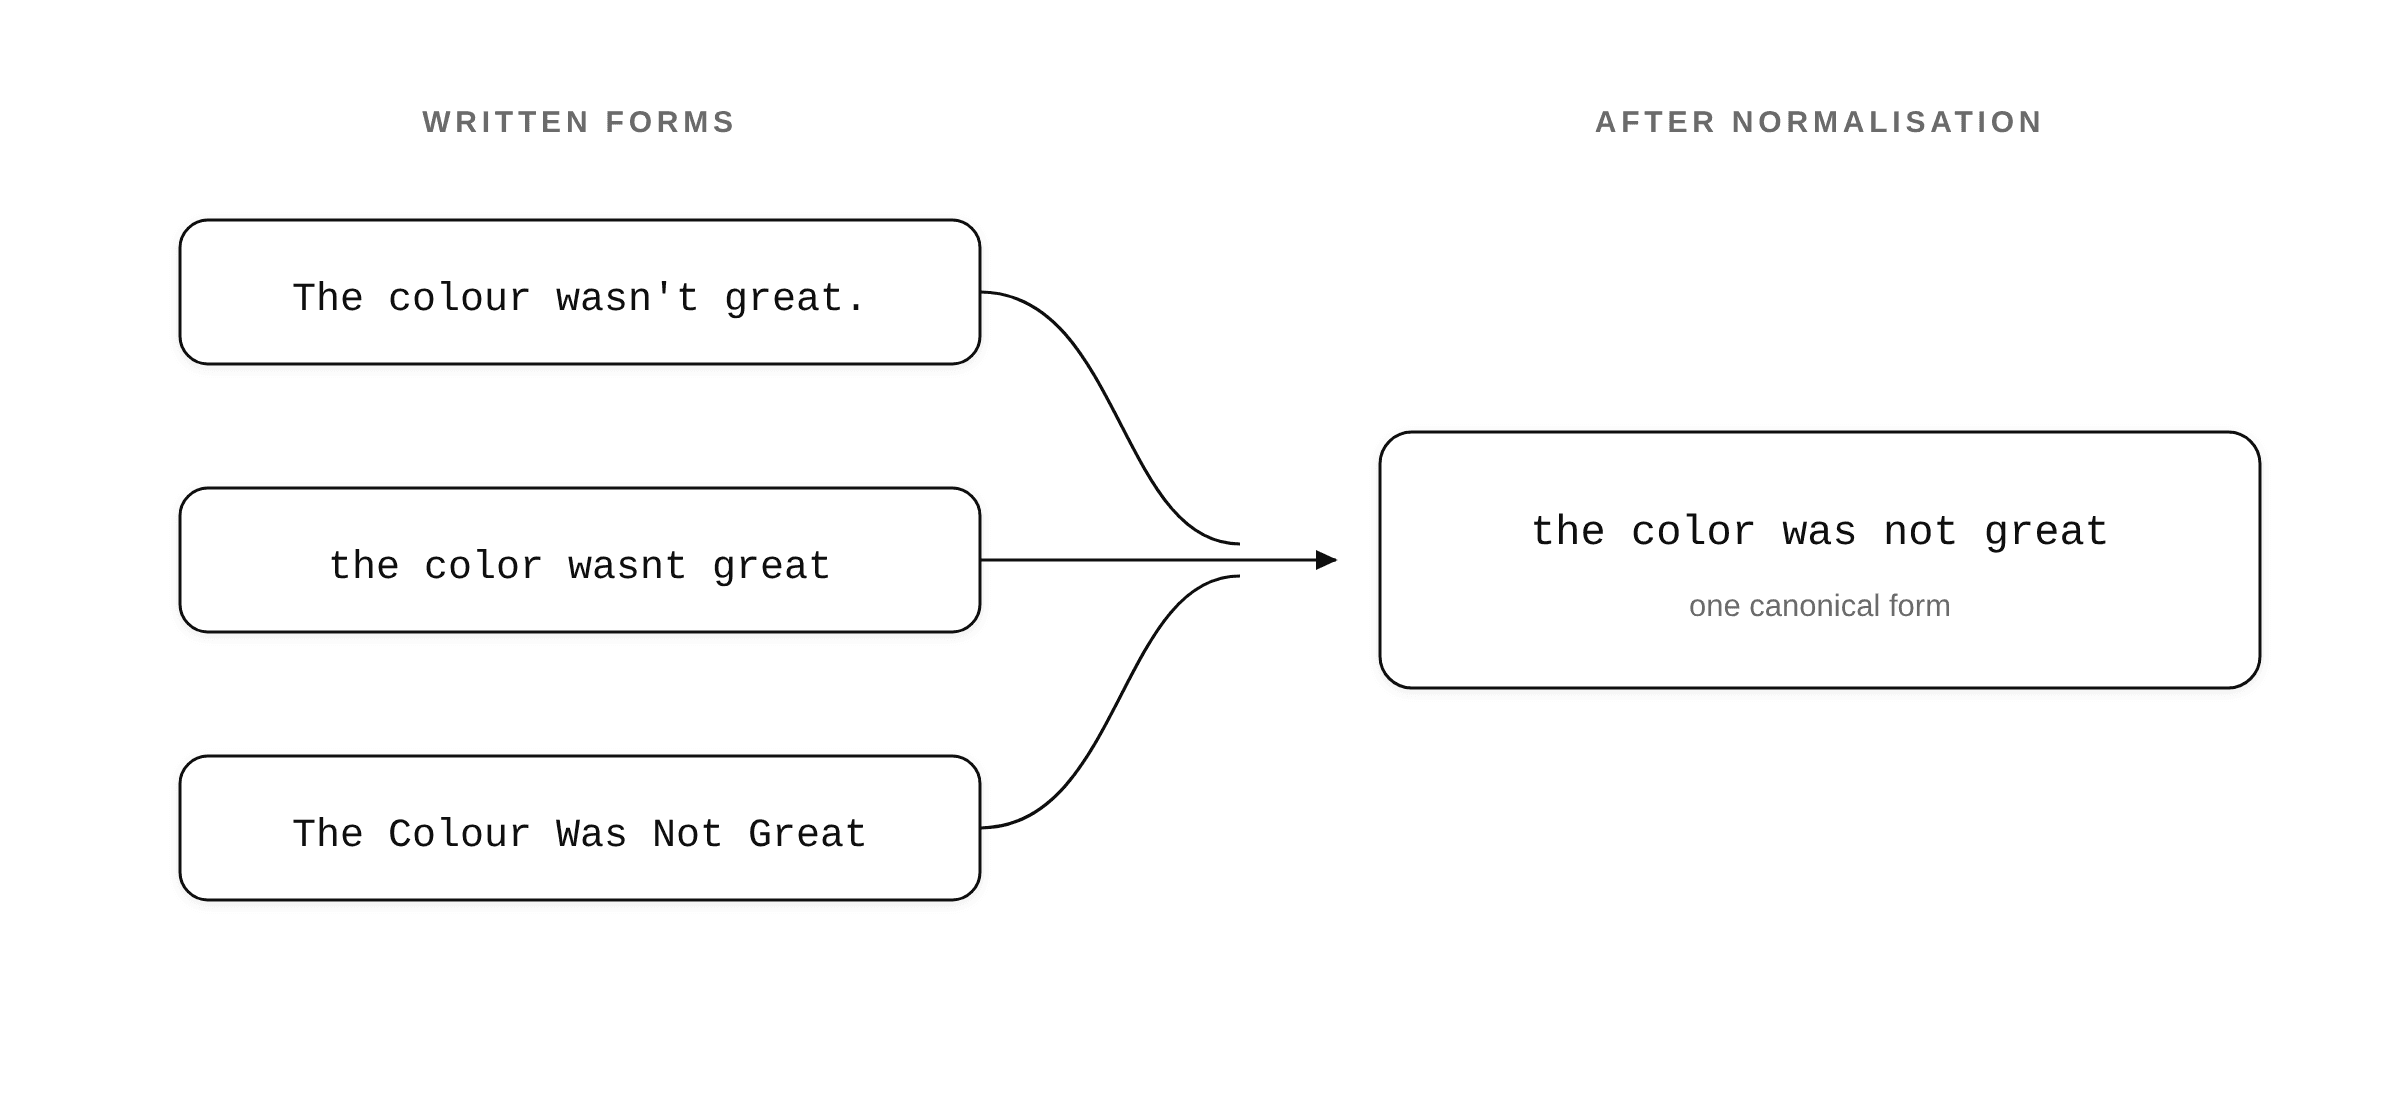
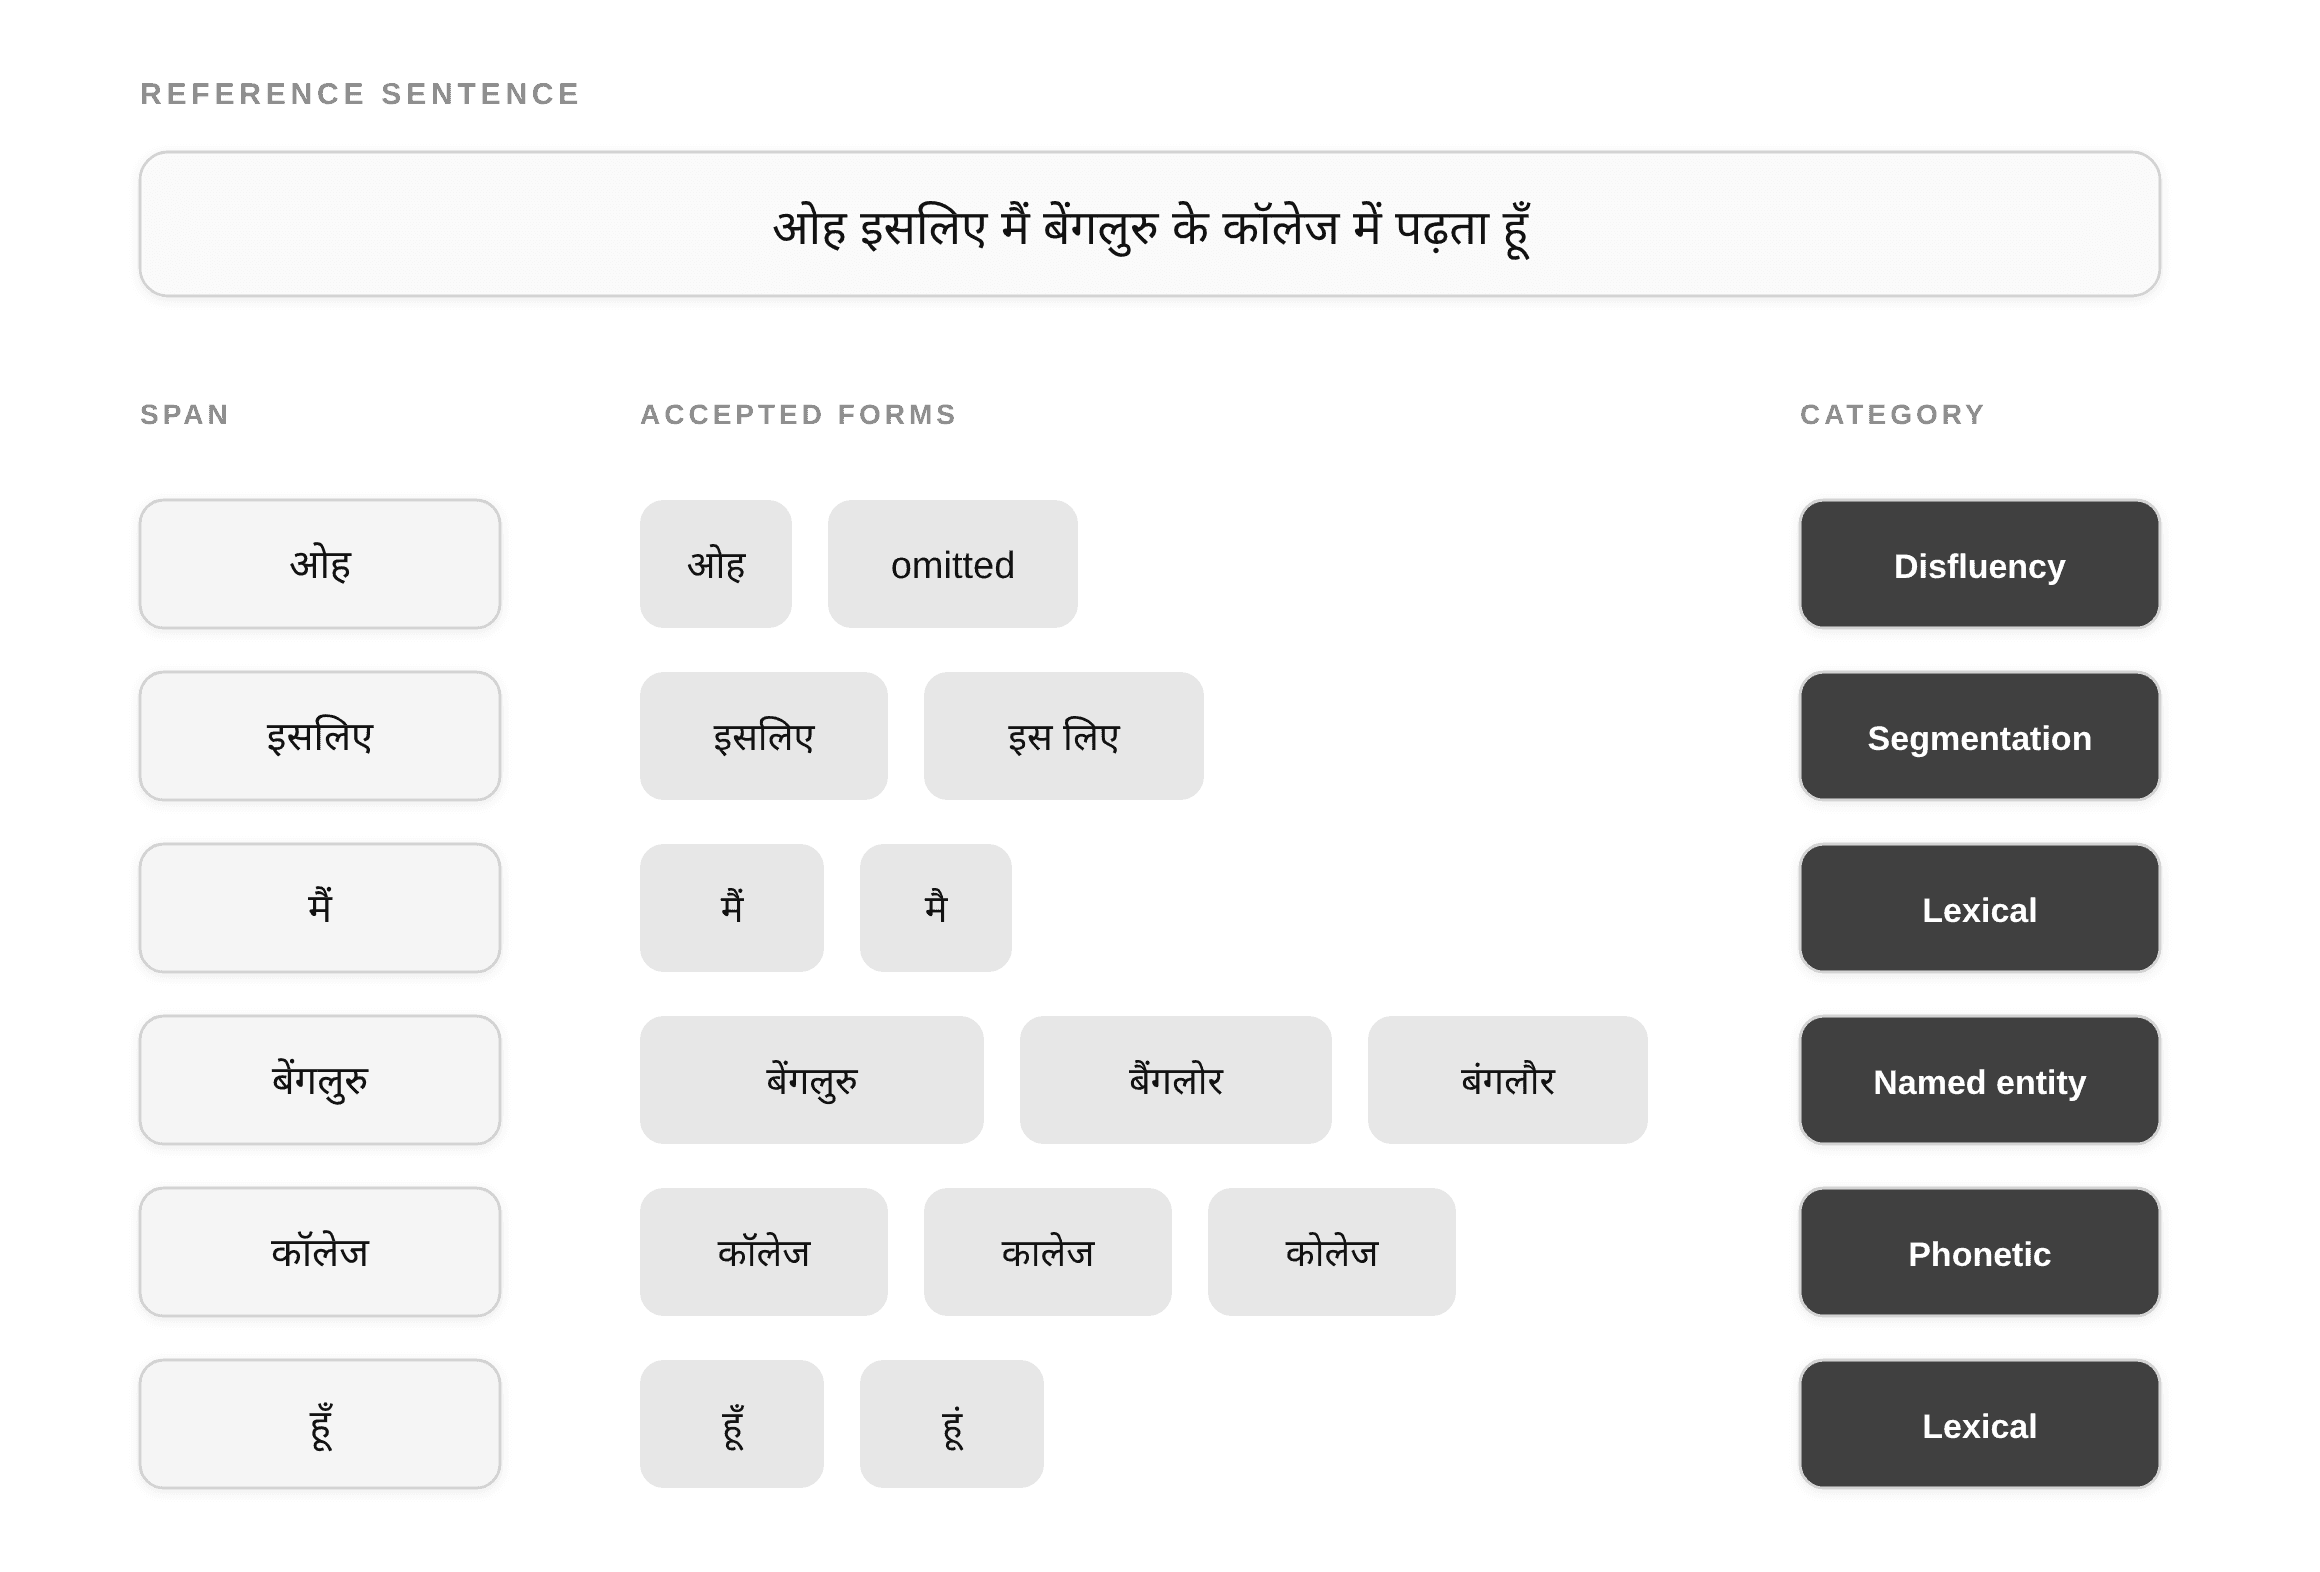
การใช้ Lattice ช่วยให้นับเฉพาะข้อผิดพลาดในการจดจำที่แท้จริง เรายังเปิดซอร์สไลบรารี voi-oiwer เพื่อให้ทุกคนสามารถทำซ้ำผลลัพธ์นี้ได้
การขอรับการประเมิน
ผู้พัฒนาสามารถนำโมเดลขึ้นสู่ Open ASR Leaderboard ผ่านทาง Open ASR Leaderboard GitHub โดยมีขั้นตอนคือเปิด Pull Request และรายงานผลบนชุดข้อมูลสาธารณะ จากนั้นทีมงานจะคำนวณตัวชี้วัดบนชุดข้อมูลส่วนตัวให้
ภาษาอังกฤษอินเดียจะรวมอยู่ใน Voice Arena Monsoon บน Leaderboard หลัก และมีผลต่อค่าเฉลี่ย WER รวม ส่วนภาษาฮินดีจะอยู่ในแท็บพหุภาษาเพื่อให้เกิดการเปรียบเทียบที่ยุติธรรมระหว่างโมเดลที่รองรับหลายภาษา
สิ่งที่จะตามมา
โครงการ Monsoon ของ Voice Arena มุ่งหวังที่จะนำปัญหาเรื่องความหลากหลายทางภาษาใน Global South มาวางไว้บน Leaderboard ที่ทุกคนมองเห็น เพื่อให้ความแตกต่างของระบบจดจำเสียงสามารถสืบย้อนไปถึงต้นตอได้ว่ามีปัญหาที่ใครหรืออย่างไร มากกว่าจะเป็นเพียงตัวเลข WER ที่ไร้บริบท
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร