
FireDucks ไลบรารี Python ตัวแรงที่ช่วยให้ Pandas ทำงานเร็วขึ้นสูงสุดถึง 20 เท่า
Pandas มักจะเป็นตัวเลือกแรกในการทำงานกับข้อมูลแบบตารางใน Python เนื่องจากใช้งานง่ายและทำงานร่วมกับระบบนิเวศอื่นได้ดี แต่เมื่อชุดข้อมูลขยายใหญ่ขึ้นถึงระดับหลายล้านแถว การดำเนินการพื้นฐานอย่างการเรียงลำดับ (Sorting) การกรอง (Filtering) หรือการจัดกลุ่ม (Grouping) มักจะเริ่มทำงานช้าลงอย่างเห็นได้ชัด
นี่คือจุดที่ FireDucks เข้ามาแก้ปัญหา โดย FireDucks มอบ API ที่เข้ากันได้กับ pandas ทำให้คุณสามารถใช้ไวยากรณ์ที่คุ้นเคยได้เช่นเดิม แต่ได้ประสิทธิภาพที่สูงขึ้นจากเทคนิค Lazy Execution, Compiler Optimizations และการประมวลผลผ่าน CPU แบบ Multithreaded
จากการทดสอบ Benchmark เปรียบเทียบกับ pandas โดยใช้ชุดข้อมูล 10 ล้านแถวใน 7 เวิร์กโหลดหลัก ผลลัพธ์ที่ได้น่าประทับใจอย่างยิ่ง โดยความแตกต่างที่โดดเด่นที่สุดคือการเรียงลำดับชุดข้อมูล ซึ่ง FireDucks ทำงานเสร็จ เร็วกว่า pandas ถึง 20.77 เท่า และมีค่าเฉลี่ยความเร็วเพิ่มขึ้นรวมทุกรายการอยู่ที่ 7.28 เท่า
FireDucks คืออะไร?
FireDucks คือไลบรารี DataFrame ที่เร่งความเร็วด้วยคอมไพเลอร์ พัฒนาโดย NEC ซึ่งถูกออกแบบมาให้ทำงานทดแทน pandas ได้เกือบสมบูรณ์เพียงแค่เปลี่ยนคำสั่ง import เท่านั้น
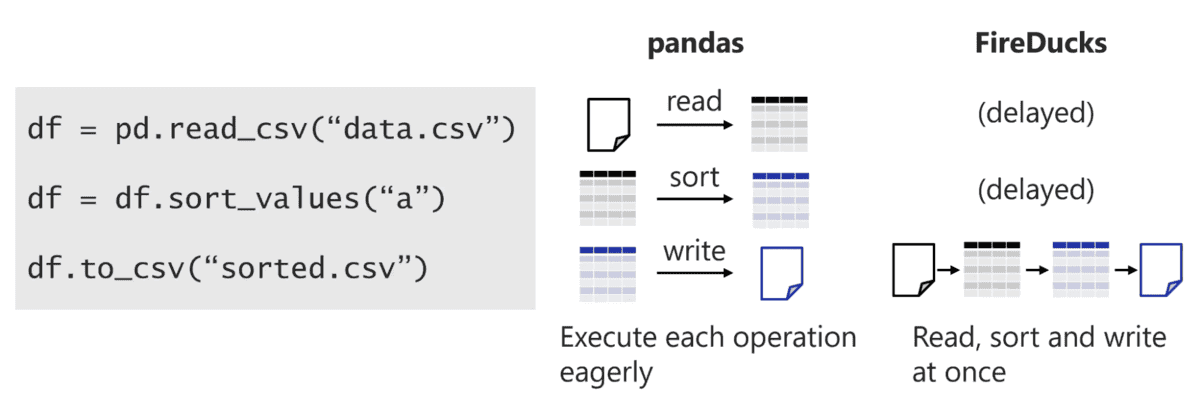
ภาพจาก Execution Model | FireDucks
ความแตกต่างสำคัญอยู่ที่วิธีประมวลผล ปกติ pandas จะรันแต่ละคำสั่งทันที (Eager Execution) แต่ FireDucks จะใช้ lazy execution ซึ่งจะรวบรวมลำดับการทำงานทั้งหมดมาสร้างเป็นแผนการประมวลผลที่เหมาะสมที่สุดก่อน แล้วจึงสั่งรันผ่านคอร์ CPU หลายตัวพร้อมกัน วิธีนี้ช่วยลดการคำนวณส่วนเกินและเพิ่มความเร็วในการจัดการข้อมูลขนาดใหญ่ได้อย่างมหาศาล
การเริ่มต้นใช้งาน FireDucks
คุณสามารถติดตั้ง FireDucks เวอร์ชันล่าสุดได้ง่ายๆ ผ่าน pip:
pip install -U fireducksเมื่อติดตั้งแล้ว เพียงเปลี่ยนการ import pandas ในโค้ดเดิมของคุณเป็นรูปแบบนี้:
import fireducks.pandas as pdจากนั้นคุณก็สามารถเขียนโค้ดต่อด้วยไวยากรณ์เดิมได้ทันที ตัวอย่างเช่น:
import fireducks.pandas as pd

df = pd.read_parquet("transactions.parquet")

result = (
    df[df["price"] > 100]
    .groupby("category", as_index=False)
    .agg(
        total_sales=("price", "sum"),
        average_price=("price", "mean"),
    )
    .sort_values("total_sales", ascending=False)
)

print(result)
ในการทำงานจริง FireDucks จะไม่รันทุกคำสั่งในทันที แต่จะรอจนกว่าจะมีการเรียกใช้ผลลัพธ์จริงๆ เช่น คำสั่ง print() ระบบถึงจะประมวลผลแผนงานที่ปรับแต่งมาแล้วอย่างรวดเร็ว
วิธีที่เราทำ Benchmark
เราทำการทดสอบบนชุดข้อมูล 10 ล้านแถว ร่วมกับตาราง lookup อีก 2 ล้านแถว โดยครอบคลุม 7 เวิร์กโหลดทั่วไป ได้แก่ การอ่าน Parquet, การกรอง, การจัดกลุ่ม (Low/High-cardinality), การเรียงลำดับ, การรวมตาราง และการประมวลผลแบบต่อเนื่อง (Chained Pipeline)
การทดสอบทำในสภาพแวดล้อม Linux โดยใช้ CPU AMD EPYC 9V74 (9 cores) และ RAM 15.93 GiB รันบน Python 3.12.13 เพื่อให้ได้ผลลัพธ์ที่แม่นยำที่สุด
ผลลัพธ์ Benchmark ระหว่าง pandas vs. FireDucks
| การดำเนินการ | ค่ามัธยฐาน pandas | ค่ามัธยฐาน FireDucks | ความเร็วที่เพิ่มขึ้น |
|---|---|---|---|
| อ่าน Parquet | 0.3243 วินาที | 0.1220 วินาที | 2.66 เท่า |
| กรองข้อมูลหลายคอลัมน์ | 0.5159 วินาที | 0.0444 วินาที | 11.63 เท่า |
| จัดกลุ่มแบบ Low-cardinality | 0.9061 วินาที | 0.0587 วินาที | 15.44 เท่า |
| จัดกลุ่มแบบ High-cardinality | 2.1634 วินาที | 0.3765 วินาที | 5.75 เท่า |
| เรียงลำดับชุดข้อมูลทั้งหมด | 15.2674 วินาที | 0.7352 วินาที | 20.77 เท่า |
| รวมตารางกับ lookup 2 ล้านแถว | 1.6886 วินาที | 0.5271 วินาที | 3.20 เท่า |
| Pipeline แบบต่อเนื่อง | 1.0418 วินาที | 0.1754 วินาที | 5.94 เท่า |
FireDucks สามารถทำให้ Pandas เร็วขึ้น 20 เท่าได้จริงหรือ?
คำตอบคือใช่ แต่ผลลัพธ์จะแตกต่างกันไปตามประเภทของงาน โดยความเร็วที่เพิ่มขึ้น 20.77 เท่า เกิดขึ้นในงานประเภทการเรียงลำดับข้อมูลจำนวนมาก ซึ่งสอดคล้องกับรายงานจาก Toyota Technical Development Corporation (TTDC) ที่นำไปใช้ในงาน AI และพบว่าช่วยลดเวลาการวิเคราะห์ข้อมูลได้ถึง 60-76%
แม้แต่นักวิทยาศาสตร์ข้อมูลอย่าง Avi Chawla ที่ทดสอบบน Google Colab ก็พบว่าความเร็วเพิ่มขึ้นถึง 4 เท่า ดังนั้นประสิทธิภาพที่แท้จริงจะขึ้นอยู่กับลักษณะข้อมูลและฮาร์ดแวร์ที่คุณใช้งานเป็นหลัก
บทสรุป
จุดเด่นของ FireDucks ไม่ได้มีแค่ตัวเลขความเร็ว แต่คือความง่ายในการเปลี่ยนผ่านจากโค้ดเดิม เพียงเปลี่ยนการ import ก็สามารถเพิ่มประสิทธิภาพได้ทันทีโดยเฉพาะในงานที่ต้องใช้พลังการประมวลผลสูงหรือการทำงานแบบขนาน
สำหรับนักวิเคราะห์ข้อมูลที่ต้องดีลกับชุดข้อมูลมหาศาล การประหยัดเวลาแม้เพียงเล็กน้อยในแต่ละ Pipeline หมายถึงการประหยัดต้นทุนและช่วยให้การทดลองงานวิจัยทำได้รวดเร็วยิ่งขึ้นในแต่ละวัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร