
TorchNeuron: รันโมเดล Hugging Face บน AWS Trainium ง่ายกว่าเดิม
TorchNeuron มอบ native backend ใหม่สำหรับ PyTorch บน AWS Trainium โดยที่ Transformers, Diffusers และ Kernels รองรับการทำงานนี้แบบ native ซึ่งช่วยให้การรันโมเดลบน Trainium และการแชร์โมเดลบน Hugging Face hub นั้นง่ายยิ่งกว่าที่เคย
TorchNeuron
TorchNeuron เป็นปลั๊กอิน PyTorch ที่นำเสนอ backend ใหม่สำหรับ Trainium เพื่อรองรับ eager mode, torch.compile และ native distributed APIs เช่น FSDP และ TP อ่าน blog ของ Pytorch เพื่อเรียนรู้เพิ่มเติมเกี่ยวกับ TorchNeuron
ตั้งแต่วันที่ 20 ต.ค. 2026 TorchNeuron จะเปิดให้ใช้งานในรูปแบบ public beta โดยนักวิจัยและนักพัฒนาจะสามารถติดตั้งได้ด้วยคำสั่ง pip install torch-neuronx
Backend ใหม่, native interface ในไลบรารี Hugging Face
จนถึงปัจจุบัน ประสบการณ์การใช้งาน Hugging Face บน AWS Trainium และ Inferentia ซึ่งเป็นชิป AI ที่ออกแบบมาเพื่อการฝึกสอน (training) และการอนุมาน (inference) ในระดับสเกลที่คุ้มค่า ได้ถูกส่งมอบผ่าน optimum-neuron ไลบรารีนี้พึ่งพาแพ็กเกจ torch-neuronx ที่ทำงานบน PyTorch XLA แม้จะเป็นทางเลือกที่เหมาะสมในขณะนั้น แต่ผู้ใช้จำเป็นต้องคิดแบบคอมไพเลอร์ เช่น การใช้ lazy tensors แทน eager mode หรือการรองรับเฉพาะ static shapes
TorchNeuron เข้ามาเปลี่ยนข้อจำกัดนี้ด้วยการรวมเข้ากับ PyTorch โดยตรง ทำให้มองเห็น neuron เป็น native device พร้อมรองรับ eager execution และ distributed primitives ของ PyTorch เองอย่าง DTensor หรือ FSDP2 ได้ทันที
สำหรับไลบรารี Hugging Face นั้น Trainium จะกลายเป็นอุปกรณ์มาตรฐานเหมือนตัวเร่งความเร็วอื่นๆ ทั้ง Transformers, Diffusers, Accelerate, PEFT และ TRL สามารถรันบนอุปกรณ์นี้ได้โดยตรงผ่านคลาสและสคริปต์ชุดเดิม จากนี้ไปเราจึงแนะนำให้ผู้ใช้ Neuron เปลี่ยนมาใช้ไลบรารีเหล่านี้โดยตรงแทนการผ่าน Optimum Neuron
Transformers
Inference
ขณะนี้ Transformers รองรับการสร้างข้อความ (Text generation) แบบ native สำหรับโมเดลที่หลากหลาย โดยสถาปัตยกรรมยอดนิยม 100 อันดับแรกถึง 89% สามารถใช้งานผ่าน TorchNeuron ได้ทันที (out of the box) เพิ่มขึ้นจาก 46% ในเวอร์ชันเดิม คุณเพียงแค่ระบุอาร์กิวเมนต์ device_map="neuron" ในโค้ดเพื่อย้ายโมเดลไปยังอุปกรณ์ Neuron
ตัวอย่างการทำ text-generation ด้วย tensor parallelism เพื่อประสิทธิภาพสูงสุดบนอินสแตนซ์ Neuron โดยมีการใช้ static cache เพื่อป้องกันการ compile ใหม่บ่อยครั้ง:
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
Training เนื่องจาก Neuron เป็น native PyTorch device การฝึกสอนบน Trainium จึงใช้ไลบรารีมาตรฐานเดียวกับ GPU ได้เลย ไม่จำเป็นต้องมี trainer เฉพาะทางหรือโค้ดที่ปรับแต่งมาเพื่อ Neuron โดยเฉพาะ สคริปต์ fine-tuning ของ TRL สามารถใช้งานได้ทันทีเพียงตั้งค่าบางอย่างเพิ่มเติม
นี่คือตัวอย่างสคริปต์ supervised fine-tuning ที่สร้างขึ้นบน SFTTrainer ของ TRL:
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser

def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

# Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

# Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()

if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
Parallelism จะถูกจัดการแบบ native ผ่าน Transformers โดยการระบุ DistributedConfig ใน model_init_kwargs เพื่อแบ่งส่วนโมเดล (sharded) ขณะโหลดน้ำหนัก โดยไม่จำเป็นต้องใช้ flag --fsdp หรือตั้งค่า Accelerate เพิ่มเติม
สำหรับการใช้งานบน Trainium มีข้อควรทราบดังนี้:
- Static shapes: สคริปต์จะปิดการใช้งาน automatic dynamic shapes และใช้การเติม padding ให้เป็นผลคูณของ 128 tokens เพื่อลดความจำเป็นในการ compile ใหม่
- เปิดใช้
torch.compile: เพียงส่งค่า--torch_compile trueระบบจะตรวจจับอุปกรณ์และเลือก Neuron backend ให้อัตโนมัติ - ปิดการโหลดน้ำหนักแบบ Async: ปัจจุบันต้องตั้งค่า
HF_DEACTIVATE_ASYNC_LOAD=1เนื่องจาก Neuron ยังไม่รองรับฟีเจอร์นี้
ตัวอย่างคำสั่งเริ่มการฝึกสอนด้วย torchrun เพื่อกระจายงานไปยัง 32 NeuronCores:
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
จากการทดสอบบนชิป Trainium2 จำนวน 8 ตัว (32 NeuronCores) การฝึกสอนสำเร็จเรียบร้อยและสามารถบันทึกโมเดลเป็นมาตรฐานของ Transformers เพื่อนำไปใช้งานบนฮาร์ดแวร์อื่นๆ หรืออัปโหลดขึ้น Hugging Face Hub ได้ตามปกติ
Diffusers
Inference
ไปป์ไลน์จำนวนมากใน Diffusers เช่น FLUX.1, Qwen-Image และ H3 รองรับการทำงานร่วมกับ TorchNeuron ทั้งในโหมด eager และ compiled พร้อมรองรับ tensor parallelism เพื่อดึงประสิทธิภาพของชิป Neuron ออกมาได้สูงสุด
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
รันโค้ดดังกล่าวด้วยคำสั่ง: NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py ทั้งนี้จะมีการอัปเดตให้ไปป์ไลน์อื่นๆ รองรับ TP เพิ่มเติมในอนาคต
Kernels
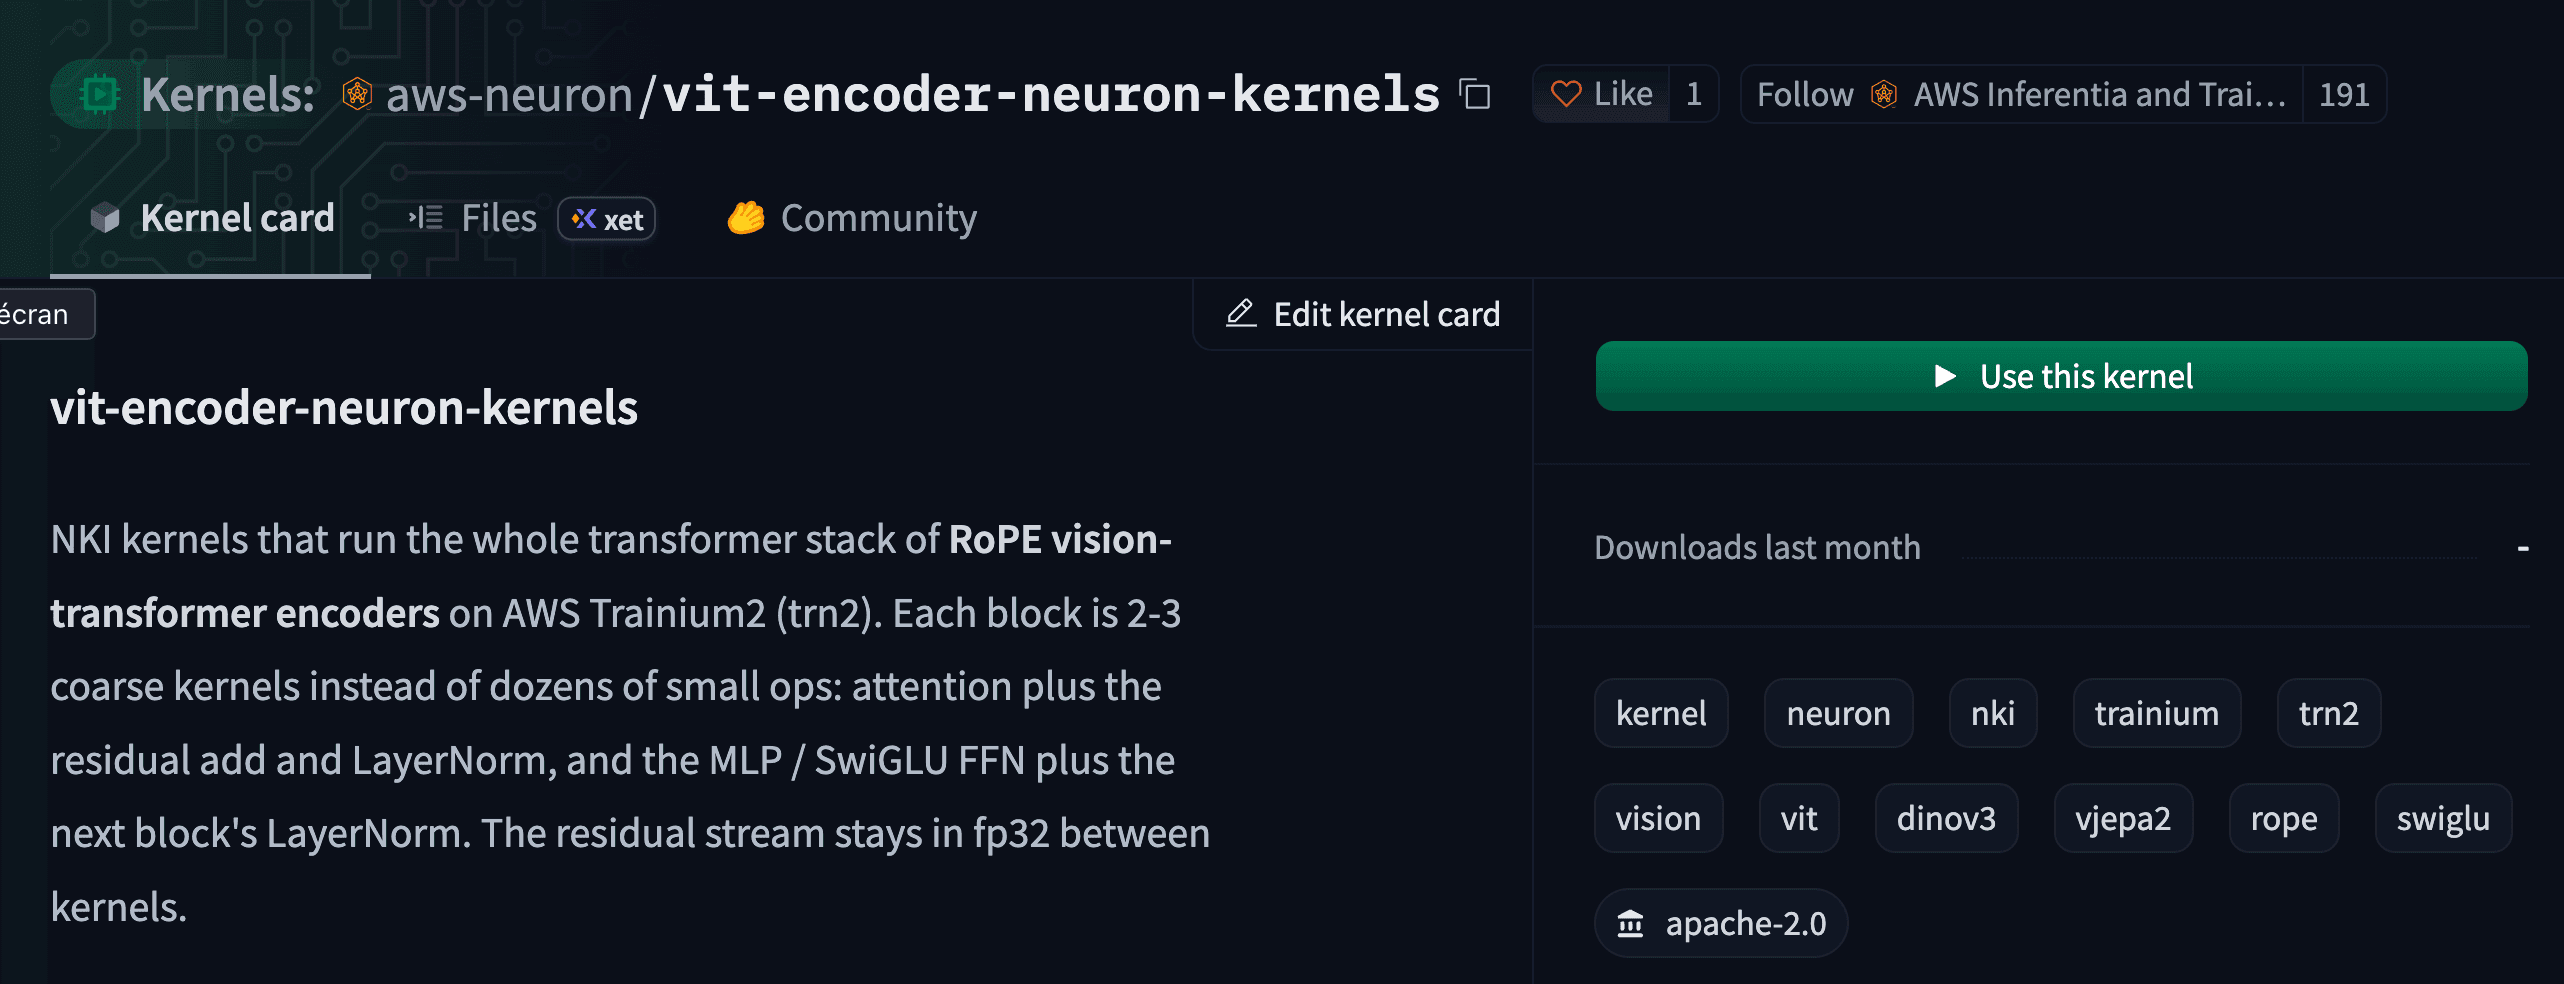
นักพัฒนาสามารถเข้าถึง kernels จากทีม Neuron บน Hub เพื่อช่วยเร่งความเร็วโมเดล โดยเขียนผ่าน Neuron Kernel Interface (NKI) ซึ่งให้การควบคุมในระดับต่ำเพื่อปรับแต่งการทำงานได้ตามต้องการ
ตัวอย่างเช่น การใช้ kernel นี้ จะช่วยเพิ่มความเร็วให้ vision transformers ได้สูงสุดถึง 2.4 เท่าบน Trainium!
การแสดงความขอบคุณ
ขอขอบคุณเป็นพิเศษสำหรับทีม AWS ที่พัฒนา TorchNeuron และทำงานร่วมกับเราในการบูรณาการเข้ากับ Hugging Face อย่างมีประสิทธิภาพสูงสุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร