
Google เปิดตัวระบบ Federated Learning ยุคใหม่ ปลอดภัยด้วย TEE
ในปี 2017 Google ได้เปิดตัว Federated Learning (FL) ซึ่งเป็นเทคนิคการเรียนรู้ของเครื่องที่ฝึกฝนโมเดลผ่านข้อมูลส่วนตัวแบบกระจายศูนย์ เทคนิคนี้ถูกนำไปใช้ในฟีเจอร์ที่เราคุ้นเคยอย่าง การทำนายคำถัดไป และ Smart Compose บน Gboard รวมถึง การแนะนำคำตอบ ใน Google Messages และ Smart Text Selection บน Android
การพัฒนาระบบ FL ของ Google ยึดตามหลักความเป็นส่วนตัว 4 ประการ ได้แก่ การลดการใช้ข้อมูล, การทำให้ข้อมูลเป็นนิรนาม, ความโปร่งใสและการควบคุม รวมถึงการตรวจสอบได้และภาระรับผิดชอบ ในปี 2025 Google ได้ นำเสนอ นิยามใหม่ของ FL ที่มุ่งเน้นให้ผู้ใช้งานสามารถควบคุมข้อมูลและตรวจสอบคุณสมบัติการทำนิรนามได้อย่างเต็มรูปแบบ
ล่าสุดในบทความ "Toward provably private learning from federated data" Google ได้ประกาศเปิดตัวระบบ FL ยุคถัดไปที่ใช้ประโยชน์จาก Trusted Execution Environments (TEEs) เพื่อให้การรับประกันความเป็นส่วนตัวที่ตรวจสอบและพิสูจน์ได้จริง โดยตรรกะที่รันใน TEEs จะได้รับการรับรองความลับและความถูกต้องสมบูรณ์ ระบบใหม่นี้ถูกนำไปใช้แล้วใน Gboard ซึ่งช่วยให้ประมวลผลได้รวดเร็วกว่าระบบเดิมอย่างมาก
การสร้างระบบ FL ที่มีความเป็นส่วนตัวแบบตรวจสอบได้จาก TEE แต่ละตัว
ระบบ FL ที่ใช้ TEE ของเราพัฒนาต่อยอดมาจากงานวิจัยด้าน confidential federated analytics และ provably private insights โดยมีกลไกการดำเนินงานหลัก 4 ส่วน:
- การอัปโหลดข้อมูล: อุปกรณ์จะเข้ารหัสข้อมูลการฝึกฝนและให้สิทธิ์เข้าถึงตามนโยบาย (access policy) ที่กำหนดไว้ ซึ่งนโยบายนี้จะถูกเผยแพร่ไปยังบันทึกความโปร่งใสสาธารณะ
- KMS และการตรวจสอบนโยบาย: ระบบจัดการคีย์ (KMS) ที่ใช้ RAFT consensus protocol จะมอบคีย์ถอดรหัสให้เฉพาะภาระงานที่ตรงตามนโยบายเท่านั้น
- การดำเนินงานภาระงาน: TEE จะรันโปรแกรม Python ผ่าน Federated Language ซึ่งพัฒนามาจาก TensorFlow Federated เพื่อปล่อยค่าน้ำหนักโมเดลที่ทำนิรนามแล้วออกมา
- การกู้คืนความเสียหาย: มีการบันทึกสถานะการกู้คืนที่เข้ารหัสโดย KMS เพื่อป้องกันข้อมูลรั่วไหลหากระบบเกิดความล้มเหลว
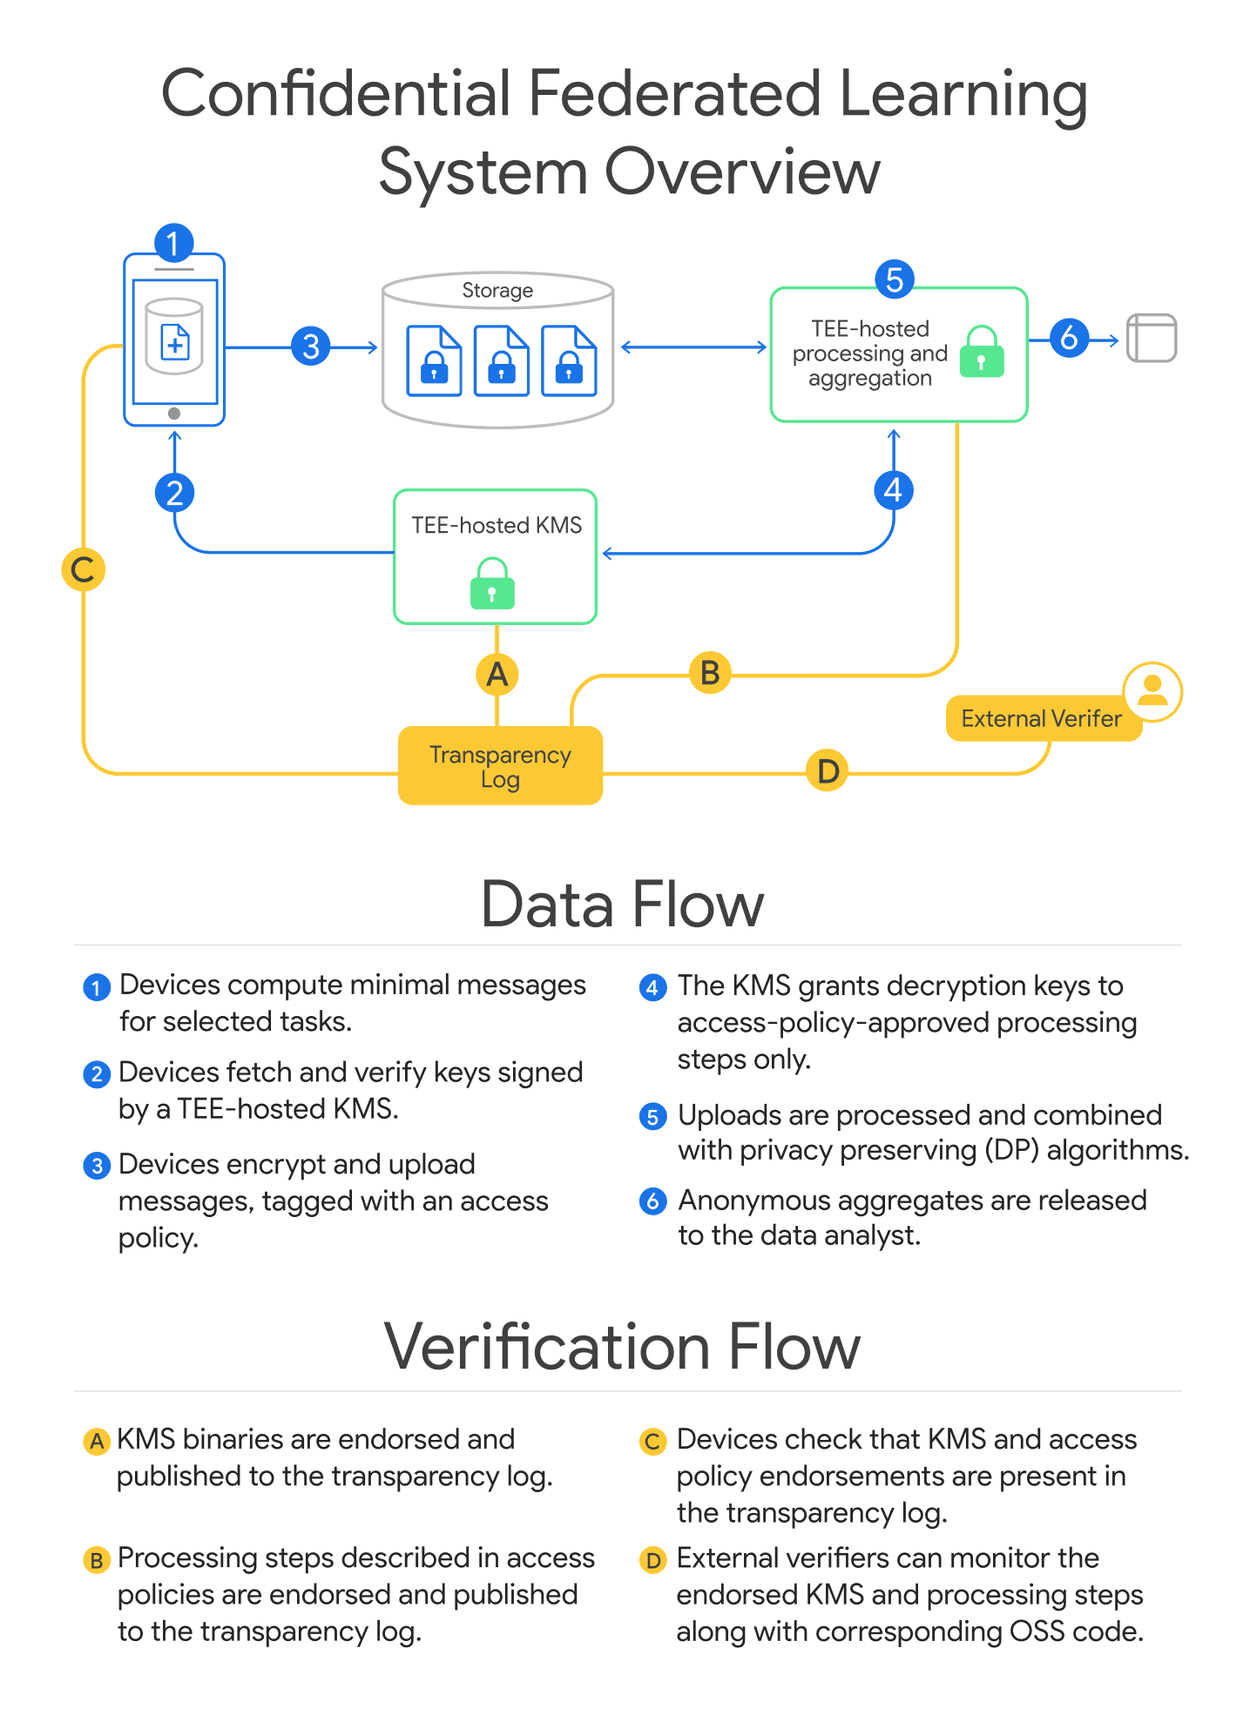
แผนภาพนี้แสดงทั้งการไหลของข้อมูลผ่านระบบและขั้นตอนที่จำเป็นในการตรวจสอบการรับประกันความเป็นส่วนตัวของภาระงานที่รันบนระบบ
สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับการออกแบบระบบ FL ที่ใช้ TEE โปรดดูสมุดปกขาว Toward provably private learning from federated data
ระบบ FL ที่ใช้ TEE เสริมสร้างความเป็นส่วนตัวได้อย่างไร
ในระบบยุคแรก ข้อมูลที่ถูกอัปโหลดเพื่อรวมผล (aggregation) ไม่สามารถตรวจสอบย้อนกลับได้ว่ามีการบันทึกข้อมูลไว้หรือไม่ แม้ภายหลังจะมีเทคนิค Secure Aggregation แต่ยังไม่สามารถเข้ากันได้กับการ รับประกัน DP ส่วนกลางระดับสูงสุด ระบบใหม่นี้จึงถูกออกแบบมาเพื่อลดความจำเป็นในการไว้วางใจผู้ดูแลเซิร์ฟเวอร์
ในระบบนี้ ผู้ดูแลจะมองเห็นได้เฉพาะค่าน้ำหนักโมเดลที่มีความเป็นส่วนตัวแบบผลต่าง (DP) เท่านั้น ข้อมูลดิบจะถูกถอดรหัสและประมวลผลได้เฉพาะใน TEE ตามเวลาที่กำหนดในนโยบายการเข้าถึง
บันทึกความโปร่งใสสาธารณะและการสร้างที่ทำซ้ำได้
นโยบายการเข้าถึงข้อมูลจะถูกเผยแพร่ผ่าน Rekor ซึ่งเป็นบันทึกสาธารณะที่ผู้ตรวจสอบภายนอกสามารถติดตามได้ นอกจากนี้ ไบนารีของระบบยังสามารถสร้างซ้ำได้จากซอร์สโค้ดโอเพนซอร์สใน GitHub Confidential Federated Compute
การประมวลผลที่ตรวจสอบได้ด้วยการโหลดข้อมูลแบบไดนามิก
ระบบใหม่ใช้โปรแกรม Python ระบุตรรกะการฝึกฝนผ่าน Rekor โดยตรง เพื่อปกป้องสถาปัตยกรรมโมเดลที่เป็นกรรมสิทธิ์ TEE จึงรองรับการโหลดข้อมูลแบบซีเรียลไลซ์ขณะรัน (runtime) ช่วยให้การรับประกันความเป็นส่วนตัวยังตรวจสอบได้จากภายนอก แม้จะมีการปกป้อง การสังเกตช่องทางข้างเคียง อยู่ก็ตาม
Gboard ใช้งาน FL ที่ใช้ TEE อย่างไร
Gboard ได้นำระบบนี้ไปใช้กับโมเดลทำนายคำถัดไปภาษาอังกฤษและภาษาญี่ปุ่น ซึ่งช่วยให้ได้โมเดลที่มีความแม่นยำสูงขึ้นพร้อมความเป็นส่วนตัวที่แข็งแกร่ง
การลดข้อจำกัดด้านความพร้อมใช้งานตามช่วงเวลาของวัน
ระบบใหม่ช่วยลดปัญหา ความผันผวนตามช่วงเวลาของวัน ในการเข้าถึงอุปกรณ์ โดยเซิร์ฟเวอร์สามารถคำนวณตารางการเข้าร่วมของอุปกรณ์ที่เหมาะสมที่สุดเพื่อปรับแต่งพารามิเตอร์ DP ได้ทันที
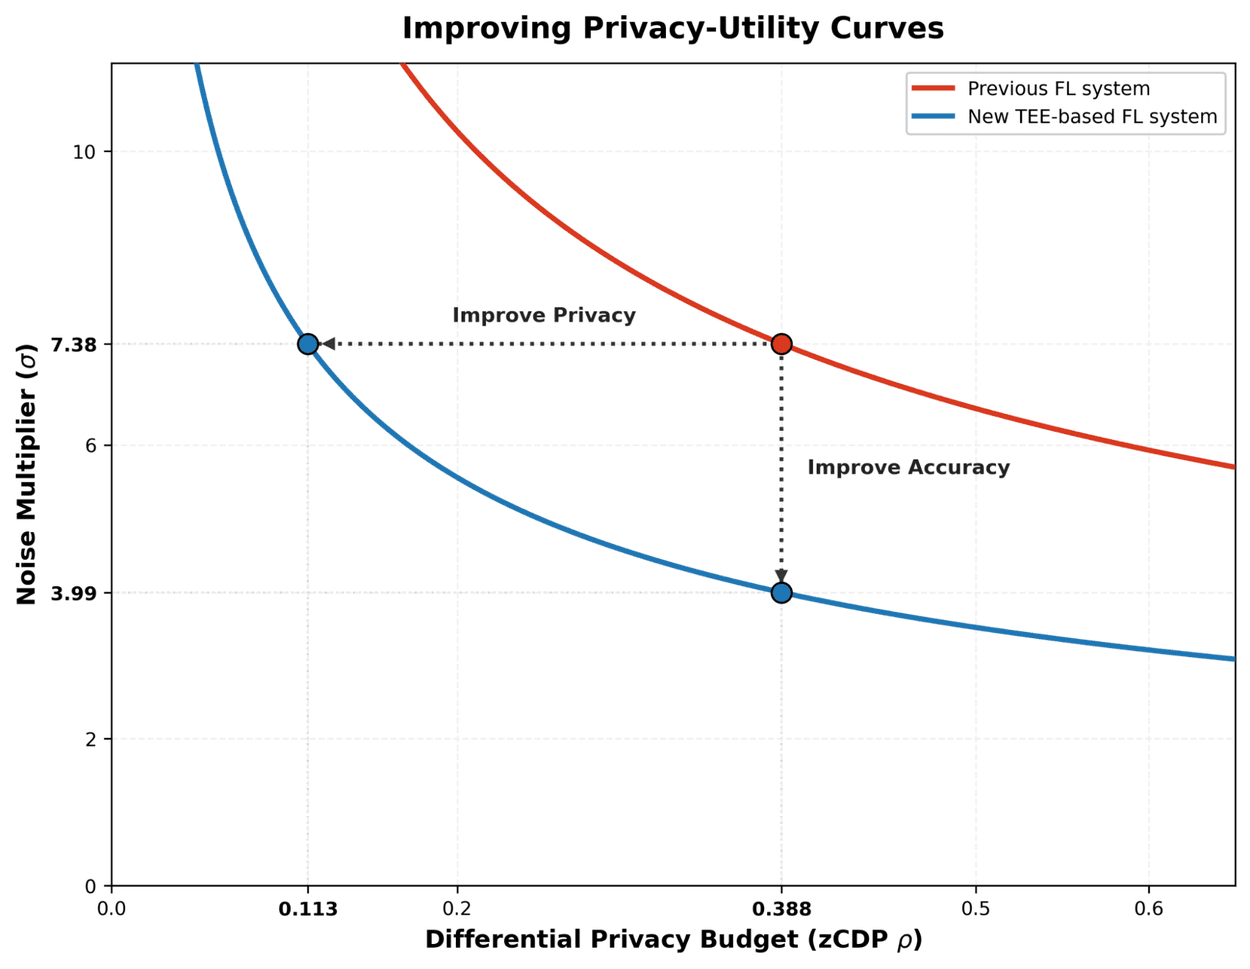
กราฟแสดงให้เห็นว่าระบบ TEE ใหม่ให้ความเป็นส่วนตัวที่แข็งแกร่งกว่าและมีสัญญาณรบกวนน้อยกว่าจากการปรับตารางการเข้าร่วมอุปกรณ์ให้เหมาะสม
ความเร็วในการฝึกฝนที่เพิ่มขึ้น
เดิมการฝึกฝนโมเดล FL อาจใช้เวลานานถึง 1-2 เดือนเนื่องจากข้อจำกัดด้านทรัพยากรบนตัวเครื่อง แต่ระบบใหม่ได้ย้ายการคำนวณมาไว้ที่เซิร์ฟเวอร์ TEE ทำให้สามารถประมวลผลแบบขนานและเพิ่มความเร็วในการฝึกฝนได้อย่างมหาศาล
ขั้นตอนต่อไปคืออะไร?
การย้ายการคำนวณความชัน (gradients) มาที่เซิร์ฟเวอร์ช่วยขจัดข้อจำกัดเดิมและเปิดทางสู่การฝึกฝนโมเดลขนาดใหญ่ขึ้น โดย Google กำลังทดลองใช้โครงสร้างพื้นฐานนี้กับงานอื่นๆ เช่น การสร้างข้อมูลสังเคราะห์และการอนุมาน LLM (LLM inference)
ความสำเร็จนี้เป็นก้าวสำคัญสู่การพิสูจน์ความปลอดภัยในการประมวลผลฝั่งเซิร์ฟเวอร์ ซึ่งจะช่วยสร้างความมั่นใจว่าข้อมูลส่วนบุคคลจะถูกจัดการอย่างถูกต้องตามที่ระบุไว้ทุกประการ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร