
Allen Institute เปิดตัว AstaBrief 8B โมเดลสร้างรายงานวิจัยฉบับเปิด
โมเดลภาษาสามารถช่วยนักวิจัยในการค้นหาเอกสาร สังเคราะห์หลักฐาน และตอบคำถามที่ซับซ้อนได้แล้ว แต่การทำงานทางวิทยาศาสตร์มีความต้องการเฉพาะเจาะจงที่สูงกว่านั้น โดยคำตอบจำเป็นต้องยึดโยงกับหลักฐานอย่างเคร่งครัด แทนที่จะขยายข้อสรุปเอาเอง และต้องช่วยให้นักวิจัยสามารถตรวจสอบผลลัพธ์สุดท้ายได้จริง
เราพบพฤติกรรมนี้จากการที่นักวิทยาศาสตร์ใช้งาน Asta ซึ่งเป็นแพลตฟอร์มเชิง agentic สำหรับงานวิจัย แทนที่จะค้นหาด้วยคีย์เวิร์ดแบบง่าย ผู้ใช้มักระบุบริบทและข้อจำกัดจำนวนมาก เช่น การขอให้เปรียบเทียบวิธีการวิจัยโดยคำนึงถึงประชากรหรือสภาพแวดล้อมที่กำหนด หลายคนยังนำรายงานที่สร้างขึ้นไปใช้งานต่อเป็นงานวิจัยหลักมากกว่าจะเป็นแค่คำตอบชั่วคราว
เราต้องการช่วยให้นักวิทยาศาสตร์สร้างรายงานที่มีการอ้างอิงได้เร็วขึ้นด้วยโมเดลที่สามารถดาวน์โหลดไปรันได้เอง ทีมงานจึงทดสอบว่าโมเดลขนาดเล็กแบบเปิด (open model) ที่เทรนมาเพื่อการสร้างรายงานวิทยาศาสตร์โดยเฉพาะ จะสามารถเทียบชั้นคุณภาพกับโมเดลแบบกรรมสิทธิ์ (proprietary models) ได้หรือไม่ ในขณะที่ลดเวลาและค่าใช้จ่ายในการให้บริการ
ผลลัพธ์ที่ได้คือ AstaBrief 8B โมเดลที่เปลี่ยนคำถามวิจัยและข้อความจากเอกสารให้กลายเป็นรายงานที่มีการอ้างอิง ปัจจุบันเปิดให้ใช้งานแล้วในฟีเจอร์ Generate a report ของ Asta ผ่านทาง Fast mode เคียงคู่กับ Thinking mode เดิม และเรายังเปิดซอร์สโมเดลพร้อมข้อมูลการเทรนเพื่อให้ผู้อื่นนำไปศึกษาต่อยอดได้
การพัฒนา AstaBrief ต้องใช้คำถามวิจัยจริงหลายหมื่นรายการ การกรองข้อมูลที่เน้นการอ้างอิง และการออกแบบ pipeline ใหม่ที่เขียนรายงานฉบับเต็มในการรันครั้งเดียว ส่งผลให้เวลาการสร้างรายงานลดลงเกือบหนึ่งเท่าตัว (order-of-magnitude) โดยใน Fast mode ใช้เวลาเฉลี่ยเพียง 51.1 วินาทีต่อรายงาน เมื่อเทียบกับ 178.5 วินาทีใน Thinking mode ซึ่งเร็วกว่าประมาณ 3.5 เท่า
ประสิทธิภาพที่เพิ่มขึ้นนี้ทำให้ AstaBrief เป็นกรณีทดสอบที่สำคัญสำหรับการสร้างโมเดลภาษาแบบเปิดที่ปรับแต่งตามความต้องการเฉพาะทางวิทยาศาสตร์
การเปิด Weight โมเดลยังช่วยให้สถาบันต่างๆ สามารถรัน AstaBrief บนโครงสร้างพื้นฐานของตนเองได้ ซึ่งจำเป็นมากสำหรับงานวิจัยที่ละเอียดอ่อนหรือยังไม่ได้ตีพิมพ์ นอกจากน้ำหนักโมเดลแล้ว เรายังเผยแพร่ ตัวอย่าง workflow ที่นักวิจัยสามารถปรับใช้เพื่อสร้างรายงานจากไฟล์ PDF ของตนเอง เพื่อเป็นจุดเริ่มต้นสำหรับการใช้งานแบบ Local
เนื้อหาต่อไปนี้จะครอบคลุมถึงวิธีเทรน AstaBrief บทเรียนเรื่องการทำให้โมเดลยึดโยงกับหลักฐาน และแนวทางที่สามารถนำไปใช้กับโมเดลวิทยาศาสตร์ในอนาคต โดยการเทรนและการประเมินส่วนใหญ่เสร็จสิ้นในปี 2025 ดังนั้นผลลัพธ์ที่แสดงด้านล่างควรพิจารณาในฐานะหลักฐานเชิงการออกแบบระบบเฉพาะที่เราได้ทดสอบในช่วงเวลานั้น
การฝึกฝนโมเดล (Training the model)
เป้าหมายของ AstaBrief คือการสร้างโมเดล open-weights ที่มีคุณภาพคำตอบ ความเกี่ยวข้อง โครงสร้าง และการยึดโยงกับการอ้างอิงครบถ้วนสำหรับการสังเคราะห์งานวิจัยระยะยาว เราเริ่มต้นจาก Qwen3-8B และทุ่มเทไปที่ข้อมูลหลังการเทรน (post-training data) และโครงสร้างสนับสนุนการสร้างรายงาน
การปรับเปลี่ยนโมเดลอเนกประสงค์เพื่อการค้นพบทางวิทยาศาสตร์เป็นสิ่งที่ Ai2 กำลังสำรวจผ่านโครงการ NSF OMAI ซึ่งเป็นโครงสร้างพื้นฐาน AI ระดับชาติของสหรัฐฯ นักวิจัยของเราทำงานร่วมกับชุมชนวิทยาศาสตร์เพื่อทำความเข้าใจจุดที่โมเดลทั่วไปยังขาดตกบกพร่อง โดยจะมีผลการวิจัยเพิ่มเติมแบ่งปันในอนาคต
งานวิจัยล่าสุดรวมถึง DR Tulu แสดงให้เห็นว่าการเรียนรู้แบบเสริมกำลัง (RL) สามารถปรับปรุงการสร้างรายงานได้ แต่สำหรับ AstaBrief เราเลือกใช้สูตรที่เรียบง่ายกว่าอย่าง Supervised Fine-Tuning (SFT) และ Direct Preference Optimization (DPO) เนื่องจาก RL อาจไม่เสถียรและมีราคาแพง เราจึงต้องการทดสอบขีดจำกัดของคุณภาพด้วยการตั้งค่าที่จัดการง่ายและดีบั๊กได้สะดวกกว่า
คุณภาพของข้อมูลการเทรนจึงมีความสำคัญเป็นพิเศษ เราใช้เวลาส่วนใหญ่ไปกับการคัดเลือกและกรองตัวอย่างที่แสดงพฤติกรรมการเขียนรายงานที่ต้องการจริงๆ แทนการพึ่งพาวิธีเพิ่มประสิทธิภาพที่ซับซ้อน
นอกจากนี้ เรายังปรับปรุงความเร็วโดยให้ AstaBrief สร้างรายงานฉบับสุดท้ายโดยตรงจากการรันครั้งเดียว ข้ามขั้นตอนการสรุปข้อความ (snippet summarization) และการจัดกลุ่มที่ซับซ้อนซึ่งใช้ในระบบเดิม ซึ่งพบว่าสามารถเพิ่มความเร็วได้โดยไม่สูญเสียประสิทธิภาพ
การรวบรวมข้อมูลฝึกฝน SFT (Collecting SFT training data)
Pipeline การเทรนเริ่มต้นด้วยคำถามจากผู้ใช้จริงผ่านระบบที่อธิบายไว้ในงานวิจัย “Synthesizing scientific literature with retrieval-augmented LMs” และ ScholarQA เราต้องการให้ AstaBrief เรียนรู้จากโจทย์จริงของนักวิทยาศาสตร์ แทนที่จะใช้แค่ข้อมูลสังเคราะห์หรือ Benchmark ทั่วไป
งานวิจัยของเราพบว่า นักวิทยาศาสตร์มักถามคำถามที่ต่างจากแชทบอททั่วไป จากการวิเคราะห์คำถามหลายแสนรายการ พบว่าผู้เชี่ยวชาญมักระบุบริบทและข้อจำกัดที่ซับซ้อนมากกว่าการใช้คีย์เวิร์ดสั้นๆ
การศึกษาผู้ใช้ล่าสุดยังชี้ให้เห็นว่า นักวิจัยต้องการความสามารถในการติดตามแหล่งที่มาที่ชัดเจนและการควบคุมบริบทที่โมเดลใช้ได้มากขึ้น
เรากรอง Log ของผู้ใช้เพื่อคุณภาพและความเป็นส่วนตัว โดยตัดข้อมูลจาก Bot และคำถามที่สั้นเกินไปออก พร้อมใช้ LLM กรองคำถามที่ไม่ใช่เชิงวิทยาศาสตร์หรือมีข้อมูลส่วนบุคคล จนเหลือคำถามวิจัยคุณภาพ 90,000 รายการ สำหรับ SFT เราสร้างรายงานเป้าหมายผ่าน Pipeline ของ ScholarQA โดยใช้โมเดลกรรมสิทธิ์หลายตัว เช่น Claude 3.5/3.7 Sonnet, o3, o4-mini และ GPT-4.1 จนได้ตัวอย่างที่สมบูรณ์ 47,000 รายการ
การสร้างคู่ข้อมูล DPO (Creating DPO pairs)
DPO ต้องการข้อมูลแบบคู่ (Pairs) เพื่อเปรียบเทียบว่ารายงานฉบับใดดีกว่ากัน เราสร้างคู่นี้จากคำถามย่อยที่ไม่ซ้ำกับชุด SFT โดยเปรียบเทียบระหว่างรายงานจาก ScholarQA เดิม กับรายงานที่สร้างโดยโมเดลอื่นๆ เช่น DeepSeek-V3 หรือ DeepSeek-R1
เราใช้ GPT-4.1 และ DeepSeek-R1 เป็นผู้ตัดสิน โดยเลือกเก็บเฉพาะคู่ที่โมเดลผู้ตัดสินทั้งสองเห็นตรงกัน ซึ่งมีความสอดคล้องกับความชอบของมนุษย์สูงถึง 95% วิธีนี้ช่วยให้ได้ชุดข้อมูลที่สะอาดและลดสัญญาณรบกวน จนได้ข้อมูล DPO สุดท้ายประมาณ 6,000 ตัวอย่าง
การใช้ผู้ตัดสินสองตัวช่วยให้เราได้ข้อมูลความชอบที่มีคุณภาพโดยไม่ต้องยึดติดกับเอาต์พุตของโมเดลใดโมเดลหนึ่งเป็นความจริงสูงสุด
การกรองข้อมูลเพื่อการอ้างอิงที่แม่นยำ (Filtering data for better attribution)
เราใช้ SQABench-CS2 ซึ่งเป็นคำถามด้านวิทยาการคอมพิวเตอร์ 200 ข้อ เป็นเกณฑ์ประเมินหลัก โดยติดตามตัวชี้วัด 4 ด้าน: Rubric score, Answer precision, Citation precision และ Citation recall
นอกจากนี้ยังประเมินด้วย DeepScholarBench และการเปรียบเทียบแบบคู่ (pairwise) ผ่านสายตามนุษย์และ LLM เพื่อตรวจสอบว่ารายงานมีความแม่นยำ ไม่กล่าวเกินจริงจากสิ่งที่หลักฐานระบุไว้
การสรุปเหมารวม (Generalization bias) เป็นปัญหาสำคัญในงานวิจัย เช่น การเปลี่ยนผลลัพธ์เฉพาะกลุ่มเป็นข้ออ้างทั่วไป หรือเปลี่ยนรูปอดีตเป็นความจริงสากล ตัวชี้วัดของเราจึงเน้นไปที่ความซื่อตรงต่อหลักฐานต้นฉบับ
ในการรัน SFT ครั้งแรก เราพบว่าความแม่นยำยังตามหลังระบบที่ใช้ Claude เราจึงเพิ่มตัวกรองทางสถิติ 4 ตัวเพื่อคัดกรองข้อมูลสังเคราะห์:
- Output-to-input token ratio: คัดออกหากสร้างข้อความเยอะเกินหลักฐานที่มี
- Citation relevance: ดูคะแนนความเกี่ยวข้องของบทความที่อ้างอิง
- Citation density: วัดสัดส่วนข้อความที่มีการอ้างอิงสนับสนุน
- Citation diversity: ดูความหลากหลายของบทความที่ถูกนำมาอ้างอิง
เราพบว่าการกรองรายงานที่มี Citation density (ความหนาแน่นการอ้างอิง) ต่ำออกไปให้ผลดีที่สุด ซึ่งพิสูจน์ว่าสัญญาณที่เรียบง่ายมักมีประสิทธิภาพมากกว่าการใช้ตัวกรองที่ซับซ้อนเกินไป คุณภาพของข้อมูล Post-training จึงเป็นกุญแจสำคัญที่เปลี่ยนประสิทธิภาพของโมเดลได้อย่างมีนัยสำคัญ
เมื่อได้จุดตรวจสอบ SFT ที่แข็งแกร่งและผ่านการเทรน DPO เพิ่มเติม AstaBrief จึงมีคุณภาพที่ใกล้เคียงกับระบบที่ใช้ Claude และ DR Tulu ในที่สุด
การตรวจสอบประสิทธิภาพ (Validating the approach)
คำถามหลักคือ AstaBrief สามารถรักษาคุณภาพรายงานในขณะที่ทำงานได้เร็วและประหยัดกว่าได้หรือไม่
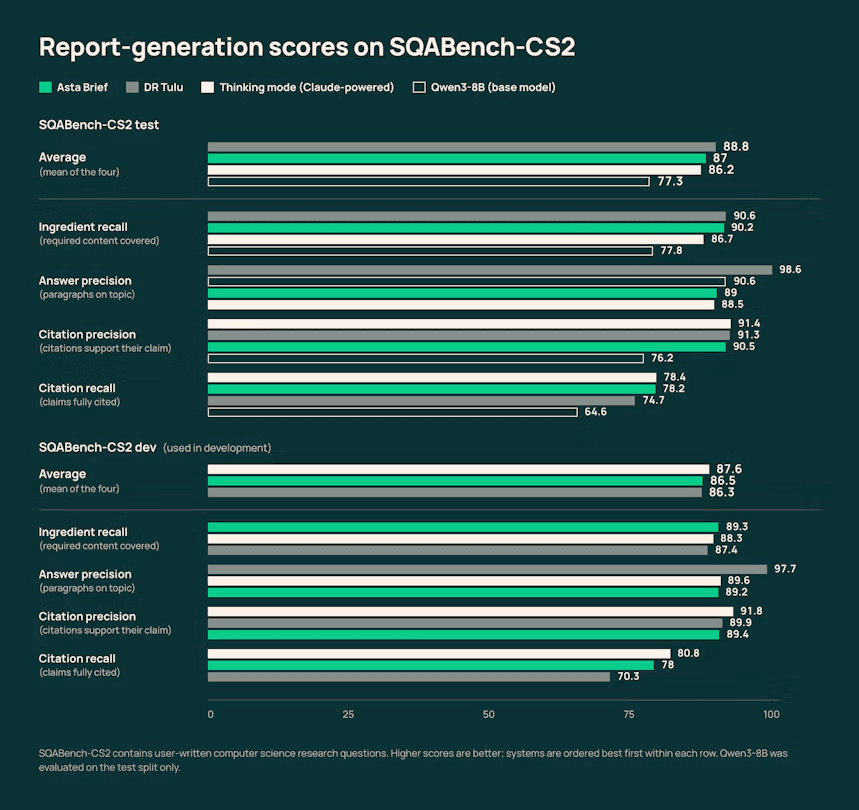
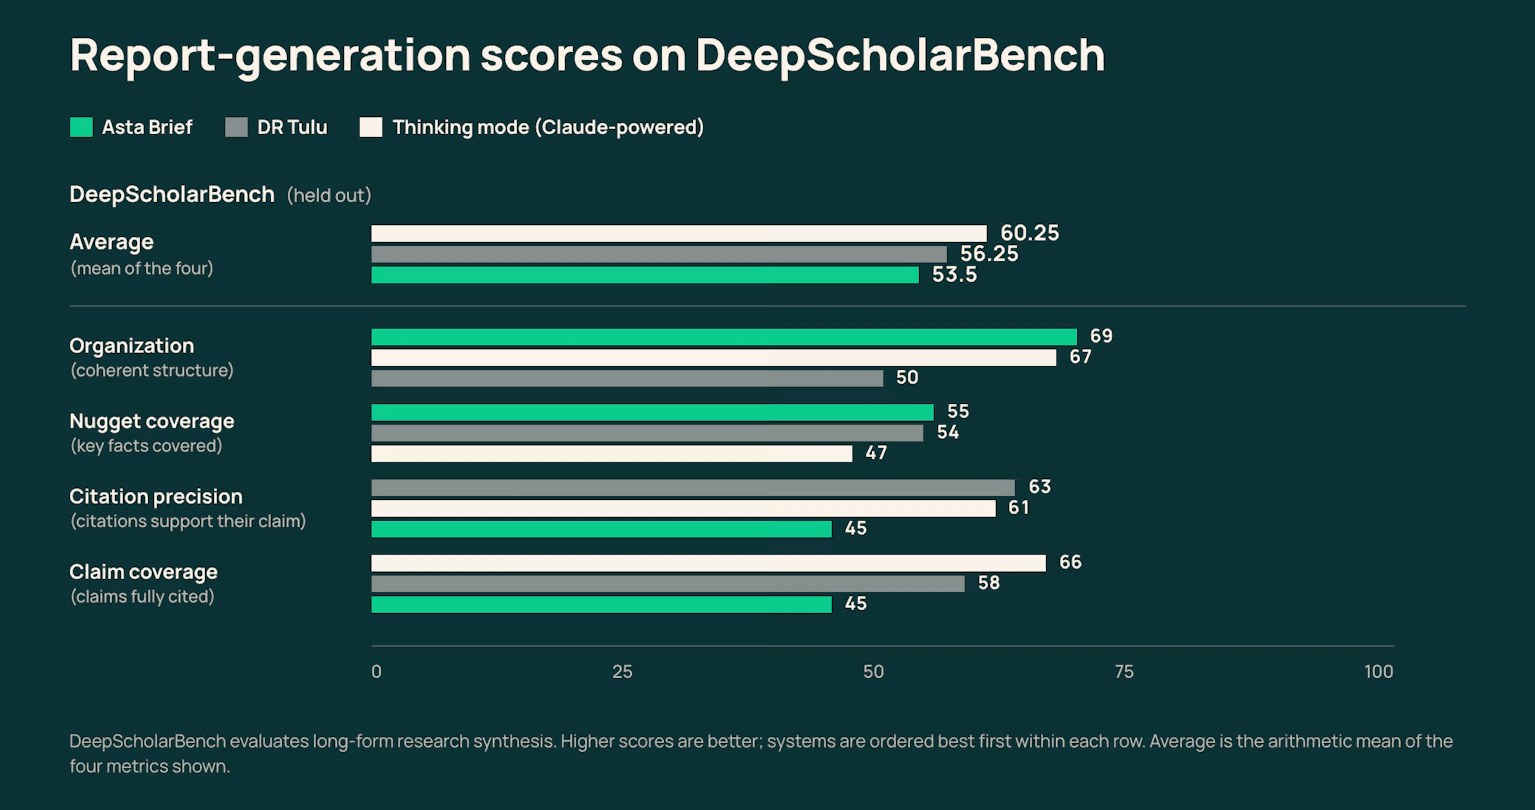
ผลการประเมินจากตารางแสดงให้เห็นว่า AstaBrief 8B มีความสามารถในการแข่งขันสูงใน SQABench-CS2 และ DeepScholarBench
ในการประเมินโดยมนุษย์ นักวิจัย 2 ใน 3 ชอบ AstaBrief มากกว่าระบบอื่นในด้านความแม่นยำของการอ้างอิง ซึ่งยืนยันถึงความสำเร็จของการใช้ตัวกรองคุณภาพข้อมูล SFT ของเรา
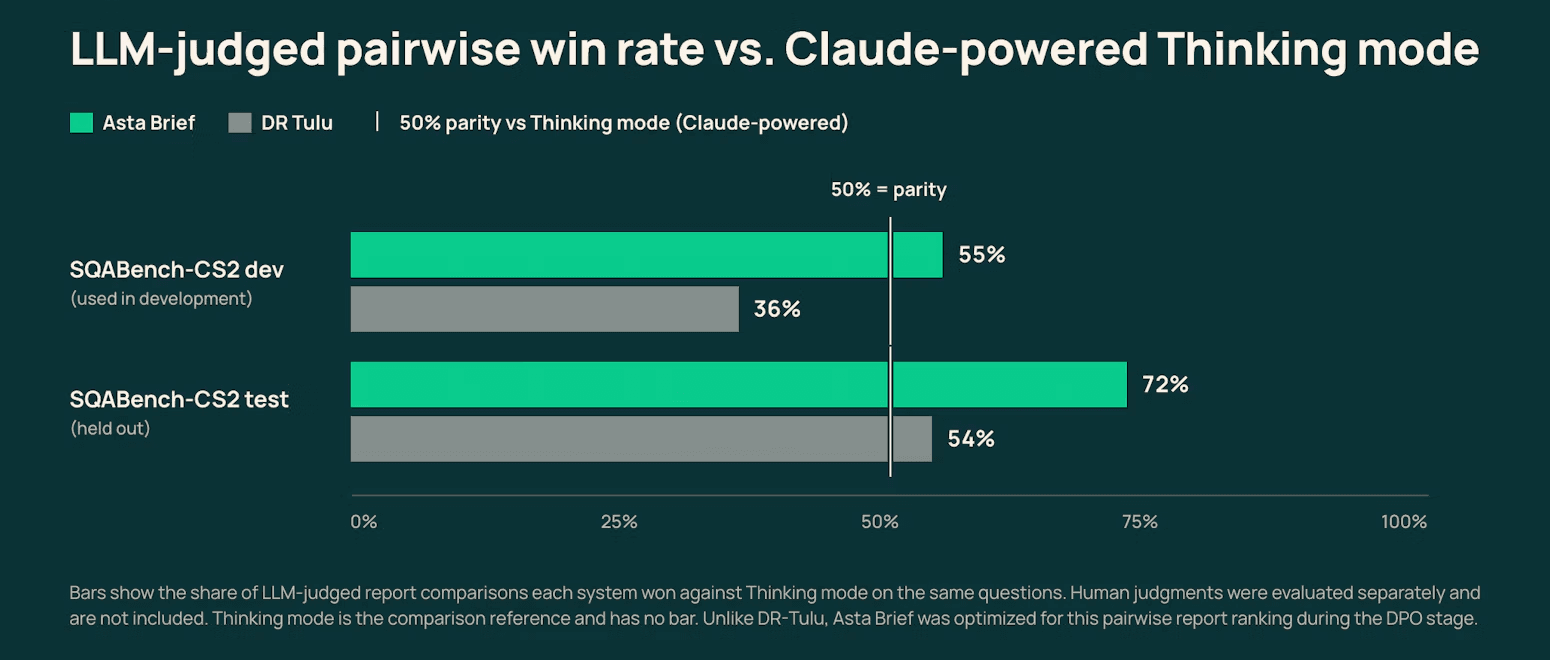
แผนภูมิเปรียบเทียบผลการตัดสินโดย LLM ระหว่าง AstaBrief และ Thinking mode
ข้อมูลจากการใช้งานจริงใน Asta Fast mode พบว่าผู้ใช้ 23% ที่ลองใช้ได้เปลี่ยนมาใช้งานโหมดนี้อย่างต่อเนื่อง และอีก 18% สลับใช้งานร่วมกับ Thinking mode ตามความเหมาะสม โดย Fast mode ได้รับคำชมเชิงบวกในระดับที่ใกล้เคียงกับ Thinking mode (84.2% เทียบกับ 85.2%)
ก้าวต่อไป (Where this goes next)
AstaBrief ช่วยให้นักวิจัยเข้าถึงโมเดลประสิทธิภาพสูงแบบ open-weights ที่ติดตั้งภายในหน่วยงานได้เอง เพื่อความปลอดภัยของข้อมูลวิจัยที่ยังไม่ได้ตีพิมพ์
เรากำลังพัฒนาต่อในด้านการเรียนรู้ความชอบที่ละเอียดขึ้น (fine-grained preference learning), การทำงานแบบหลายขั้นตอน (multi-turn), และการตรวจสอบว่าโมเดลรักษาขอบเขตเชิงประจักษ์ของแหล่งที่มาไว้ได้ดีเพียงใด เพื่อลดการสรุปที่เกินความจริง
AstaBrief เป็นเพียงส่วนหนึ่งของงานวิจัยที่ยาวนาน ตั้งแต่ ScholarQA ไปจนถึง Olmo เวอร์ชันอนาคต บทเรียนจากโปรเจกต์นี้จะเป็นรากฐานสำคัญให้กับการพัฒนาเครื่องมือ AI เพื่อวิทยาศาสตร์ต่อไป
ลองใช้ Fast model วันนี้ใน Asta หรือ ดาวน์โหลด AstaBrief จาก Hugging Face
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร