
ประสิทธิภาพต่อวัตต์พุ่ง 30 เท่า: NVIDIA Vera Rubin NVL72 สร้างมาตรฐานใหม่รองรับ AI Agent
ตามข้อมูลจาก OpenRouter เวิร์กโหลดของ AI แบบ Agentic มีการใช้โทเคนมากกว่าการเรียกใช้งานแชททั่วไปถึง 15 เท่า สาเหตุที่เป็นเช่นนั้นเพราะกระบวนการทำงานที่ซับซ้อนกว่าปกติ
ลองพิจารณาตัวอย่างเมื่อ AI Agent ทำการวิจัยบริษัทเพื่อตัดสินใจลงทุน Agent จะต้องสืบค้นฐานข้อมูลทางการเงิน ค้นหาข่าวสารและเอกสารที่ยื่นต่อหน่วยงาน พร้อมทั้งเรียกใช้ sub-agent เพื่อเปรียบเทียบกับคู่แข่งและประเมินมูลค่าโมเดล ก่อนจะรวบรวมข้อมูลทั้งหมดเป็นคำแนะนำ ทั้ง Agent และ sub-agent จะใช้เหตุผลต่อเนื่องไปจนกว่างานจะเสร็จสิ้น ซึ่งผลักดันให้ความต้องการโทเคนเพิ่มสูงขึ้น ในทุกขั้นตอน โทเคนที่สะสมจะกลายเป็นอินพุตสำหรับขั้นตอนถัดไป ทำให้การจัดการบริบทที่ยาว (long-context handling) กลายเป็นหัวใจสำคัญของประสิทธิภาพใน AI ยุคนี้
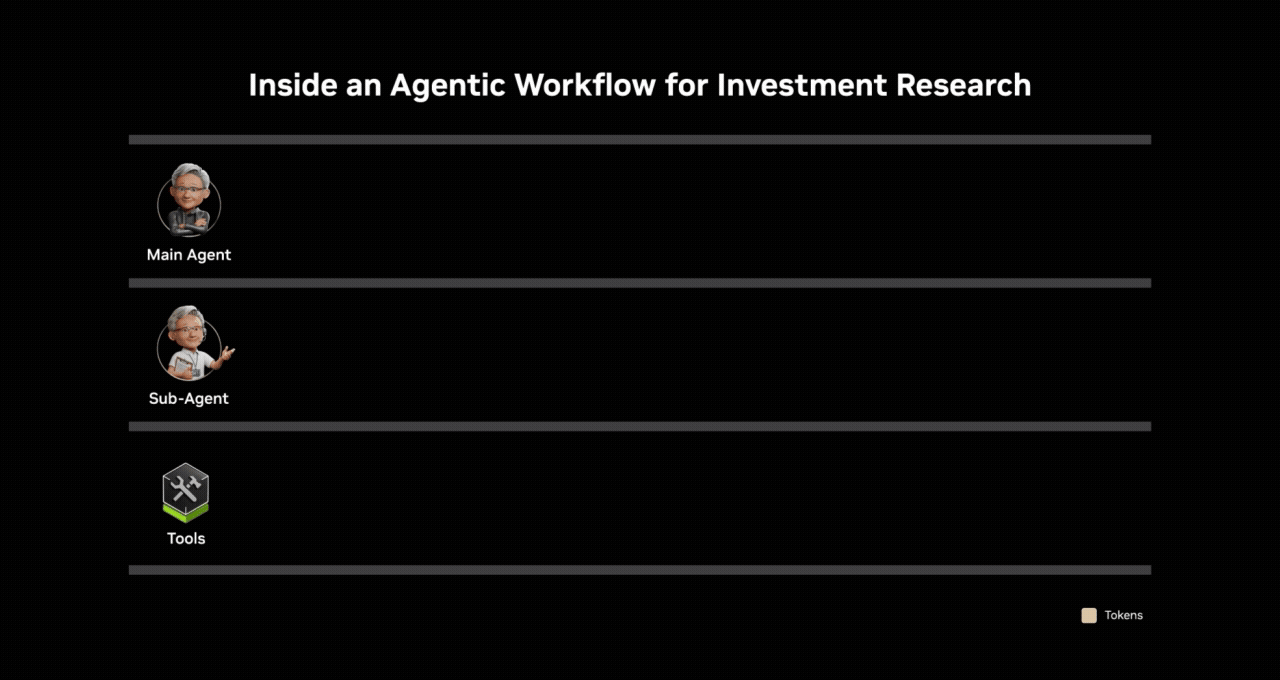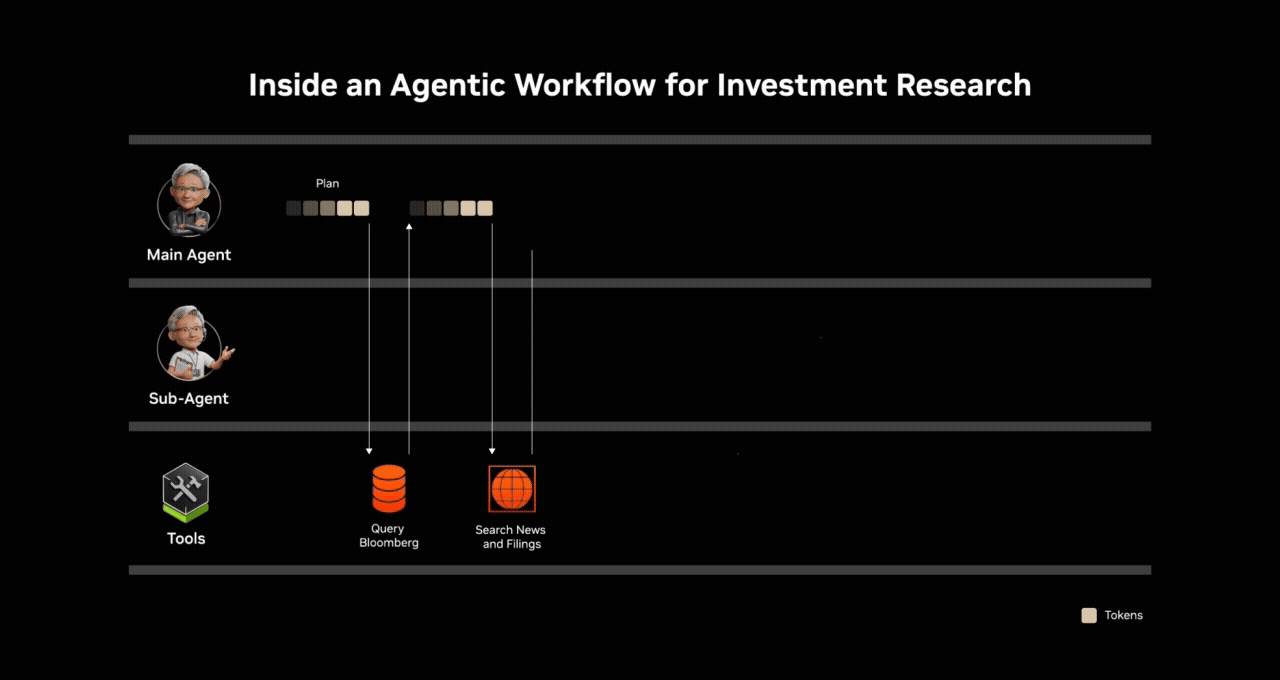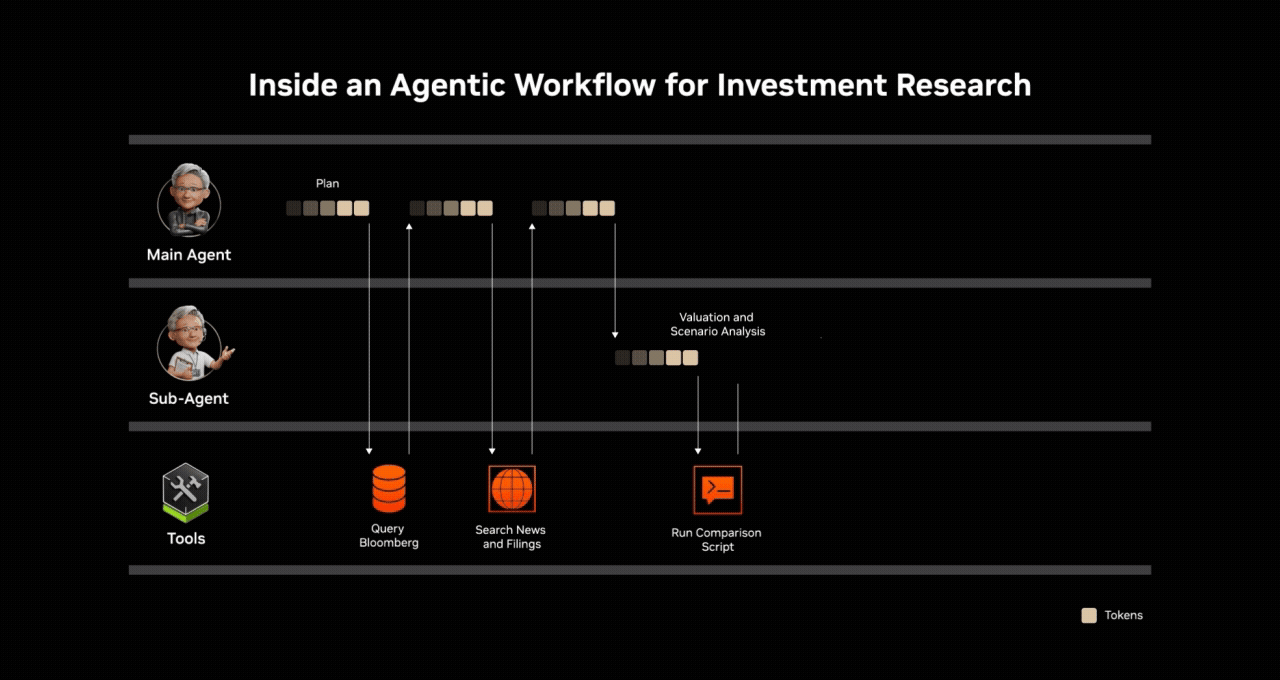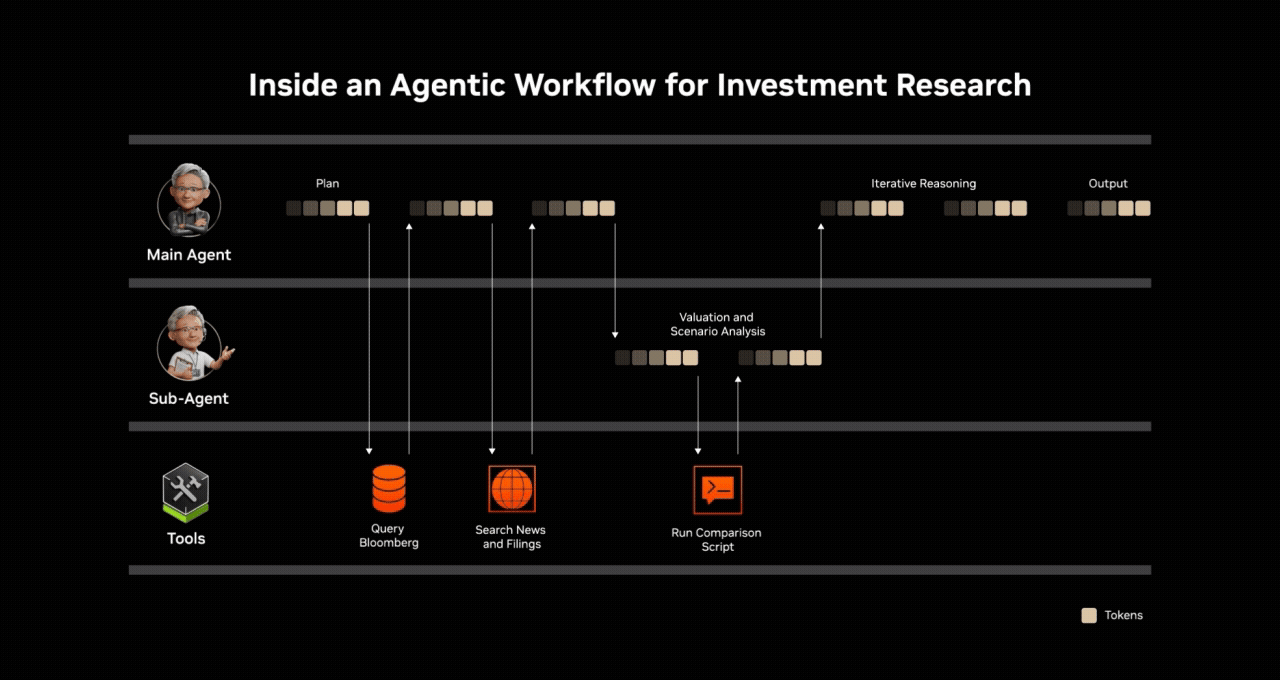
รูปแบบการใช้งานที่ใช้ทรัพยากรสูงเช่นนี้เกิดขึ้นในทุกกรณีของ Agentic ตั้งแต่การพัฒนาซอฟต์แวร์ การบริการลูกค้า ไปจนถึงการวิจัยเชิงลึก เมื่อระบบเหล่านี้เข้าสู่ขั้นตอนการผลิตจริงในอุตสาหกรรม โครงสร้างพื้นฐานที่รันระบบจึงต้องตอบสนองความต้องการโทเคนได้อย่างมีประสิทธิภาพสูงสุด
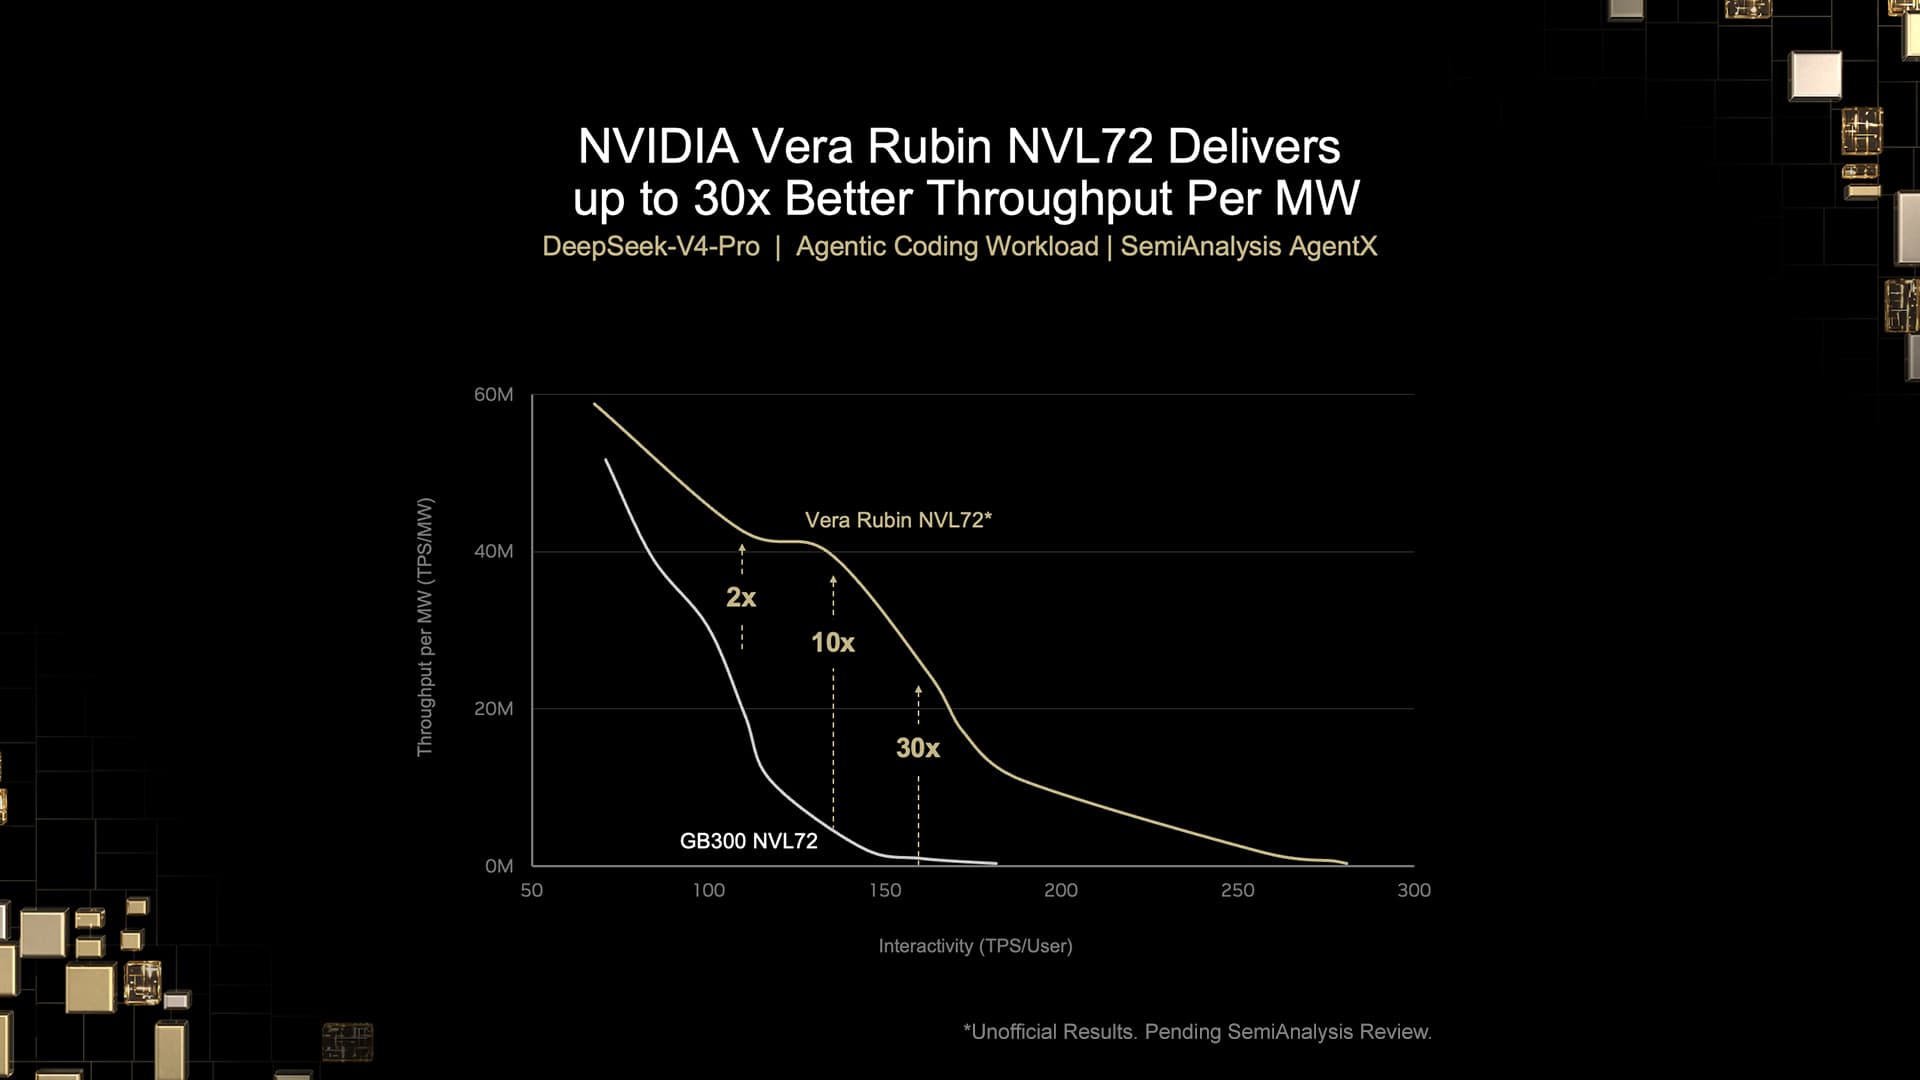
ข้อมูลประสิทธิภาพล่าสุดแสดงให้เห็นว่าระบบ NVIDIA Vera Rubin NVL72 ให้ throughput ต่อเมกะวัตต์สูงกว่า NVIDIA GB300 NVL72 ถึง 30 เท่าในเวิร์กโหลดแบบ Agentic โดย NVIDIA วัดผลจากการทำ inference ผ่าน SemiAnalysis AgentX ซึ่งเป็นเวิร์กโหลดที่จำลองการเขียนโค้ดของ Agent ในโลกความจริง ทั้งการเติบโตของบริบท การเรียกใช้เครื่องมือ (tool calls) และการสร้าง sub-agent สำหรับ AI factory ที่มีข้อจำกัดด้านพลังงาน นี่หมายถึงความสามารถในการทำงานเพิ่มขึ้น 30 เท่าโดยใช้พลังงานเท่าเดิม
ผลลัพธ์ในช่วงเริ่มต้นของ Vera Rubin NVL72 สะท้อนถึงนวัตกรรมที่ก้าวกระโดดของ NVIDIA ซึ่งการพัฒนาประสิทธิภาพของทั้ง Vera Rubin NVL72 และ GB300 NVL72 จะยังคงดำเนินต่อไปผ่านการเพิ่มประสิทธิภาพซอฟต์แวร์อย่างต่อเนื่อง
Vera Rubin NVL72: Throughput ต่อเมกะวัตต์สูงขึ้น 30 เท่า และต้นทุนโทเคนต่ำลง 35 เท่า
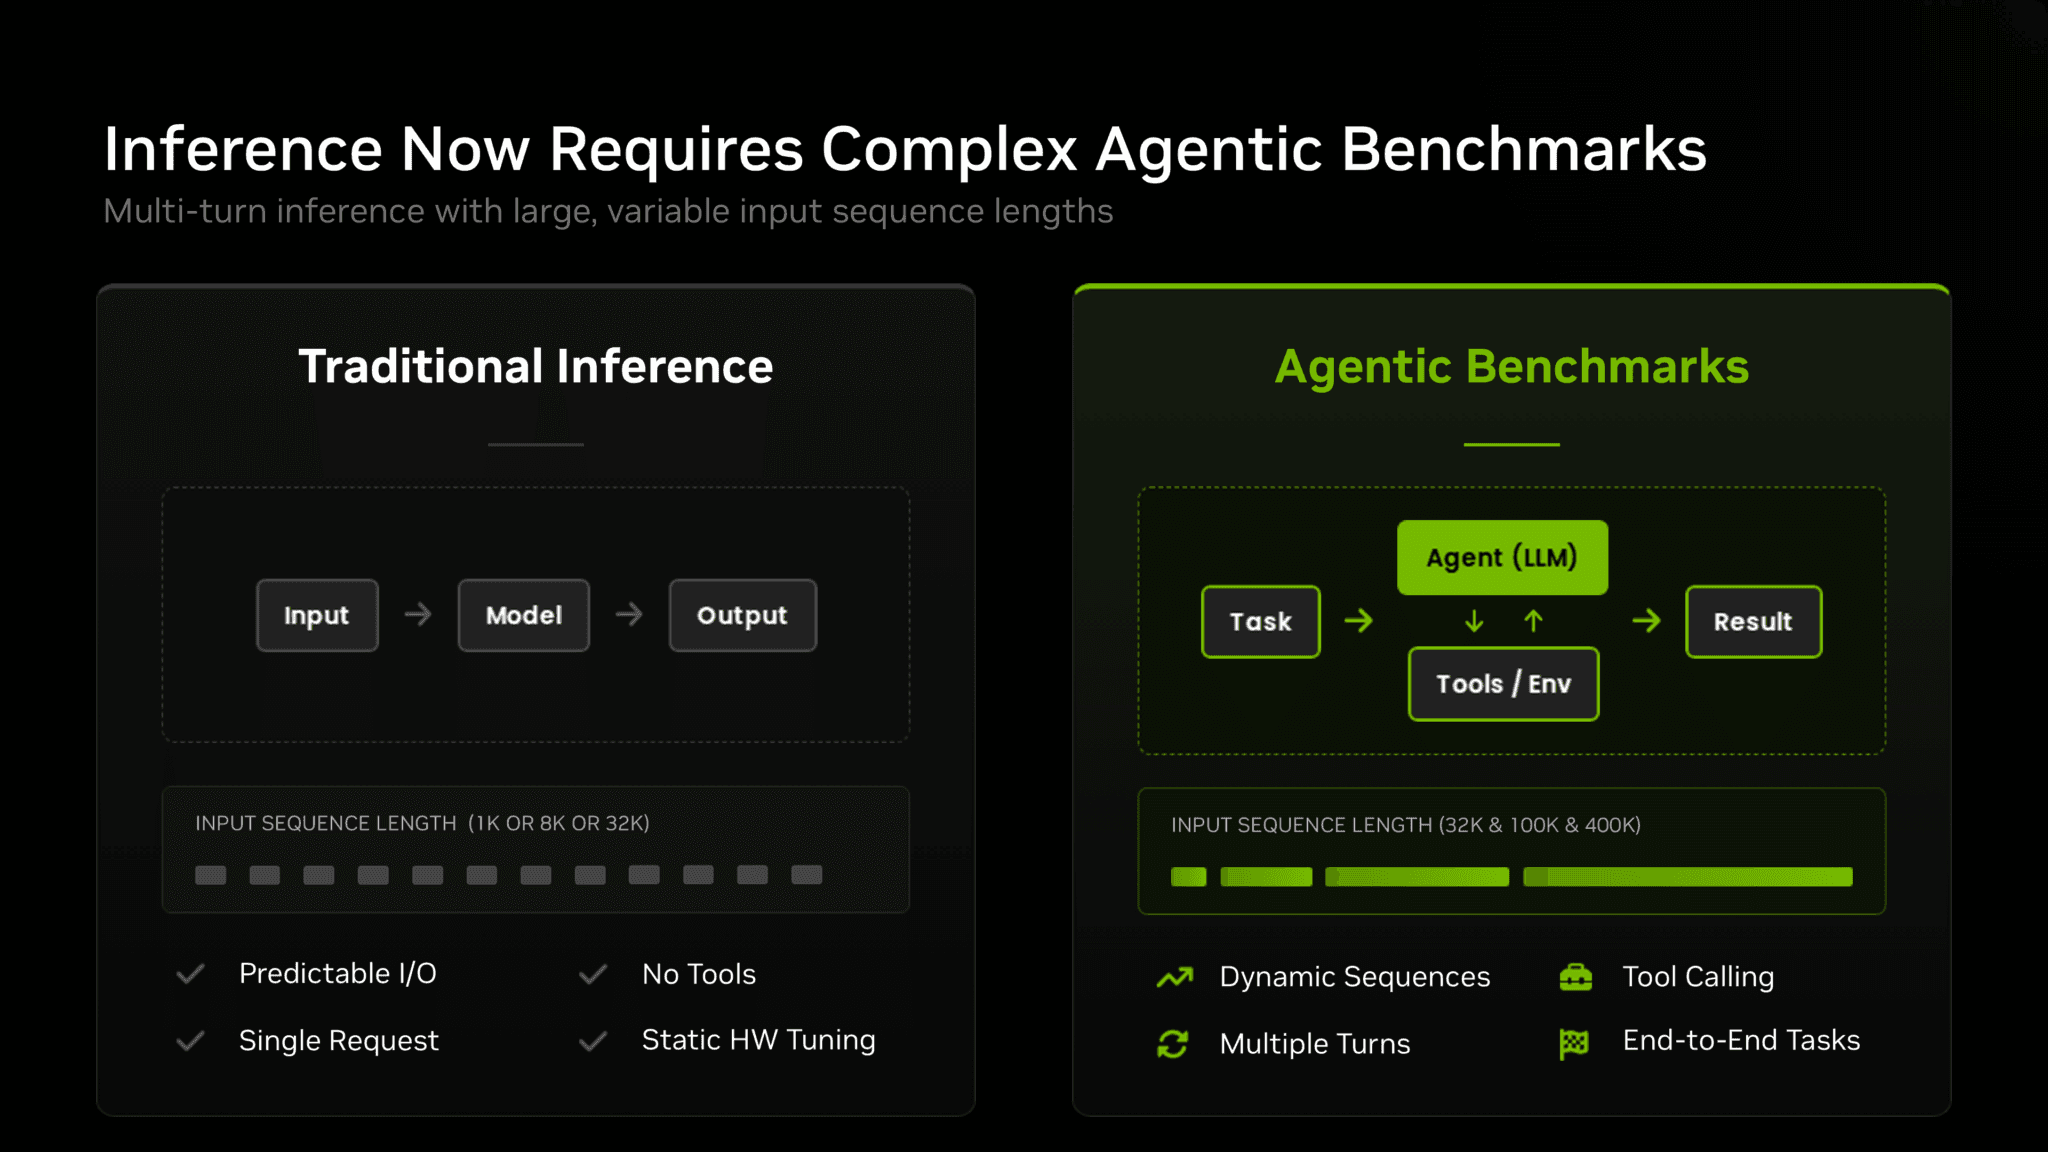
เวิร์กโหลดแบบ Agentic มีลักษณะต่างจากการแชทหรือสรุปเอกสารทั่วไปที่มักมีอินพุตและเอาต์พุตเพียง 1,000 ถึง 8,000 โทเคน แต่ในเซสชันของ Agent บริบทจะสะสมเพิ่มขึ้นเรื่อยๆ จนอาจสูงถึงหลายแสนโทเคน และมีความผันผวนของความยาวข้อมูลในแต่ละคำขอสูงมาก การวัดประสิทธิภาพจึงต้องเปลี่ยนมารวมเวิร์กโฟลว์ของ Agent ทั้งหมดแทนการวัดเพียงการเรียกใช้ inference ครั้งเดียว
ผลลัพธ์จากการทดสอบกับเส้นทางการเขียนโค้ดแบบ Agentic ในโลกความเป็นจริงบน SemiAnalysis AgentX พบว่าแพลตฟอร์ม NVIDIA Blackwell ให้ประสิทธิภาพชั้นนำในโมเดลหลายตัว เช่น Kimi K3, MiniMax M3, GLM5.3, Qwen3.5 และ DeepSeek V4 Pro
ตัวอย่างเช่น GB300 NVL72 ให้ throughput ต่อเมกะวัตต์ดีกว่าเดิมถึง 15 เท่า เมื่อเทียบกับสถาปัตยกรรม NVIDIA Hopper ในโมเดล DeepSeek V4 Pro ช่วยให้ลูกค้ามีรากฐานที่แข็งแกร่งในการรันเวิร์กโหลด Agentic การก้าวกระโดดนี้แสดงถึงข้อได้เปรียบของ GPU domain แบบ scale-up ขนาดใหญ่และซอฟต์แวร์ที่ออกแบบมาร่วมกัน
Vera Rubin ได้ต่อยอดความสำเร็จนั้นด้วยการยกระดับประสิทธิภาพทั่วทั้งเส้นโค้ง Pareto จนทำ throughput ต่อเมกะวัตต์ได้สูงกว่า GB300 NVL72 ถึง 30 เท่าในโมเดล DeepSeek V4 Pro แม้ผลลัพธ์เบื้องต้นนี้กำลังอยู่ระหว่างการตรวจสอบโดย SemiAnalysis และยังไม่ได้รวมประสิทธิภาพของ Vera CPU สำหรับการเรียกใช้เครื่องมือ แต่ก็นับว่าเป็นสถิติที่น่าทึ่ง
เทคโนโลยี NVIDIA DSX MaxLPS ยังเข้ามาช่วยจัดการพลังงานครอบคลุมระดับ GPU, แร็ค และเวิร์กโหลด ทำให้สามารถจัดสรร GPU ได้มากขึ้นถึง 40% ภายใต้งบประมาณพลังงานเท่าเดิม ซึ่งส่งผลโดยตรงต่อต้นทุน โดย Vera Rubin NVL72 มีต้นทุนต่อล้านโทเคนที่ต่ำกว่า GB300 NVL72 สูงสุดถึง 35 เท่า ช่วยให้การรัน Agent ในระดับสเกลเป็นไปได้อย่างคุ้มค่า
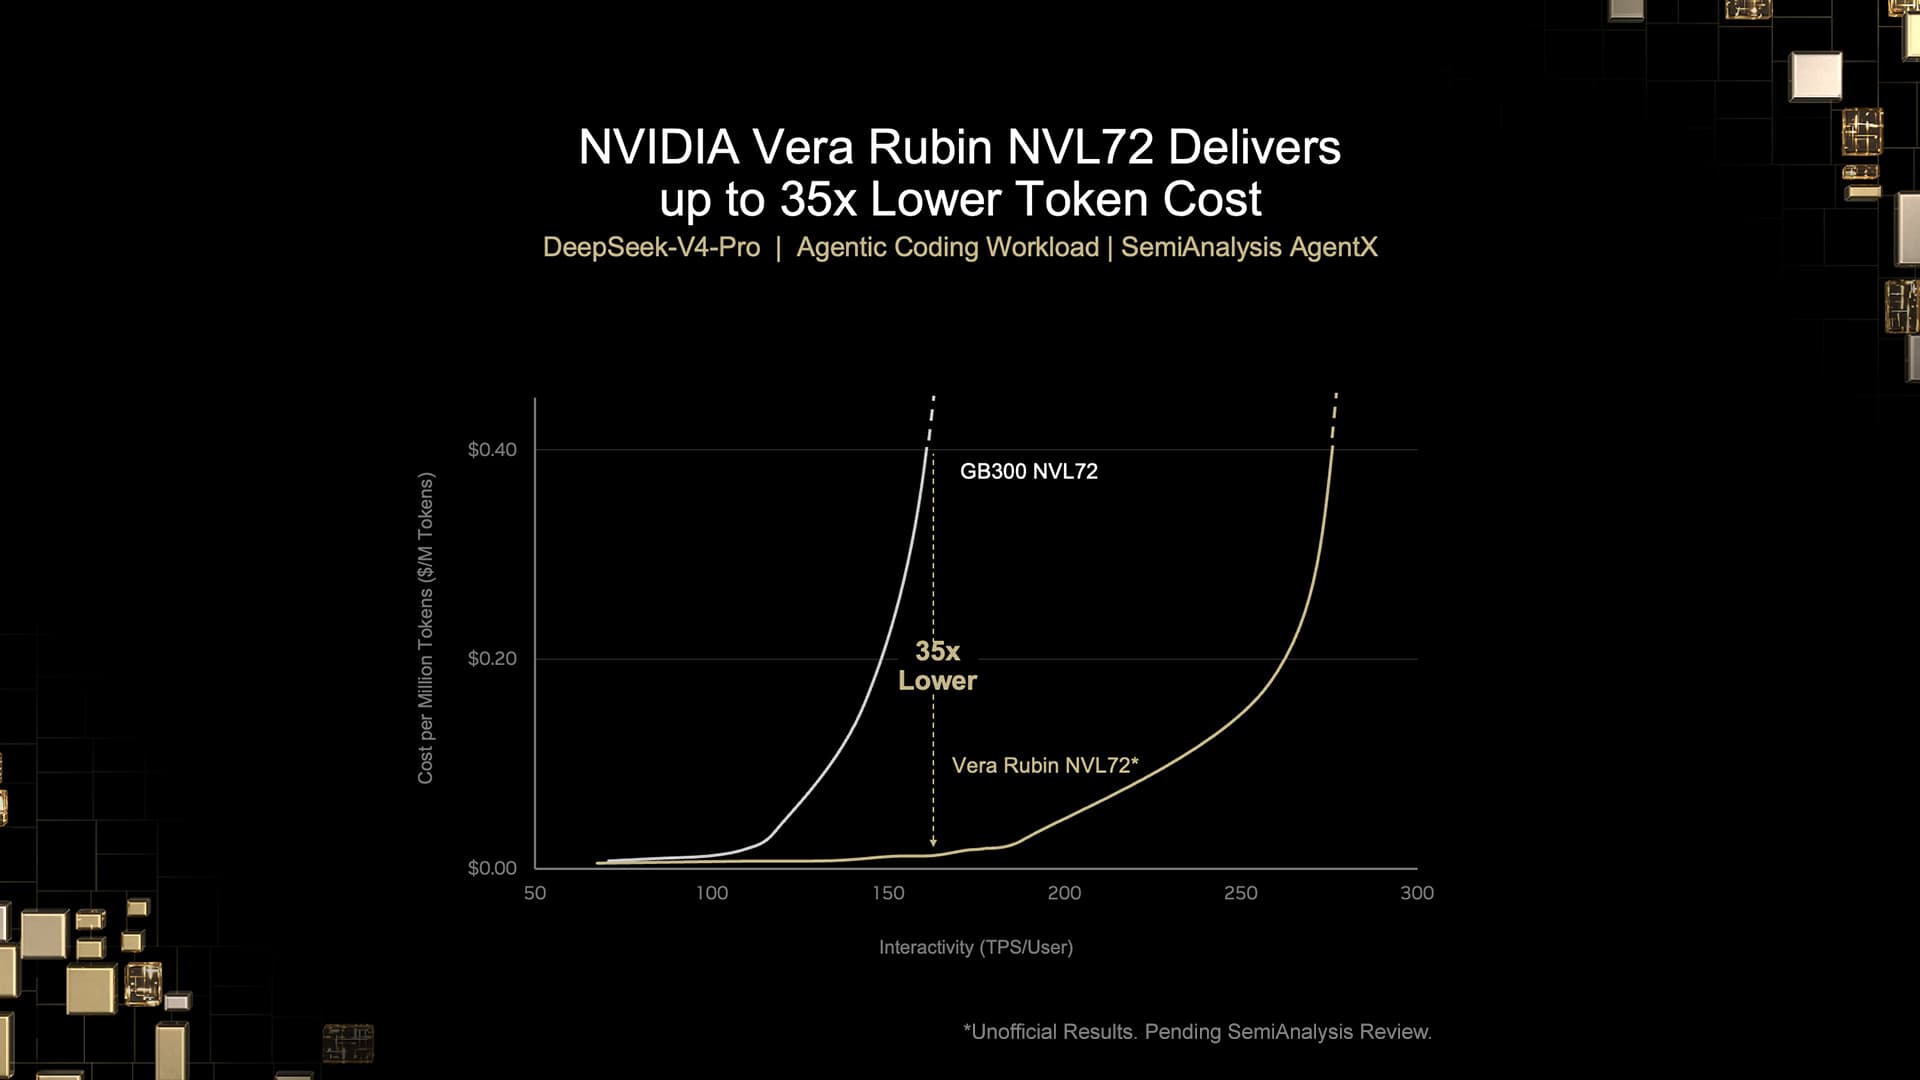
สำหรับผู้ดำเนินงาน AI factory ประสิทธิภาพ Throughput ต่อเมกะวัตต์คือตัวกำหนดรายได้ของ AI factory ในขณะที่ต้นทุนต่อล้านโทเคนจะเป็นตัวกำหนดอัตรากำไรที่จะได้รับ
การออกแบบร่วมกันขั้นสุด (Extreme Codesign) เพื่อสเกลระดับ Agentic
การเพิ่มประสิทธิภาพ inference สมัยใหม่ต้องใช้เทคนิคหลายด้าน ซึ่ง NVIDIA Vera Rubin NVL72 รองรับผ่านการออกแบบร่วมกันในทุกชั้นของแพลตฟอร์ม ได้แก่:
- การให้บริการแบบแยกส่วน (Disaggregated serving): แยกส่วนประมวลผลบริบท (prefill) ออกจากส่วนสร้างคำตอบ (decode) เพื่อให้แต่ละส่วนสเกลได้อย่างอิสระ
- การจับคู่ความเร็ว (Rate matching): ประสานความเร็วระหว่าง GPU ส่วน prefill และ decode เพื่อให้ได้ประสิทธิภาพสูงสุด
- การขนานแบบ Expert ขนาดใหญ่ (Large-scale expert parallelism): กระจายเครือข่ายย่อยผู้เชี่ยวชาญใน mixture-of-experts models ข้ามโดเมน GPU
- การทำ KV-caching แบบกระจาย (Distributed KV-caching): ขยายหน่วยความจำและจัดลำดับบริบทที่มีการใช้งานน้อยไปยังที่เก็บข้อมูล เพื่อให้เข้าถึงได้โดยไม่ต้องคำนวณใหม่
- การกำหนดเส้นทางโดยคำนึงถึง KV (KV-aware routing): ส่งคำขอไปยัง GPU ที่มีข้อมูลแคชเดิมอยู่แล้ว ช่วยลดการคำนวณซ้ำซ้อนในเซสชันยาวๆ
- Fused CUDA kernels: เช่น MegaMoE ที่รวมการคำนวณและการสื่อสารระหว่าง GPU เข้าด้วยกัน ช่วยให้ GPU ทำงานได้ต่อเนื่องโดยไม่ต้องรอข้อมูล
ชิป Rubin GPU มาพร้อม Tensor Cores รุ่นที่ 5 และ Transformer Engine รุ่นที่ 3 พร้อมเทคโนโลยี NVFP4 quantization ที่บีบอัดน้ำหนักโมเดลเหลือ 4-bit ช่วยเพิ่ม throughput โดยไม่เสียคุณภาพงาน
สถาปัตยกรรม scale-up ของ NVL72 ช่วยให้การสื่อสารระหว่าง GPU มีแบนด์วิดท์สูงและความหน่วงต่ำ ผ่านเทคโนโลยี NVIDIA NVLink รุ่นที่ 6 ที่ให้อัตราแพ็กเก็ตสูงขึ้น 10 เท่า และความหน่วงต่ำลง 3 เท่าเมื่อเทียบกับ Ethernet ทั่วไป นอกจากนี้ Software stack ทั้งหมดตั้งแตระดับ CUDA kernels ไปจนถึงเฟรมเวิร์กอย่าง NVIDIA Dynamo ก็ถูกออกแบบมาเพื่อรองรับฮาร์ดแวร์นี้โดยเฉพาะ
แม้ผลลัพธ์นี้จะเป็นเพียงส่วนหนึ่ง แต่แพลตฟอร์ม Vera Rubin NVL72 ตัวเต็มคือสถาปัตยกรรมแบบเจ็ดชิป ประกอบด้วย NVIDIA Vera CPU, Groq 3 LPU, NVLink 6 Switch, BlueField-4 DPU, Spectrum-6 SPX และ ConnectX-9 SuperNIC ซึ่งออกแบบมาเพื่อ AI factory ยุคใหม่โดยเฉพาะ
ปัจจุบัน Vera Rubin อยู่ในสายการผลิตเต็มรูปแบบและกำลังขยายความร่วมมือไปทั่วทั้งระบบนิเวศผ่านการทำงานร่วมกับพันธมิตรของ NVIDIA
เรียนรู้เพิ่มเติมเกี่ยวกับ แพลตฟอร์ม NVIDIA Vera Rubin.
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร