
webAI เปิดตัว TwIL-LM โมเดลตรรกะเชิงรูปแบบขนาดเล็ก 1.7B และ 3B ชูประสิทธิภาพรันบนเครื่องได้โดยตรง
webAI ประกาศเปิดตัว TwIL-LM ตระกูลโมเดลผู้ใช้เหตุผลทางตรรกะเชิงรูปแบบสองโมเดลขนาด 1.7B และ 3B พารามิเตอร์ โดยรุ่น 3B คือ TwIL-LM3 ซึ่งเป็นการปรับแต่งแบบ merged fine-tune จาก SmolLM3-3B ส่วนรุ่น 1.7B เป็น PEFT LoRA adapter สำหรับ SmolLM2-1.7B-Instruct
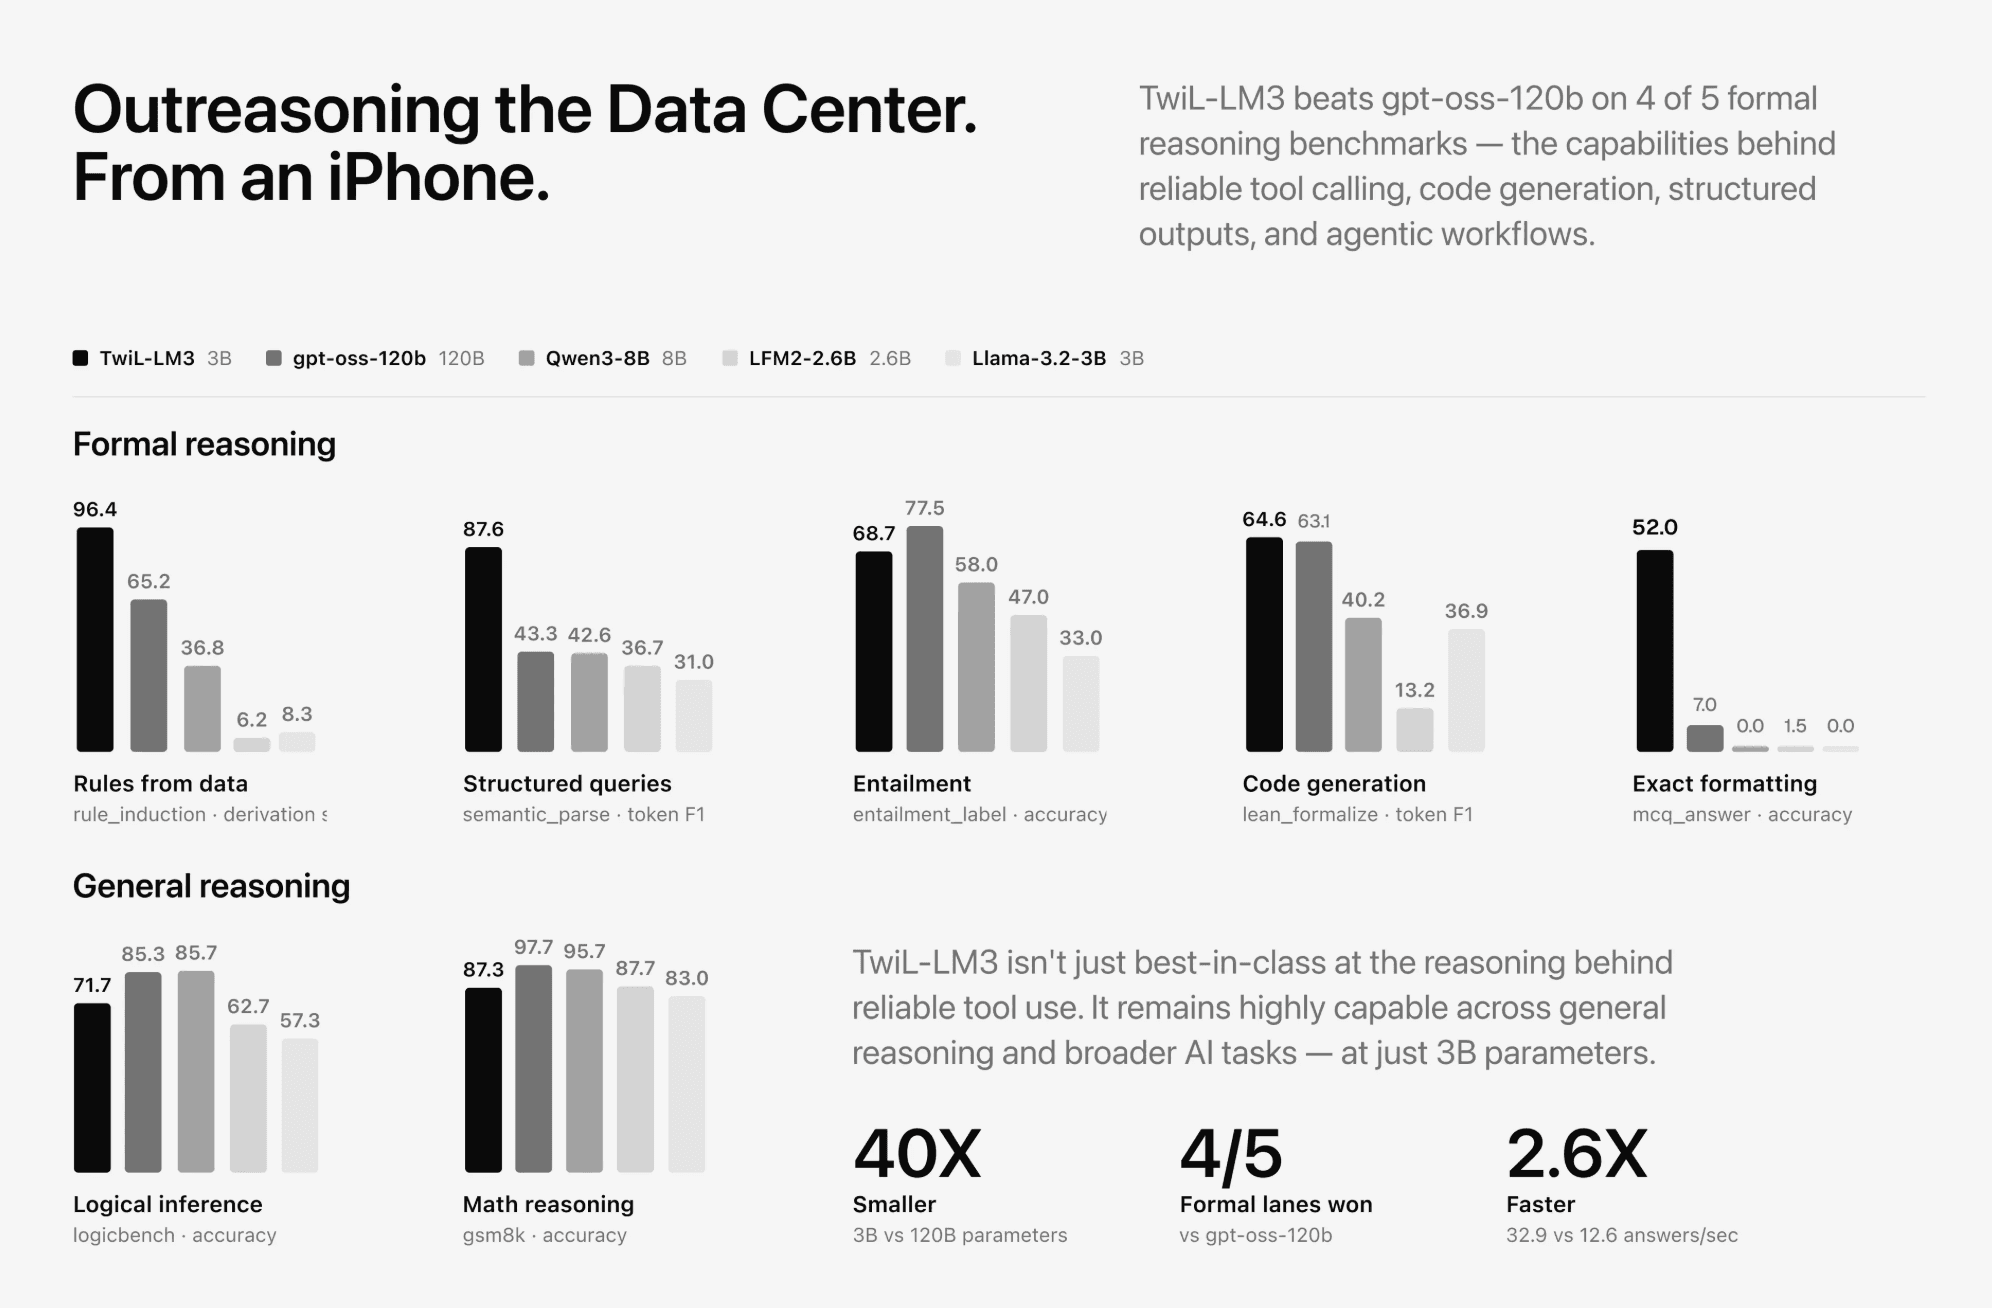
โมเดลทั้งสองมุ่งเน้นไปที่งาน autoformalization หรือการแปลภาษาอังกฤษเป็นตรรกะอันดับหนึ่ง (first-order logic) รวมถึงการตรวจสอบความสมเหตุสมผลของข้อสรุปจากข้อตั้ง โดยเน้นการทำงานแบบท้องถิ่น (locally) ซึ่งรุ่น 1.7B มีขนาดหลังทำ quantization เพียง 1.06 GB ในขณะที่รุ่น 3B ใช้ไฟล์ GGUF แบบ Q4_K_M ขนาด 1.78 GiB การ ประกาศ ของ webAI ระบุว่าโมเดลเหล่านี้สามารถเอาชนะ gpt-oss-120b ได้ใน 4 จาก 5 เลนของการให้เหตุผลเชิงรูปแบบ
ความพร้อมในการใช้งาน (Deployment)
ปัจจุบันทั้งสองโมเดลเปิดให้ใช้งานได้เฉพาะในเชิงที่ไม่ใช่การค้าเท่านั้น โดยเผยแพร่ภายใต้สัญญาอนุญาต webAI Non-Commercial License ver. 1.0 หากต้องการนำไปใช้ในเชิงธุรกิจที่สร้างรายได้ จะต้องทำข้อตกลงแยกต่างหากกับทาง webAI โดยตรง
ในระดับองค์กร รุ่น 3B สามารถรันบน CPU หรือ VRAM ขนาด 4 GB ได้อย่างสบาย เหมาะสำหรับอุตสาหกรรมที่เน้นความปลอดภัยของข้อมูล เช่น งานด้านการปฏิบัติตามกฎระเบียบ (RegTech), บริการทางการเงิน, การแพทย์, และงานกฎหมายที่ข้อมูลห้ามหลุดออกจากอุปกรณ์ แอปพลิเคชันที่รองรับครอบคลุมตั้งแต่การแปลตรรกะอันดับหนึ่ง (FOL), การเปลี่ยนภาษาธรรมชาติเป็นคิวรีโครงสร้าง, ไปจนถึงการเป็นเลเยอร์ตัวตรวจสอบ (verifier layer) ให้กับโมเดลขนาดใหญ่ และการร่วมร่างรูปแบบใน Lean
กระบวนการสร้าง TwIL-LM3
กระบวนการพัฒนาประกอบด้วย 4 ขั้นตอนหลัก เริ่มจากการทำ LoRA supervised fine-tuning บนคลังข้อมูลตรรกะสังเคราะห์ ตามด้วยการทำ Checkpoint fusion เพื่อหาค่าเฉลี่ยในพื้นที่พารามิเตอร์ จากนั้นใช้ WiSE-FT interpolation กลับไปยังโมเดลฐานที่ค่า λ = 0.25 และปิดท้ายด้วย MGPO ซึ่งเป็นกระบวนการ GRPO แบบถ่วงน้ำหนักเอนโทรปีที่รันเทียบกับตัวตรวจสอบทางโปรแกรมมิ่ง
ค่า λ มีบทบาทสำคัญอย่างยิ่ง โดยทีมพัฒนาเลือกเก็บส่วนต่างจากการ fine-tuned ไว้เพียงหนึ่งในสี่ เพื่อรักษาความสามารถทั่วไปไว้ แม้ว่ารุ่นที่ไม่ผ่านกระบวนการ interpolation จะทำคะแนนในโดเมนเฉพาะทางได้สูงกว่า แต่ความสามารถในส่วนที่อยู่นอกชุดทดสอบ (held-out capability) จะลดลงถึง 12 จุด ซึ่ง webAI ตัดสินใจไม่เผยแพร่รุ่นดังกล่าว
ประสิทธิภาพและผลการทดสอบ
webAI รายงานคะแนนที่น่าสนใจในหลายด้าน เช่น การเหนี่ยวนำกฎ (96.4), การแจกแจงความหมาย (87.6) และการระบุประเภทการอนุมาน (68.7) ในการทดสอบ Track A พบว่า TwIL-LM3 ทำคะแนนเฉลี่ยหกเลนได้ 0.4488 นำหน้าโมเดลคู่แข่งอย่าง LFM2.5-8B-A1B แม้จะมีพารามิเตอร์น้อยกว่าถึง 3 เท่า อย่างไรก็ตาม ยังคงตามหลังโมเดลยักษ์ใหญ่อย่าง Qwen3-8B และ gpt-oss-120b ในบางเกณฑ์
จุดเด่นที่แท้จริงคือความเร็วในการประมวลผล โดย TwIL-LM3 สามารถสร้างคำตอบได้สั้นและกระชับที่สุด ส่งผลให้มีอัตราการตอบกลับสูงถึง 32.9 คำตอบต่อวินาที เมื่อเทียบกับรุ่น 120B ที่ทำได้เพียง 4.2 เท่านั้น
การถ่ายโอนความสามารถไปยังข้อมูลใหม่ (Held-out transfer)
TwIL-LM3 แสดงให้เห็นถึงการพัฒนาในโดเมนเพิ่มขึ้น 26% โดยเพิ่มคะแนน macro gate เป็น 0.422 ขณะเดียวกันก็ยังรักษาคะแนนในส่วนที่อยู่นอกชุดทดสอบได้ดี โดยคะแนน LogicBench เพิ่มขึ้นเป็น 0.7167 แม้คะแนน GSM8K และ IFEval จะลดลงเล็กน้อยตามลำดับ
สำหรับรุ่น 1.7B ถือเป็นการแลกเปลี่ยนที่คุ้มค่า โดยทำคะแนน macro-primary ได้ 0.361 พุ่งสูงจาก 0.185 ของโมเดลฐาน แม้ในบางเกณฑ์การทดสอบนอกเขตข้อมูล (out-of-distribution) อย่าง ARC-C จะมีผลคะแนนลดลงบ้าง แต่ภาพรวมยังถือว่าทรงประสิทธิภาพสำหรับขนาดโมเดลที่เล็กมาก
สรุปสาระสำคัญ
- TwIL-LM3 (3B) และ TwIL-LM (1.7B) เน้นงานตรรกะเชิงรูปแบบและเปิดให้ใช้ฟรีแบบไม่ใช้เพื่อการค้า
- ประสิทธิภาพความเร็วคือหัวใจสำคัญ โดยทำได้ถึง 32.9 คำตอบ/วินาที ด้วยการตอบที่กระชับ
- เทคนิค WiSE-FT ที่ λ = 0.25 ช่วยให้โมเดลเก่งขึ้นในโดเมนเฉพาะโดยไม่สูญเสียความสามารถทั่วไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร