
SerpApi เปิดตัว Markdown Output ลดการใช้ Token ลงสูงสุด 74%
Sponsored Content
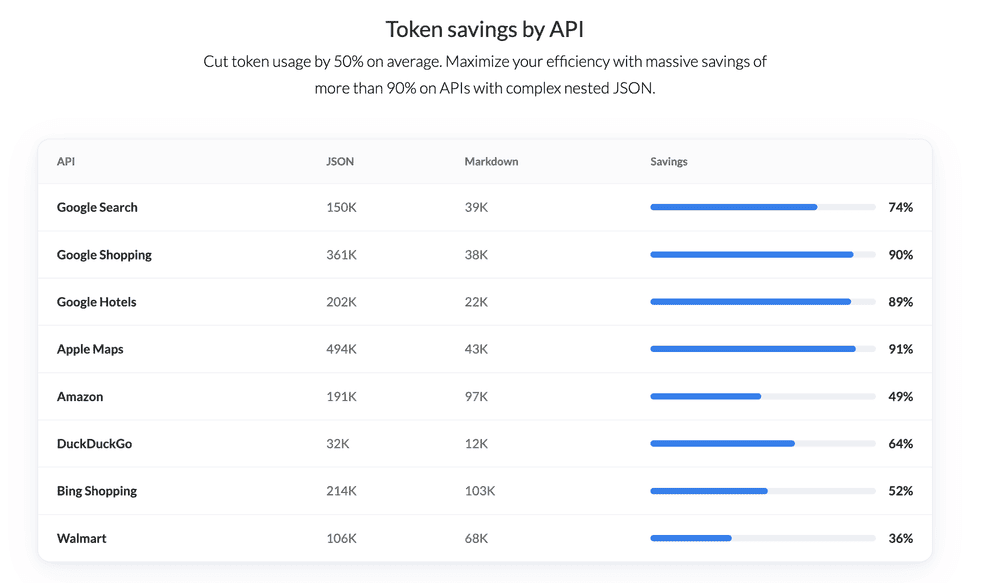
ไม่ใช่เรื่องใหม่ที่ AI Agent มักสิ้นเปลือง Token จำนวนมหาศาลไปกับการค้นหาและดึงข้อมูลไฟล์ เนื่องจากระบบมักดึงข้อมูลฉบับเต็ม ทั้งล็อกและบล็อกความคิดเห็นต่างๆ เข้ามา ซึ่งการอ่านข้อมูลเหล่านั้นอาจใช้ Token ไปหลายหมื่นตัว และยังไม่นับรวมลูปการทำงานแบบ recursive ที่เกิดขึ้นเมื่อ Agent ต้องรันคำสั่งซ้ำ
เพียงการค้นหาง่ายๆ อย่าง "look up coffee shops" ก็สามารถขยายตัวกลายเป็น Payload ขนาดใหญ่ที่เต็มไปด้วย Nested Object, Tracking Link และ Metadata ซึ่งข้อมูลเหล่านี้ส่วนใหญ่โมเดลไม่ได้นำไปใช้งานจริง แต่คุณยังต้องแบกรับภาระค่าใช้จ่ายต่อ Token อยู่เสมอ อย่างไรก็ตาม ปัจจุบันมีวิธีที่จะช่วยลดการใช้ Token ให้เหลือน้อยที่สุดได้
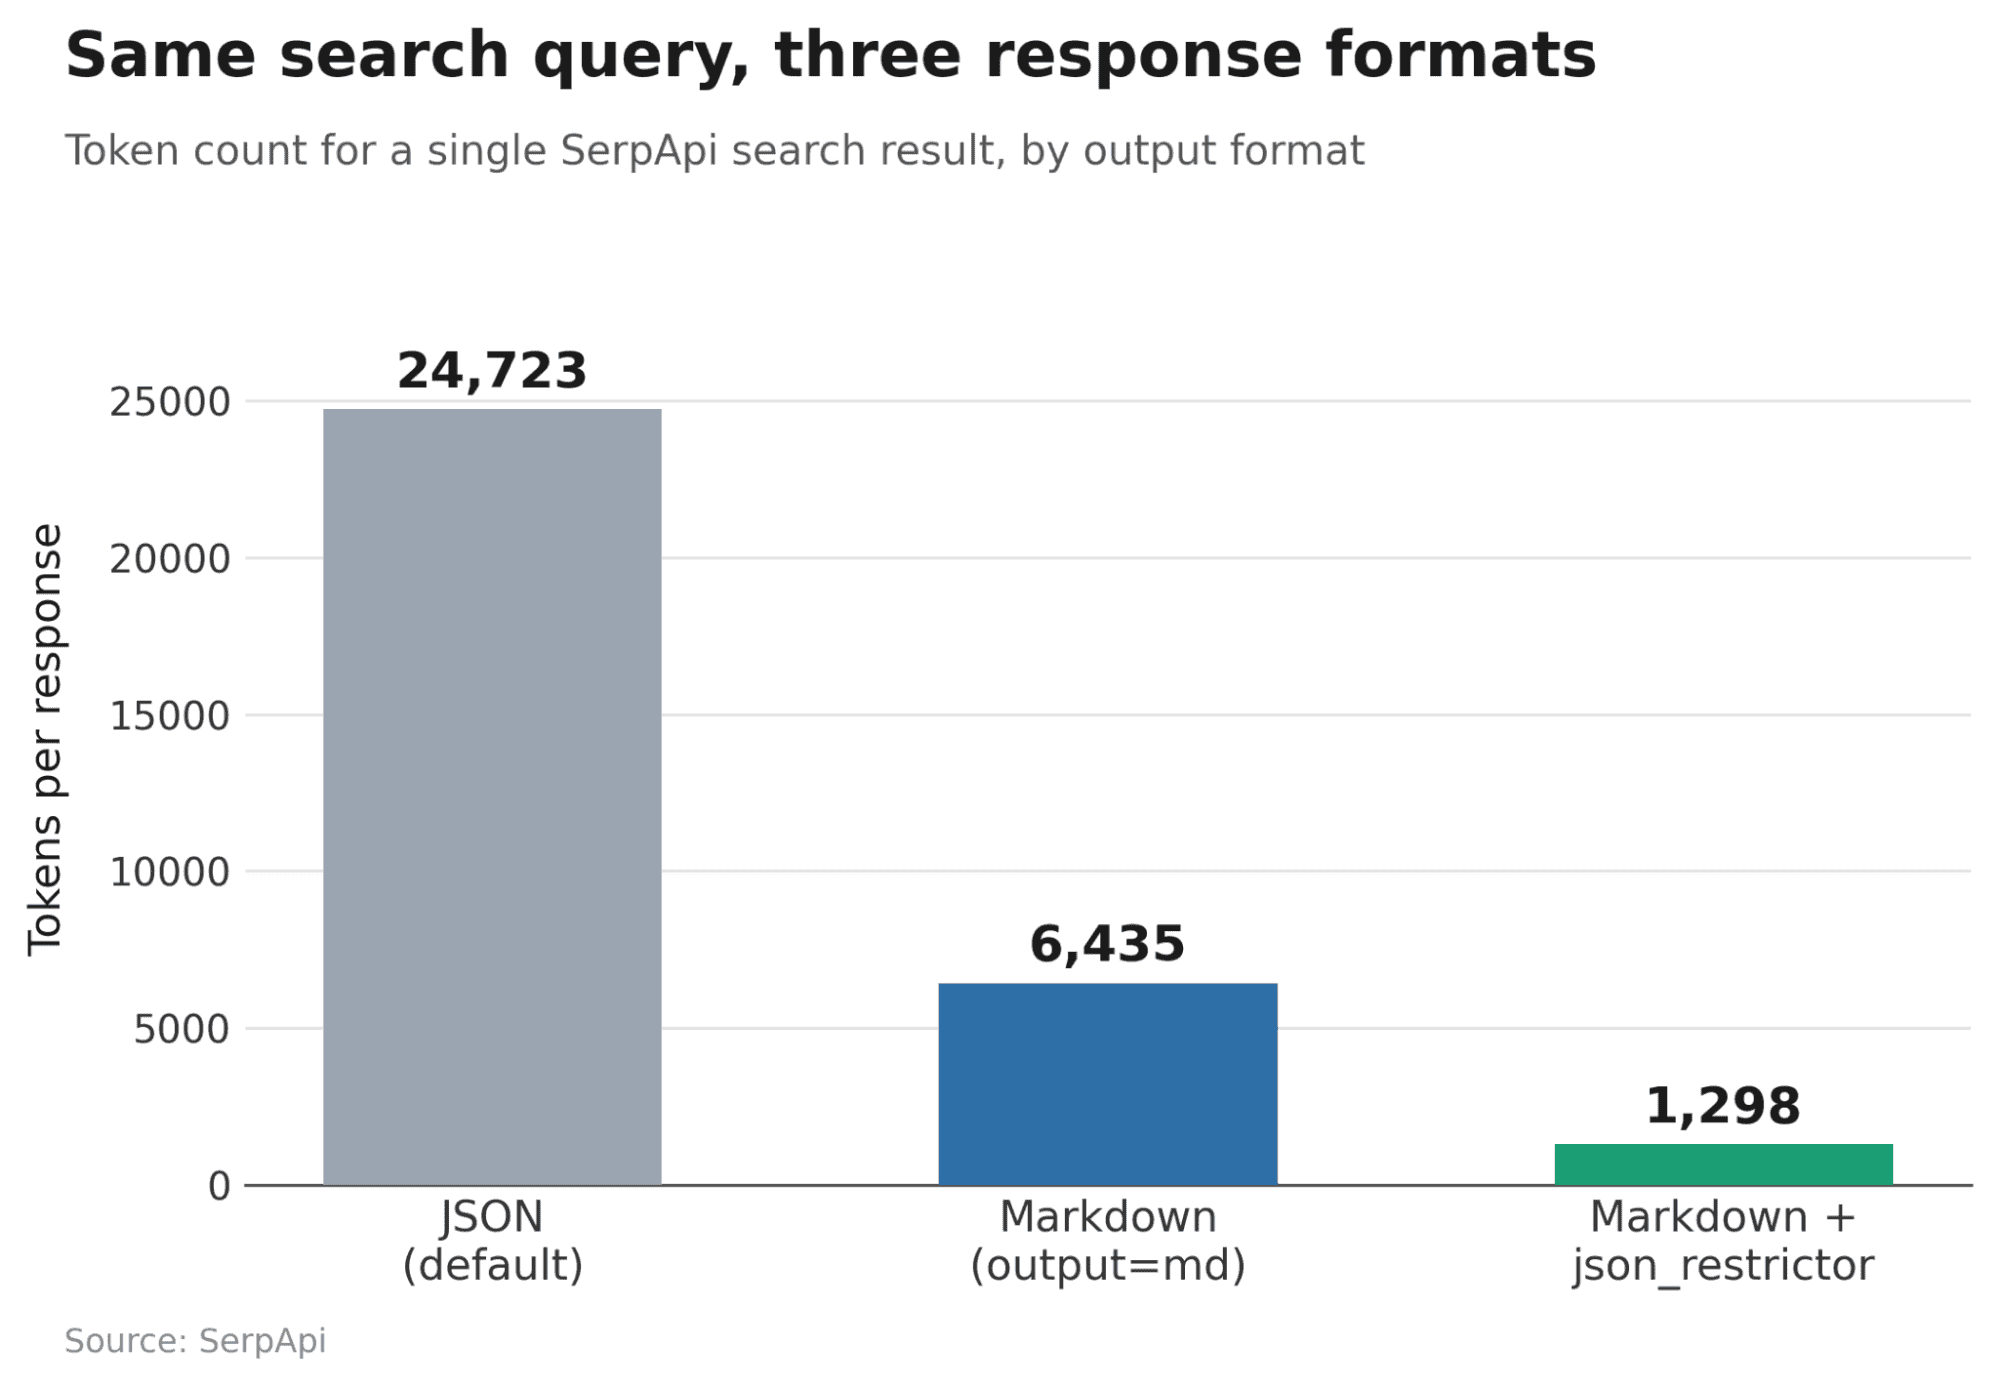
SerpApi ได้เปิดตัวตัวเลือกเอาต์พุตแบบ Markdown ที่ช่วยตัดขนาด Token ได้อย่างมีประสิทธิภาพ โดยผลการทดสอบพบว่าการค้นหาคำว่า "coffee" ด้วยรูปแบบ JSON ปกติใช้ Token สูงถึง 24,723 ตัว แต่เมื่อเปลี่ยนเป็น Markdown กลับใช้เพียง 6,435 Token หรือลดลงถึง 74% นอกจากนี้หากมีการกรองข้อมูลเพิ่มเติม อาจลดเหลือเพียง 1,298 Token เท่านั้น ซึ่งช่วยให้โมเดลประหยัดต้นทุนและเหลือพื้นที่ใน Context Window มากขึ้น
เจาะลึกความต่างระหว่าง JSON vs. Markdown
หลักการทำงานของเอาต์พุต Markdown ของ SerpApi คือการคงเนื้อหาสำคัญไว้ แต่ตัดหรือปรับเปลี่ยนส่วนที่ทำให้จำนวน Token พุ่งสูงขึ้นโดยไม่จำเป็นต่อการประมวลผลของโมเดล ซึ่งสิ่งที่มักถูกลบออกหรือแปลงสภาพมีดังนี้:
- Tracking Link และ URL ภายใน: เอาต์พุตแบบ Markdown จะลบลิงก์ภายในของ SerpApi เช่น
serpapi_linkที่ใช้สำหรับการนำทางในระบบออก และเก็บไว้เฉพาะลิงก์ปลายทางที่ผู้ใช้มองเห็นเท่านั้น - ไอคอนและรูปภาพขนาดเล็ก (Thumbnails): แม้จะมีประโยชน์ต่อหน้าจอผู้ใช้ (UI) แต่สำหรับ LLM แล้ว ข้อมูลเหล่านี้คือส่วนเกิน Markdown จึงกำจัดออกโดยค่าเริ่มต้น
- Metadata ซ้อนและฟิลด์ซ้ำซ้อน: JSON จะรักษาโครงสร้างข้อมูลทั้งหมดรวมถึง Pagination Object แต่ Markdown จะทำให้ข้อมูลแบนลง (Flatten) ให้อยู่ในรูปของตาราง, YAML Frontmatter และลิงก์แบบ Inline แทน
- การรวมชื่อเรื่องและลิงก์: Markdown จะรวมชื่อเรื่อง ลิงก์ และคำอธิบายย่อ (Snippet) เข้าเป็นบรรทัดเดียวที่อ่านง่าย ช่วยลดภาระทางโครงสร้างและชื่อ Key ต่างๆ ลง
แม้ SerpApi จะไม่ได้ระบุต้นทุน Token ที่แน่นอนต่อรายฟิลด์ แต่ตัวเลขรวมที่ลดลงจาก 24,723 เหลือ 6,435 ก็เป็นหลักฐานที่ชัดเจนว่า ข้อมูลใดที่มีไว้เพื่อให้โค้ด Parse หรือเพื่อการแสดงผล UI แต่ไม่ได้มีไว้ให้โมเดลอ่าน ถือเป็นขยะ Token ที่ควรถูกกำจัด
กรณีที่ Markdown ไม่ใช่ตัวเลือกที่เหมาะสม
เอาต์พุตแบบ Markdown ถูกปรับแต่งมาเพื่อ LLM และ AI Agent โดยเฉพาะ แต่หาก Pipeline ของคุณต้องการประเภทข้อมูล (Data Types) ที่แม่นยำ เช่น ราคาสินค้าที่เป็นตัวเลขแน่นอน, พิกัดภูมิศาสตร์ หรือเรตติ้งในรูปแบบ Float รูปแบบ JSON ยังคงเป็นทางเลือกที่ดีกว่า
ตัวอย่างเช่น ผลลัพธ์จาก Naver Shopping ในรูปแบบ JSON จะแสดงราคาและเรตติ้งเป็นตัวเลขชัดเจน ซึ่งเหมาะสำหรับระบบคำนวณราคาหรืองานวิเคราะห์ข้อมูลเชิงลึก แต่สำหรับ Agent ที่ต้องการเพียงสรุปผลิตภัณฑ์ยอดนิยม ข้อมูลแบบตารางและลิงก์ Inline ใน Markdown จะให้ข้อมูลสำคัญที่เพียงพอในราคา Token ที่ถูกกว่ามาก
วิธีใช้งาน SerpApi ในรูปแบบ Markdown
คุณสามารถเปลี่ยนมาใช้งานรูปแบบ Markdown ได้ง่ายๆ ผ่าน 3 ช่องทางหลัก ซึ่งรองรับ API ของ SerpApi กว่า 100 รายการโดยไม่มีค่าใช้จ่ายเพิ่มเติม:
- เพิ่มพารามิเตอร์
output=mdในการเรียกใช้ API ปกติ - เรียกใช้ Endpoint
/search.mdแทนที่/searchเดิม - ตั้งค่า Request Header เป็น
Accept: text/markdown
นอกจากนี้ หากต้องการควบคุมข้อมูลให้เข้มงวดขึ้น สามารถใช้ฟีเจอร์ json_restrictor เพื่อเลือกเฉพาะ Key ที่ต้องการจากฝั่งเซิร์ฟเวอร์ ซึ่งจะช่วยลดขนาด Payload ก่อนส่งข้ามเครือข่ายได้อีกทางหนึ่ง
ตรวจสอบด้วยข้อมูลของคุณเอง
ผู้ใช้สามารถทดสอบประสิทธิภาพนี้ได้ทันทีโดยลองเพิ่ม output=md ใน Query ที่ใช้งานอยู่และนับจำนวน Token ก่อนและหลังดูด้วยตนเอง ส่วนต่างที่เกิดขึ้นคือสิ่งที่คุณประหยัดได้จริง ซึ่งจะแปรผันตามประเภทของ Search Engine และ Workflow ที่คุณใช้งาน
ถึงเวลาเปลี่ยนมาใช้ Markdown หรือยัง?
แม้ Markdown จะไม่ใช่ทางออกสำหรับทุกปัญหา แต่โครงสร้างของข้อมูลมีต้นทุน Token ที่ซ่อนอยู่เสมอ ในระบบ AI Agent ข้อมูลส่วนเกินเพียงเล็กน้อยจากการเรียกใช้แต่ละครั้งจะสะสมเป็นต้นทุนมหาศาล การปรับแต่ง Payload จึงเป็นวิธีที่ดีที่สุดในการควบคุมค่าใช้จ่าย หากสนใจศึกษาเพิ่มเติม สามารถดู ฟีเจอร์ใหม่ของ SerpApi ที่นี่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร