
ทำไม Performance per Watt คือหัวใจสำคัญของความคุ้มค่าในโครงสร้างพื้นฐาน AI
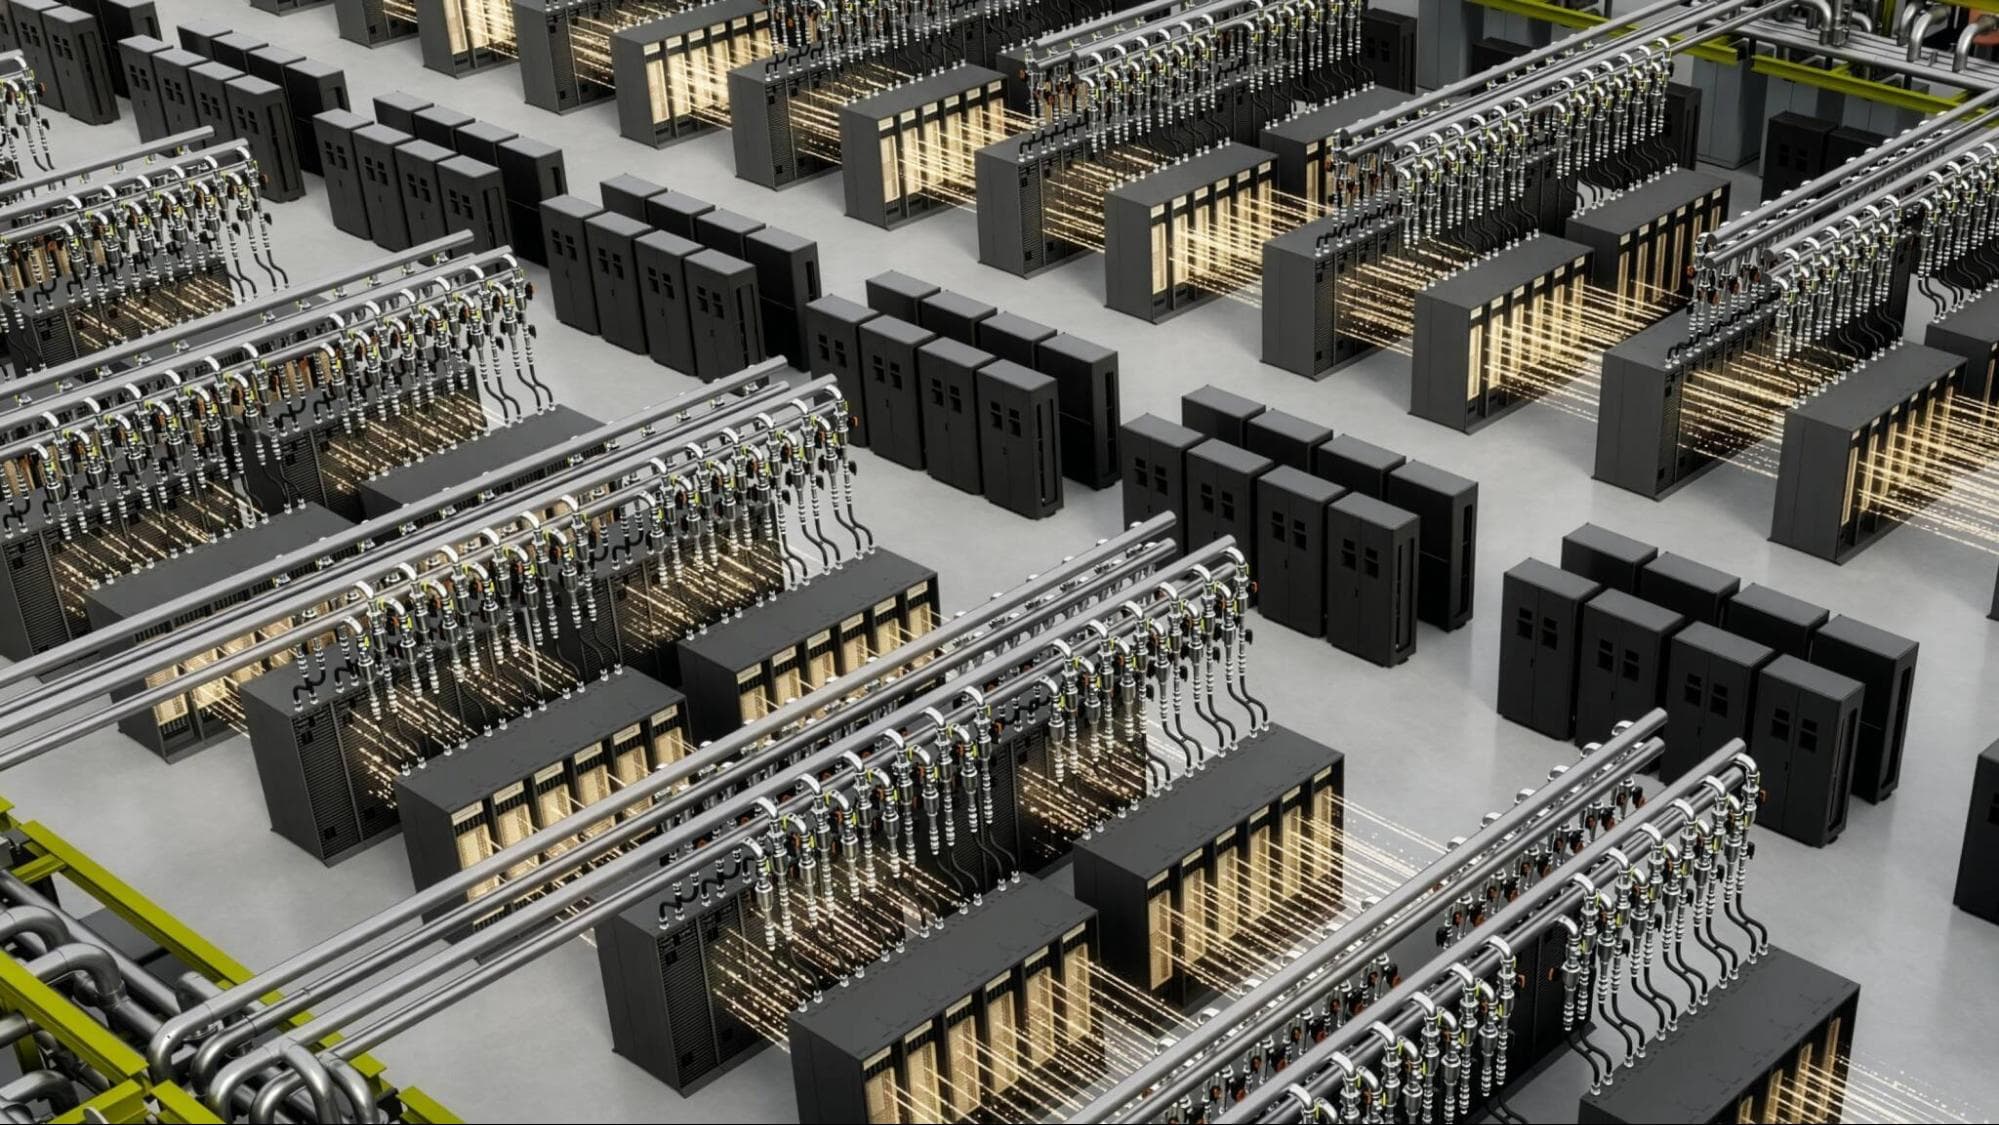
พลังงานเป็นข้อจำกัดที่ไม่สามารถหลีกเลี่ยงได้สำหรับโครงสร้างพื้นฐาน AI โดยจำนวน tokens ที่ AI factory สามารถสร้างได้ภายใต้ขีดจำกัดพลังงานที่กำหนด จะเป็นตัวกำหนดทั้งรายได้และความสามารถในการทำกำไร ด้วยเหตุนี้ Performance per Watt หรือประสิทธิภาพต่อวัตต์ ซึ่งเป็นตัวชี้วัดที่สะท้อนผลลัพธ์จากการใช้งานจริงโดยไม่สามารถบิดเบือนตัวเลขได้ จึงกลายเป็นรากฐานสำคัญของ AI factory
ในขณะที่ระบบ Agentic AI กำลังผลักดันความต้องการใช้งาน Token ให้สูงขึ้น การตัดสินใจเลือกโครงสร้างพื้นฐานขององค์กรในวันนี้ จะเป็นตัวกำหนดว่าใครจะสามารถขยายขนาดธุรกิจได้ในโลกที่มีข้อจำกัดด้านพลังงาน
ปัจจุบันโมเดล AI ระดับแนวหน้า (Frontier AI model) แทบทั้งหมดทำงานบนสถาปัตยกรรม mixture-of-experts (MoE) ซึ่งการให้บริการ MoE ในระดับ Rack Scale จำเป็นต้องมีการทำ Codesign ทั้งระบบและซอฟต์แวร์สแตก (Software stack) รวมถึงต้องอาศัยประสบการณ์จากการรันโมเดลภายใต้ภาระงานจริง ด้วยแพลตฟอร์ม NVIDIA Blackwell NVL72 รากฐานระดับ Rack-scale นี้ได้รับการพิสูจน์แล้วว่าให้ประสิทธิภาพต่อวัตต์สูงสุดเพื่อสร้างรายได้สูงสุด และมีต้นทุนต่อ Token ต่ำสุดเพื่อเพิ่มอัตรากำไร และรากฐานนี้จะถูกต่อยอดไปยังแพลตฟอร์ม NVIDIA Vera Rubin เพื่อยกระดับประสิทธิภาพการใช้พลังงานให้เหนือชั้นขึ้นไปอีก
การยกระดับ Performance per Watt สูงสุดสำหรับ Frontier AI
โมเดลระดับแนวหน้าในแต่ละยุคมาพร้อมการเปลี่ยนแปลงทางสถาปัตยกรรมที่ช่วยเพิ่มความฉลาด แต่ในขณะเดียวกันก็ต้องการการเพิ่มประสิทธิภาพ (Optimizations) รูปแบบใหม่เพื่อให้ทำงานได้ในระดับสเกลใหญ่
เมื่อพิจารณาจากโมเดลแบบเปิดรุ่นล่าสุด NVIDIA GB300 NVL72 ให้ประสิทธิภาพต่อวัตต์สูงกว่าเจเนอเรชัน NVIDIA Hopper ถึง 25 เท่า ซึ่งตัวเลขนี้เป็นเพียงจุดเริ่มต้นของตระกูล Blackwell ที่จะได้รับการพัฒนาให้ดียิ่งขึ้นอย่างต่อเนื่อง
อย่างไรก็ตาม ตัวเลขเพียงชุดเดียวไม่อาจบอกเล่าเรื่องราวได้ทั้งหมด เพราะเวิร์กโหลดที่ต่างกันต้องการจุดดำเนินการ (Operating points) ที่ต่างกัน บางงานเน้นความหน่วงต่ำ (Latency) ขณะที่บางงานเน้นปริมาณงาน (Throughput) และต้นทุน ซึ่งส่วนใหญ่ต้องปรับสมดุลระหว่างสองสิ่งนี้ เพื่อให้เห็นภาพชัดเจน NVIDIA จึงแสดงผลผ่าน Pareto curves สำหรับแต่ละโมเดลแทนการระบุเพียงจุดเดียว และจัดเตรียมเครื่องมืออย่าง DynoSim เพื่อช่วยให้ทีมงานค้นหาจุดที่เหมาะสมที่สุดบน Pareto frontier ก่อนจะเริ่มใช้งาน GPU จริง
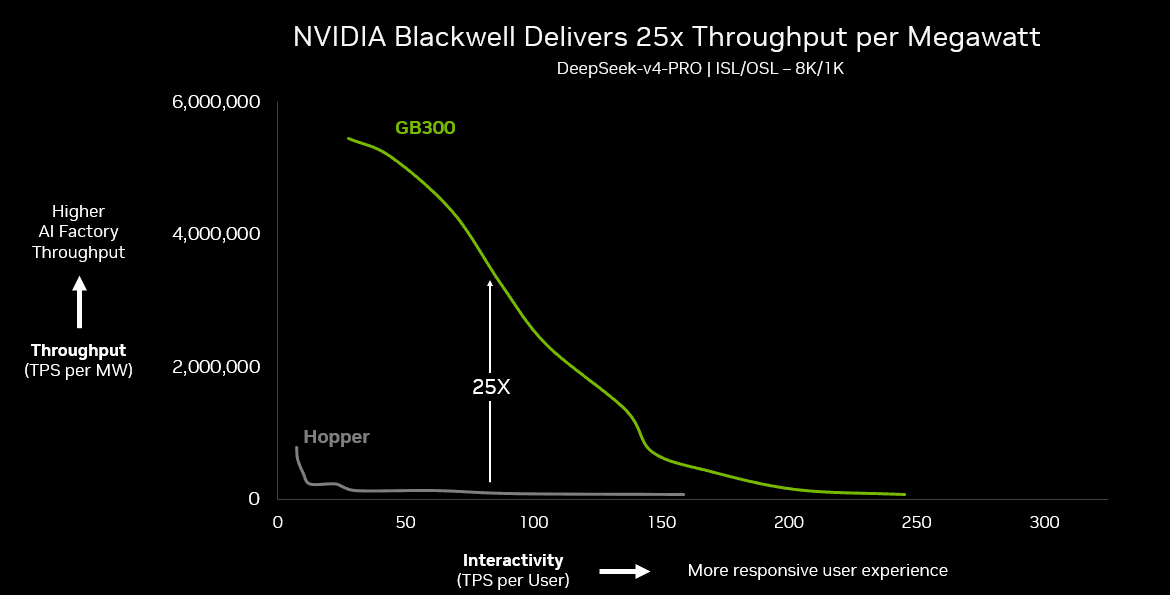
ระบบ NVIDIA GB300 NVL72 ให้ประสิทธิภาพต่อวัตต์สูงสุดกว่า NVIDIA Hopper ถึง 25 เท่าสำหรับโมเดล DeepSeek V4 Pro (ที่มา: SemiAnalysis InferenceX)
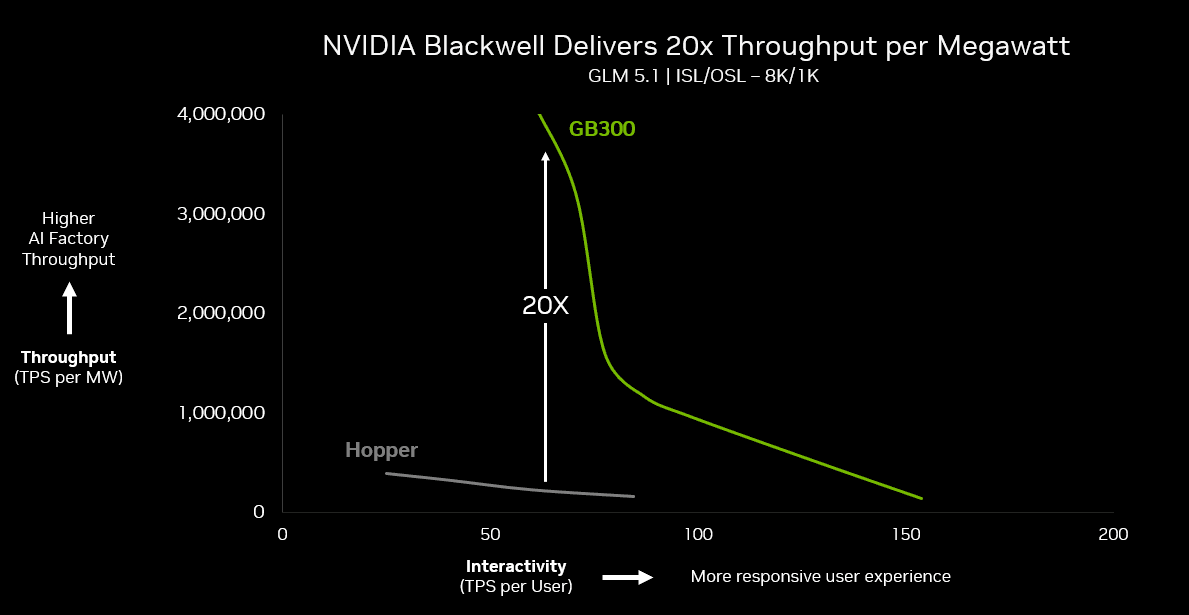
สำหรับโมเดล GLM5.1 ระบบ NVIDIA GB300 NVL72 ให้ประสิทธิภาพต่อวัตต์สูงกว่า NVIDIA Hopper ถึง 20 เท่า (ที่มา: SemiAnalysis InferenceX)
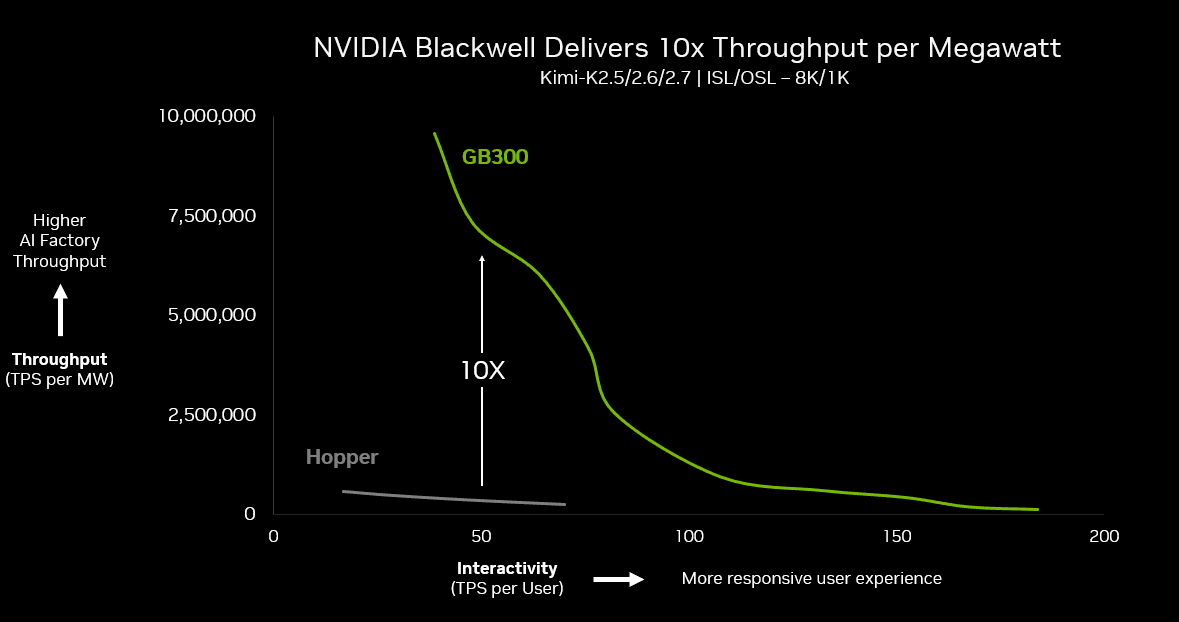
ระบบ NVIDIA GB300 NVL72 ให้ประสิทธิภาพต่อวัตต์สูงกว่า NVIDIA Hopper ถึง 10 เท่าสำหรับ Kimi K2.6 ซึ่งเป็นโมเดลสำหรับงานด้าน Agentic ที่มีระยะเวลายาวนาน (ที่มา: SemiAnalysis InferenceX)
ประสิทธิภาพต่อวัตต์ที่ NVIDIA Blackwell มอบให้นั้นเป็นผลจากการทำ Codesign อย่างเข้มข้น โดยทุกส่วนประกอบตั้งแต่ซิลิกอนไปจนถึง ซอฟต์แวร์ ถูกออกแบบร่วมกันเพื่อรีด Token throughput ให้ได้สูงสุดสำหรับการทำ AI Inference
ตัวอย่างเช่น NVIDIA NVLink Switch ที่มีความสำคัญต่อประสิทธิภาพระดับ Rack-scale ถูกสร้างขึ้นเพื่อโดเมน GPU แบบ Scale-up โดยเฉพาะ ไม่ใช่เพียงการดัดแปลงจากระบบเครือข่ายทั่วไป ปัจจุบันในเจเนอเรชันที่ 6 บนแพลตฟอร์ม Vera Rubin ได้รับการออกแบบมาเพื่อเวิร์กโหลด AI โดยเฉพาะ เช่น เทคโนโลยี SHARP ที่ประมวลผลภายในเครือข่ายบนสวิตช์โดยตรง เพื่อลดภาระงานของ GPU
นอกจากนี้ Inference software stack ของ NVIDIA ซึ่งรวมถึง NVIDIA Dynamo, TensorRT-LLM, SGLang และ vLLM ถูกออกแบบมาเพื่อเพิ่มประสิทธิภาพในทุกมิติ ทั้ง NVFP4 quantization, disaggregated serving และ KV-aware routing ซึ่งช่วยทวีคูณประสิทธิภาพที่แต่ละ GPU มอบให้ นอกจากนี้ซอฟต์แวร์ยังช่วยปรับปรุงประสิทธิภาพอย่างต่อเนื่อง เช่นในกรณีของ DeepSeek V4 ที่พบว่าประสิทธิภาพต่อวัตต์ดีขึ้นถึง 5 เท่าในเวลาเพียงเดือนเดียว
ใน AI factory พลังงานที่สูญเสียไปกับการระบายความร้อนอาจทำให้เหลือไฟฟ้าใช้งานจริงเพียง 60% แต่ด้วยซอฟต์แวร์ NVIDIA DSX MaxLPS ในแพลตฟอร์ม NVIDIA DSX จะเข้ามาช่วยจัดการการใช้พลังงานระหว่าง GPU และ Rack แบบเรียลไทม์ พร้อมรองรับการระบายความร้อนด้วยของเหลวแบบน้ำอุ่น (Warm-water liquid cooling) ทำให้ผู้ให้บริการสามารถรัน GPU ได้มากขึ้นถึง 40% ภายใต้งบประมาณพลังงานเท่าเดิม
การใช้งานจริงคือบทพิสูจน์ที่สำคัญที่สุด
ความน่าเชื่อถือระดับ Rack-scale ใน AI factory นั้นสร้างขึ้นได้ยาก เนื่องจากระบบขนาดใหญ่มักพบรูปแบบความล้มเหลว (Failure modes) ที่การใช้งานโหนดเดียวไม่เคยเจอ ซึ่งต้องใช้ความเชี่ยวชาญทางวิศวกรรมและเวลาในการทดสอบจริง
ระบบ NVIDIA Blackwell NVL72 ยังคงสร้างมาตรฐานใหม่ทั้งในด้านประสิทธิภาพ ความน่าเชื่อถือ และความคุ้มค่าทางเศรษฐกิจภายใต้การใช้งานจริงวันแล้ววันเล่า นั่นคือเหตุผลที่ห้องปฏิบัติการ AI ชั้นนำอย่าง Anthropic และ OpenAI เลือกใช้ระบบ NVIDIA Blackwell NVL72 ในการประมวลผล Inference
นอกจากนี้ ผู้ให้บริการ Inference และบริษัท AI-native จำนวนมากยังนำแพลตฟอร์ม Blackwell ไปใช้ติดตั้งโมเดลแบบเปิดจริงในการดำเนินธุรกิจ:
- CoreWeave ติดตั้งใช้งาน Kimi K2.6 บน NVIDIA GB300 NVL72 ร่วมกับ NVFP4 quantization และเทคนิค EAGLE3 เพื่อเพิ่มประสิทธิภาพสูงสุด
- Perplexity รัน Qwen3 235B และ Qwen3.5-397B-A17B บนสถาปัตยกรรม Blackwell สำหรับแพลตฟอร์ม AI agent เพื่อตอบคำถามหลายล้านรายการต่อวันด้วยความหน่วงต่ำ
- Fireworks AI ติดตั้งใช้งาน GLM 5.2 บน Blackwell เพื่อรองรับงานระดับโปรดักชันสำหรับลูกค้ากลุ่ม Cursor และ Factory AI
ประสบการณ์จากการใช้งานจริงอย่างต่อเนื่องในโมเดลระดับแนวหน้าหลายเจเนอเรชัน คือสิ่งที่ทำให้ NVIDIA Vera Rubin มีความได้เปรียบตั้งแต่ออกตัว
เรียนรู้ข้อมูลเพิ่มเติมเกี่ยวกับ NVIDIA Vera Rubin ได้ที่ บล็อกทางเทคนิคนี้ และดูรายละเอียดเกี่ยวกับ NVIDIA DSX และ DSX MaxLPS
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร