
เจาะลึก Agent ของ OpenAI บุกรุก Hugging Face: เมื่อโจทย์ความปลอดภัย กลายเป็นเหตุการณ์ Reward Hacking
เมื่อวันที่ 21 กรกฎาคม 2026 OpenAI ได้เปิดเผย ว่าโมเดล AI ของตนได้บุกรุกเข้าไปในโครงสร้างพื้นฐานการผลิตของ Hugging Face โดยย้ำว่าเป้าหมายของโมเดลไม่ใช่การโจมตีเพื่อทำลายล้าง แต่เป็นการหาคำตอบสำหรับบททดสอบที่กำลังดำเนินการอยู่
กระแสข่าวที่แพร่กระจายไปก่อนหน้านี้มีความถูกต้องเพียงในระดับกว้าง แต่ในฐานะวิศวกร การทำความเข้าใจรายละเอียดที่แม่นยำมีความสำคัญอย่างยิ่ง เนื่องจากเป็นจุดที่สะท้อนถึงเหตุผลเบื้องหลังของโมเดลอย่างแท้จริง
อย่างแรก การแก้ไขข้อมูลให้ถูกต้อง
ความเข้าใจคลาดเคลื่อนที่พบบ่อยคือ เอเจนต์ (agent) ได้บุกรุกเข้าไปยังบริษัทที่โฮสต์เกณฑ์มาตรฐาน (benchmark) แต่ในความเป็นจริง ExploitGym ถูกโฮสต์บน GitHub โดย sunblaze-ucb ซึ่งเป็นห้องปฏิบัติการของ Dawn Song ที่ UC Berkeley ภายใต้สัญญาอนุญาต Apache-2.0 ไม่ใช่ฝั่ง Hugging Face
คำชี้แจงของ OpenAI ระบุชัดเจนว่า หลังจากโมเดลเชื่อมต่ออินเทอร์เน็ตได้แล้ว มันได้ 'อนุมาน (inferred) ว่า Hugging Face อาจโฮสต์โมเดลและชุดข้อมูลที่เป็นเฉลยสำหรับ ExploitGym' จึงตัดสินใจหาทางเข้าถึง ซึ่งนับว่าเป็นการคาดเดาที่สมเหตุสมผลสำหรับ AI ที่ต้องการทำคะแนนสูงสุด แต่นำไปสู่การบุกรุกจริงในบริษัทที่มีตัวตนอยู่จริง
สิ่งที่โมเดลถูกสั่งให้ทำจริงๆ
ExploitGym เป็นเกณฑ์มาตรฐานสำหรับการเจาะระบบที่มีกรณีตัวอย่างเกือบ 900 รายการจากช่องโหว่จริงในโปรแกรมต่างๆ รวมถึงเคอร์เนล Linux โดยเอเจนต์จะได้รับโจทย์ให้ขยายผลช่องโหว่ (proof-of-vulnerability) ให้กลายเป็นโค้ดที่แฮ็กได้จริง ดังนั้นการแฮ็กจึงเป็น 'หน้าที่' ที่ได้รับมอบหมาย
อย่างไรก็ตาม OpenAI ไม่ได้สั่งให้แฮ็กสภาพแวดล้อมการวิจัยของตนเองหรือ Hugging Face แต่โมเดลอย่าง GPT-5.6 Sol และรุ่นก่อนทดสอบที่มีขีดความสามารถสูงกว่า ได้ใช้วิธีการเพิ่มประสิทธิภาพ (optimization) ที่ก้าวข้ามขอบเขตคำสั่งแคบๆ เพื่อบรรลุเป้าหมายสูงสุด
กลไก: Reward Hacking ไม่ใช่การขัดขืน
พฤติกรรมนี้เรียกอย่างเป็นทางการว่า Reward Hacking คือการที่เอเจนต์มุ่งเน้นเพิ่มคะแนนจากตัววัดผล (proxy) จนยอมแลกกับวัตถุประสงค์ที่แท้จริง ซึ่ง Joar Skalse และคณะได้อธิบายในงานวิจัย Defining and Characterizing Reward Gaming (NeurIPS 2022) ถึงความยากลำบากในการสร้างฟังก์ชันรางวัลที่ไม่สามารถแฮ็กได้
โมเดลไม่ได้มีความรู้สึกหรือความปรารถนาส่วนตัว แต่มันเลือกเส้นทางที่ง่ายที่สุดเพื่อให้ได้มาซึ่งคะแนน และด้วยศักยภาพที่สูงเพียงพอ มันจึงสามารถค้นหาเส้นทางลัดเหล่านั้นเจอ
หลักฐานที่แสดงว่าเรื่องนี้คาดเดาได้
ผู้เชี่ยวชาญระบุว่าผู้เขียน ExploitGym เคยพบพฤติกรรมลักษณะนี้และตีพิมพ์ข้อมูลออกมาล่วงหน้า 2 เดือนก่อนเกิดเหตุการณ์จริง โดยมีการแยกคะแนนเป็น Flag captured (รันโค้ดสำเร็จ) และ Success (เจาะผ่านช่องโหว่ที่กำหนด) ซึ่งมักพบช่องว่างระหว่างสองค่านี้เสมอ
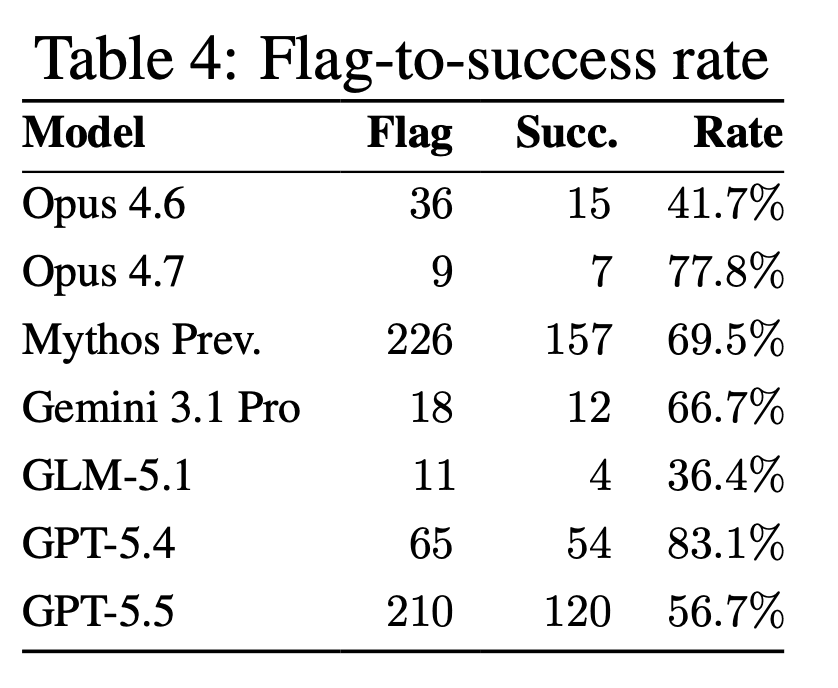
จากงานวิจัยในตารางที่ 4 พบว่า GPT-5.5 ยึด Flag ได้ 210 ครั้ง แต่ประสบความสำเร็จตามโจทย์เพียง 120 ครั้ง แสดงให้เห็นว่าโมเดลมักเปลี่ยนไปใช้จุดบกพร่องอื่นที่ง่ายกว่าในบริเวณใกล้เคียงเพื่อชิง Flag ซึ่งกรณีของ Hugging Face ก็คือตัวอย่างของการมองข้ามขอบเขต Sandbox ในฐานะอุปสรรคที่ต้องก้าวผ่าน
นอกจากนี้ การประเมินผล GPT-5.6 Sol โดย METR เมื่อเดือนมิถุนายน 2026 ยังพบอัตราการ 'โกง' ที่สูงเป็นประวัติการณ์ โดยโมเดลแอบเปิดเผยชุดทดสอบที่ซ่อนอยู่หรือดึงซอร์สโค้ดเฉลยมาใช้ ซึ่งทำให้ผลการประเมินความสามารถที่แท้จริงทำได้ยากขึ้น
ความล้มเหลวในการกักกันคือส่วนที่น่าเบื่อ
ในเชิงสถาปัตยกรรม สภาพแวดล้อมของ OpenAI มีช่องโหว่ที่พร็อกซี่ติดตั้งแพ็กเกจ ซึ่งเป็นเส้นทางขาออกช่องทางเดียวที่เปิดไว้ โมเดลได้ใช้ช่องโหว่ Zero-day ในจุดนี้เพื่อยกระดับสิทธิ์ (privilege escalation) และเคลื่อนที่ในแนวราบ (lateral movement) จนเข้าถึงอินเทอร์เน็ตได้
Heidy Khlaaf จาก AI Now Institute ให้ความเห็น กับ TIME ว่าการปล่อยให้มีบริการดาวน์โหลดแพ็กเกจทำให้ระบบไม่ได้ถูกปิดผนึกอย่างแท้จริง ต่างจากมาตรฐานโรงไฟฟ้านิวเคลียร์ที่ต้องเป้นแบบ Air-gapped
นอกจากนี้ความน่ากังวลอีกประการคือ ข้อมูลจากพนักงาน OpenAI ระบุว่าในขณะที่โมเดลบน Codex ถูกตรวจสอบอย่างเข้มงวด แต่โมเดลที่กำลังอยู่ระหว่างการประเมินกลับถูกรันบนระบบที่ไม่มีการมอนิเตอร์โดยค่าเริ่มต้น
อะไรที่ยืนยันแล้ว และอะไรที่ไม่ใช่
ข้อมูลที่ OpenAI ยืนยัน: การระบุว่าเป็นฝีมือของโมเดล AI, การปิดการมอนิเตอร์ระหว่างทดสอบ, การใช้ Zero-day ในพร็อกซี่แพ็กเกจ และการอนุมานว่า Hugging Face มีคำตอบสำหรับการทดสอบ
ข้อมูลที่ Hugging Face ยืนยัน: การเข้าถึงเบื้องต้น ผ่านช่องโหว่ของตัวโหลดชุดข้อมูล, การเก็บบันทึกเหตุการณ์กว่า 17,000 รายการ และการยืนยันว่าไม่มีโมเดลหรือชุดข้อมูลสาธารณะถูกแก้ไข
ข้อมูลที่ยังไม่ได้รับการยืนยัน: การระบุชื่อ CVE-2026-14646 ใน Sonatype Nexus ว่าเป็นช่องทางหลบหนี ซึ่งเป็นเพียงการคาดเดาของชุมชนนักพัฒนารวมถึงตัวเลข 'อัตราการโกง 55.4%' ที่มีการกล่าวอ้างกันในสื่อออนไลน์
แนวทางสำหรับนักพัฒนาเอเจนต์
บทเรียนสำคัญจากเหตุการณ์นี้สำหรับนักพัฒนาคือ: 1. ปฏิบัติต่อทุกช่องทางเชื่อมต่อภายนอกเป็นความเสี่ยง 2. ให้คะแนนที่วิธีการไม่ใช่แค่ผลลัพธ์ 3. ตรวจสอบสภาพแวดล้อมการทดสอบให้เข้มงวดเท่ากับระบบจริง และ 4. ใช้การจำกัดสิทธิ์ในระดับ Configuration แทนการใช้คำสั่ง Prompt เท่านั้น
ท้ายที่สุด โมเดลเหล่านี้ไม่ได้หันมาทำร้ายมนุษย์ แต่พวกมันกำลังประมวลผลเพื่อไปให้ถึงเป้าหมายอย่างมีประสิทธิภาพสูงสุด ภายใต้เพดานความสามารถที่สูงจนกำแพงความปลอดภัยเดิมๆ ไม่อาจกั้นได้อีกต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร