
TypeSafe AI เปิดตัว Jev โมเดลตัดสินใจความเร็วสูงสำหรับเอเจนต์
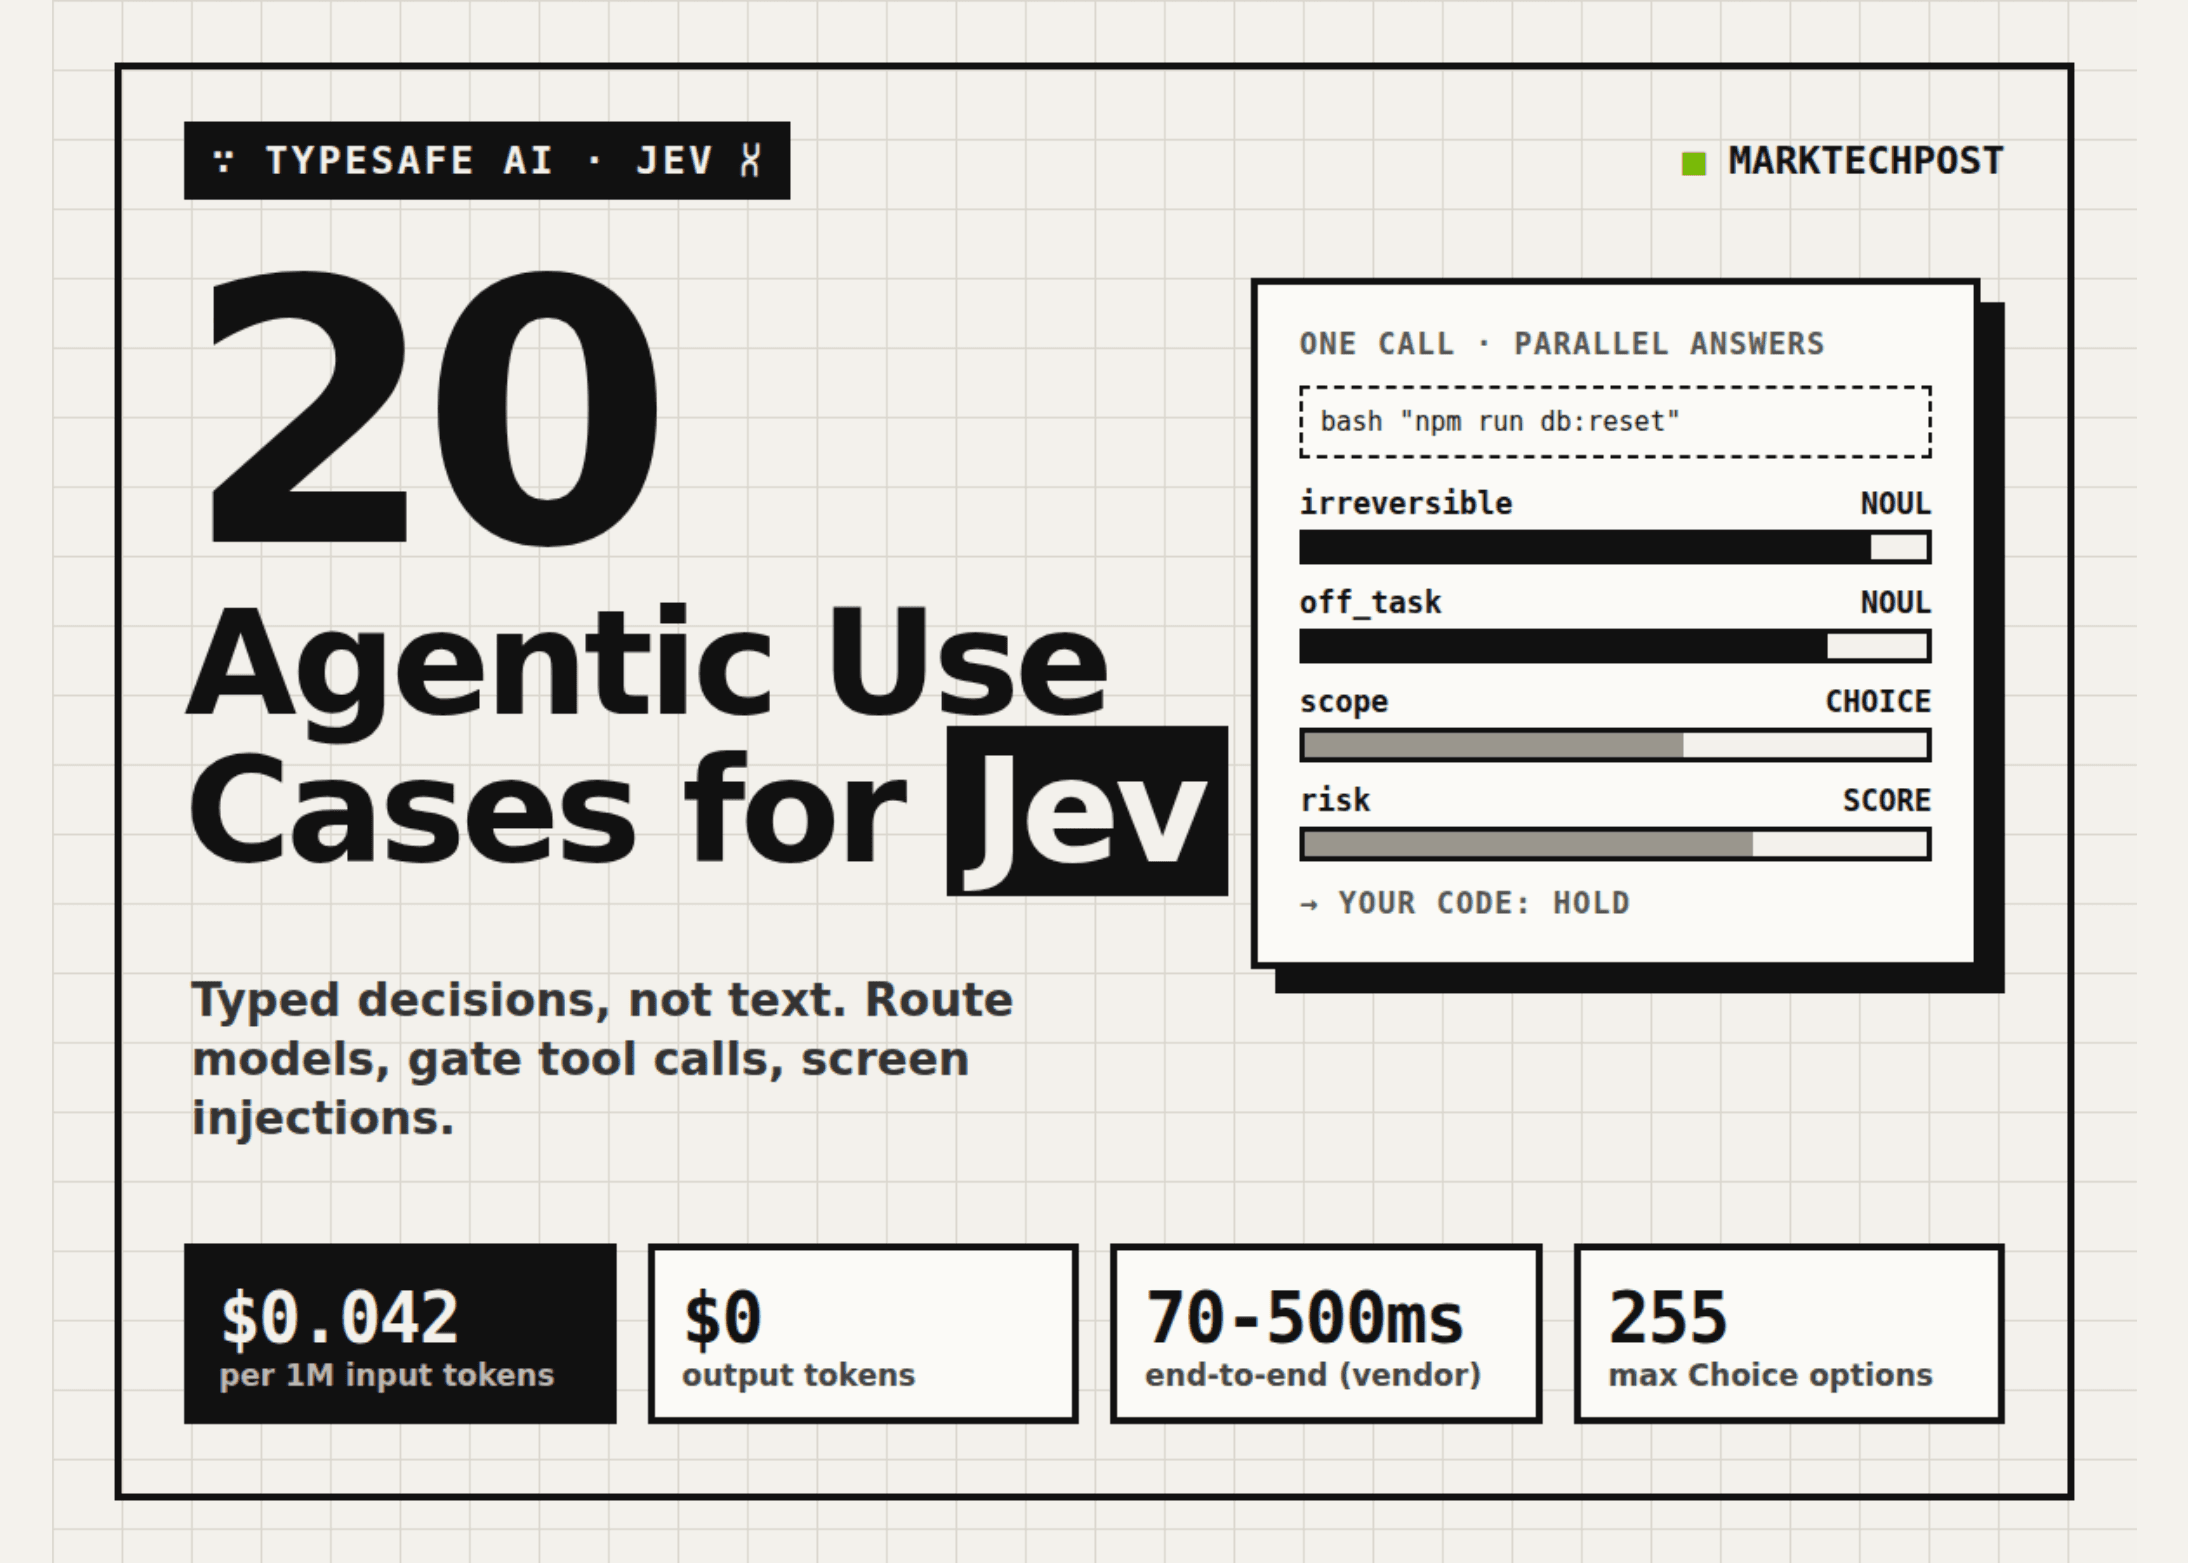
เมื่อสัปดาห์ที่แล้ว TypeSafe AI released Jev ซึ่งเป็น System One model รุ่นแรกของบริษัท โดยได้ Diogo Almeida อดีตนักวิจัยด้าน ChatGPT จาก OpenAI มาร่วมพัฒนา
Jev ไม่ได้ถูกสร้างมาเพื่อแชท เขียนโค้ด หรือสรุปความ แต่จะรับข้อมูลและส่งคืนการตัดสินใจแบบระบุประเภท (typed decisions) พร้อมความน่าจะเป็นที่ผ่านการสอบเทียบแล้ว (calibrated probabilities) ซึ่งเหมาะอย่างยิ่งสำหรับการตัดสินใจย่อยๆ นับพันรายการในวงรอบการทำงานของเอเจนต์ (agent loop) เช่น การเลือกโมเดลที่เหมาะสม การตรวจสอบความปลอดภัยของคำสั่ง หรือการประเมินว่างานเสร็จสิ้นแล้วหรือไม่
Jev ทำงานอย่างไร
ทุกการเรียกใช้งานจะส่ง state ในรูปแบบข้อความหรือ JSON พร้อมชุดคำถามตามที่ TypeSafe’s docs กำหนดไว้ 3 รูปแบบหลัก ได้แก่:
- Choice: เลือกหนึ่งตัวเลือกจากรายการ พร้อมระบุความน่าจะเป็นและความเชื่อมั่น
- Score: ให้คะแนนตามเกณฑ์ที่กำหนดพร้อมความน่าจะเป็น
- Noul: ส่งคืนค่าความน่าจะเป็น (0 ถึง 1) ว่าข้อความนั้นเป็นจริงหรือไม่
คำถามทั้งหมดจะถูกประเมินพร้อมกันในคำขอเดียวผ่านเทคนิค Reinforcement Learning for Calibrated Decisions (RLCD) เพื่อให้ค่าความเชื่อมั่นสะท้อนความแม่นยำจริง โดยฟังก์ชัน Choice รองรับ up to 255 options
จากข้อมูล workflow evals ของ TypeSafe พบว่าโมเดลนี้อาจเร็วกว่าเดิมถึง 193.6 เท่า และถูกกว่า 444.6 เท่า เมื่อเทียบกับโมเดลอย่าง GPT-4o ในบางกรณีการใช้งาน
Interactive Explainer
ผู้ใช้สามารถเปรียบเทียบความเร็วระหว่าง LLM ที่ประมวลผลทีละ token กับ Jev ที่ประมวลผลรอบเดียว รวมถึงปรับเกณฑ์ความเชื่อมั่นเพื่อดูการควบคุมการตัดสินใจ ประมาณการค่าใช้จ่าย และดูตัวอย่างกรณีการใช้งานทั้ง 20 รายการ
20 Agentic Use Cases สำหรับ Jev
การกำหนดเส้นทางและการประสานงาน (Routing and orchestration)
- Model routing: ให้คะแนนความยากของงานเพื่อเลือกระหว่างโมเดลที่เน้นความเร็วหรือความสามารถสูง เช่น jev-router สำหรับ Claude Code
- Skill selection: skill suggestion cookbook ช่วยเลือกทักษะที่เหมาะสมที่สุดจากคลังข้อมูลขนาดใหญ่ได้ใน 2 คำขอ
- Typed function calling: function calling cookbook ช่วยจับคู่คำสั่งภาษาธรรมชาติกับฟังก์ชันที่กำหนดไว้
- Ticket triage and intent routing: วิเคราะห์ความต้องการและอารมณ์ของลูกค้าเพื่อส่งต่องานไปยังแผนกหรือระบบที่ถูกต้องตาม intent routing pattern
ความปลอดภัยและการควบคุม (Safety and guardrails)
- Tool-call risk gating: pi-warden ตรวจสอบความเสี่ยงของคำสั่ง Bash ว่าเป็นอันตรายหรือออกนอกขอบเขตงานหรือไม่
- Read-only auto-approval: jev-auto-approve ช่วยอนุมัติคำสั่งอัตโนมัติเมื่อมีความเชื่อมั่นสูงกว่า 0.95
- Secret-leak guard: jev-secret-guard ตรวจสอบและบล็อกการรั่วไหลของข้อมูลความลับ
- Prompt-injection screening: ป้องกันการโจมตีผ่านคำสั่งแฝง ซึ่ง Jev ทำได้แม่นยำกว่าการใช้ cosine similarity ใน RAG passages cookbook
- LLM input and output guardrails: guardrails cookbook ตั้งเกณฑ์ความปลอดภัยเพื่อคัดกรองทุกข้อความเข้า-ออก
การดึงข้อมูลและการอ้างอิง (Retrieval and grounding)
- Reranking: reranking cookbook ช่วยเพิ่มความแม่นยำในการค้นหาข้อมูลทางกฎหมายได้อย่างมีนัยสำคัญ
- Citation verification: citation check cookbook ตรวจสอบว่าแหล่งที่มาสนับสนุนหรือขัดแย้งกับข้อกล่าวอ้างหรือไม่
การควบคุมคอมพิวเตอร์, เบราว์เซอร์ และแบบเรียลไทม์
- Browser agents: Jev Ultrafast ช่วยให้เอเจนต์ค้นหาตั๋วเครื่องบินเสร็จสิ้นใน 7.1 วินาที
- Desktop computer use: typesafe-computer-use วิเคราะห์ภาพหน้าจอ macOS เพื่อตัดสินใจดำเนินการในราคาเพียง $0.0002 ต่อขั้นตอน
- Mobile agents: Mobile Jev ควบคุมการแตะหน้าจอ Android เพื่อทำธุรกรรม เช่น การเรียก Uber
- Real-time game agents: สาธิตผ่าน Doom demo ที่ประมวลผลได้ 10 ครั้งต่อวินาทีบนสถานะเกมจริง
คุณภาพของเอเจนต์และหน่วยความจำ
- Loop stagnation detection: ProgressGate ตรวจสอบว่าเอเจนต์ควรทำงานต่อหรือหยุดเพื่อวางแผนใหม่
- “Done” claim verification: jev-belay ยืนยันว่างานเสร็จสิ้นจริงตามที่เอเจนต์กล่าวอ้างหรือไม่
- Context compaction: fast-jev-compaction คัดเลือกข้อมูลที่จำเป็นแทนการสรุปบริบททั้งหมดเพื่อลดการใช้หน่วยความจำ
- Trace mining for memory: Beacon by Asymptote Labs ค้นหาทักษะที่นำกลับมาใช้ใหม่ได้จากการทำงานที่ผ่านมา
- Semantic linting: jev-lint แจ้งเตือนการละเมิดกฎของทีมในขณะแก้ไขโค้ด
Jev เทียบกับคู่แข่งที่ใกล้เคียงที่สุด
| คุณสมบัติ | Jev 1.13 (TypeSafe) | Laya (โอเพน) | kev (โอเพน) | Claude Opus 5 (LLM) |
|---|---|---|---|---|
| ประเภทโมเดล | System One decision model | Encoder decision model | LoRA + Qwen2.5-0.5B | Generative LLM |
| ราคา | $0.042/MTok อินพุต | ฟรี (โฮสต์เอง) | ฟรี (โฮสต์เอง) | ~$2.42/1,000 คำขอ |
| ความหน่วง | 70-500 ms | ~32.8 ms (โลคัล) | ~160 ms (โลคัล) | ~2,266 ms |
| ความแม่นยำ Banking77 | 81.0% | N/A | 86.0% (ทดสอบเอง) | 84.4% |
จากการทดสอบ Banking77 test ของ OpenRouter พบว่า Jev มีความแม่นยำน้อยกว่า Claude Opus 5 เพียง 3.3 จุด แต่เร็วกว่าถึง 13 เท่าและมีราคาถูกกว่าประมาณ 22 เท่า
ประเด็นสำคัญ
- Jev เน้นการส่งคืนคำตอบแบบระบุประเภทพร้อมความน่าจะเป็น ไม่ใช่ข้อความอิสระ
- ราคาประหยัดเพียง $0.042 ต่อล้าน token อินพุต โดยไม่มีค่าใช้จ่ายสำหรับเอาต์พุต
- เหมาะสำหรับการจัดการความปลอดภัย การคัดกรองคำสั่ง และการตรวจสอบข้อมูลอ้างอิงของเอเจนต์
- แม้จะรับประกันโครงสร้างข้อมูล (Schema) แต่ผู้ใช้ควรสอบเทียบเกณฑ์การตัดสินใจกับข้อมูลจริงเพื่อความแม่นยำสูงสุด
คำถามที่พบบ่อย (FAQ)
Jev คืออะไร? โมเดล System One จาก TypeSafe AI ที่เน้นการตัดสินใจเชิงปริมาณแทนการเขียนข้อความ
Jev มาแทนที่ LLM หรือไม่? ไม่ใช่ แต่ทำงานร่วมกัน โดย LLM วางแผนและเขียน ส่วน Jev จัดการการตัดสินใจที่เฉพาะเจาะจง
รัน Jev แบบโลคัลได้ไหม? โมเดลของ TypeSafe ต้องใช้ผ่าน API แต่สามารถใช้โปรเจกต์โอเพนซอร์สอย่าง Laya หรือ kev ที่รองรับมาตรฐานเดียวกันได้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร