
5 แนวทางปฏิบัติเพื่อสร้าง Python AI Library ให้แข็งแกร่งระดับโปรดักชัน
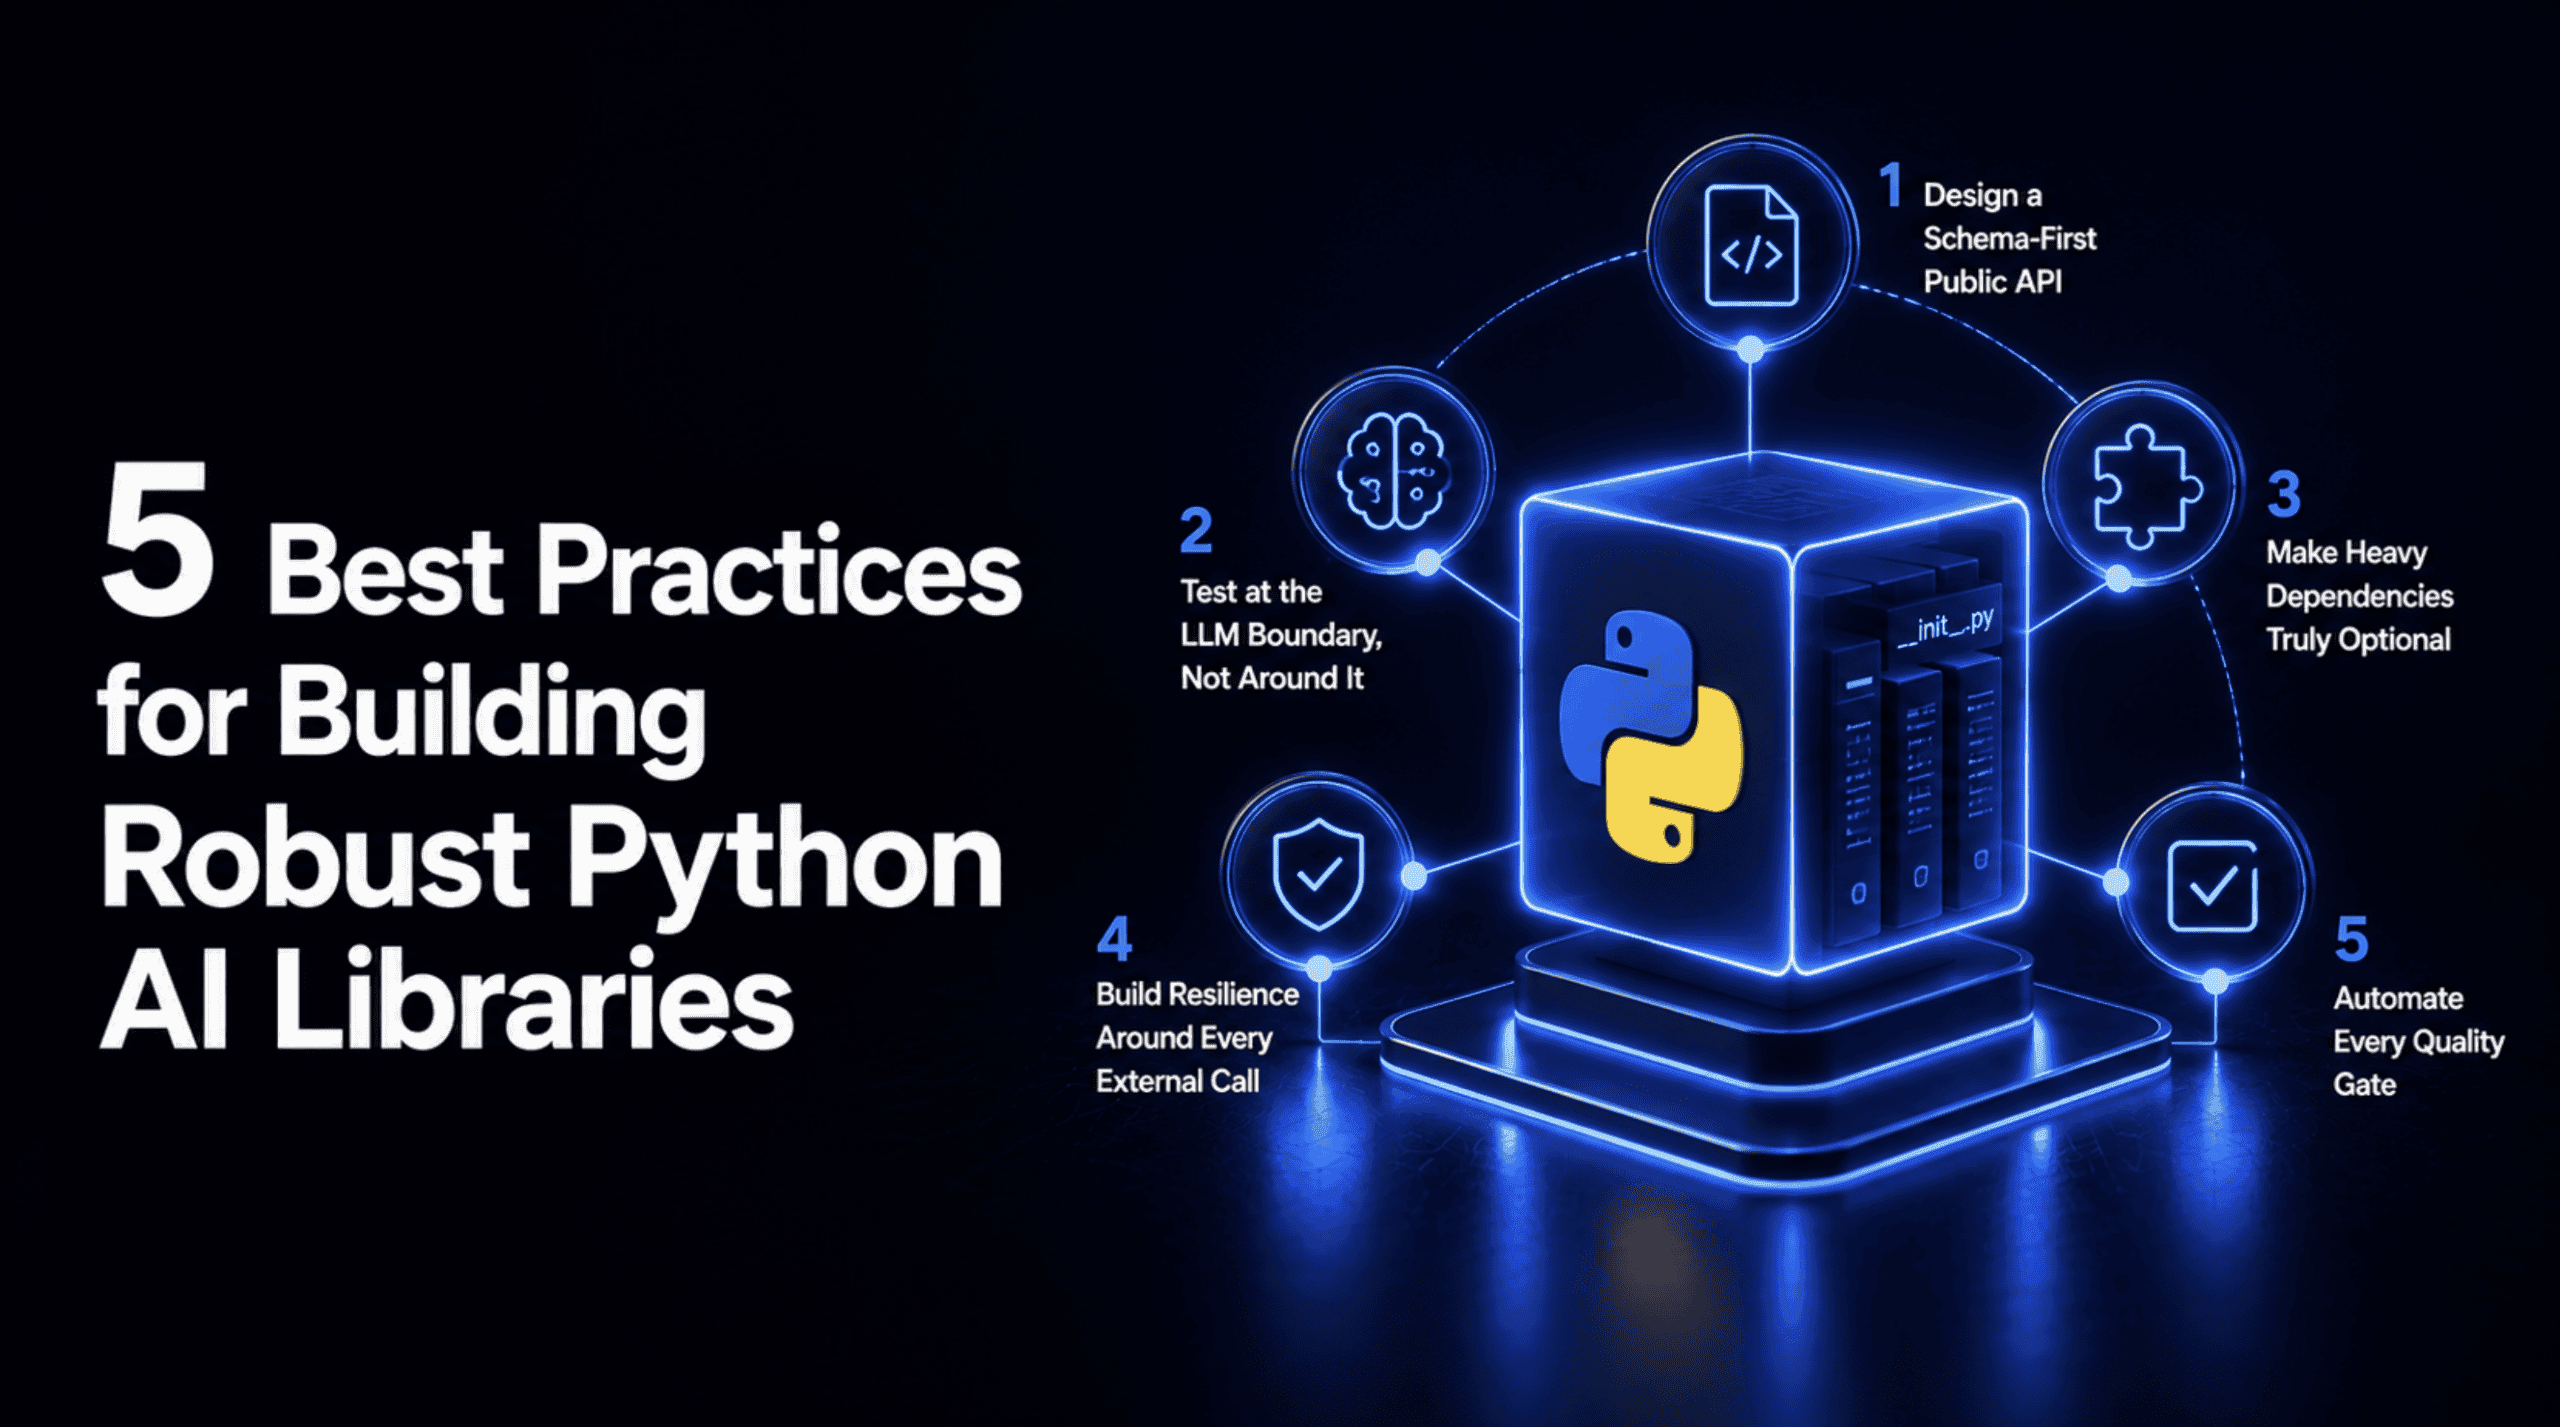
AI wrapper แบบโอเพนซอร์สส่วนใหญ่มักทำงานได้สมบูรณ์แบบใน Notebook ของผู้พัฒนา แต่เมื่อถูกนำไปใช้งานจริงเพียงหนึ่งสัปดาห์ ปัญหาต่างๆ มักเริ่มปรากฏขึ้น ไม่ว่าจะเป็นระบบล่มด้วย KeyError เมื่อ API key หายไป การติดตั้งแพ็กเกจที่ดึงเฟรมเวิร์กขนาดหลายกิกะไบต์มาโดยไม่จำเป็น หรือชุดการทดสอบที่ผ่านบ้างไม่ผ่านบ้างตามอารมณ์ของโมเดลภาษา
สิ่งเหล่านี้ไม่ใช่แค่ปัญหาของโค้ดที่แย่ แต่เป็นความท้าทายเฉพาะตัวของไลบรารี AI ที่มีรูปแบบความล้มเหลวต่างจากซอฟต์แวร์ทั่วไป เช่น ผลลัพธ์ที่ไม่แน่นอนตาม Schema, Dependency ขนาดมหึมา และ API บุคคลที่สามที่ล้มเหลวได้หลากรูปแบบ บทความนี้จะเจาะลึก 5 แนวทางปฏิบัติที่จะเปลี่ยนแพ็กเกจ AI จากแค่ตัวเดโมให้กลายเป็นเครื่องมือที่พร้อมใช้งานในระดับโปรดักชัน
Prerequisites
บทความนี้สมมติว่าคุณมีความคุ้นเคยกับ Python packaging สมัยใหม่ที่ใช้ pyproject.toml แทน setup.py รวมถึงมีความเข้าใจในการใช้งาน pytest และพื้นฐานการเรียกใช้งาน LLM หรือ API ของผู้ให้บริการโมเดลต่างๆ
สิ่งที่ไลบรารี Python AI ที่แข็งแกร่งควรจะเป็นจริงๆ
นิยามของไลบรารี AI ที่แข็งแกร่งตามคำแนะนำจาก Python Packaging User Guide และมาตรฐานปี 2026 คือการมี Type Coverage ที่สมบูรณ์พร้อมเครื่องหมาย py.typed เพื่อให้ตัวตรวจเช็คประเภทมองเห็นคำอธิบายประกอบของคุณ
นอกจากนี้ต้องมีโครงสร้างตามมาตรฐาน PEP 621 และ Public API ที่ตรวจสอบความถูกต้องของข้อมูล (Validation) เสมอ เนื่องจากการทำงานของโมเดลไม่มีการรับประกันความถูกต้องของข้อมูลขาออก รวมถึงต้องมีการแยก Dependency (Isolation) และความยืดหยุ่นต่อการเรียกใช้งานภายนอก
ตัวอย่างจริงที่น่าศึกษา
การศึกษาโค้ดจากโปรเจกต์ที่ประสบความสำเร็จจะช่วยให้เห็นภาพชัดเจนขึ้น:
- Python SDK ของ OpenAI: โดดเด่นเรื่อง
__init__.pyที่สะอาดตาและระบบ CI ที่รัดกุม - Instructor: ตัวอย่างการตรวจสอบข้อมูลตาม Schema โดยใช้ Pydantic
- PydanticAI: เน้นปรัชญา Type Safety ตั้งแต่เริ่มต้น
- LiteLLM: อินเทอร์เฟซที่เป็นเอกภาพสำหรับผู้ให้บริการหลายราย
- Hugging Face Transformers: ต้นแบบการจัดการ Dependency หนักๆ ให้เป็นทางเลือก (Optional)
สรุปแนวทางปฏิบัติที่ดีที่สุด 5 ประการ
| แนวทางปฏิบัติ | ปัญหาที่แก้ไข |
|---|---|
| Public API ที่ยึด Schema เป็นหลัก | ผลลัพธ์ของโมเดลไม่รับประกันความถูกต้องตามที่ขอ |
| การทดสอบที่ขอบเขตของ LLM | การตอบสนองของโมเดลไม่แน่นอน (Nondeterministic) |
| Dependency เสริมผ่าน extras | เฟรมเวิร์ก AI มีขนาดใหญ่ระดับกิกะไบต์ |
| ความยืดหยุ่นรอบการเรียกภายนอก | API ของผู้ให้บริการล้มเหลวในรูปแบบที่คาดเดายาก |
| ประตูกั้นคุณภาพอัตโนมัติ | ป้องกันคุณภาพถดถอยด้วยการบังคับใช้ผ่านระบบ |
แนวทางปฏิบัติที่ 1: การออกแบบ Public API ที่ยึด Schema เป็นหลัก
กฎเหล็กคืออย่าปล่อยให้สตริงดิบหรือ Dictionary ที่ไม่มีประเภทข้อมูลข้ามขอบเขตไลบรารีของคุณเด็ดขาด เพราะโมเดลอาจคืนค่า JSON ที่ผิดรูปแบบหรือฟิลด์ขาดหาย ซึ่งจะนำไปสู่การล่มของระบบในจุดที่ไล่หาต้นเหตุได้ยาก
ตัวอย่างโค้ดการใช้ Pydantic เพื่อตรวจสอบความถูกต้องของใบแจ้งหนี้:
from pydantic import BaseModel, ValidationError
from openai import OpenAI

client = OpenAI()

class ExtractedInvoice(BaseModel):
    vendor: str
    total: float
    due_date: str

class SchemaValidationError(Exception):
    """Raised when a model's response doesn't match the expected schema."""

def extract_invoice(raw_text: str) -> ExtractedInvoice:
    """Extract structured invoice fields from raw text. Returns a
    validated ExtractedInvoice, never a raw dict or string."""
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "Extract invoice fields as JSON: vendor, total, due_date."},
            {"role": "user", "content": raw_text},
        ],
        response_format={"type": "json_object"},
    )
    raw_json = response.choices[0].message.content

try:
        return ExtractedInvoice.model_validate_json(raw_json)
    except ValidationError as e:
        raise SchemaValidationError(
            f"Model returned data that doesn't match ExtractedInvoice: {e}"
        ) from e
การใช้ response_format={"type": "json_object"} ช่วยให้มั่นใจว่าข้อมูลที่ได้เป็น JSON จริงๆ และการครอบ ValidationError ด้วย Exception เฉพาะของไลบรารีจะช่วยให้ผู้เรียกใช้งานจัดการข้อผิดพลาดได้ง่ายขึ้น โดยที่ยังคง Traceback เดิมไว้เพื่อการดีบั๊ก
แนวทางปฏิบัติที่ 2: การทดสอบที่ขอบเขตของ LLM
การทดสอบ AI ไม่ควรเช็คคำตอบของโมเดลแบบตรงตัวเพราะจะทำให้การทดสอบไม่เสถียร (Flake) วิธีที่ถูกต้องคือการจำลอง (Mock) ขอบเขตระหว่างโค้ดของคุณกับผู้ให้บริการ API เพื่อตรวจสอบว่า Prompt ถูกสร้างถูกต้องและระบบจัดการผลลัพธ์ที่ผิดพลาดได้ตามคาด
from unittest.mock import patch, MagicMock
import pytest
from mylib.invoices import extract_invoice, SchemaValidationError

def _mock_response(content: str) -> MagicMock:
    mock = MagicMock()
    mock.choices = [MagicMock(message=MagicMock(content=content))]
    return mock

@patch("mylib.invoices.client")
def test_extract_invoice_parses_valid_response(mock_client):
    mock_client.chat.completions.create.return_value = _mock_response(
        '{"vendor": "Acme Corp", "total": 452.10, "due_date": "2026-09-01"}'
    )

result = extract_invoice("some raw invoice text")

assert result.vendor == "Acme Corp"
    assert result.total == 452.10

sent_messages = mock_client.chat.completions.create.call_args.kwargs["messages"]
    assert "Extract invoice fields as JSON" in sent_messages[0]["content"]

@patch("mylib.invoices.client")
def test_extract_invoice_raises_on_malformed_output(mock_client):
    mock_client.chat.completions.create.return_value = _mock_response(
        '{"vendor": "Acme Corp"}'  # missing total and due_date
    )

with pytest.raises(SchemaValidationError):
        extract_invoice("some raw invoice text")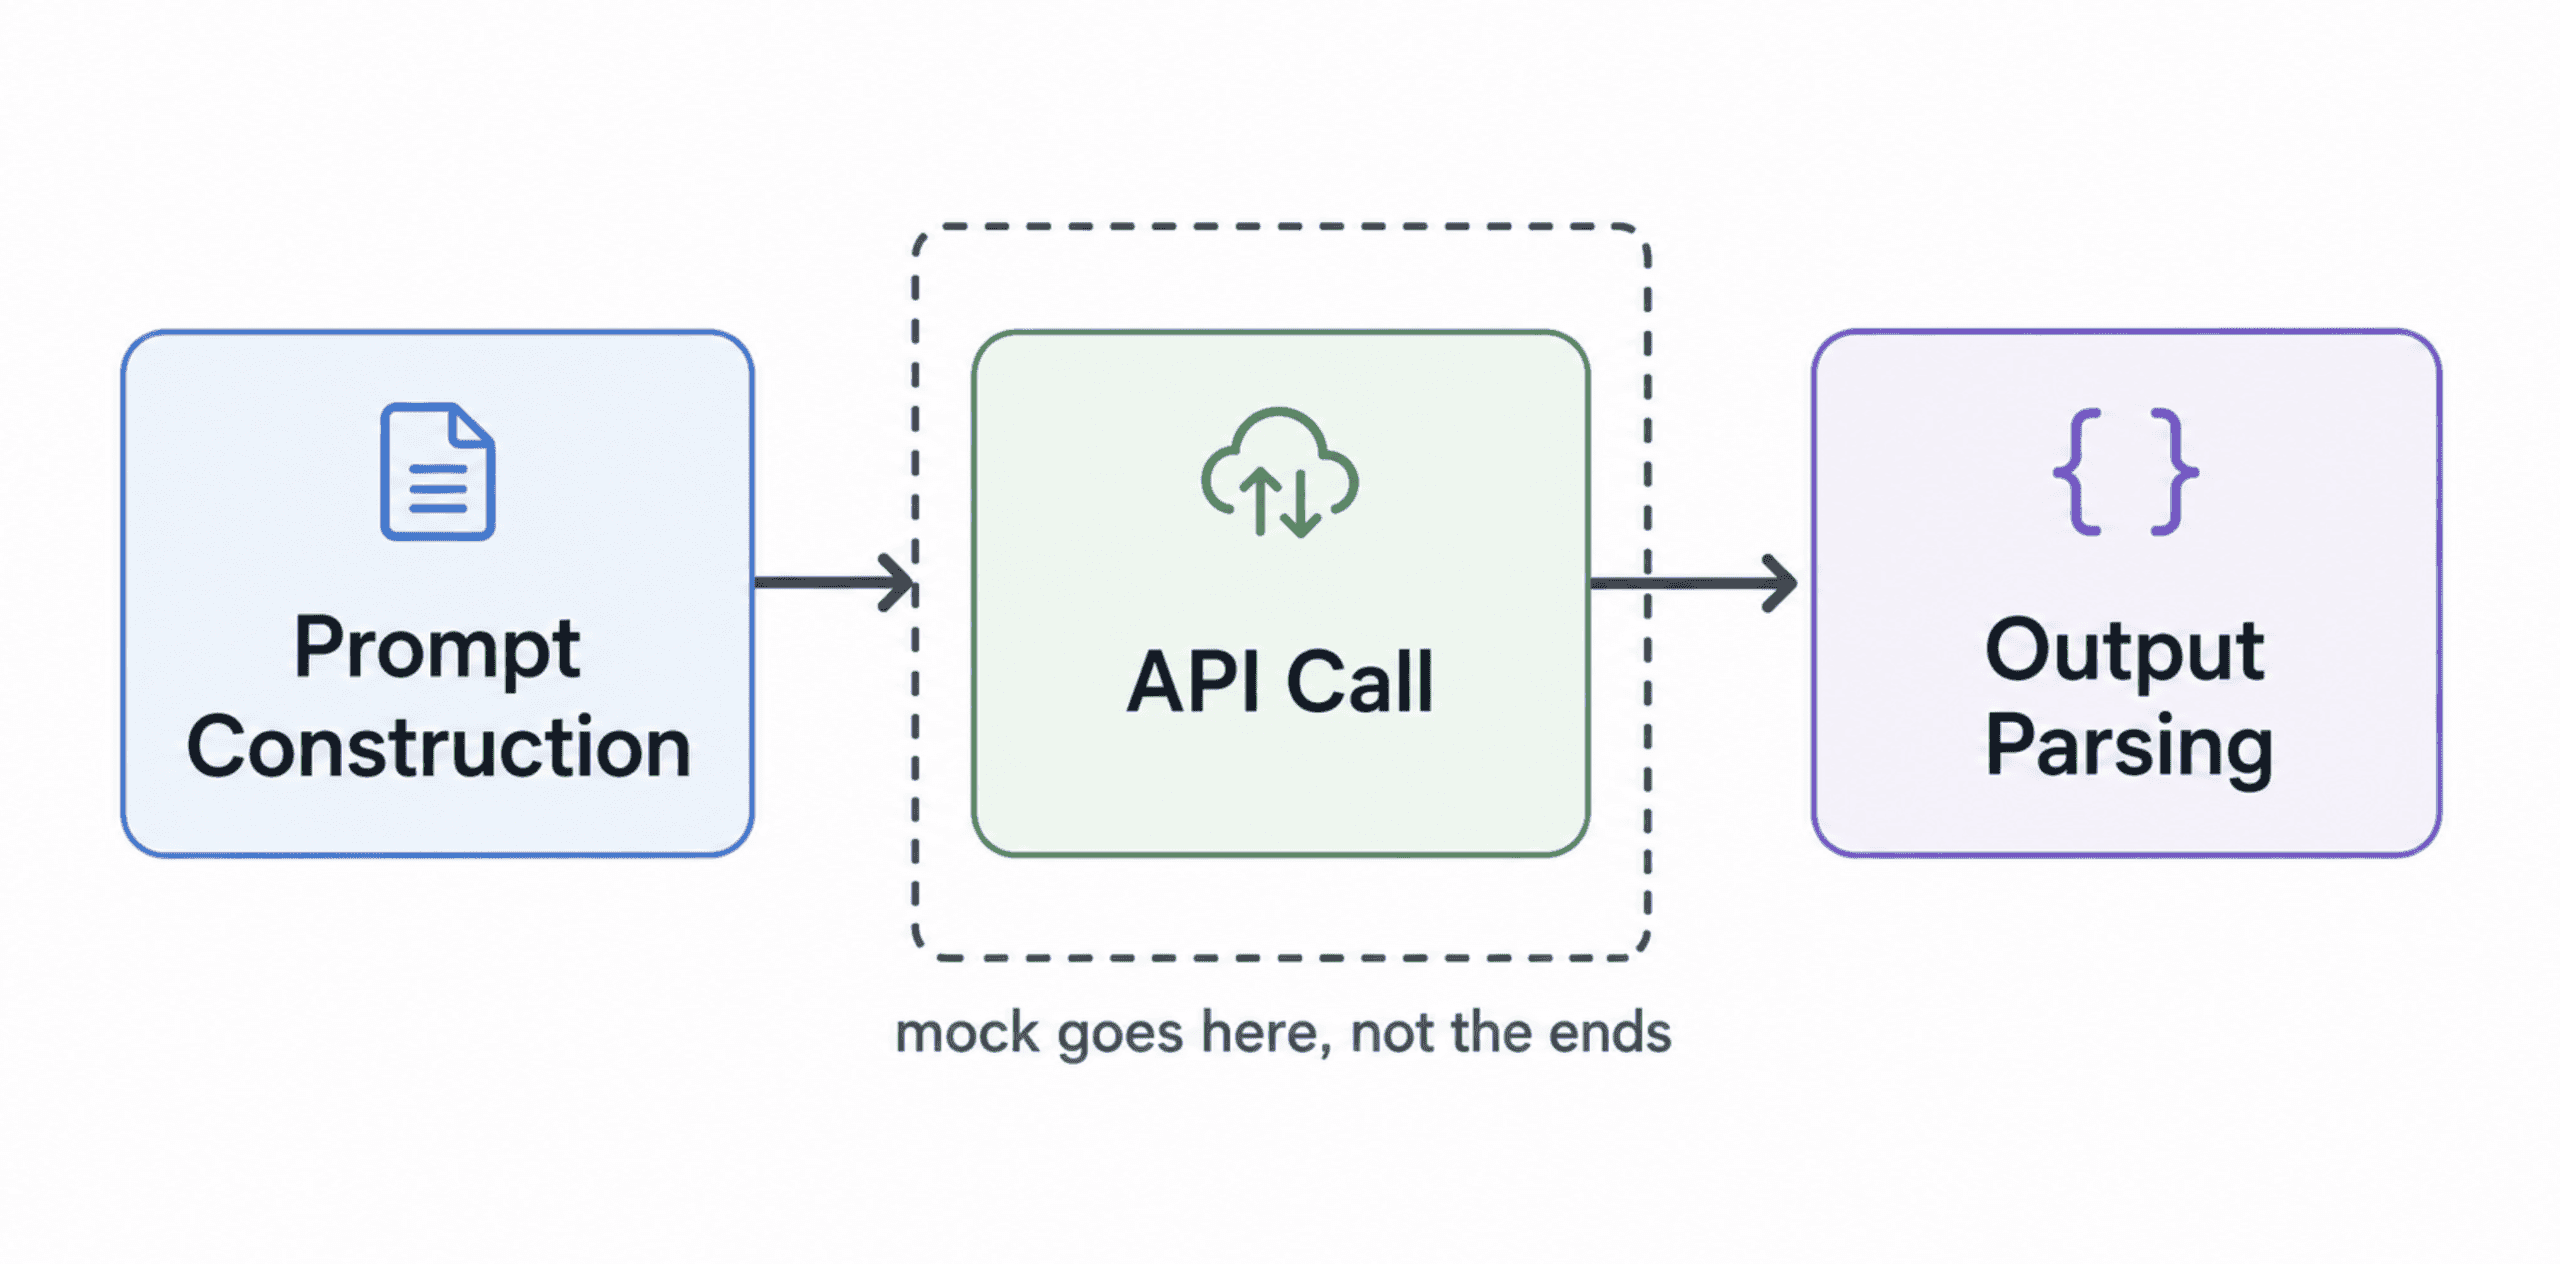
แนวทางปฏิบัติที่ 3: การทำให้ Heavy Dependency เป็นทางเลือก
ไลบรารี AI ควรเปิดให้ผู้ใช้เลือกว่าจะใช้ API ภายนอกหรือโมเดลในเครื่อง โดยไม่บังคับให้ต้องติดตั้งเฟรมเวิร์กหนักๆ อย่าง torch หากไม่จำเป็น เราสามารถใช้กลไก optional-dependencies ใน pyproject.toml ร่วมกับ Lazy Import ได้
[project]
name = "mylib"
dependencies = [
    "pydantic>=2.0",
    "httpx>=0.27",
]

[project.optional-dependencies]
openai = ["openai>=1.0"]
local = ["torch>=2.0", "transformers>=4.40"]
all = ["mylib[openai,local]"]
เมื่อผู้ใช้เรียกฟังก์ชันที่ต้องใช้ Dependency เสริมแต่ไม่ได้ติดตั้ง ระบบควรแจ้งข้อผิดพลาดพร้อมวิธีแก้ไขที่ชัดเจน เช่น pip install 'mylib[local]' เพื่อลดความสับสน
แนวทางปฏิบัติที่ 4: ความยืดหยุ่นรอบการเรียกใช้งานภายนอก เนื่องจากผู้ให้บริการ API อาจมีการจำกัดความถี่หรือขัดข้องชั่วคราว การใช้ระบบ Retry พร้อม Exponential Backoff จึงสำคัญมาก เพื่อป้องกันไม่ให้ปัญหาเล็กน้อยกลายเป็นความล้มเหลวถาวร
import logging
import httpx
from tenacity import (
    retry,
    stop_after_attempt,
    wait_exponential,
    retry_if_exception_type,
    before_sleep_log,
)

logger = logging.getLogger("mylib")

@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=1, max=10),
    retry=retry_if_exception_type((httpx.TimeoutException, httpx.HTTPStatusError)),
    before_sleep=before_sleep_log(logger, logging.WARNING),
    reraise=True,
)
def _call_provider(client, **kwargs):
    return client.chat.completions.create(timeout=15.0, **kwargs)
การตั้งค่า stop_after_attempt ป้องกันไม่ให้เกิด Loop ที่ไม่มีวันสิ้นสุด และการเลือก Retry เฉพาะ Exception ที่เหมาะสมจะช่วยประหยัดเวลาและค่าใช้จ่ายได้มหาศาล
แนวทางปฏิบัติที่ 5: ประตูกั้นคุณภาพอัตโนมัติ เพื่อให้มาตรฐานข้างต้นถูกนำไปใช้อย่างต่อเนื่อง ควรใช้เครื่องมืออย่าง uv, ruff, mypy และ pytest เชื่อมต่อเข้ากับ CI Workflow ของ GitHub Actions เพื่อตรวจสอบโค้ดโดยอัตโนมัติในทุก Pull Request
# .github/workflows/ci.yml
name: CI

on:
  push:
    branches: [main]
  pull_request:

jobs:
  quality:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: astral-sh/setup-uv@v3
      - run: uv sync --all-extras --dev
      - run: uv run ruff check .
      - run: uv run ruff format --check .
      - run: uv run mypy src/
      - run: uv run pytest --cov=mylib --cov-report=term-missing tests/
ข้อผิดพลาดทั่วไปที่ควรระวัง
- การเขียน API Key หรือชื่อโมเดลลงในโค้ดโดยตรง (Hardcoding)
- การทดสอบกับโมเดลจริงในระบบ CI ซึ่งทำให้การทดสอบช้าและไม่แน่นอน
- การไว้วางใจผลลัพธ์จากโมเดลโดยไม่มีการตรวจสอบ Schema
- การลืมใส่ไฟล์
py.typedซึ่งจะทำให้การตรวจสอบประเภทของผู้ใช้ปลายทางล้มเหลว
บทสรุป
การสร้างไลบรารี AI ที่ดีไม่ใช่แค่การทำให้ฟีเจอร์ทำงานได้ แต่คือการสร้างความเชื่อมั่นให้กับผู้ใช้เมื่อเกิดสิ่งผิดปกติ ไลบรารีที่เตรียมพร้อมรับมือกับความไม่แน่นอนของโมเดลและการขัดข้องของ API ได้อย่างเป็นระบบ คือไลบรารีที่จะถูกเลือกนำไปใช้งานในระดับโปรดักชันอย่างแท้จริง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร