
7 โมเดล AI เฉพาะทางขนาดเล็กที่ทรงพลังกว่า LLM ยักษ์ใหญ่
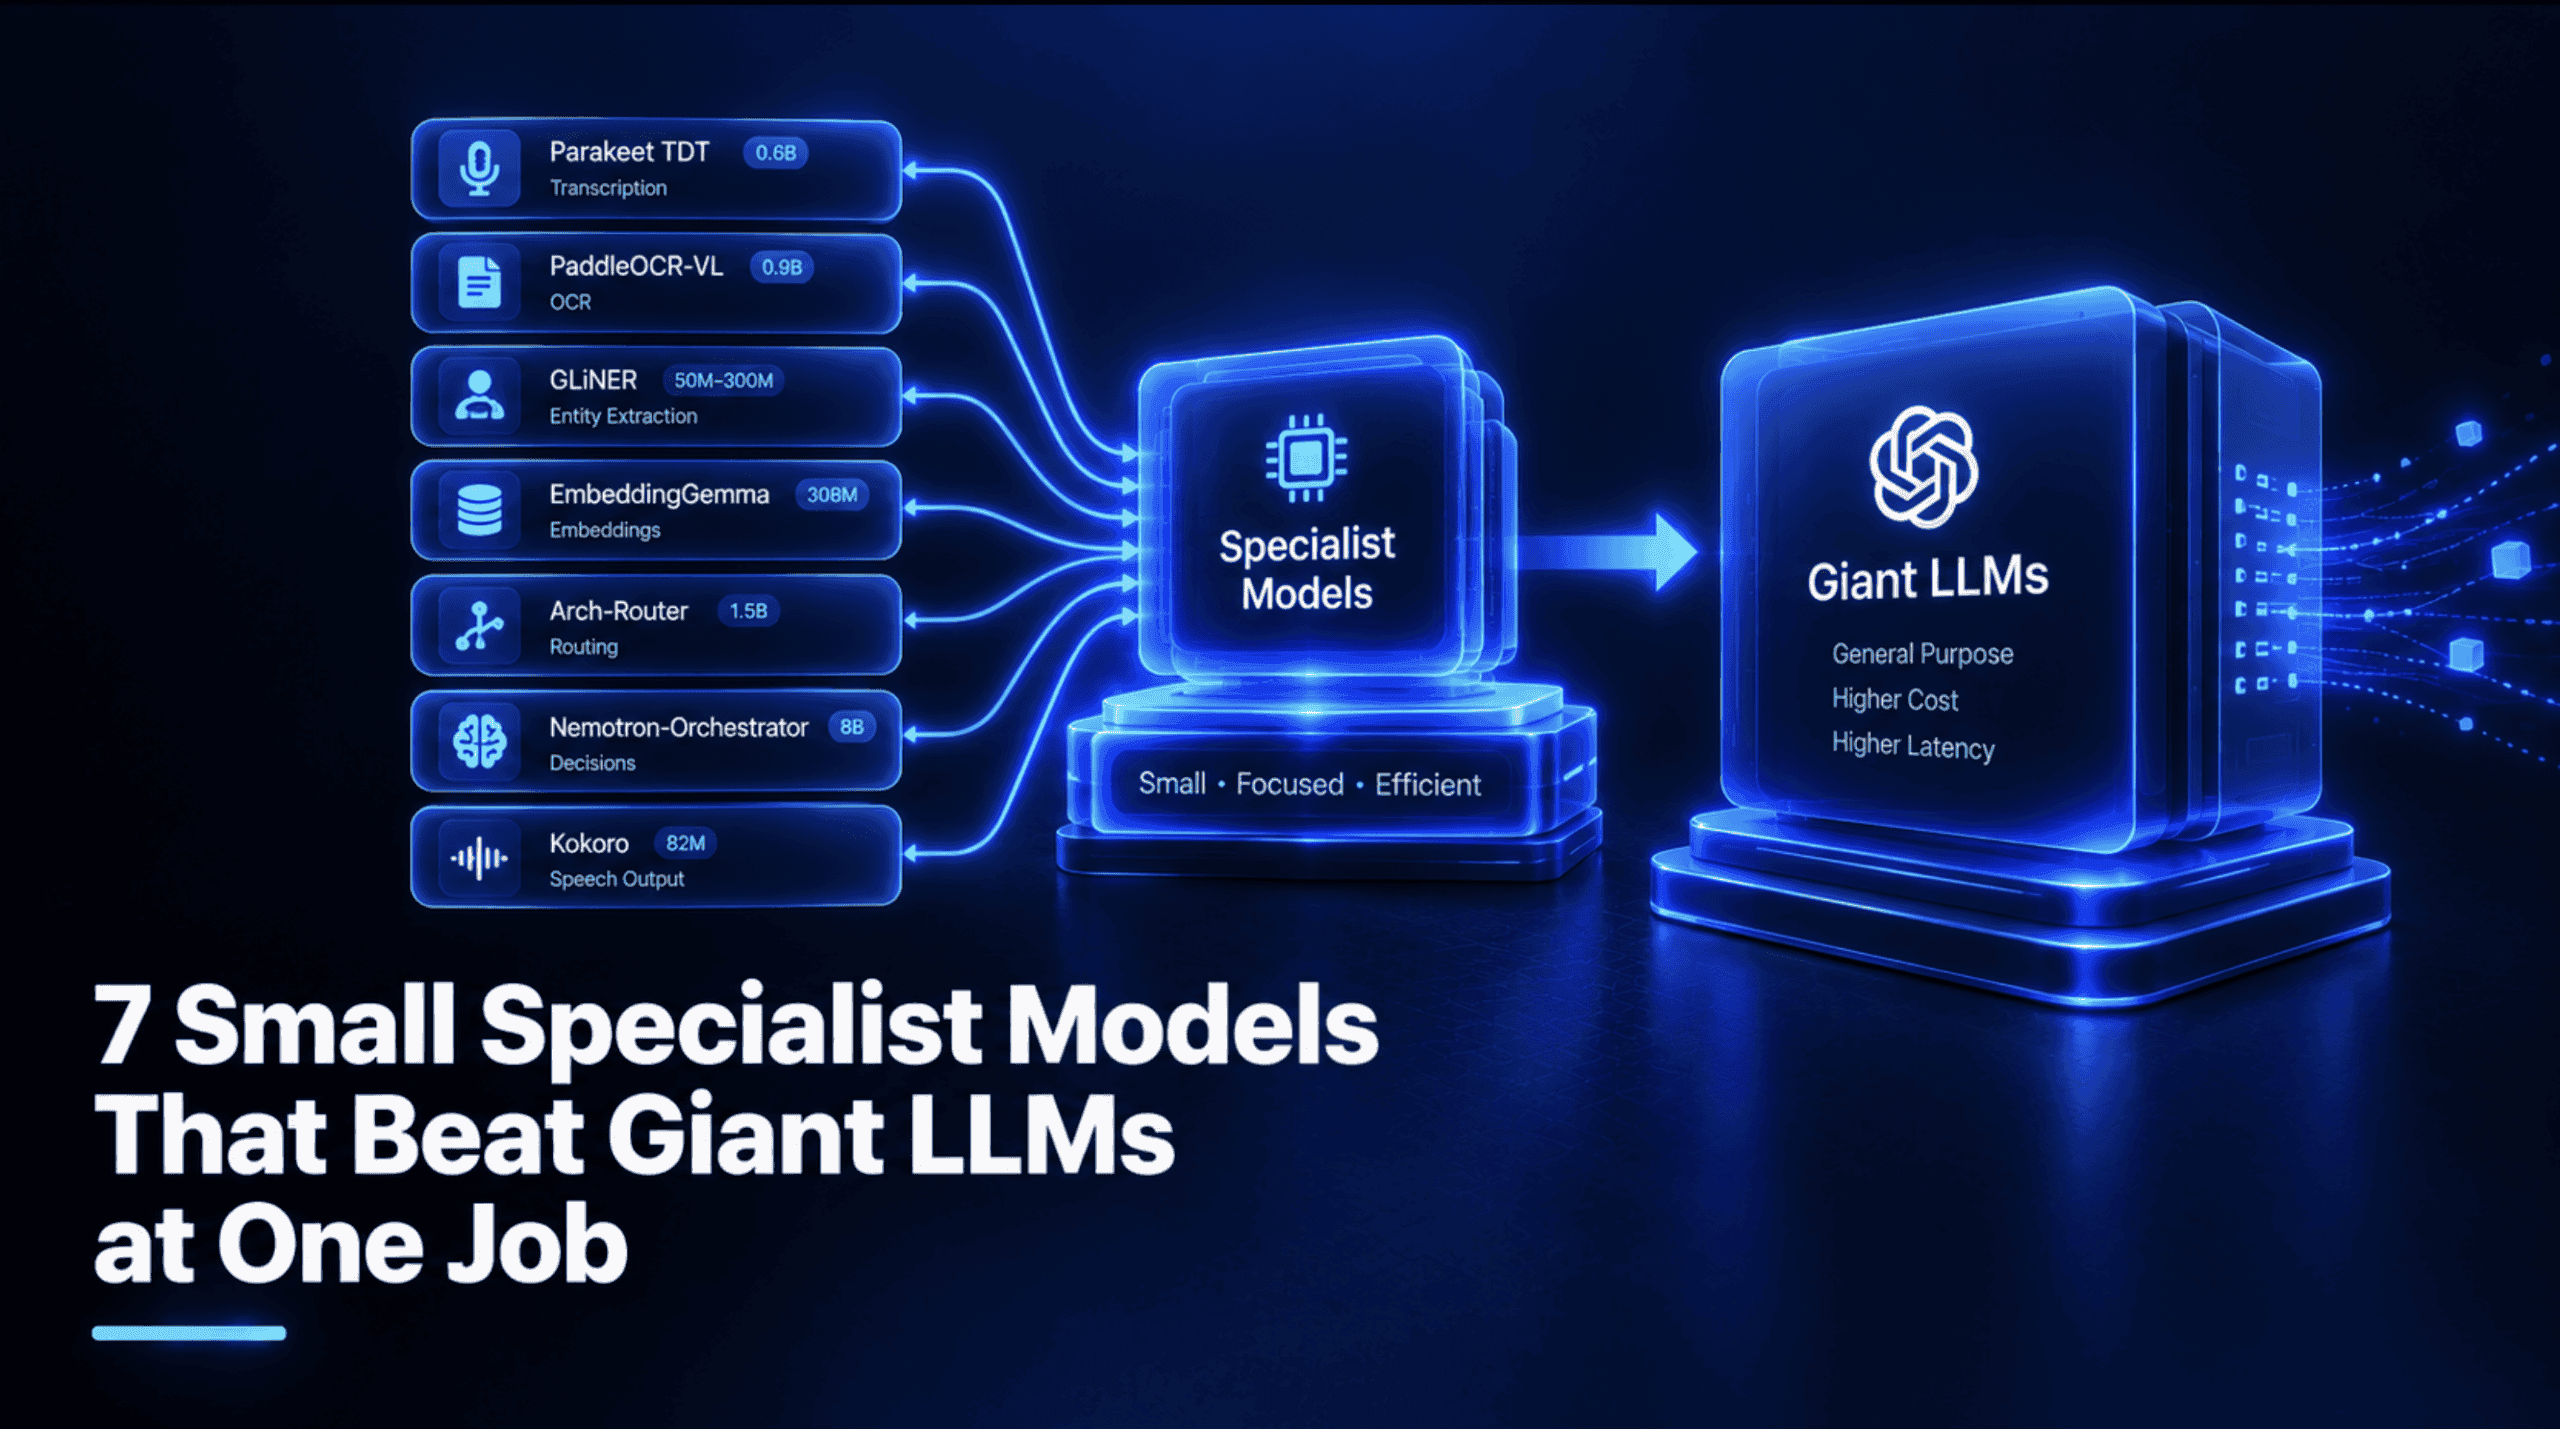
ลองนึกภาพกระบวนการสนับสนุนลูกค้าที่ถูกสร้างขึ้นแบบง่ายๆ โมเดลยักษ์ใหญ่ต้องทำหน้าที่ถอดความการโทร อ่านใบแจ้งหนี้ ดึงชื่อและจำนวนเงิน ตัดสินใจเลือกทีมที่จะรับเรื่อง และตอบกลับลูกค้า แม้ระบบจะทำงานได้จริง แต่ทุกขั้นตอนจะถูกเรียกเก็บเงินในราคาสูงระดับโมเดลเรือธง (frontier model)
ในความเป็นจริง ขั้นตอนส่วนใหญ่เหล่านั้นเป็นงานเฉพาะทางที่โมเดลขนาดเล็กถูกสร้างมาเพื่อทำสิ่งนั้นโดยเฉพาะ บทความนี้จะพาไปรู้จักกับ 7 โมเดลแบบเปิดที่มีพารามิเตอร์ต่ำกว่า 1 หมื่นล้านตัว ซึ่งสามารถประชันหน้ากับระบบที่ใหญ่กว่าในงานเดี่ยวได้อย่างดีเยี่ยม
เราจะวิเคราะห์ทั้งในด้านงานที่โมเดลเหล่านั้นชนะ ขนาด สัญญาอนุญาต หลักฐานประกอบ และโค้ดสำหรับรันในเครื่อง อย่างไรก็ตาม โมเดลเฉพาะงานเหล่านี้ไม่ได้ถูกสร้างมาเพื่อแทนที่ large language model (LLM) ยักษ์ใหญ่ในทุกด้าน ซึ่งเราจะกล่าวถึงข้อจำกัดในช่วงท้าย
วิธีการเลือกทั้ง 7 โมเดลนี้
ทุกโมเดลต้องเป็นไปตามกฎ 4 ข้อ: ต้องเป็น open weights, มีงานที่ชัดเจนเพียงอย่างเดียว, มีหลักฐานตีพิมพ์เปรียบเทียบกับระบบที่ใหญ่กว่า และมีขนาดเล็กพอสำหรับรันบนเครื่องเดียว ทั้งนี้คำว่า "ยักษ์ใหญ่" อาจหมายถึงทั้ง chat LLM, closed API หรือโมเดลเฉพาะทางที่มีขนาดใหญ่กว่า
สรุปข้อมูลเบื้องต้นของทั้ง 7 โมเดล
| # | งาน | โมเดล | ขนาด | สัญญาอนุญาต | สิ่งที่เอาชนะ |
|---|---|---|---|---|---|
| 1 | การถอดความ (Transcription) | Parakeet TDT 0.6B v3 | 0.6B | CC-BY-4.0 | Whisper large-v3 ในด้านความแม่นยำและความเร็ว |
| 2 | การจดจำอักขระด้วยแสง (OCR) | PaddleOCR-VL-1.6 | 0.9B | Apache 2.0 | Gemini 3 Pro และ GPT-5.2 บน OmniDocBench v1.6 |
| 3 | การสกัดเอนทิตี (Entity extraction) | GLiNER | 50M ถึง ~300M | ตรวจสอบตาม checkpoint | ChatGPT ในด้าน zero-shot named entity recognition (NER) |
| 4 | Embeddings | EmbeddingGemma | 308M | ข้อกำหนดของ Gemma | Open embedding models ที่ต่ำกว่า 500M |
| 5 | การหาเส้นทาง (Routing) | Arch-Router | 1.5B | สัญญาอนุญาต Katanemo | GPT-4o และ Claude-Sonnet-3.7 ในการหาเส้นทาง |
| 6 | การตัดสินใจ (Decisions) | Nemotron-Orchestrator-8B | 8B | สัญญาอนุญาต NVIDIA (วิจัยเท่านั้น) | GPT-5 บน Humanity's Last Exam |
| 7 | การส่งออกเสียง (Speech output) | Kokoro-82M | 82M | Apache 2.0 | โมเดล text-to-speech (TTS) แบบเปิดที่ใหญ่กว่าในการทดสอบ |
การตั้งค่า
คุณควรใช้ virtual environment แยกสำหรับแต่ละโมเดล เนื่องจากสแต็กเหล่านี้ระบุเวอร์ชันของ PyTorch และไลบรารีอย่าง NeMo, Paddle และ vLLM แตกต่างกัน ซึ่งอาจทำให้เกิดความขัดแย้งได้หากติดตั้งรวมกัน
# หนึ่งสภาพแวดล้อมต่อหนึ่งโมเดล ตัวอย่างเช่นสำหรับโมเดลแรก
python -m venv parakeet-env
source parakeet-env/bin/activate   # Windows: parakeet-env\Scripts\activate
สำหรับโมเดล EmbeddingGemma ซึ่งเป็นโมเดลที่ถูกจำกัด (gated) คุณต้องยอมรับสัญญาอนุญาตใน หน้าโมเดล และเข้าสู่ระบบผ่าน Hugging Face Hub:
from huggingface_hub import login

login()  # วาง access token ของ Hugging Face เมื่อได้รับการแจ้งเตือน
ส่วน Kokoro จำเป็นต้องมีแพ็กเกจระบบ espeak-ng ติดตั้งอยู่ในเครื่องตามรายละเอียดใน หน้า GitHub
1. Parakeet TDT 0.6B v3: การถอดความ
ขนาดและสัญญาอนุญาต: 600M พารามิเตอร์, สัญญาอนุญาต CC-BY-4.0 รองรับ 25 ภาษาในยุโรปพร้อมระบบตรวจจับภาษาอัตโนมัติ
หลักฐาน: จาก เอกสาร Open ASR Leaderboard พบว่า Parakeet v3 มีอัตราข้อผิดพลาดของคำเฉลี่ย 6.32 ซึ่งต่ำกว่า Whisper large-v3 (7.44) อีกทั้งยังมีอัตราประมวลผล (throughput) สูงกว่าถึง 23 เท่า โดยมีขนาดเพียงหนึ่งในสี่ของ Whisper เท่านั้น
การรันโมเดล:
pip install -U "nemo_toolkit[asr]"import nemo.collections.asr as nemo_asr
# ดาวน์โหลดโมเดลในการรันครั้งแรก; ต้องใช้ RAM อย่างน้อย 2 GB
asr_model = nemo_asr.models.ASRModel.from_pretrained(
model_name="nvidia/parakeet-tdt-0.6b-v3"
)
# ส่งไฟล์เสียงแบบ 16 kHz mono
output = asr_model.transcribe(["meeting.wav"])
print(output[0].text)ข้อควรระวัง: แม้จะแม่นยำและเร็วกว่าในภาษาอังกฤษ แต่ Parakeet ครอบคลุมเพียง 25 ภาษา ในขณะที่ Whisper รองรับถึง 99 ภาษา
2. PaddleOCR-VL-1.6: การจดจำอักขระด้วยแสง
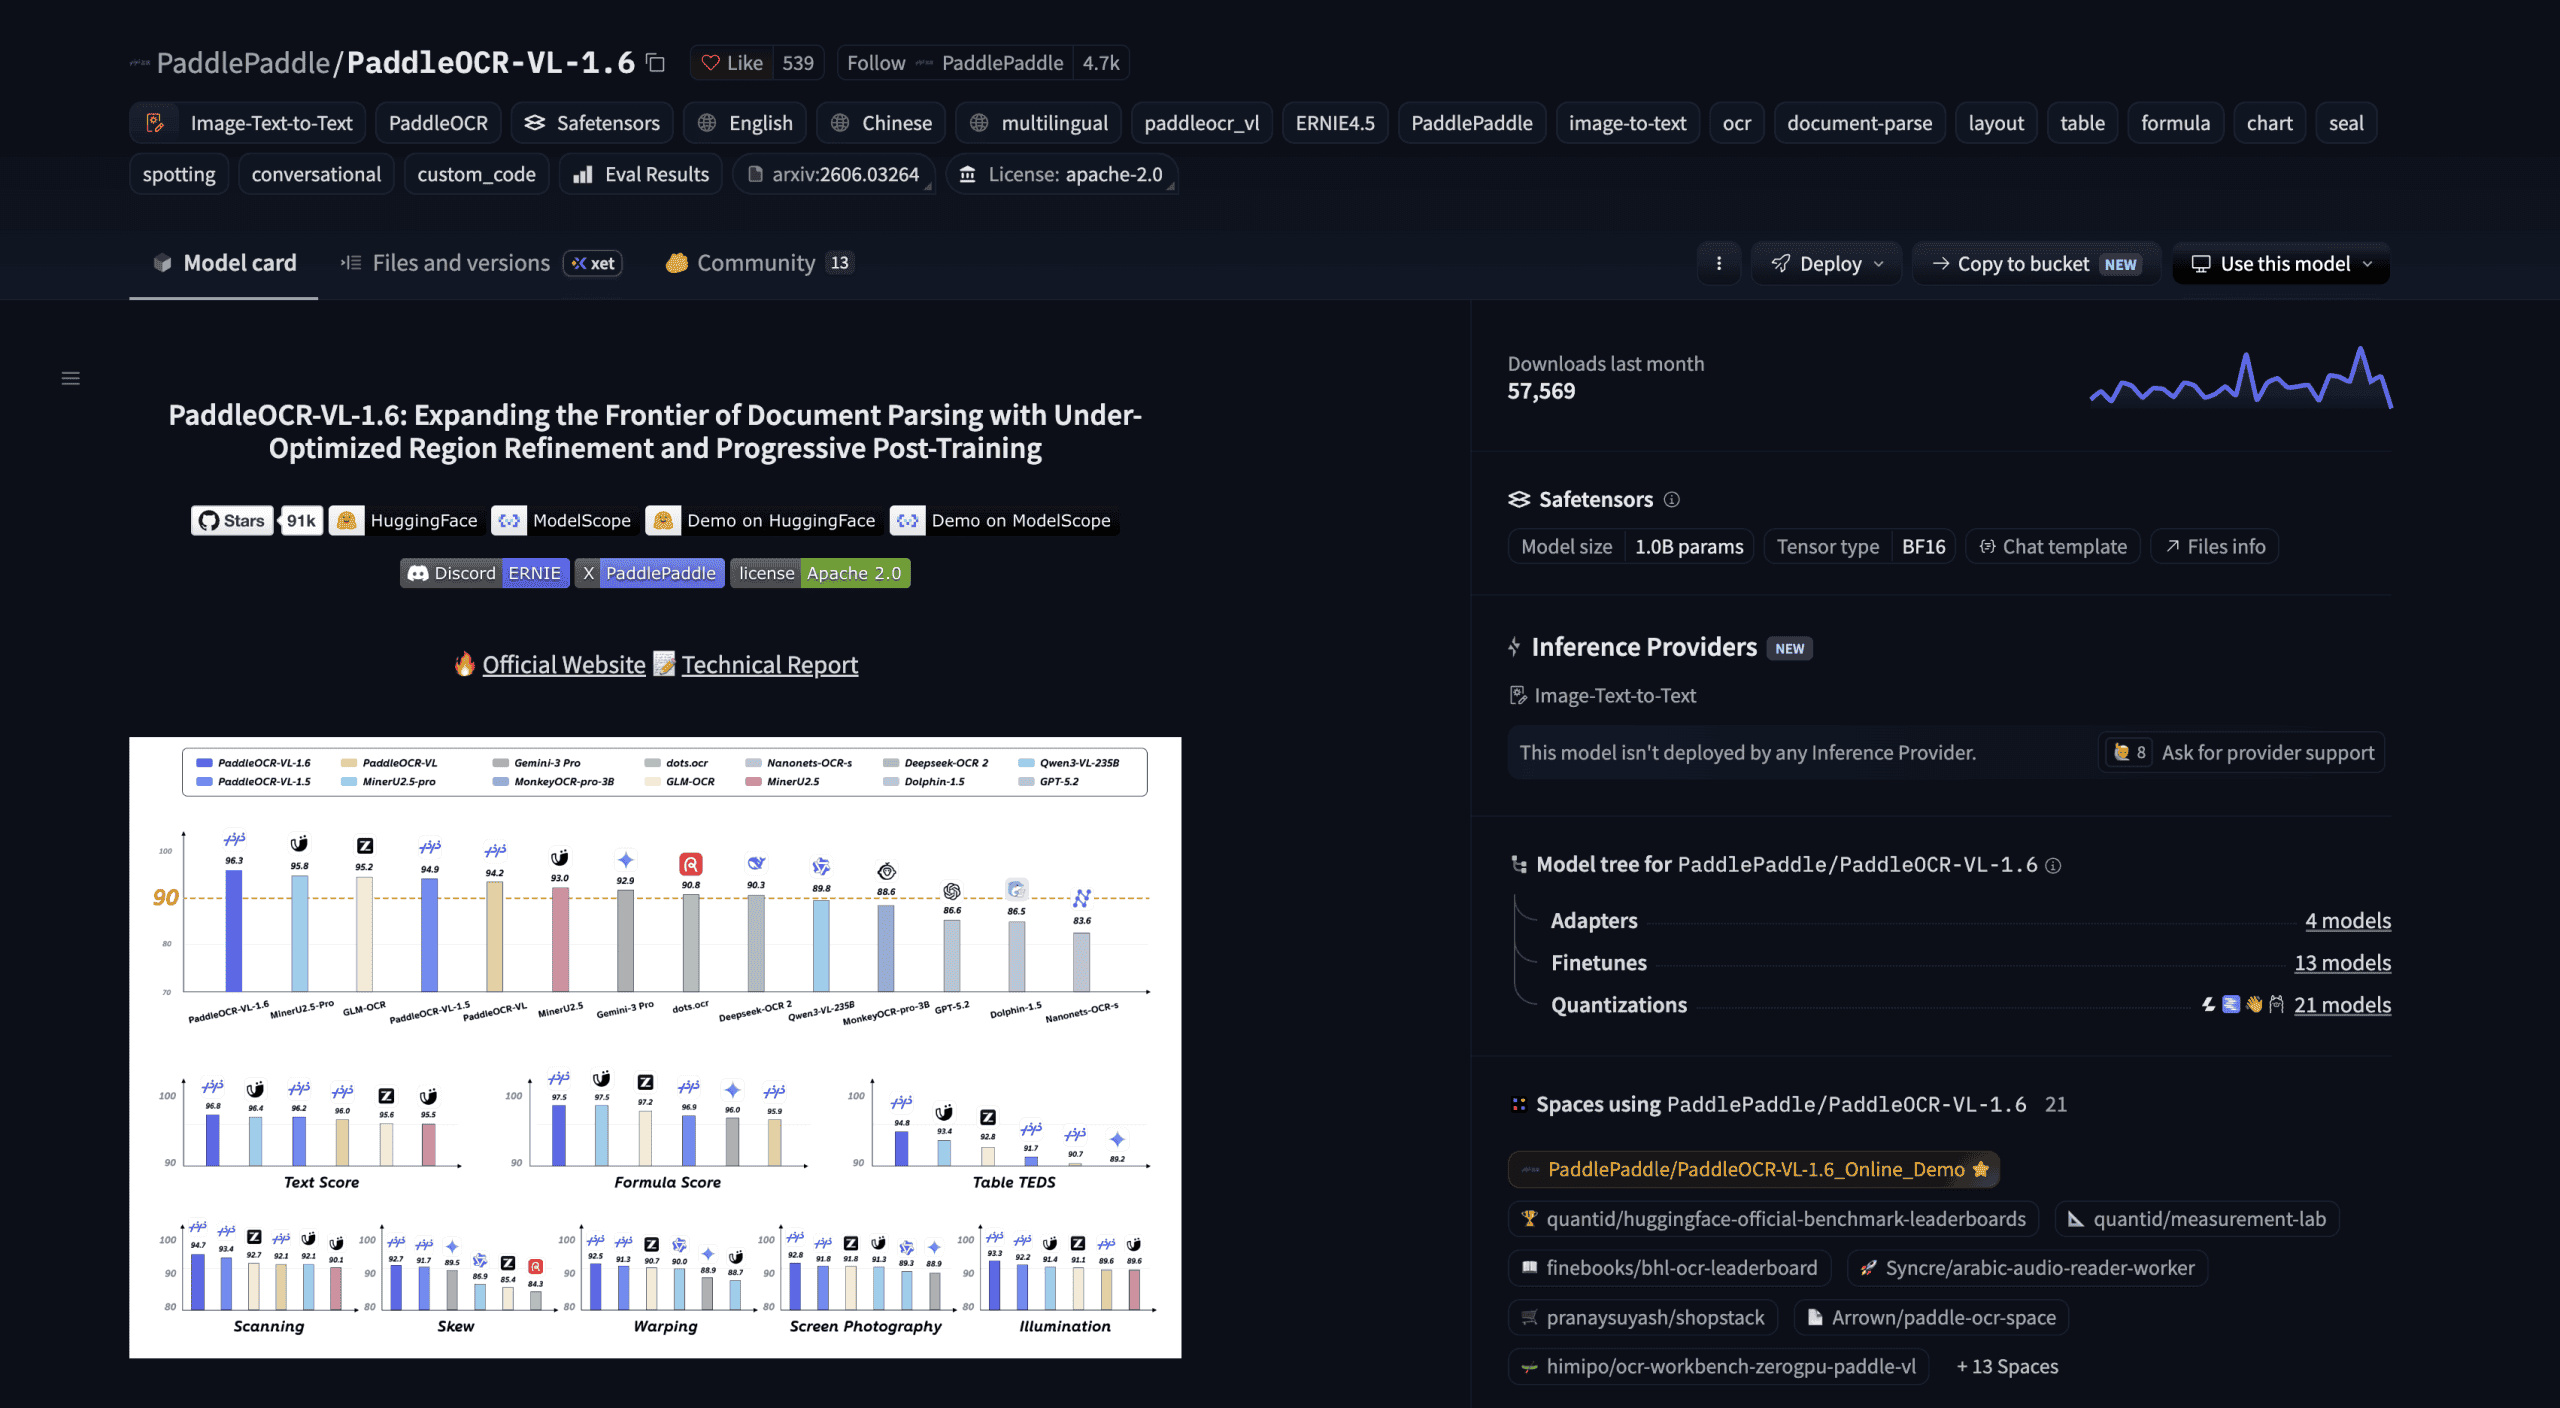
ขนาดและสัญญาอนุญาต: 0.9B พารามิเตอร์ สัญญาอนุญาต Apache 2.0
หลักฐาน: ใน เอกสาร PaddleOCR-VL-1.6 คะแนนรวมบน OmniDocBench v1.6 ของโมเดลนี้อยู่ที่ 96.33 ซึ่งสูงกว่าทั้ง Gemini 3 Pro (92.91) และ GPT-5.2 (86.59) ในด้านการวิเคราะห์เอกสาร
การรันโมเดล:
# ติดตั้งตาม GPU build สำหรับ CUDA 12.6
python -m pip install paddlepaddle-gpu==3.2.1 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
python -m pip install -U "paddleocr[doc-parser]>=3.6.0"
from paddleocr import PaddleOCRVL
pipeline = PaddleOCRVL(pipeline_version="v1.6")
output = pipeline.predict("invoice.png")
for res in output:
res.print()
res.save_to_json(save_path="output")ข้อควรระวัง: ปัจจุบันยังมีโมเดลอย่าง TeleOCR และ OvisOCR2 ที่ทำคะแนนได้สูงกว่าเล็กน้อยในบางการทดสอบ ดังนั้นควรพิจารณาเป็นกลุ่มผู้นำอันดับต้นๆ
3. GLiNER: การสกัดเอนทิตี
ขนาดและสัญญาอนุญาต: เริ่มต้น 50M พารามิเตอร์ สัญญาอนุญาตส่วนใหญ่เป็น Apache-2.0 (โปรดตรวจสอบแต่ละ checkpoint)
หลักฐาน: GLiNER-S (50M) ทำคะแนนเฉลี่ยใน zero-shot NER ได้ 52.7 สูงกว่า ChatGPT ที่ได้ 47.5 และยังมีประสิทธิภาพเหนือกว่า LLM ที่ผ่านการ fine-tuned ในการประเมินบางรายการ
การรันโมเดล:
pip install glinerfrom gliner import GLiNER
model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Sarah Okafor from Brightwave Ltd confirmed invoice INV-20418..."
labels = ["Person", "Company", "Invoice number", "Amount", "Date"]
entities = model.predict_entities(text, labels, threshold=0.5)ข้อควรระวัง: GLiNER ทำหน้าที่สกัดข้อความตามเลเบลที่กำหนดเท่านั้น ไม่สามารถใช้เหตุผลหรือเติมข้อมูลส่วนที่ขาดหายไปได้เหมือน LLM ทั่วไป
4. EmbeddingGemma: Embeddings
ขนาดและสัญญาอนุญาต: 308M พารามิเตอร์ ใช้สัญญาอนุญาต Gemma ของ Google
หลักฐาน: Google ระบุว่านี่เป็นโมเดล text embedding หลายภาษาอันดับสูงสุดในกลุ่มที่ต่ำกว่า 500M บน MTEB และมีขนาดเล็กจนสามารถรันได้ด้วย RAM ไม่ถึง 200 MB เมื่อทำ quantization
การรันโมเดล:
pip install -U sentence-transformersfrom sentence_transformers import SentenceTransformer
model = SentenceTransformer("google/embeddinggemma-300m")
query_embedding = model.encode_query("How do I reset my password?")
document_embeddings = model.encode_document(["To reset your password, open Settings..."])ข้อควรระวัง: รองรับบริบทที่ 2,048 tokens หากมีเอกสารยาวจำเป็นต้องแบ่งส่วน (chunking)
5. Arch-Router: การหาเส้นทาง
ขนาดและสัญญาอนุญาต: 1.5B พารามิเตอร์ ใช้สัญญาอนุญาตวิจัยของ Katanemo
หลักฐาน: มีความแม่นยำในการหาเส้นทาง 93.17% สูงกว่า GPT-4o และ Claude-Sonnet-3.7 โดยเฉลี่ย 7.71% และทำงานได้รวดเร็วมาก (ประมาณ 50 ms)
การรันโมเดล:
# ตัวอย่างการกำหนดเส้นทางในโค้ด
route_config = [
    {"name": "billing", "description": "Questions about invoices, charges, refunds..."},
    {"name": "tech_support", "description": "Troubleshooting errors, bugs..."}
]
# ใช้โมเดลตัดสินใจส่งต่อ Intent ไปยังโมเดลปลายทางที่เหมาะสมข้อควรระวัง: โมเดลนี้ทำหน้าที่แค่ "หาเส้นทาง" เท่านั้น ประสิทธิภาพขึ้นอยู่กับคำอธิบายที่คุณเขียน และคุณยังจำเป็นต้องมีโมเดลอื่นรอรับงานต่อ
6. Nemotron-Orchestrator-8B: การตัดสินใจ
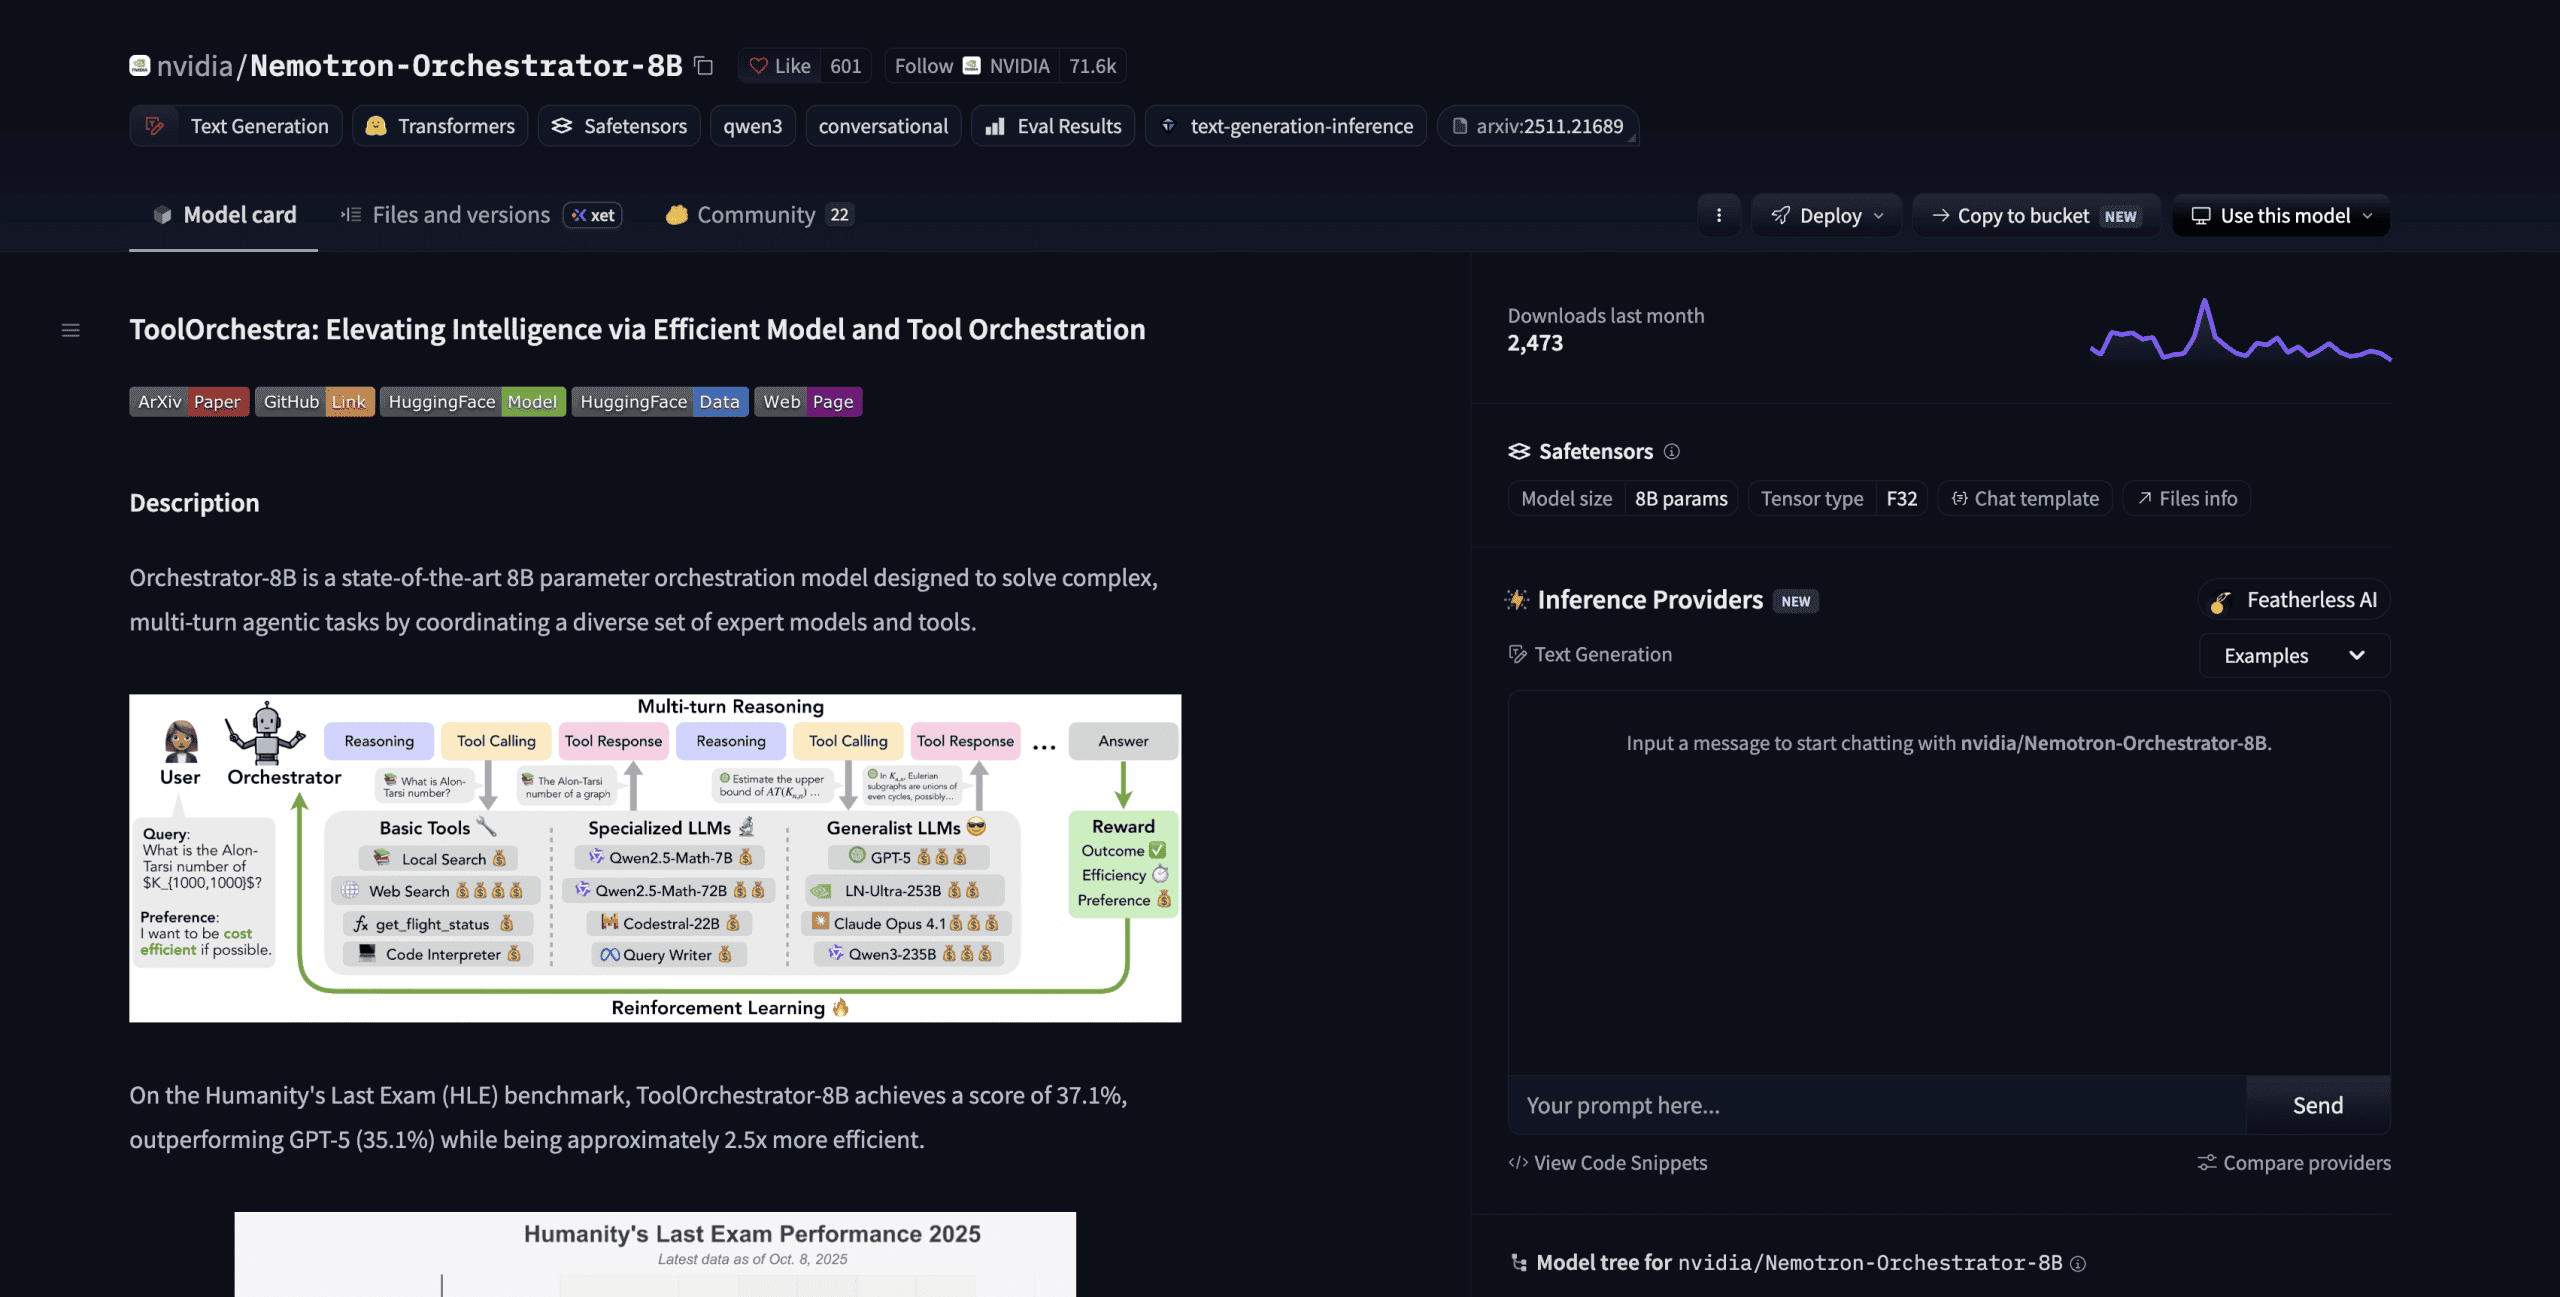
ขนาดและสัญญาอนุญาต: 8B พารามิเตอร์ ใช้สัญญาอนุญาต NVIDIA สำหรับการวิจัยเท่านั้น
หลักฐาน: บนการทดสอบ Humanity's Last Exam โมเดลนี้ทำได้ 37.1% (GPT-5 ได้ 35.1%) โดยมีความเร็วสูงกว่า 2.5 เท่า
ประเด็นสำคัญ: โมเดลนี้ไม่ได้แทนที่โมเดลยักษ์ใหญ่โดยตรง แต่ทำหน้าที่เป็น "ผู้ประสานงาน" ที่ตัดสินใจว่าควรเรียกใช้เครื่องมือใดหรือควรส่งงานต่อให้ LLM ยักษ์ใหญ่ในจังหวะที่จำเป็น
การรันโมเดล:
pip install vllm openai
vllm serve "nvidia/Nemotron-Orchestrator-8B"ข้อควรระวัง: สัญญาอนุญาตยังไม่อนุญาตให้ใช้ในเชิงพาณิชย์ และต้องใช้ GPU ที่มีหน่วยความจำประมาณ 24 GB ในการรัน
7. Kokoro-82M: การส่งออกเสียง
ขนาดและสัญญาอนุญาต: 82M พารามิเตอร์ สัญญาอนุญาต Apache 2.0
หลักฐาน: เคยครองอันดับหนึ่งใน TTS Spaces Arena แซงหน้าโมเดลที่มีขนาดใหญ่กว่ามาก ปัจจุบันยังคงติดอันดับท็อปใน Artificial Analysis Speech Arena
การรันโมเดล:
from kokoro import KPipeline

pipeline = KPipeline(lang_code="a")
for i, (graphemes, phonemes, audio) in enumerate(pipeline(text, voice="af_heart")):
sf.write(f"speech_{i}.wav", audio, 24000)ข้อควรระวัง: โมเดลนี้ไม่มีความสามารถในการจำลองเสียง (voice cloning) และปัจจุบันมีโมเดลใหม่อย่าง Magpie ที่เริ่มทำคะแนนได้สูงกว่า
บทสรุป
โมเดลเฉพาะทางเหล่านี้พิสูจน์ให้เห็นว่าขนาดไม่ใช่ทุกอย่างในงานเฉพาะด้าน การเปลี่ยนมาใช้โมเดลที่เล็กลงในจุดที่เหมาะสม เช่น การถอดความหรือการสกัดข้อมูล จะช่วยลดต้นทุนและเพิ่มความเร็วของระบบได้อย่างมหาศาล โดยเก็บ LLM ยักษ์ใหญ่ไว้ใช้ในงานที่ต้องอาศัยการใช้เหตุผลซับซ้อนเท่านั้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร