
คู่มือประหยัด Token ในระบบ Multi-Agent AI ด้วย 4 กลยุทธ์ลดต้นทุนอย่างมีประสิทธิภาพ
บทนำ
เมื่อมีการเชื่อมต่อ AI agents หลายตัวเข้าด้วยกันเพื่อจัดการเวิร์กโฟลว์ที่ซับซ้อน ปริมาณการใช้ tokens ซึ่งเป็นหน่วยพื้นฐานของข้อความมักจะพุ่งสูงขึ้นอย่างรวดเร็ว ปัจจัยต่างๆ ตั้งแต่บันทึกความจำ (memory logs) ไปจนถึงข้อกำหนดของเครื่องมือ (tool specifications) และคำสั่งระบบ (system instructions) ล้วนสะสมจนนำไปสู่ความล่าช้าในการประมวลผลและงบประมาณที่บานปลาย
การบริหารจัดการ token จึงกลายเป็นทักษะสำคัญสำหรับนักพัฒนา AI ในปัจจุบัน อย่างไรก็ตาม การเพิ่มประสิทธิภาพระบบ multi-agent ไม่จำเป็นต้องแลกมาด้วยค่าใช้จ่ายที่สูงขึ้นเสมอไป หากคุณรู้จักปรับใช้กลยุทธ์ที่เหมาะสม บทความนี้จะนำเสนอ 4 แนวทางปฏิบัติที่จะช่วยให้ระบบของคุณทำงานได้ชาญฉลาดขึ้นในราคาที่ถูกลง
4 กลยุทธ์หลักในการประหยัดการใช้ Token
ต่อไปนี้คือแนวทางปฏิบัติที่ดีที่สุด (best practices) 4 ประการที่นิยมนำมาใช้เพื่อปรับปรุงโซลูชัน multi-agent AI ให้มีประสิทธิภาพสูงสุดควบคู่ไปกับการประหยัดทรัพยากร
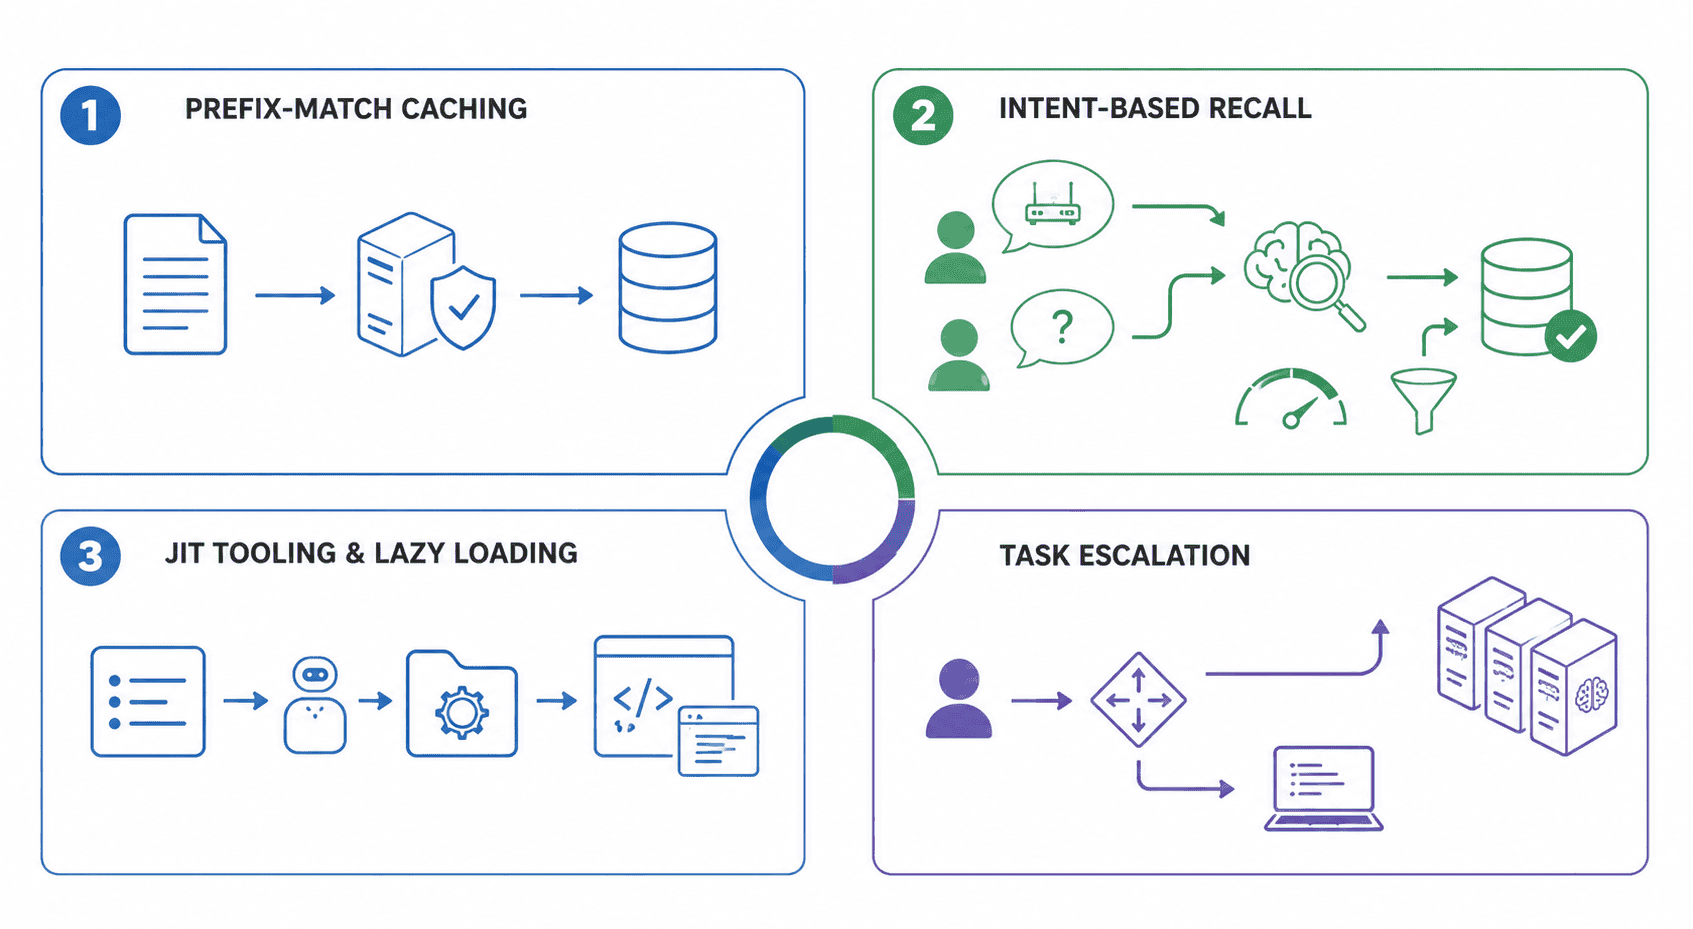
กลยุทธ์สำหรับการประหยัดการใช้ token ในระบบ multi-agent AI
// 1. การใช้ Static Instruction Caching (Prefix-Match Caching)
กลยุทธ์นี้ยึดหลักการ "อย่าพูดซ้ำ" (don't repeat yourself) เนื่องจากโมเดลภาษาขนาดใหญ่ (LLMs) ต้องใช้พลังงานประมวลผลสูงในการอ่านพรอมต์ระบบเดิมซ้ำๆ การใช้ Prefix caching จะช่วยจัดเก็บคำสั่งที่คงที่ (static) ไว้ในรูปแบบคู่คีย์-ค่า (key-value pairs) เพื่อใช้เป็นจุดอ้างอิง แทนที่โมเดลจะต้องอ่านคู่มือการปฏิบัติงานใหม่ทุกครั้ง ระบบจะทำเครื่องหมาย (bookmark) สถานะเดิมไว้ ทำให้เมื่อมีคำถามใหม่เข้ามา โมเดลสามารถข้ามไปประมวลผลส่วนที่เพิ่มขึ้นได้ทันที ช่วยลดทั้งความล่าช้า (latency) และค่าใช้จ่าย token
// 2. การใช้ Semantic Caching: การเรียกคืนข้อมูลตามเจตนา
หาก AI agent เคยตอบคำถามหรือแก้ปัญหาที่คล้ายกันมาแล้ว ก็ไม่จำเป็นต้องสร้างคำตอบใหม่ทั้งหมด กลยุทธ์นี้ใช้ embeddings ซึ่งเป็นการแปลงข้อความเป็นตัวเลขเชิงเวกเตอร์เพื่อระบุ "เจตนา" ที่คล้ายคลึงกันในอดีต ยกตัวอย่างเช่น คำถามว่า "ฉันจะรีเซ็ตเราเตอร์ได้อย่างไร?" กับ "ขั้นตอนการเริ่มทำงานกล่อง wifi ใหม่มีอะไรบ้าง?" ระบบจะจดจำว่าเป็นเจตนาเดียวกันและดึงคำตอบเดิมมาใช้ได้ทันที ช่วยข้ามขั้นตอนการเรียกใช้งาน LLM ไปได้ในบางกรณี
// 3. การใช้ Just-in-Time Tooling
เทคนิคนี้คือการ "โหลดเมื่อจำเป็น" (lazy loading) เพื่อแก้ปัญหาการอัดข้อมูลเครื่องมือและ API ทั้งหมดลงในหน้าต่างบริบท (context window) จนทำให้พรอมต์บวมและสับสน แทนที่จะใส่คู่มืออ้างอิงขนาดใหญ่ลงไปตั้งแต่ต้น เราจะให้เอเจนต์ถือเพียงรายการความสามารถระดับสูงแบบสรุปสั้นๆ เมื่อเอเจนต์ระบุได้ว่าต้องใช้งานเฉพาะทางด้านใด จึงค่อยดึงรายละเอียดคำสั่งและพารามิเตอร์ของเครื่องมือนั้นออกมาใช้งานจริง
// 4. การใช้ Task Escalation: การส่งต่องานไปยังโมเดลที่คุ้มค่า
ไม่ใช่ทุกงานที่ต้องพึ่งพาโมเดลขนาดใหญ่ราคาแพง สถาปัตยกรรมที่มีประสิทธิภาพควรทำหน้าที่เป็นศูนย์คัดกรอง (triage centers) โดยมีเลเยอร์การจัดเส้นทาง (routing layer) เพื่อวิเคราะห์ความซับซ้อนของงาน งานพื้นฐานอย่างการจัดรูปแบบข้อมูลหรือการสรุปสั้นๆ จะถูกส่งไปยังโมเดลน้ำหนักเบาที่อาจใช้งานได้ฟรีหรือรันในเครื่อง (local) ได้ ส่วนโมเดลประสิทธิภาพสูงจะถูกสำรองไว้สำหรับงานที่ต้องใช้การใช้เหตุผลเชิงลึกหรือการประสานงานหลายขั้นตอนเท่านั้น
ตัวอย่างการนำไปใช้โดยสังเขป
ลองมาดูตัวอย่างการรวมกลยุทธ์ semantic caching และ model routing เข้าด้วยกันผ่านโค้ดตัวอย่าง ซึ่งใช้ sentence transformer ในการสร้าง embeddings สำหรับทำแคช และจำลองการเรียกใช้งาน LLMs ผ่านโมเดลน้ำหนักเบาที่สามารถแทนที่ด้วยโมเดลฟรีจากแหล่งอย่าง Groq ตามที่อธิบายไว้ใน บทความนี้
import numpy as np
from sentence_transformers import SentenceTransformer

# Loading a free, local model to convert text into embeddings
embedder = SentenceTransformer('all-MiniLM-L6-v2')

# In-memory semantic cache and similarity threshold (0.90 = 90% similar)
semantic_cache = {}
SIMILARITY_THRESHOLD = 0.90

def cosine_similarity(vec1, vec2):
    """Calculates how closely related two queries are."""
    return np.dot(vec1, vec2) / (np.linalg.norm(vec1) * np.linalg.norm(vec2))

def route_and_respond(user_query):
    # 1. Converting the current query into an embedding vector
    query_vector = embedder.encode(user_query)

# 2. Semantic Caching: Check if a similar problem was solved recently
    for cached_vector, past_response in semantic_cache.values():
        if cosine_similarity(query_vector, cached_vector) >= SIMILARITY_THRESHOLD:
            return f"[Served from Cache] {past_response}"

# 3. Model Routing: Triage the task based on complexity
    # Simple tasks get routed to a free, locally hosted model (e.g. Llama 3 via Ollama)
    # This routing logic is illustrative-only; not be used in production
    if "summarize" in user_query.lower() or len(user_query) < 100:
        response = call_free_local_agent(user_query)
    else:
        # Complex multi-step reasoning escalates to a larger orchestration agent
        response = call_heavy_reasoning_agent(user_query)

# 4. Save the new vector and response to our cache for future users
    semantic_cache[user_query] = (query_vector, response)

return response

# --- Mocking Agent Functions for Illustration: no actual LLMs invoked here ---
def call_free_local_agent(prompt):
    return "Action completed by local, zero-cost model."

def call_heavy_reasoning_agent(prompt):
    return "Action completed by complex orchestration agent."

# Example Usage: mocking the alternate use of different agents/models
# Comment/uncomment to try both examples and try your own

print(route_and_respond("Summarize today's server logs"))
# print(route_and_respond("Draft an optimal one-month itinerary for my upcoming Japan trip. Take into consideration the set of documents, public transport timetables and other documents provided, along with real-time API information"))
ความซับซ้อนของพรอมต์ที่ส่งเข้าไปยังฟังก์ชัน route_and_respond() จะเป็นตัวตัดสินว่าจะเรียกใช้โมเดลประเภทใด โดยผลลัพธ์จะแสดงข้อความยืนยันการทำงานของโมเดลแต่ละระดับตามเงื่อนไขที่กำหนดไว้
สรุป
การปรับใช้อาร์คิเทคเจอร์ multi-agent AI ให้มีประสิทธิภาพสูงสุดจำเป็นต้องคำนึงถึงการบริหารจัดการ token เป็นหัวใจหลัก ทั้ง 4 กลยุทธ์ที่กล่าวมาไม่เพียงช่วยลดต้นทุนการดำเนินงาน แต่ยังเพิ่มประสบการณ์การใช้งานผ่านความเร็วที่เพิ่มขึ้นอีกด้วย การผสานเทคนิคอย่าง semantic caching และ model routing เข้าด้วยกันจึงเป็นทางเลือกที่ชาญฉลาดสำหรับนักพัฒนา AI ยุคใหม่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร