
AgentHands: นวัตกรรมมือเสมือนจริงใน XR สื่อสารผ่านท่าทางแบบอิงพื้นที่จริง
ในขณะที่เอเจนต์ AI กำลังพัฒนาจากอินเทอร์เฟซข้อความไปสู่เพื่อนคู่คิดแบบหลายโหมด (Multimodal) เราเริ่มเห็นการเปลี่ยนแปลงไปสู่การช่วยเหลือเชิงรุกที่สอดคล้องกับสถานการณ์มากขึ้น นวัตกรรมล่าสุดอย่าง Project Astra และ Gemini 3.1 Flash Live ช่วยให้ผู้ใช้สนทนาเกี่ยวกับสภาพแวดล้อมทางกายภาพได้แบบเรียลไทม์ โดยมักใช้การซ้อนทับกรอบสี่เหลี่ยม (Visual Bounding Box) เพื่อระบุวัตถุ แม้การซ้อนทับนี้จะมีประสิทธิภาพบนหน้าจอ 2D แต่การเปลี่ยนผ่านไปสู่แพลตฟอร์มที่สมจริงอย่าง Android XR นำมาซึ่งความท้าทายใหม่ ว่าเราจะก้าวข้าม UI แบบแบนราบเพื่อสร้างบทสนทนาที่มีการตระหนักรู้ด้านพื้นที่อย่างแท้จริงได้อย่างไร เพื่อเชื่อมช่องว่างนี้ เราขอแนะนำ AgentHands ซึ่งตีพิมพ์ในงาน CHI 2026 งานวิจัยต้นแบบนี้นำพลังของท่าทางประกอบการพูดมาสู่โลก 3D โดยเลียนแบบธรรมชาติของมนุษย์ที่ใช้มือสื่อสารมากกว่าแค่การชี้ แต่ยังรวมถึงการบอกรูปทรง เลียนแบบการกระทำ และเน้นย้ำประเด็นต่างๆ ให้สอดประสานกับเสียง การใช้ประโยชน์จากความสามารถเชิงพื้นที่ของ Extended Reality (XR) ทำให้ AgentHands สามารถจำลองการทำงานร่วมกันนี้ขึ้นมาได้
จากการวิจัยต่อยอดจาก Human I/O และ Sensible Agent ทาง AgentHands ได้เพิ่มขีดความสามารถให้เอเจนต์ AI ด้วยท่าทางมือที่แสดงออกอย่างสอดคล้อง เปลี่ยนคำแนะนำทางวาจาที่เป็นนามธรรมให้เป็นการสาธิตทางกายภาพที่เข้าใจง่าย ช่วยให้การสนทนาเกี่ยวกับสภาพแวดล้อมรอบตัวดูเป็นธรรมชาติและน่าดึงดูดยิ่งขึ้น
[
](https://storage.googleapis.com/gweb-research2023-media/media/AgentHands1_Demo.mp4)
วิดีโอสาธิต AgentHands: เพิ่มพลังให้เอเจนต์ AI ด้วยท่าทางมือที่แสดงออกและสอดประสานกันสำหรับการสนทนาที่อิงตามพื้นที่ใน XR
อนุกรมวิธานสำหรับเอเจนต์มือที่มีตัวตนใน XR
เราได้ทำการศึกษาขั้นต้นร่วมกับผู้เชี่ยวชาญด้าน XR และ human–computer interaction (HCI) ที่ Google เพื่อกำหนดคุณสมบัติที่ทำให้มือเสมือนจริง “อ่านออก” ในสภาพแวดล้อม 3D ข้อมูลเหล่านี้ถูกสรุปเป็นอนุกรมวิธานหลายมิติที่ระบุว่าเอเจนต์ควรใช้มืออย่างไรเพื่อให้การสนทนาเชื่อมโยงกับพื้นที่ทางกายภาพของผู้ใช้ ดังนี้:
- ความถนัดของมือและท่าทาง (Handedness & gesture): การเลือกระหว่างการใช้มือเดียวหรือสองมือ รวมถึงการเลือกรูปแบบท่าทาง เช่น "แบฝ่ามือ" เพื่อเตือนให้ระวัง หรือ "การกำแบบทรงกระบอก" เพื่อเลียนแบบการถือเครื่องมือ
- มิติด้านพื้นที่ (Spatiality): การใช้ความลึกของ XR กำหนดจุดวางมือ เช่น ลอยกลางอากาศสำหรับการสนทนาทั่วไป, ยึดติดกับวัตถุ (Object-anchored) เพื่อระบุจุดเฉพาะ หรืออ้างอิงกับตัวผู้ใช้ (User-relative) เพื่อส่งสัญญาณทางสังคม
- พลวัตทางเวลาและเอฟเฟกต์ภาพ (VFX): ท่าทางใน XR ไม่ใช่แค่การโพสท่าค้างไว้ แต่รวมถึงการเคลื่อนไหวแบบแอนิเมชัน เช่น "การเท" นอกจากนี้ยังใช้เอฟเฟกต์ภาพที่เป็นเอกลักษณ์ของ XR เช่น แสงสีแดงเรืองแสงเพื่อระบุคำเตือนเกี่ยวกับความร้อน
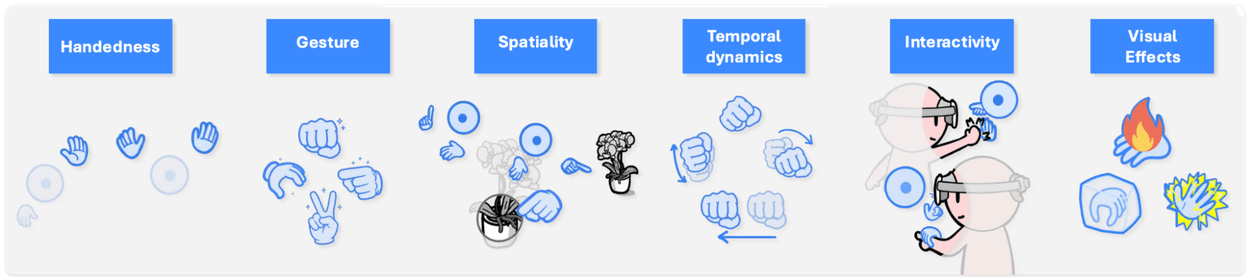
แผนภาพอนุกรมวิธานของ AgentHands แสดงให้เห็น 6 มิติ: ความถนัดของมือ, ท่าทาง, มิติด้านพื้นที่, พลวัตทางเวลา, การโต้ตอบ และเอฟเฟกต์ภาพ
เวิร์กโฟลว์ของ AgentHands
นวัตกรรมหลักของ AgentHands คือความสามารถในการแปลงการให้เหตุผลระดับสูงของ LLM ไปสู่การเคลื่อนไหวทางกายภาพที่แม่นยำแบบเรียลไทม์ ซึ่งสอดคล้องกับเสียงของเอเจนต์และสภาพแวดล้อมของผู้ใช้ โดยมีขั้นตอนสำคัญดังนี้:
การตระหนักรู้ต่อสภาพแวดล้อม (Environment awareness)
ระบบเริ่มต้นด้วยโมดูลจดจำวัตถุที่มีน้ำหนักเบา โดยใช้การจ้องมอง (Eye gaze) และการสร้างฉากใหม่ (Scene reconstruction) ผู้ใช้สามารถ "ติดแท็ก" ไอเท็มต่างๆ เช่น ต้นไม้หรือแล็ปท็อป เพื่อสร้างทะเบียนข้อมูลเชิงพื้นที่ด้วยกรอบ 3D Bounding Boxes ให้เอเจนต์นำไปอ้างอิงได้
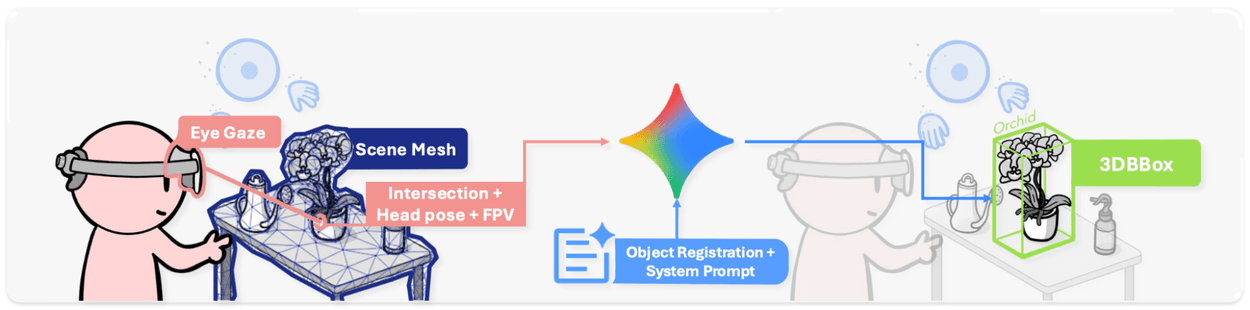
AgentHands ใช้การจ้องมองและการทำความเข้าใจฉากเพื่อจดทะเบียนวัตถุทางกายภาพลงในทะเบียน 3D
คลังเหตุการณ์ท่าทางมือ (Hand gesture event library)
เราสร้างคลังพฤติกรรมท่าทางมือใน 3 หมวดหมู่ ได้แก่ ก) Deictic สำหรับการอ้างอิงหรือชี้ ข) Iconic สำหรับการพรรณนาการกระทำหรือรูปทรง และ ค) Expression สำหรับการสื่อสัญญาณทางสังคมและอารมณ์
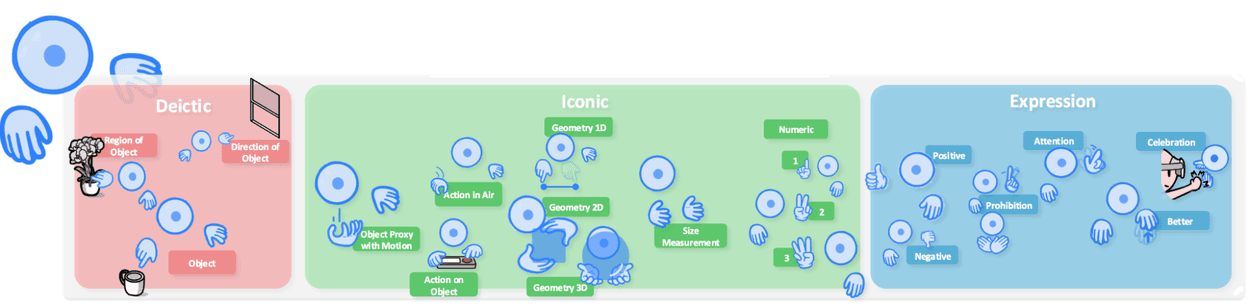
การให้เหตุผลที่ฝังท่าทางและการประมวลผล
เมื่อผู้ใช้ถามคำถาม LLM จะสร้างคำตอบที่มี GestureEvents แทรกอยู่ตามคำสั่งกระตุ้น (Trigger words) ที่เฉพาะเจาะจง จากนั้นตัวแยกส่วนคำสั่งบนชุดหูฟัง XR จะประสานงานการเล่นเสียง text-to-speech (TTS) ร่วมกับเอนจินแอนิเมชัน โดยใช้การประทับเวลาในระดับคำเพื่อให้ท่าทางมือสอดประสานกับคำพูดอย่างสมบูรณ์แบบ
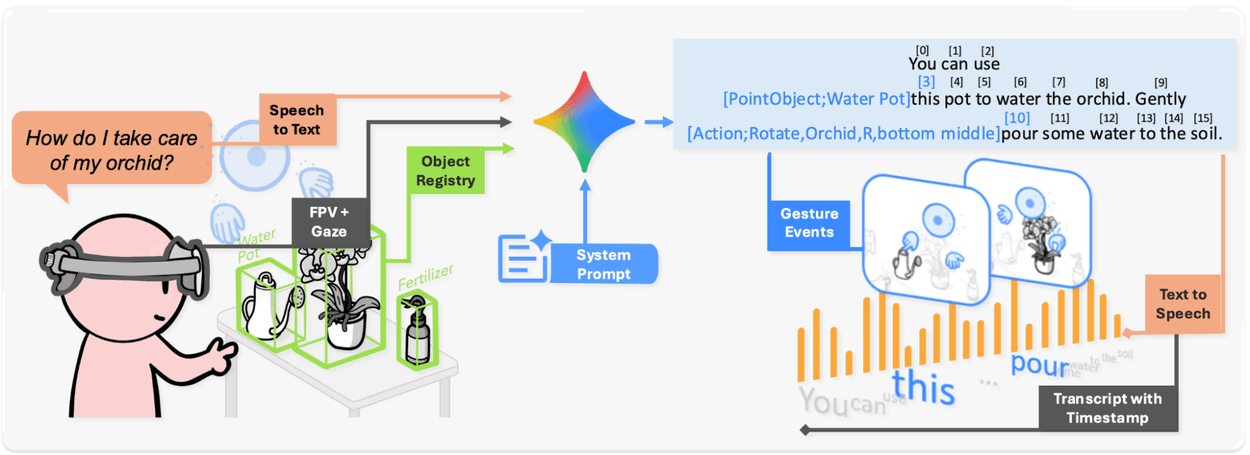
เวิร์กโฟลว์ของระบบ AgentHands ฉบับสมบูรณ์ แสดงให้เห็นลำดับตั้งแต่เสียงของผู้ใช้ไปจนถึงการเรนเดอร์ XR แบบซิงโครไนซ์
สถานการณ์การใช้งาน
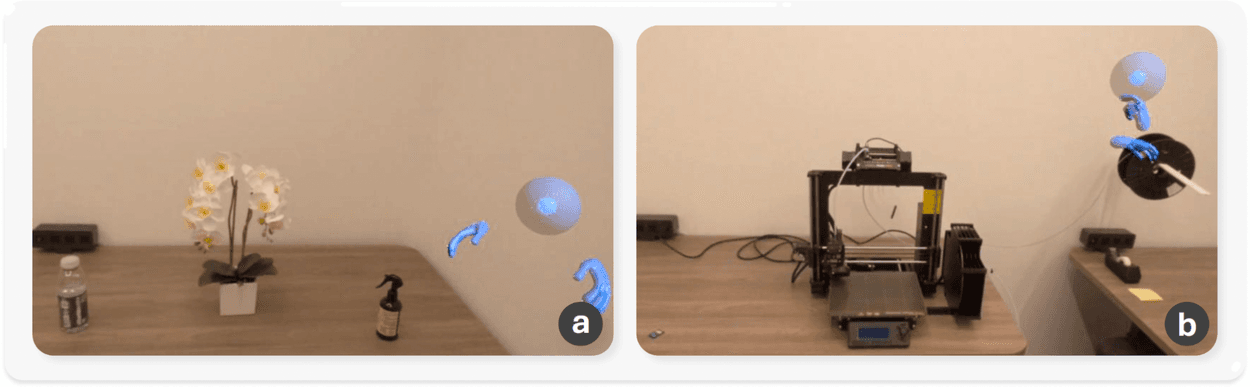
- การติวแบบโต้ตอบ (Interactive tutoring): ในการดูแลกล้วยไม้ เอเจนต์จะเคลื่อนมือไปที่ฐานต้นไม้และวาดเส้นล้อมรอบรากอากาศในขณะที่อธิบายหน้าที่ของมัน
[
- การสาธิตทางเทคนิค (Technical walkthroughs): สำหรับเครื่องพิมพ์ 3D เอเจนต์สามารถสาธิตขั้นตอน "หมุนและคลิก" ที่แน่นอนสำหรับการควบคุมปุ่มหมุน ทำให้ขั้นตอนที่ซับซ้อนเข้าใจง่ายขึ้น
[
](https://storage.googleapis.com/gweb-research2023-media/media/AgentHands_Application_TechPrint.mp4)
- เพื่อนคู่คิดด้านไลฟ์สไตล์ (Lifestyle companionship): เอเจนต์สามารถทำหน้าที่เป็นโค้ชสุขภาพ เช่น แสดงท่าทาง "เตือน" โดยการจับมือผู้ใช้พร้อมเอฟเฟกต์ภาพเพื่อเตือนถึงพฤติกรรมที่ไม่ดีต่อสุขภาพ
[
การศึกษาในผู้ใช้และผลลัพธ์
เราทำการศึกษากับกลุ่มตัวอย่าง (N = 12) โดยเปรียบเทียบ AgentHands กับระบบที่มีแต่เสียง พบว่าผู้เข้าร่วมสามารถระบุตำแหน่งวัตถุและทิศทางได้ง่ายขึ้นอย่างมีนัยสำคัญ (p < 0.05) อีกทั้งยังช่วยให้เข้าใจการกระทำที่ซับซ้อนและสังเกตเห็นคำเตือนความปลอดภัยได้ดีขึ้นผ่านสัญญาณภาพและท่าทางที่เด่นชัด
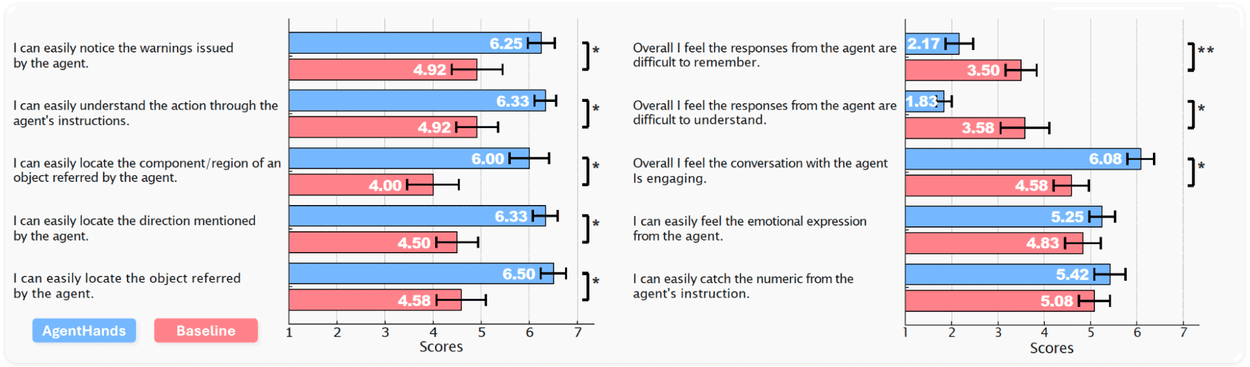
ผลลัพธ์ทางสถิติแสดงให้เห็นว่า AgentHands มีประสิทธิภาพเหนือกว่าเกณฑ์มาตรฐานในทุกมิติสำคัญ
บทสรุปและทิศทางในอนาคต
AgentHands เป็นก้าวสำคัญสู่โลกที่ AI ไม่เพียงแต่วิเคราะห์ข้อมูล แต่ยังทำงานร่วมกับมนุษย์ภายในโลกทางกายภาพได้อย่างกระฉับกระเฉง ช่วยลดภาระทางพุทธิปัญญาและทำให้การประมวลผลเชิงพื้นที่ (Spatial Computing) เข้าถึงได้ง่ายขึ้น ในอนาคตเรากำลังพัฒนาให้ท่าทางเหล่านี้มีความเป็นส่วนตัวมากขึ้นเพื่อสร้างการทำงานร่วมกันที่ไร้รอยต่อยิ่งกว่าเดิม
กิตติกรรมประกาศ
งานวิจัยนี้ดำเนินการโดย Ziyi Liu ในช่วงที่เป็น Student Researcher ที่ Google ภายใต้ความร่วมมือของหลายทีมงาน โดยได้รับการสนับสนุนจาก David Li, Zhongyi Zhou, David Kim และคำแนะนำจาก Adarsh Kowdle, Guru Somadder และ Shahram Izadi
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร