
Agile Deliberation: เฟรมเวิร์กใหม่ช่วย AI นิยามพื้นที่สีเทา
โมเดล Machine learning ทั่วไปเรียนรู้จดจำโลกผ่านตัวอย่างที่ติดป้ายกำกับ (labeled) โดยมนุษย์ ภายใต้สมมติฐานที่ว่านิยามของหมวดหมู่นั้นชัดเจนและคงที่ ซึ่งใช้ได้ดีกับวัตถุที่มีความเป็นวัตถุวิสัย เช่น ป้ายหยุด หรือสุนัขพันธุ์โกลเด้นรีทรีฟเวอร์
อย่างไรก็ตาม ในโลกความเป็นจริงมักต้องการระบบการมองเห็นที่นำทางใน "พื้นที่สีเทา" อันเป็นอัตวิสัย เช่น การนิยาม "อาหารเพื่อสุขภาพ" หรือ "งานศิลปะที่สร้างแรงบันดาลใจ" ซึ่งขอบเขตเหล่านี้เปลี่ยนไปตามบริบทวัฒนธรรมและปรัชญาส่วนบุคคล ผู้คนมักไม่ได้มีข้อกำหนดที่สมบูรณ์ในใจแต่แรก แต่จะค้นพบข้อยกเว้นและรายละเอียดเมื่อพบตัวอย่างจริง เวิร์กโฟลว์แบบดั้งเดิมไม่ได้คำนึงถึง concept evolution นี้ ทำให้ผู้ใช้ถูกบีบให้ต้องระบุป้ายกำกับที่ตายตัวแม้โมเดลทางความคิดจะยังเปลี่ยนแปลงอยู่ เพื่อลดช่องว่างนี้ นักวิจัยจึงแนะนำ Agile Deliberation เฟรมเวิร์กที่มองการสร้างตัวจำแนกประเภท AI เป็นการสนทนาที่ทำซ้ำได้ ระบบจะเปลี่ยนจากผู้รับป้ายกำกับเป็นพันธมิตรที่ช่วยผู้ใช้ "ใคร่ครวญ" (deliberate) และขัดเกลานิยามให้ชัดเจนขึ้น โดยมีการเปิดซอร์สโค้ดบน GitHub เพื่อสนับสนุนชุมชนวิจัย
จุดเด่นของงานนี้คือการมุ่งเน้นประสบการณ์ผู้ใช้จริงผ่านเซสชันทดสอบ 18 ครั้ง ครั้งละ 1.5 ชั่วโมง เพื่อสังเกตการพัฒนาเจตนาของมนุษย์เมื่อทำงานร่วมกับระบบอัจฉริยะ ผลการศึกษาพบว่าช่วยลดความเหนื่อยล้าและความกังวลได้มาก เนื่องจากการให้ข้อเสนอแนะต่อภาพที่เป็นจุดก้ำกึ่งแทนที่การทำ prompt engineering ด้วยตนเอง ส่งผลให้ได้โมเดล AI ที่สอดคล้องและมีประสิทธิภาพสูงกว่าเดิม
วิธีการทำงาน: การใคร่ครวญสองขั้นตอน
Agile Deliberation แบ่งงานที่ซับซ้อนออกเป็นสองขั้นตอนคือ การกำหนดขอบเขตแนวคิด (concept scoping) และ การทำซ้ำแนวคิด (concept iteration) เพื่อเปลี่ยนไอเดียที่คลุมเครือให้เป็นพิมพ์เขียวที่แม่นยำ
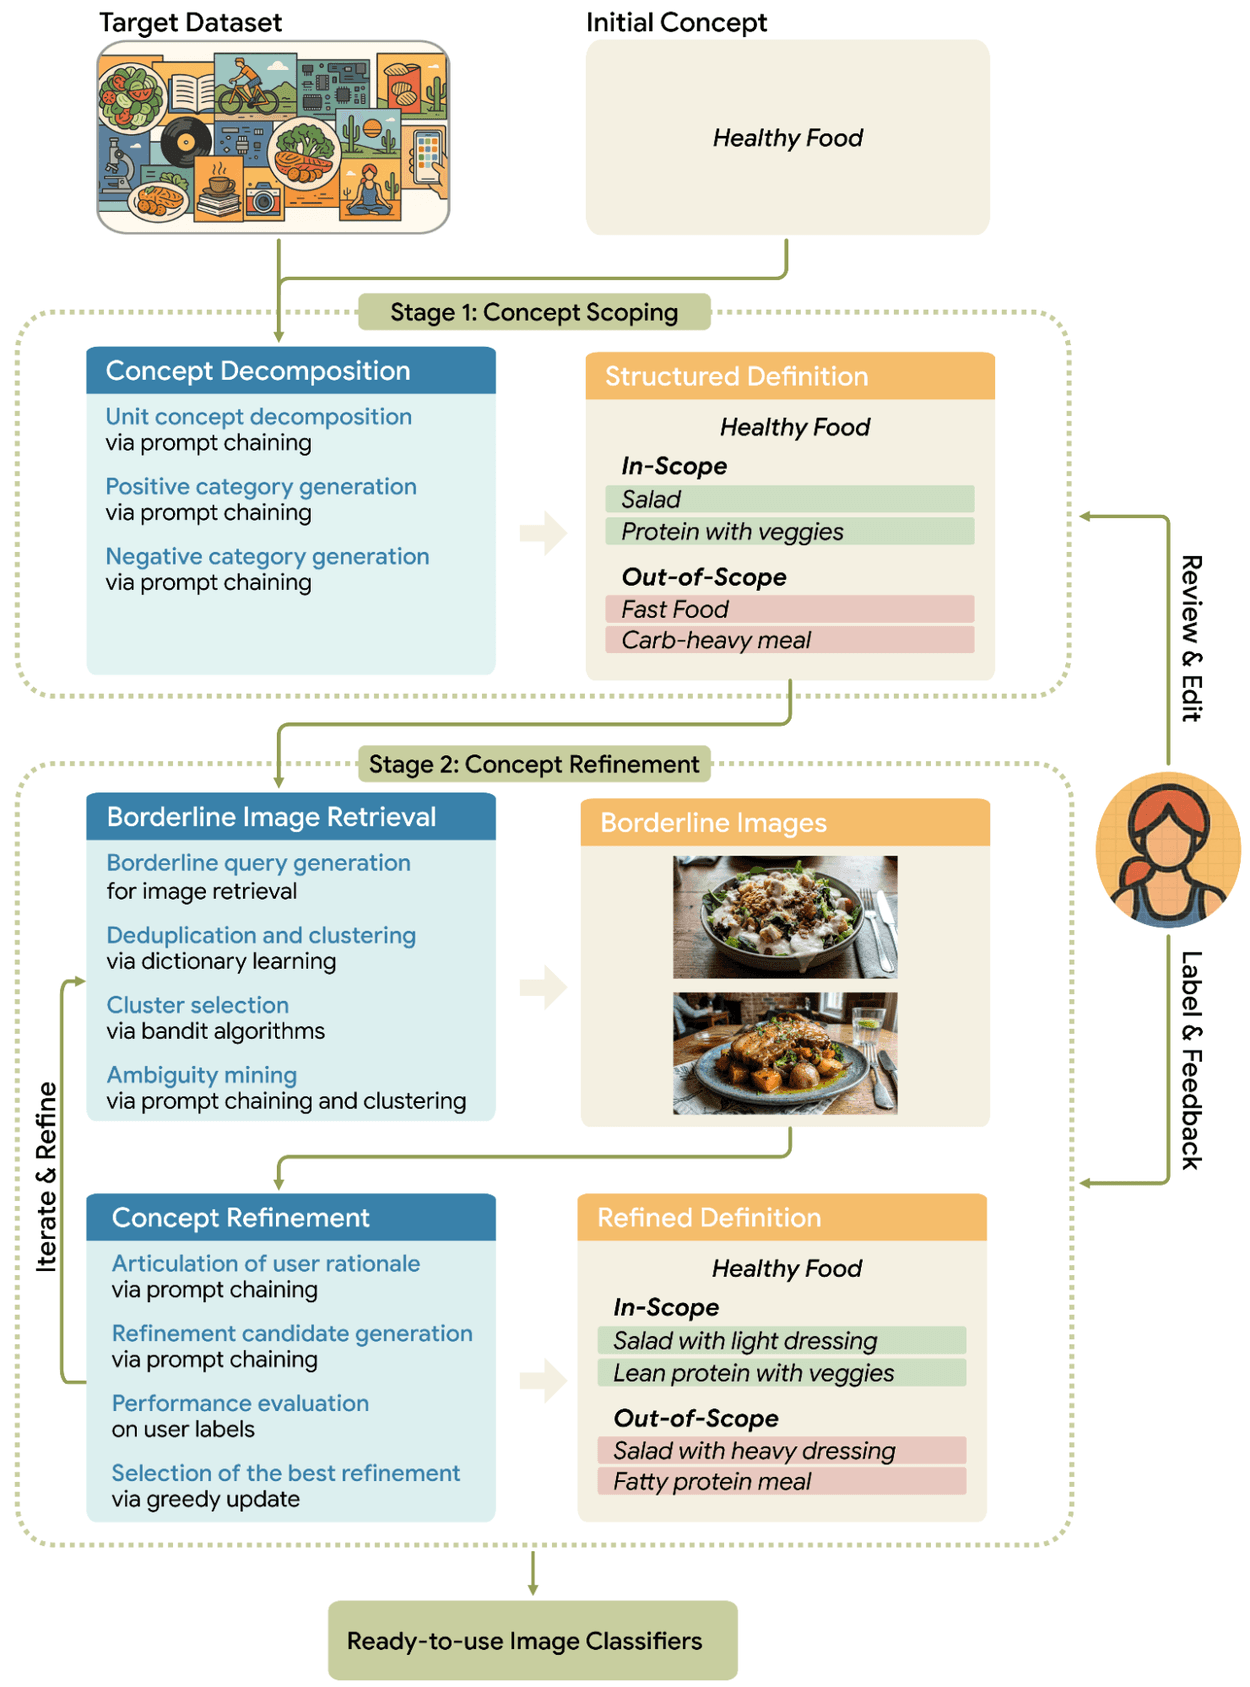
เวิร์กโฟลว์ของ Agile Deliberation จะแยกย่อยแนวคิดหลักออกเป็นนิยามที่อยู่ในขอบเขตและนอกขอบเขต พร้อมดึงภาพก้ำกึ่งออกมาเพื่อแสดงกรณีตัวอย่างที่รุนแรง (edge cases) และนำทางข้อเสนอแนะเข้าสู่ลูปการขัดเกลาพรอมต์อัตโนมัติ
ขั้นตอนที่ 1: การกำหนดขอบเขตแนวคิด
เมื่อต้องเผชิญกับหัวข้อกว้างๆ เช่น "อาหารเพื่อสุขภาพ" ระบบจะนำทางผู้ใช้ให้แยกย่อยแนวคิดหลักออกเป็นลำดับชั้นของแนวคิดย่อยและข้อยกเว้น เช่น การแยกหมวดหมู่ย่อยเป็น "สลัด" หรือ "โปรตีนไม่ติดมัน" พร้อมกำหนดข้อยกเว้นอย่าง "อาหารแปรรูป" เพื่อสร้างพื้นฐานความเข้าใจเริ่มต้นให้โมเดล
ขั้นตอนที่ 2: การทำซ้ำแนวคิด
ขั้นตอนนี้เปลี่ยนจากการวางแผนสู่การทดสอบเชิงรุก โดยใช้ vision-language models (VLMs) เพื่อขุดค้นภาพที่มีความก้ำกึ่งทางความหมาย (semantically borderline) มาท้าทายต่อนิยามปัจจุบัน
ตัวอย่างเช่น ระบบอาจแสดงภาพสมูทตี้ผลไม้เพื่อบีบให้ผู้ใช้ตัดสินใจว่าจัดเป็นอาหารเพื่อสุขภาพหรืออาหารแปรรูปเนื่องจากมีน้ำตาลสูง การเผชิญกับกรณีที่คลุมเครือจะกระตุ้นให้ผู้ใช้ชี้แจงเจตนาที่แท้จริงและอัปเดตกฎนโยบาย ซึ่งข้อเสนอแนะจะถูกส่งไปยังลูปเพิ่มประสิทธิภาพพรอมต์โดยอัตโนมัติเพื่อให้ VLM ปรับขอบเขตตามผู้ใช้
การทดลองและผลลัพธ์
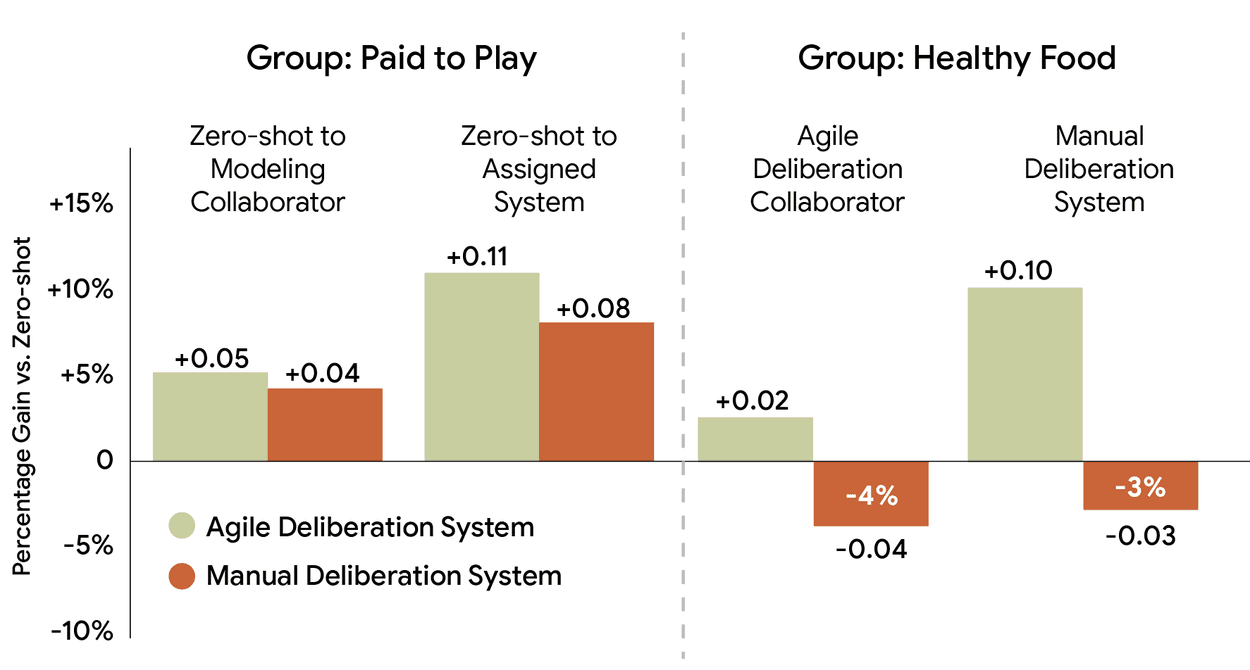
การประเมินเน้นการศึกษาผ่านผู้ใช้จริงในโดเมนที่มีความเป็นอัตวิสัยสูงอย่าง "อาหารเพื่อสุขภาพ" และ "Pay-to-Play" (การตรวจสอบเนื้อหาคลิกเบตหรือเกมที่มีเงื่อนไขการเงินแฝง) โดยเปรียบเทียบกับ Zero-shot classifiers, Modeling collaborator และการทำ Manual deliberation
ผลลัพธ์แสดงให้เห็นว่าผู้ใช้มีความสอดคล้องในการติดป้ายกำกับสูงขึ้นและสร้างตัวจำแนกประเภทที่มีประสิทธิภาพเหนือกว่าเกณฑ์มาตรฐาน โดยเฉพาะในภาพที่ท้าทายที่สุด ระบบยังทำหน้าที่เป็นเครื่องมือวินิจฉัยจุดบอด (blind spots) ช่วยให้ค้นพบสถานการณ์ที่ไม่คาดคิดมาก่อน
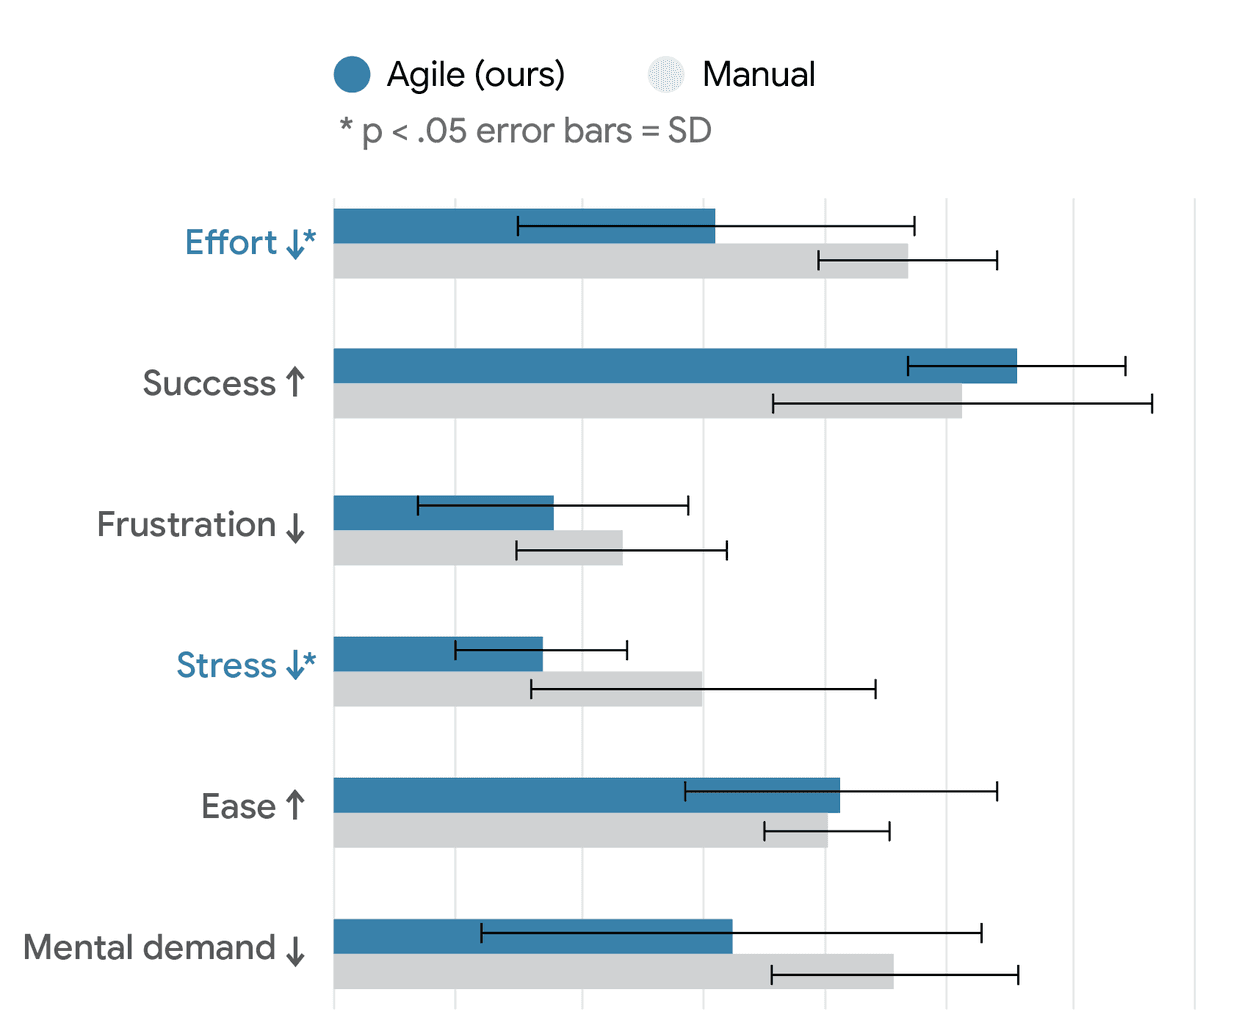
นอกจากนี้ยังช่วยบรรเทาความเหนื่อยล้าทางพุทธิปัญญา (Cognitive Fatigue) ได้อย่างมาก ผู้ใช้รายงานว่าความเครียดและความกังวลลดลงเนื่องจากไม่ต้องคาดเดาคำค้นหาหรือแก้พรอมต์ด้วยตนเอง ระบบรับภาระการคำนวณที่หนักหน่วงไปจัดการเอง ทำให้ผู้ใช้เพียงแค่ดูภาพที่คัดสรรมาและให้ข้อเสนอแนะที่เป็นธรรมชาติ
บทสรุป
Agile Deliberation ได้เปลี่ยนกระบวนทัศน์จาก AI ที่เรียนรู้ทางเดียว เป็นการทำงานร่วมกันสองทางเพื่อขัดเกลาแนวคิดให้ละเอียดอ่อนสอดคล้องกับมนุษย์ (human-AI alignment) เหมาะสำหรับงานตรวจสอบความปลอดภัยของเนื้อหา การคัดกรองคอลเลกชันดิจิทัล หรือการนิติวิทยาศาสตร์
ผู้ที่สนใจสามารถศึกษารายละเอียดเชิงลึกได้จาก paper หรือทดลองผ่าน Colab/Jupyter demo บน GitHub เพื่อประยุกต์ใช้กับโดเมนเฉพาะทางหรือการสร้างตัวจำแนกประเภทส่วนบุคคล
กิตติกรรมประกาศ
ขอขอบคุณผู้ร่วมงานจาก Google Research และ Google Ads สำหรับการมีส่วนร่วมในงานวิจัยชิ้นนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร