
Alibaba เปิดตัว Qwen4-Max โมเดล MoE 2.4T หั่นราคา API ลง 62%
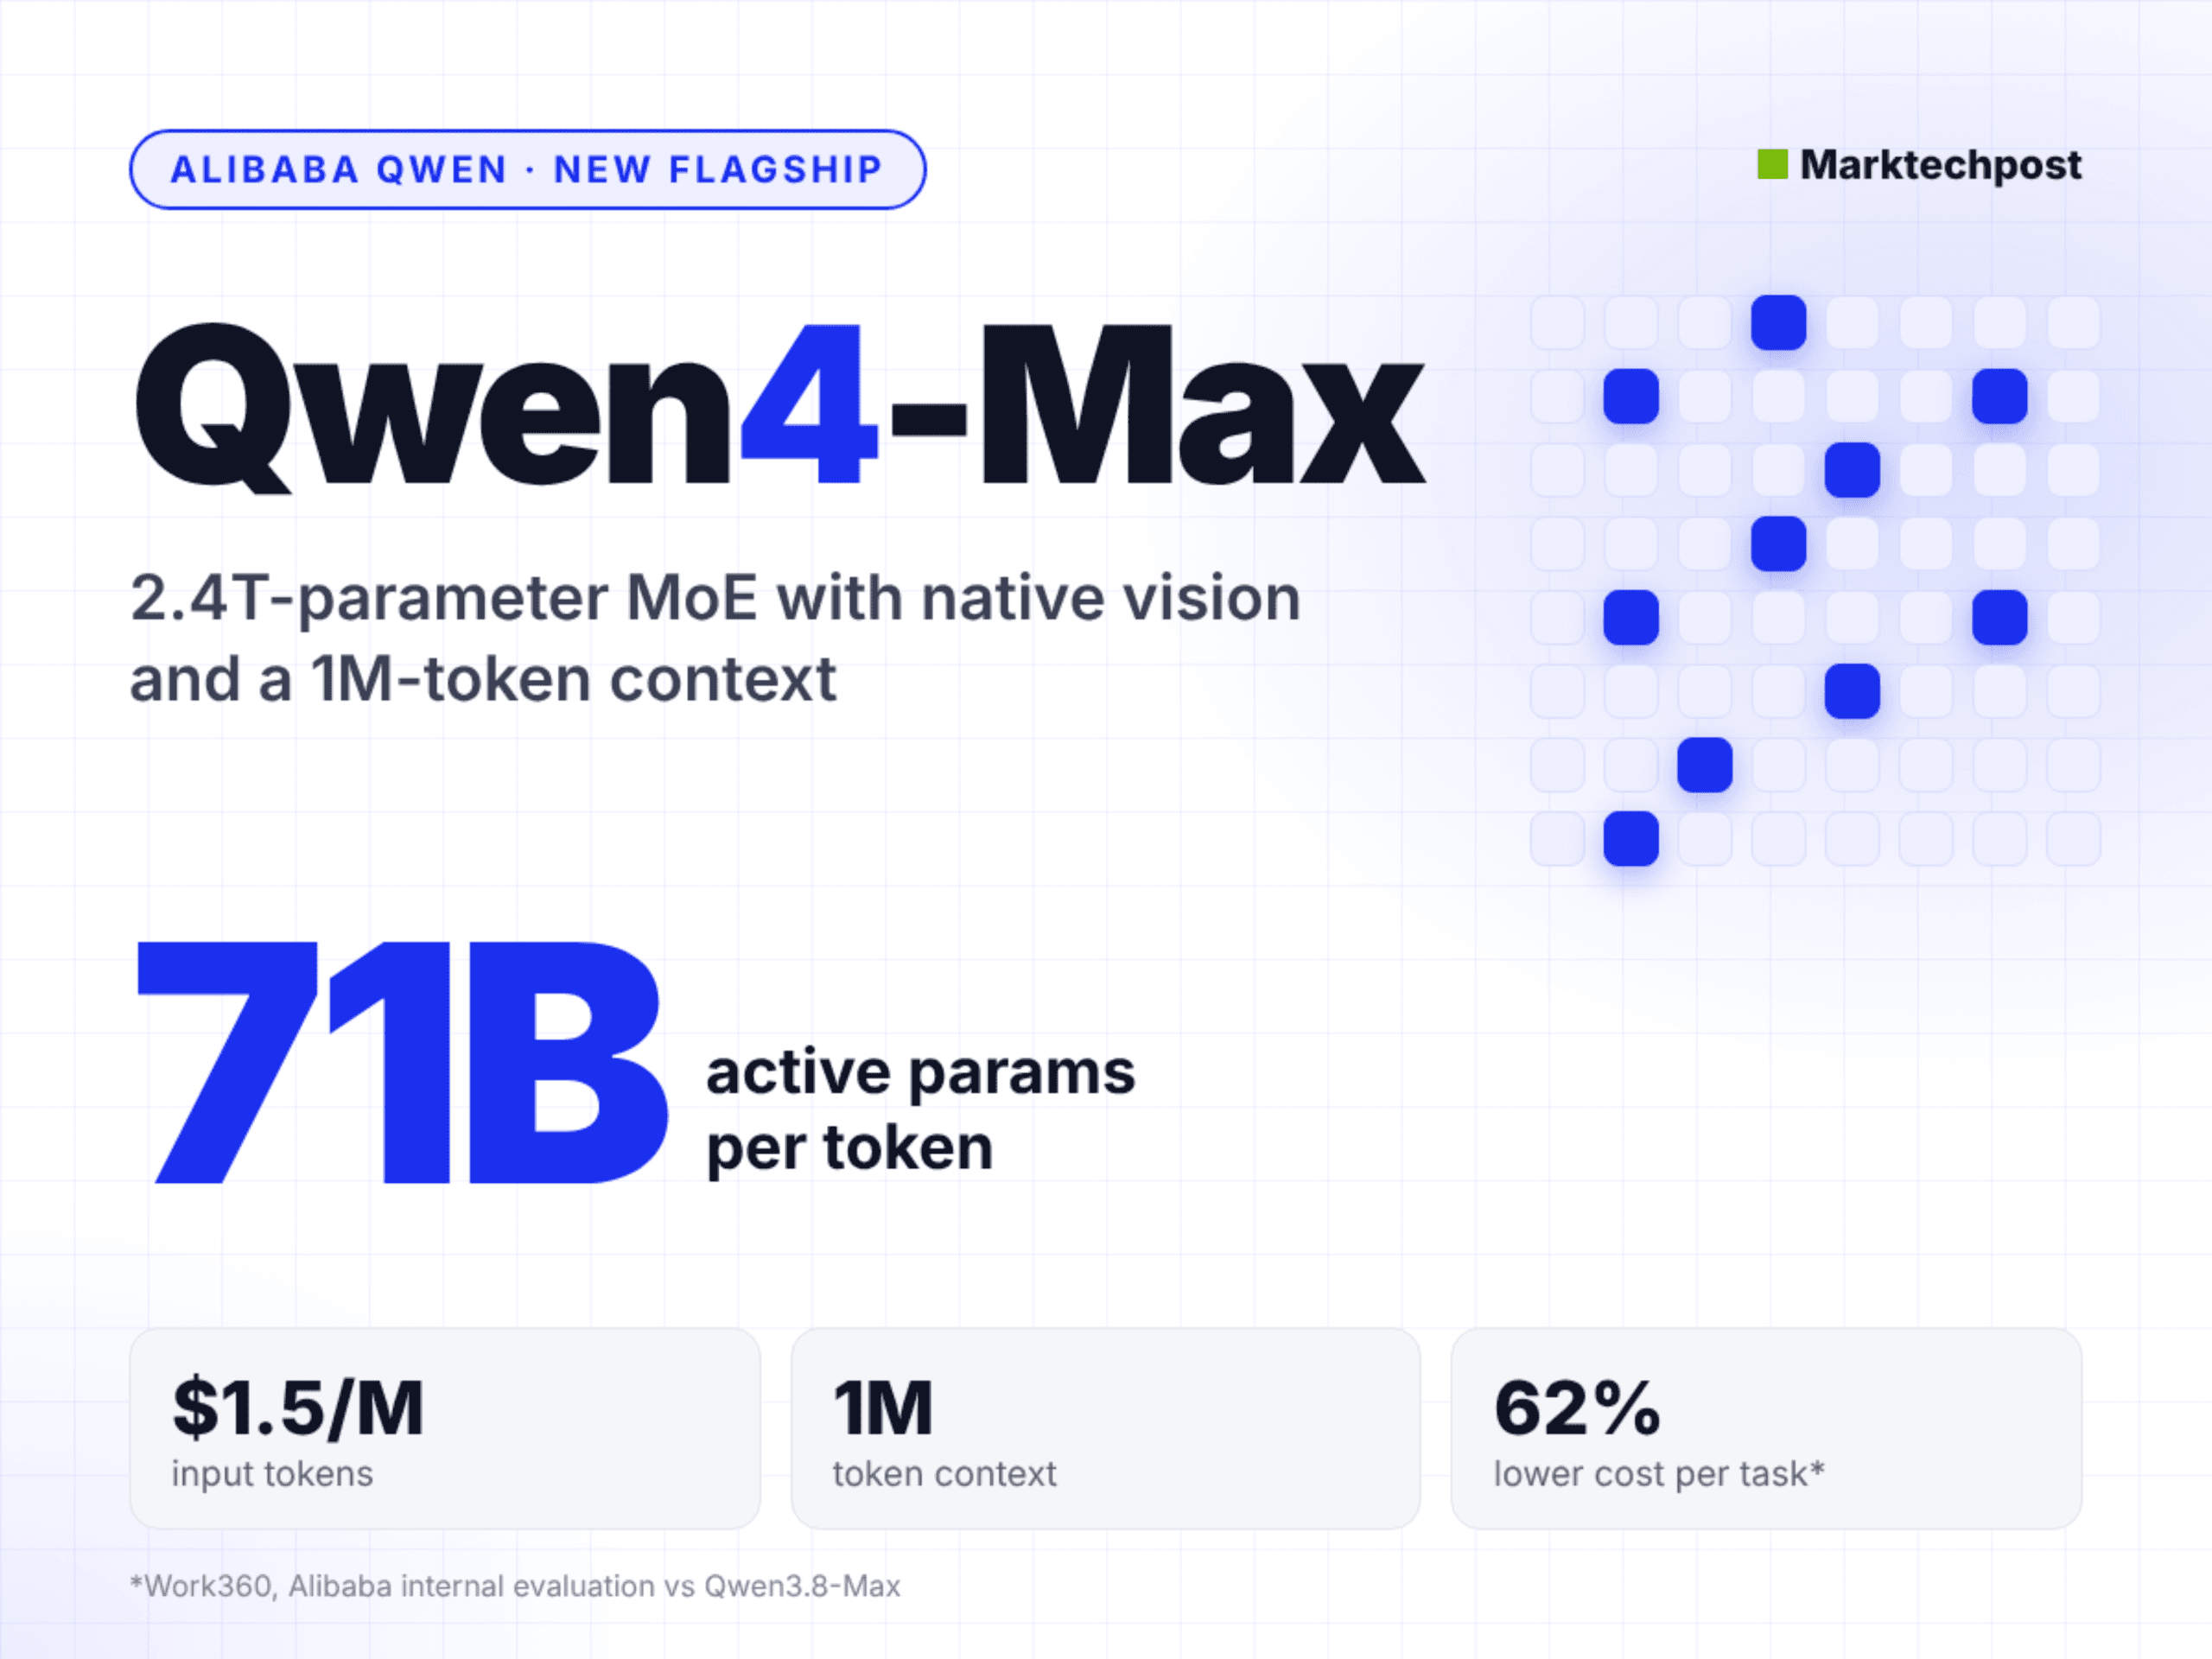
ทีม Qwen ของ Alibaba ได้เปิดตัว Qwen4-Max ซึ่งเป็นโมเดลลำดับแรกในเจเนอเรชัน Qwen4 โดยเป็นโมเดลแบบ sparse MoE (Mixture of Experts) ระดับกรรมสิทธิ์ที่มีโครงสร้างหลัก (backbone) ขนาด 2.4T พารามิเตอร์ และมีพารามิเตอร์ขณะทำงาน (active) 71B ต่อ token
โมเดลรุ่นนี้ได้รับการออกแบบให้รองรับข้อมูลหลากหลายรูปแบบทั้งข้อความ รูปภาพ และวิดีโอ พร้อมรองรับ 1M-token context window นอกจากนี้ Alibaba ยังสร้างเสียงฮือฮาด้วยการประกาศลดราคา API ซึ่งส่งผลให้ต้นทุนเฉลี่ยต่อภารกิจลดลงถึง 62% เมื่อเทียบกับรุ่นก่อนหน้า
TL;DR
- ขนาด: พารามิเตอร์ backbone 2.4T, active 71B ต่อ token เสริมด้วย N-gram Embedding อีก 328B รองรับบริบท 1M และให้เอาต์พุตสูงสุดถึง 393K tokens
- การเข้าใช้งาน: ให้บริการผ่าน QwenCloud API, Token Plan, Qwen Studio, QwenWork และ Qoder เท่านั้น ไม่มีการเปิดเผยน้ำหนักโมเดล (open weights) จึงย้ายไปทำ self-hosting หรือสร้างเวอร์ชัน quantized เองไม่ได้
- ประสิทธิภาพ: พัฒนาขึ้นจาก Qwen3.8-Max อย่างก้าวกระโดด สามารถแข่งขันกับโมเดลระดับหน้า (frontier models) ในงานด้าน agentic ได้ดี แต่ยังตามหลังคู่แข่งในด้านการเขียนโค้ดที่ซับซ้อนและการประมวลผล vision
- จุดเด่น: ทำคะแนนสูงสุดใน HLAB-Vals-1.1 (งานด้านกฎหมาย) ที่ 21.3 คะแนน ทิ้งห่าง Kimi K3.1 ที่ทำได้ 11.7 คะแนนอย่างชัดเจน
Qwen4-Max คืออะไร?
Qwen4-Max คือโมเดลภาษาแบบ multimodal MoE จาก Alibaba ที่พัฒนาขึ้นเพื่อตอบโจทย์งานระดับมืออาชีพที่ต้องใช้การประมวลผลข้อมูลจำนวนมากในระยะยาว โดย เวอร์ชันพรีวิวสำหรับ Token Plan ได้เปิดให้เริ่มใช้งานแล้วในเดือนนี้
สถาปัตยกรรมของ Qwen4-Max ทำงานอย่างไร?
Qwen4 ได้ปรับปรุงการออกแบบสถาปัตยกรรม sparse MoE ใน 3 ส่วนสำคัญ ได้แก่ attention, residual connections และ embeddings เพื่อเพิ่มประสิทธิภาพสูงสุด
- GDN + Qwen Sparse Attention (QSA): แต่ละเลเยอร์ของ QSA จะทำงานร่วมกับเลเยอร์ Gated DeltaNet 3 เลเยอร์ เพื่อบีบอัดประวัติข้อมูล (history) ให้อยู่ในสถานะคงที่ จากนั้น QSA จะใช้ดัชนีน้ำหนักเบาเพื่อเลือกบริบทที่เกี่ยวข้องในระดับ micro-block ช่วยลดต้นทุนในลำดับข้อมูลที่มีความยาวสูง
- Gated Residual (GR): ใช้สาขา residual ขนานกัน 4 สาขา พร้อมเกตสำหรับการอ่านและเขียนแบบไดนามิก เพื่อให้การไหลเวียนของข้อมูลแข็งแกร่งและเพิ่มความเสถียรในการเทรน
- N-gram Embedding: มีการเพิ่มพารามิเตอร์อีก 328B เพื่อช่วยค้นหารูปแบบ token ในพื้นที่เฉพาะ (local pattern) ซึ่งช่วยเพิ่มขีดความสามารถโดยใช้พลังประมวลผลเพิ่มขึ้นเพียงเล็กน้อยเท่านั้น
จากการทดสอบภายใน Alibaba รายงานว่าไม่พบปัญหา loss spikes ตลอดช่วง pre-training ในสเกล 2.4T โดย Qwen4-Max-Base ให้ค่า bits per byte ต่ำกว่า Qwen3.8-Max-Base ประมาณ 5-13% แม้จะใช้พารามิเตอร์ขณะทำงานน้อยลงถึง 25% ก็ตาม
ประสิทธิภาพบนผลทดสอบ Benchmark
ตารางเปรียบเทียบ ของ Alibaba แสดงผลทดสอบ 16 benchmark ร่วมกับคู่แข่งอย่าง Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra และ Kimi K3.1 โดย Qwen4-Max สามารถครองอันดับหนึ่งได้ใน 4 รายการ ได้แก่:
- HLAB-Vals-1.1 (ตัวแทนทางกฎหมาย): 21.3 คะแนน (คู่แข่งสูงสุดคือ Kimi K3.1 ที่ 11.7)
- Agents’ Last Exam v1.1: 46.7 คะแนน
- BioMysteryBench: 85.0 คะแนน
- DeepSWE v1.1: 75.7 คะแนน
อย่างไรก็ตาม Claude Opus 5.5 ยังคงนำอยู่ใน 7 รายการ โดยเฉพาะด้านการเขียนโค้ดและ vision ที่ Qwen4-Max ยังตามหลังอยู่พอสมควร เช่น ใน ProgramBench ที่ทำได้ 31.5 คะแนน เทียบกับ 65.0 คะแนนของ Opus 5.5
ต้นทุนการใช้งานที่ถูกลงอย่างมีนัยสำคัญ
การลดค่าใช้จ่ายมาจากสองส่วนคือ ประสิทธิภาพการใช้ token ที่น้อยลงและราคาที่ถูกลง โดยบนแพลตฟอร์ม Work360 ของ Alibaba พบว่ามีการใช้จำนวน token ลดลง 24-35% ส่งผลให้ต้นทุนเฉลี่ยต่อภารกิจลดจาก $4.43 เหลือเพียง $1.67 หรือลดลง 62%
สำหรับการใช้งานผ่าน API ราคาฝั่ง Input ปรับลดลงเหลือ $1.50 ต่อหนึ่งล้าน token (จากเดิม $2 ในรุ่น Qwen3.8-Max) ส่วน Output อยู่ที่ $4.50 และที่น่าสนใจคือค่าการอ่านแคช (implicit cache reads) ลดลงถึง 70% เหลือเพียง $0.075 เท่านั้น
การเข้าใช้งานสำหรับนักพัฒนา
นักพัฒนาสามารถเรียกใช้โมเดลผ่าน ID qwen4-max บน QwenCloud โดย API ตัวนี้รองรับการทำงานร่วมกับ client ของ OpenAI และ Anthropic ได้ทันที
ฟีเจอร์ที่มาให้ครบครันประกอบด้วย function calling, structured outputs, context caching, batch processing รวมถึงการทำ fine-tuning โดยมีขีดจำกัดความเร็ว (rate limit) เริ่มต้นสูงถึง 5,000,000 tokens ต่อนาที และนักพัฒนาสามารถเลือกเปิดโหมดการคิดผ่านพารามิเตอร์ enable_thinking ได้ตามต้องการ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร