
คู่มือเบื้องต้นการถอดรหัสแบบกำหนดเงื่อนไข: เปลี่ยน LLM ให้แสดงผลโครงสร้างข้อมูลแม่นยำ 100%
Introduction
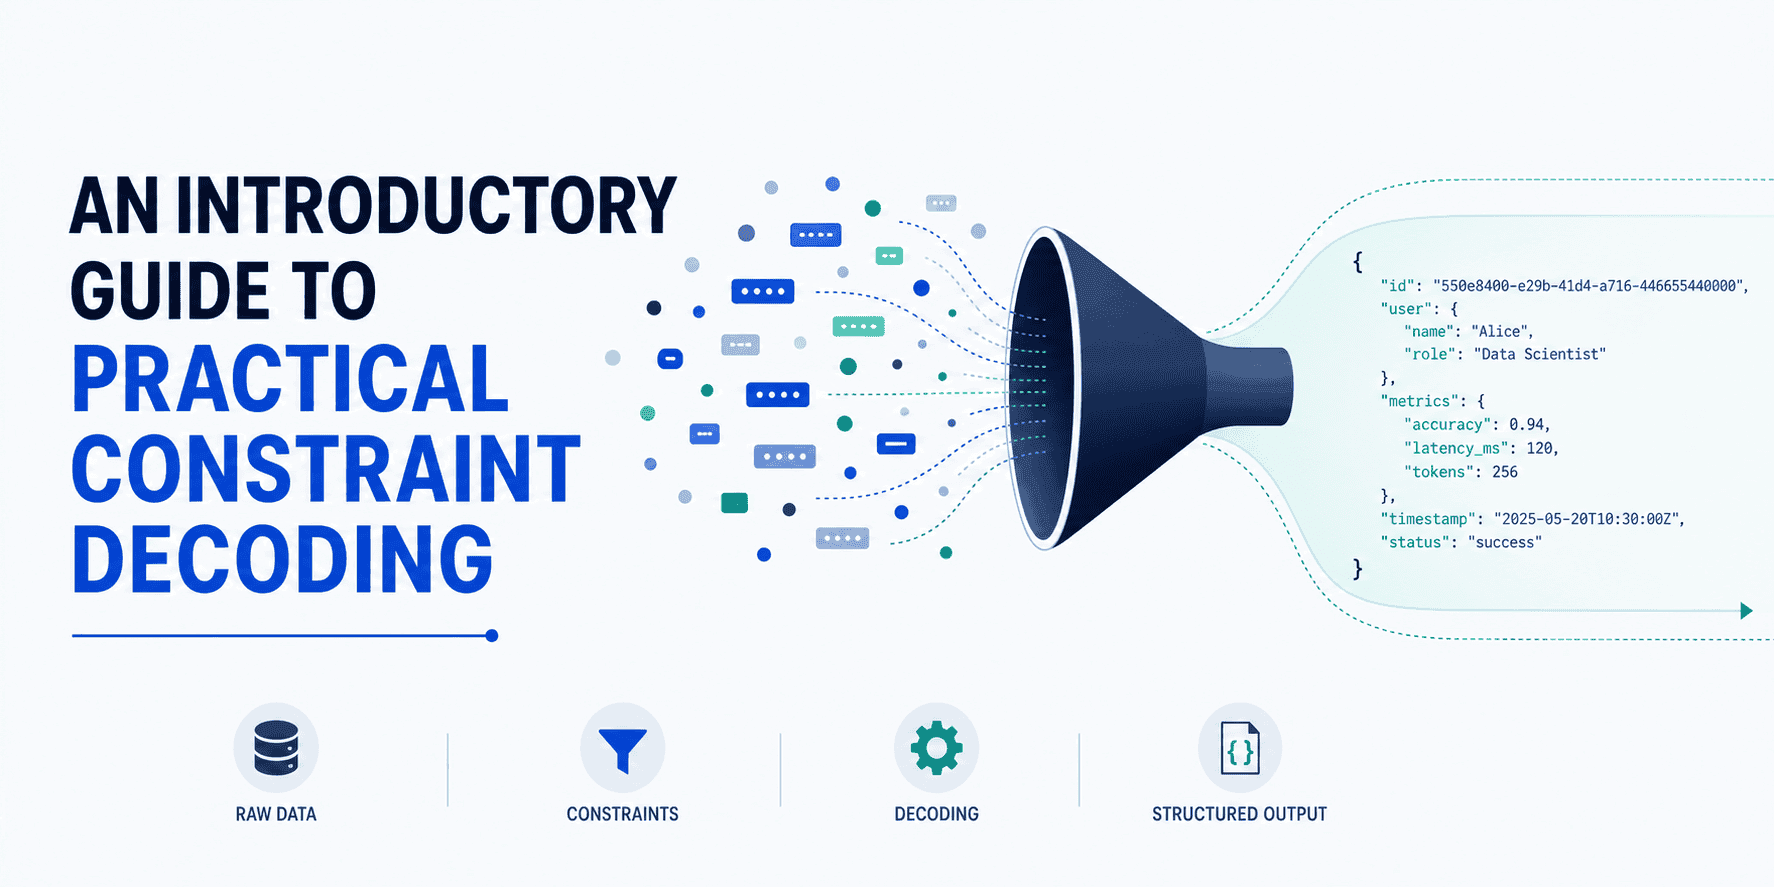
Practical constraint decoding หรือที่รู้จักในชื่อ structured generation หรือ guided decoding คือกลยุทธ์ทางวิศวกรรมที่ใช้บังคับให้โมเดลภาษาขนาดใหญ่ (LLM) สร้างข้อความที่ปฏิบัติตามโครงสร้างข้อมูล (data schema) ไวยากรณ์ หรือ regular expression (regex) ที่ระบุไว้อย่างเคร่งครัดในขั้นตอน token selection
ด้วยคู่มือเบื้องต้นเกี่ยวกับการถอดรหัสแบบกำหนดเงื่อนไขในบทความนี้ คุณจะไม่ต้องอ้อนวอนให้โมเดลของคุณ "แสดงผล JSON ที่ถูกต้องโดยไม่รวม markdown ใดๆ" อีกต่อไป เพราะเทคนิคนี้ทำให้เป็นไปไม่ได้ในทางคณิตศาสตร์ที่ LLM จะส่งผลลัพธ์ใดๆ ที่อยู่นอกเหนือข้อกำหนดที่วางไว้
How Does Practical Constraint Decoding Work?
ในขณะที่กระบวนการสร้างเนื้อหาของ LLM โดยทั่วไปทำงานแบบ "การวัดดวง" ซึ่งคุณส่ง Prompt ไปยังโมเดลและหวังว่ามันจะแสดงผลในสิ่งที่ต้องการ แต่การถอดรหัสแบบกำหนดเงื่อนไขในเชิงปฏิบัติใช้แนวทางที่แตกต่างออกไป โดยจะมองว่า Prompt และการสร้างข้อความเป็นโปรแกรมที่ทำงานสอดประสานกัน ซึ่งช่วยให้สามารถล็อกตัวอักษรบางตัวที่เป็นกุญแจสำคัญในการรักษาไวยากรณ์ไว้ได้ และอนุญาตให้โมเดล "เติมคำในช่องว่าง" เฉพาะในส่วนที่เหลือเท่านั้น
หากลงรายละเอียดเชิงลึก เมื่อ LLM แสดงผล Token ถัดไปของการตอบสนอง ในตอนแรกมันจะสร้างเวกเตอร์ของคะแนนดิบหรือ logits ซึ่งมีหนึ่งค่าสำหรับทุก Token ที่เป็นไปได้ในชุดคำศัพท์ (vocabulary) ที่มีอยู่มากมายหลายหมื่นรายการ
แต่เมื่อใช้การถอดรหัสแบบกำหนดเงื่อนไข สิ่งที่จะเกิดขึ้นก่อนกระบวนการ Inference คือ เครื่องจักรสถานะจำกัด (finite state machine) จะถูกสร้างขึ้น โดยมีการคอมไพล์เงื่อนไขเป้าหมาย เช่น ผ่านโมเดล Pydantic ใน Python ในทุกขั้นตอนของการสร้าง Token เครื่องจักรสถานะนี้จะประเมินสถานะปัจจุบันและให้ รายการของ Token ถัดไปที่อนุญาต (white list) เพื่อนำไป ใช้เป็นหน้ากาก (mask) บนเวกเตอร์ logits ดิบของ LLM ทำให้ Token ทุกตัวที่ไม่อยู่ในรายการมีค่าถูกตั้งค่าเป็นลบอินฟินิตี้ (-inf)
หลังจากกระบวนการ Masking โมเดลจะยังคงรันการทำ softmax normalization และกระบวนการสุ่ม (sampling) ตามปกติ เช่นการตั้งค่า temperature, top-p หรือ top-k บนกลุ่ม Token ที่เหลือรอด เพื่อเลือกตัวที่มีความน่าจะเป็นสูงสุดและสร้างผลลัพธ์ออกมาในที่สุด
แม้กระบวนการนี้จะดูเหมือนซับซ้อนและอาจทำให้การ Inference ช้าลง แต่ในความเป็นจริงแล้ว Libraries สมัยใหม่ใน Python ได้เพิ่มประสิทธิภาพโดยใช้ประโยชน์จากชุดคำศัพท์ที่เป็นค่าคงที่ (static) และทำการ Pre-compile ไว้ล่วงหน้า ทำให้เครื่องจักรสถานะไม่จำเป็นต้องค้นหาจากคำศัพท์ทั้งหมด ส่งผลให้การหน่วงเวลา (latency overhead) ลดลงอย่างมาก
ปัจจุบันมาตรฐานระดับสูงสำหรับการปรับใช้การถอดรหัสแบบกำหนดเงื่อนไขคือไลบรารี outlines ซึ่งช่วยให้เรากำหนดและส่งโมเดล Pydantic, JSON schemas หรือ regex ไปยังโมเดลที่ผ่านการฝึกมาล่วงหน้าได้โดยตรง เพื่อจำกัดอิสระและควบคุมการสร้างผลลัพธ์ให้เป็นไปตามที่ต้องการ
Example
ลองมาดูตัวอย่างการใช้งานจริง เริ่มต้นด้วยการติดตั้ง outlines:
pip install outlines[transformers]จากนั้นเขียนโค้ดเพื่อกำหนดโครงสร้างข้อมูลที่ต้องการ:
from pydantic import BaseModel
import outlines
from transformers import AutoTokenizer, AutoModelForCausalLM

class UserProfile(BaseModel):
    name: str
    age: int
    is_active: bool

model_name = "TinyLlama/TinyLlama-1.1B-Chat-v1.0"

llm = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)

model = outlines.from_transformers(llm, tokenizer)
result = model("Extract the user: John is a 34 year old pilot.", UserProfile)

print(result)
ตัวอย่างผลลัพธ์ (Output) ที่ได้จะเป็นรูปแบบ JSON ตามรายละเอียดที่เรากำหนดไว้ใน UserProfile ทันที:
{"name": "John",ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร