
เจาะลึกการสร้าง Local AI Agent แบบสตรีมมิ่ง: จากการรับข้อมูลสดสู่การประมวลผลแบบเรียลไทม์
คำว่า "Streaming" ในบริบทของ AI agent มักถูกนำมาใช้ในสองความหมายที่แตกต่างกัน และบทเรียนส่วนใหญ่มักจะสอนเพียงรูปแบบใดรูปแบบหนึ่งเท่านั้น
ความหมายแรกคือ Agent ที่รับข้อมูลจากสตรีมของเหตุการณ์สด (live stream) แทนที่จะรอรับคำสั่งจากมนุษย์ ส่วนความหมายที่สองคือการที่ Agent ค่อยๆ ส่งเอาต์พุตออกมาทีละ token แทนที่จะแสดงผลทั้งหมดในคราวเดียวหลังจากประมวลผลเสร็จ การสร้าง Agent ในครั้งนี้จะรวมทั้งสองรูปแบบเข้าด้วยกัน เพื่อแก้ปัญหาที่แตกต่างกันและสร้างระบบที่ทำงานได้จริงแบบ "เปิดตลอดเวลา" (always-on)
แนวคิดหลักที่เราจะนำมาใช้คือ "Ambient Agent" ซึ่งทาง LangChain อธิบายว่าถูกกระตุ้นโดยเหตุการณ์มากกว่าข้อความจากมนุษย์ เช่นเดียวกับ Agent Development Kit ของ Google ที่เน้นโครงสร้างพื้นฐานในลักษณะเดียวกัน
ในบทความนี้เราจะสร้าง Local Agent สำหรับเฝ้าดูฟีดการแก้ไข Wikipedia แบบสดๆ เพื่อวิเคราะห์การก่อกวน (vandalism) โดยไม่ต้องใช้ API key และรันทุกอย่างบนเครื่องของคุณผ่าน Ollama ซึ่งโค้ดทั้งหมดผ่านการทดสอบจริงมาแล้ว
สิ่งที่ต้องเตรียมล่วงหน้า:
- Python 3.11 ขึ้นไป
- Ollama ติดตั้งพร้อมโมเดล (เช่น
ollama pull llama3.1:8bหรือรุ่นที่รองรับ structured JSON output) - ติดตั้งไลบรารี:
pip install fastapi uvicorn httpx pydantic ollama sse-starlette - ไม่ต้องใช้ API key หรือบัญชี Cloud มีเพียงค่าไฟฟ้าของคุณเท่านั้น โดยระบบจะเชื่อมต่อไปยัง EventStreams สาธารณะของ Wikipedia ที่ไม่ต้องยืนยันตัวตน
การตัดสินใจด้านการออกแบบที่สำคัญที่สุด
สตรีมการแก้ไขของ Wikipedia มีปริมาณมหาศาลหลายรายการต่อวินาที หากเราส่งทุกรายการให้ Language Model (LLM) ประมวลผล จะส่งผลเสียสองด้านคือ สิ้นเปลืองทรัพยากรเครื่องโดยไม่จำเป็น และ Agent จะประมวลผลไม่ทันเหตุการณ์สดจนเสียจุดประสงค์การทำงานแบบ "เปิดตลอดเวลา"
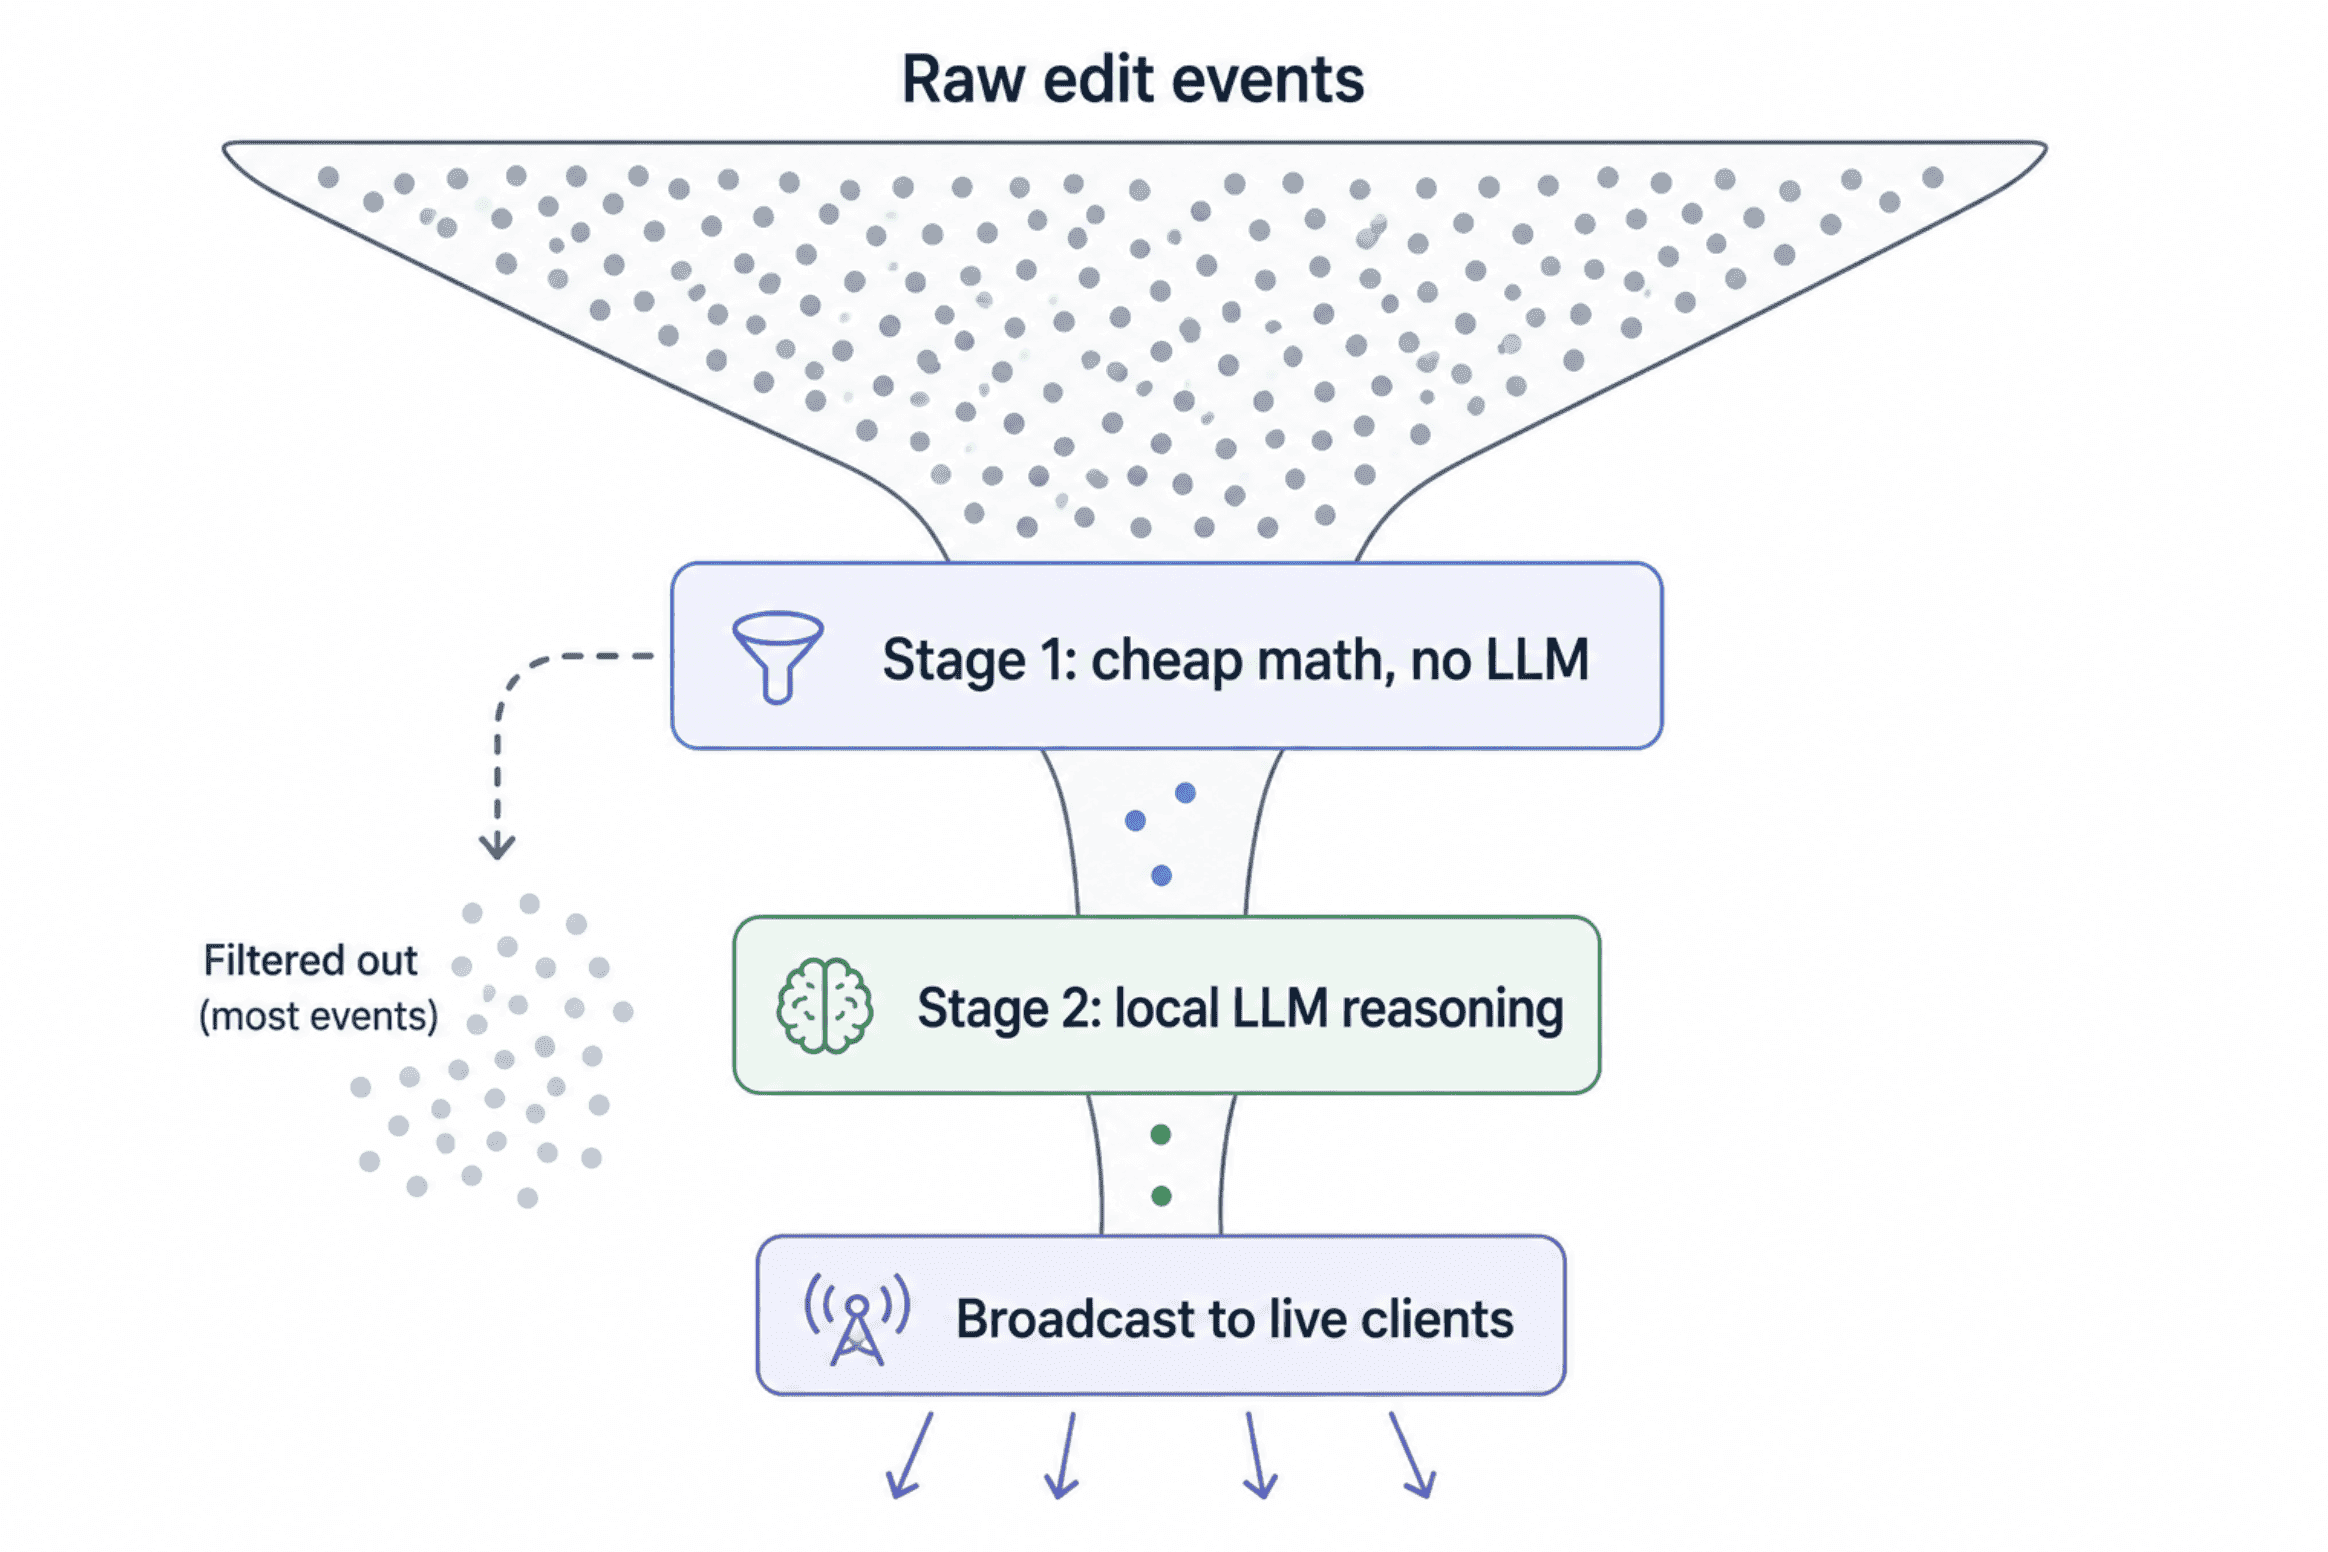
วิธีแก้ไขคือการใช้ระบบกรองข้อมูลแบบสองขั้นตอน (two-stage funnel) ซึ่งเป็นแนวคิดสำคัญที่สุดของการสร้างนี้:
- ขั้นตอนที่หนึ่ง: ใช้ Python ธรรมดาคำนวณทางคณิตศาสตร์ที่มีราคาถูก เพื่อคัดกรองทุกเหตุการณ์โดยไม่ใช้ Model เช่น ตรวจสอบว่ามีการลบข้อมูลกี่ไบต์ หรือผู้ใช้รายนี้แก้ไขบ่อยแค่ไหนในช่วงไม่กี่นาทีที่ผ่านมา เนื่องจากการแก้ไขส่วนใหญ่นั้นปกติ การตรวจจับสิ่งเหล่านี้จึงทำได้โดยไม่มีค่าใช้จ่ายสูง
- ขั้นตอนที่สอง: ใช้ Local LLM วิเคราะห์เฉพาะเหตุการณ์ส่วนน้อยที่ผ่านเกณฑ์จากขั้นตอนแรกเท่านั้น เช่นเดียวกับระบบ Monitoring ที่ดีซึ่งใช้ตัวกรองราคาถูกไว้ด้านหน้า และเก็บการวิเคราะห์ราคาแพงไว้สำหรับรายการที่น่าสงสัยจริงๆ
// โครงสร้างโฟลเดอร์
streaming-local-agent/
├── src/
│   ├── __init__.py
│   ├── config.py
│   ├── schemas.py
│   ├── stream_source.py
│   ├── filters.py
│   ├── agent.py
│   ├── broadcaster.py
│   └── main.py
├── tests/
│   └── test_filters.py
├── requirements.txt
└── .env.example
ไฟล์แต่ละส่วนจะสอดคล้องกับขั้นตอนของไพพ์ไลน์ ทำให้ง่ายต่อการทำความเข้าใจและทดสอบแยกส่วน
ส่วนที่ 1: ตัวรับสตรีมเหตุการณ์ (The Event Stream Consumer)
บริการ EventStreams ของ Wikipedia ส่งข้อมูลรูปแบบ Server-Sent Events (SSE) ผ่าน HTTP ธรรมดา ไม่ต้องใช้คีย์ เพียงแค่ส่งคำขอ GET ค้างไว้
# src/stream_source.py
import asyncio
import json
import re
import time
from typing import AsyncIterator, Optional
import httpx

from .schemas import RecentChangeEvent
from . import config

# Wikipedia ไม่ได้ส่งแฟล็ก "ผู้ใช้รายนี้ไม่ระบุตัวตนหรือไม่" อย่างชัดเจนใน
# สตรีมนี้; การแก้ไขแบบไม่ระบุตัวตนจะถูกระบุด้วยที่อยู่ IP ของผู้แก้ไขแทน
# ชื่อผู้ใช้ ดังนั้นชื่อผู้ใช้ที่มีรูปแบบเป็น IP จึงเป็นวิธีที่คุณใช้ตรวจจับในทางปฏิบัติ
_IPV4_RE = re.compile(r"^\d{1,3}(\.\d{1,3}){3}$")
_IPV6_RE = re.compile(r"^[0-9A-Fa-f:]+:[0-9A-Fa-f:]+$")

def is_anonymous_user(username: str) -> bool:
    return bool(_IPV4_RE.match(username) or _IPV6_RE.match(username))

def parse_sse_line(line: str) -> Optional[dict]:
    """SSE จะจัดระเบียบข้อมูลเป็นบรรทัดที่ขึ้นต้นด้วย 'data: ' บรรทัดคอมเมนต์
    (เริ่มต้นด้วย ':') และบรรทัดว่าง keep-alive นั้นพบได้ทั่วไปในฟีดนี้
    และควรถูกเพิกเฉยไปเงียบๆ ไม่ควรถือว่าเป็นข้อผิดพลาด"""
    if not line or line.startswith(":"):
        return None
    if line.startswith("data:"):
        raw = line[len("data:"):].strip()
        if not raw:
            return None
        try:
            return json.loads(raw)
        except json.JSONDecodeError:
            return None
    return None

def to_event(raw: dict) -> Optional[RecentChangeEvent]:
    """แปลงข้อมูล Wikimedia ดิบให้เป็น schema มาตรฐานของเรา
    จะส่งค่าคืนเป็น None สำหรับประเภทเหตุการณ์ที่เราไม่สนใจแทนที่จะ
    แจ้ง error เนื่องจากสตรีมที่มีปริมาณสูงเช่นนี้มักจะมีข้อมูลรูปแบบที่
    เราไม่ได้เฝ้าดูอยู่ตลอดเวลา"""
    if raw.get("type") != "edit":
        return None
    length = raw.get("length") or {}
    if "old" not in length or "new" not in length:
        return None
    return RecentChangeEvent(
        wiki=raw.get("wiki", "unknown"),
        user=raw.get("user", "unknown"),
        title=raw.get("title", "unknown"),
        is_anonymous=is_anonymous_user(raw.get("user", "")),
        is_bot=raw.get("bot", False),
        old_length=length["old"],
        new_length=length["new"],
        timestamp=raw.get("timestamp", time.time()),
        comment=raw.get("comment", "") or "",
    )

async def wikipedia_event_stream() -> AsyncIterator[RecentChangeEvent]:
    """ตัวสร้าง async สดที่ใช้โดย main.py จะเชื่อมต่อใหม่โดยอัตโนมัติ
    เมื่อการเชื่อมต่อหลุด แทนที่จะปล่อยให้บริการทั้งหมดหยุดทำงานเพียงเพราะ
    ปัญหาเครือข่ายชั่วคราว ซึ่งสำคัญมากสำหรับสิ่งที่ออกแบบมาให้ทำงานโดยไม่มีคนเฝ้า"""
    while True:
        try:
            async with httpx.AsyncClient(timeout=None) as client:
                async with client.stream("GET", config.WIKIPEDIA_STREAM_URL) as response:
                    async for line in response.aiter_lines():
                        raw = parse_sse_line(line)
                        if raw is None:
                            continue
                        if raw.get("wiki") not in config.WATCHED_WIKIS:
                            continue
                        event = to_event(raw)
                        if event is not None:
                            yield event
        except httpx.HTTPError:
            await asyncio.sleep(5)
จุดที่น่าสนใจคือการตรวจจับผู้ใช้ไม่ระบุตัวตน เนื่องจากฟีดไม่มีฟิลด์ระบุตรงๆ เราจึงต้องใช้ is_anonymous_user ตรวจสอบว่าชื่อผู้ใช้มีรูปแบบเป็น IPv4 หรือ IPv6 แทน
นอกจากนี้ ฟังก์ชัน parse_sse_line และ to_event ถูกออกแบบเป็น pure functions เพื่อให้ทดสอบตรรกะการคัดกรองได้ง่ายก่อนเชื่อมต่อเครือข่ายจริง ส่วน wikipedia_event_stream มีการใช้ while True และการหน่วงเวลาเมื่อเกิดข้อผิดพลาด เพื่อให้ระบบทำงานต่อเนื่องได้จริง
ส่วนที่ 2: ตัวกรองราคาถูก ขั้นตอนที่หนึ่ง
# src/filters.py
import time
from collections import defaultdict, deque
from typing import Optional

from .schemas import RecentChangeEvent, FilterSignal
from . import config

class EditVelocityTracker:
    """ติดตามประทับเวลาการแก้ไขล่าสุดต่อผู้ใช้ในหน้าต่างเวลาที่เคลื่อนที่ได้ (sliding window)
    เพื่อให้ตัวกรองสามารถจับการแก้ไขที่ถาโถมเข้ามาอย่างรวดเร็ว ไม่ใช่แค่การลบขนาดใหญ่เพียงครั้งเดียว
    มีการจำกัดหน่วยความจำ: ผู้ใช้เก่าจะถูกขับออกไป ไม่ได้ถูกเก็บไว้ตลอดไป"""

def __init__(self, window_seconds: int = config.EDIT_VELOCITY_WINDOW_SECONDS,
                 max_tracked: int = config.MAX_TRACKED_WINDOWS):
        self.window_seconds = window_seconds
        self.max_tracked = max_tracked
        self._history: dict[str, deque[float]] = defaultdict(deque)

def record_and_count(self, user: str, timestamp: float) -> int:
        """บันทึกการแก้ไขนี้และส่งคืนจำนวนการแก้ไขที่ผู้ใช้รายนี้ทำ
        ภายในหน้าต่างเวลาย้อนหลัง รวมรายการนี้ด้วย"""
        history = self._history[user]
        history.append(timestamp)

cutoff = timestamp - self.window_seconds
        while history and history[0] < cutoff:
            history.popleft()

if len(self._history) > self.max_tracked:
            self._evict_oldest()

return len(history)

def _evict_oldest(self) -> None:
        oldest_user = min(self._history, key=lambda u: self._history[u][-1] if self._history[u] else 0)
        del self._history[oldest_user]

class Stage1Filter:
    """ห่อหุ้มตัวติดตามความเร็วและการตรวจสอบการลบไบต์ไว้ในการตัดสินใจ
    ผ่าน/ไม่ผ่าน เพียงครั้งเดียวต่อเหตุการณ์"""

def __init__(self, tracker: Optional[EditVelocityTracker] = None):
        self.tracker = tracker or EditVelocityTracker()

def evaluate(self, event: RecentChangeEvent) -> Optional[FilterSignal]:
        """ส่งคืน FilterSignal หากเหตุการณ์นี้คุ้มค่าแก่เวลาของ LLM
        มิฉะนั้นจะส่งคืน None และ None คือกรณีส่วนใหญ่ที่พบ"""
        if event.is_bot:
            return None  # การแก้ไขโดย bot มีเส้นทางการตรวจสอบแยกต่างหาก

recent_count = self.tracker.record_and_count(event.user, event.timestamp)
        bytes_removed = event.bytes_removed

reasons = []
        if bytes_removed >= config.BYTES_REMOVED_THRESHOLD:
            reasons.append(f"removed {bytes_removed} bytes in one edit")
        if recent_count >= config.EDIT_VELOCITY_THRESHOLD:
            reasons.append(f"{recent_count} edits in {self.tracker.window_seconds}s")

if not reasons:
            return None

return FilterSignal(
            event=event, bytes_removed=bytes_removed,
            recent_edit_count=recent_count, reason="; ".join(reasons),
        )
EditVelocityTracker ใช้ deque เพื่อเก็บประวัติการแก้ไขล่าสุดของผู้ใช้แต่ละราย และคัดข้อมูลที่เก่าเกินหน้าต่างเวลาทิ้ง เพื่อความแม่นยำในการตรวจจับการแก้ไขที่ถี่ผิดปกติ
สิ่งสำคัญคือ max_tracked ที่ช่วยป้องกันไม่ให้หน่วยความจำบวมขึ้นเรื่อยๆ ซึ่งเป็นจุดที่มักถูกละเลยในการทำโปรเจกต์ตัวอย่าง โดย Stage1Filter.evaluate จะทำหน้าที่เป็นด่านคัดกรองหลักที่จะปล่อยผ่านเฉพาะรายการที่น่าสนใจจริงๆ เท่านั้น
ส่วนที่ 3: ตัววิเคราะห์ในเครื่อง ขั้นตอนที่สอง
เมื่อข้อมูลผ่านด่านแรกมาได้ เราจะใช้ Local LLM วิเคราะห์ด้วย Schema ที่เข้มงวดและการสตรีม Token
# src/schemas.py
from __future__ import annotations
from pydantic import BaseModel, Field

class RecentChangeEvent(BaseModel):
    wiki: str
    user: str
    title: str
    is_anonymous: bool
    is_bot: bool
    old_length: int
    new_length: int
    timestamp: float
    comment: str = ""

@property
    def bytes_removed(self) -> int:
        return max(0, self.old_length - self.new_length)

class FilterSignal(BaseModel):
    event: RecentChangeEvent
    bytes_removed: int
    recent_edit_count: int
    reason: str

class AgentVerdict(BaseModel):
    """คำตัดสินที่มีโครงสร้างที่เราบังคับให้ local model ส่งคืน
    การจำกัดสิ่งนี้ด้วย schema คือสิ่งที่ทำให้เอาต์พุตสามารถนำไปใช้ในโค้ดได้
    แทนที่จะเป็นเพียงสิ่งที่มนุษย์อ่านได้เท่านั้น"""
    is_likely_vandalism: bool
    severity: int = Field(ge=1, le=5, description="1 = probably fine, 5 = high confidence vandalism")
    reasoning: str
    suggested_action: str

# src/agent.py
from typing import AsyncIterator
import ollama

from .schemas import FilterSignal, AgentVerdict
from . import config

SYSTEM_PROMPT = """You are a Wikipedia edit-monitoring assistant. You will be \
shown metadata about an edit that tripped an automated filter for a large \
deletion or unusually rapid editing. Decide whether this looks like likely \
vandalism or a legitimate edit (a rewrite, a cleanup, a merge). Respond with \
a JSON object matching the required schema. Be specific in your reasoning, \
reference the actual numbers you were given."""

def _build_user_prompt(signal: FilterSignal) -> str:
    e = signal.event
    return (
        f"Page: {e.title}\n"
        f"User: {e.user} ({'anonymous' if e.is_anonymous else 'registered'})\n"
        f"Bytes removed: {signal.bytes_removed}\n"
        f"Recent edit count by this user: {signal.recent_edit_count}\n"
        f"Edit summary left by user: \"{e.comment or '(none)'}\"\n"
        f"Trigger reason: {signal.reason}\n"
    )

async def evaluate_signal(signal: FilterSignal) -> AsyncIterator[str | AgentVerdict]:
    """สตรีมเอาต์พุตดิบของโมเดลขณะที่กำลังถูกสร้าง (str chunks) จากนั้นจะ
    ส่งคืน AgentVerdict ที่ตรวจสอบความถูกต้องแล้วเมื่อสตรีมเสร็จสิ้น
    ผู้เรียกสามารถแยกแยะทั้งสองอย่างได้ด้วย isinstance()"""
    client = ollama.AsyncClient(host=config.OLLAMA_HOST)

stream = await client.chat(
        model=config.OLLAMA_MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": _build_user_prompt(signal)},
        ],
        format=AgentVerdict.model_json_schema(),
        stream=True,
        options={"temperature": 0.1},
    )

full_text = ""
    async for chunk in stream:
        piece = chunk["message"]["content"]
        full_text += piece
        if piece:
            yield piece  # token สด เพื่อให้ broadcaster ส่งต่อทันที

verdict = AgentVerdict.model_validate_json(full_text)
    yield verdict
การใช้ format=AgentVerdict.model_json_schema() ช่วยให้ Ollama บังคับใช้ Schema ตั้งแต่ขั้นตอนการสร้างคำตอบ ทำให้มั่นใจได้ว่าจะได้ JSON ที่ถูกต้องตามโครงสร้างที่ต้องการเสมอ
ในขณะเดียวกัน evaluate_signal จะสตรีม Token ดิบออกมาเพื่อให้แสดงผลแบบเรียลไทม์ได้ทันที และส่งคืนออบเจกต์ที่ตรวจสอบประเภทแล้วเมื่อจบการทำงาน เพื่อให้นำไปประมวลผลต่อในระบบได้อย่างแม่นยำ
ส่วนที่ 4: การแพร่ภาพการวิเคราะห์สดไปยัง Client
# src/broadcaster.py
import asyncio
import json
from typing import AsyncIterator

class Broadcaster:
    def __init__(self, max_queue_size: int = 100):
        self._subscribers: set[asyncio.Queue] = set()
        self.max_queue_size = max_queue_size

def subscribe(self) -> asyncio.Queue:
        queue: asyncio.Queue = asyncio.Queue(maxsize=self.max_queue_size)
        self._subscribers.add(queue)
        return queue

def unsubscribe(self, queue: asyncio.Queue) -> None:
        self._subscribers.discard(queue)

async def publish(self, payload: dict) -> None:
        """กระจายข้อมูลไปยังสมาชิกทุกคน สมาชิกรายใดที่
        คิวเต็มจะถูกทิ้งข้อความแทนที่จะมาบล็อกไพพ์ไลน์ทั้งหมด
        client ที่ช้าไม่ควรสามารถทำให้ลูปการประมวลผลจริงของ
        agent ช้าลงได้"""
        message = json.dumps(payload)
        for queue in list(self._subscribers):
            try:
                queue.put_nowait(message)
            except asyncio.QueueFull:
                continue

async def stream(self) -> AsyncIterator[str]:
        """ตัวสร้าง async ที่ผู้เรียกสามารถวนลูปเพื่อรับข้อความได้
        ใช้โดยเอนด์พอยต์ SSE ใน main.py โดยตรง"""
        queue = self.subscribe()
        try:
            while True:
                message = await queue.get()
                yield message
        finally:
            self.unsubscribe(queue)
ระบบ Broadcaster ออกแบบมาเพื่อรองรับ Client หลายรายพร้อมกัน โดยใช้ asyncio.Queue แยกอิสระ หากมีผู้รับที่ช้า ระบบจะทิ้งข้อความของรายนั้น (graceful degradation) เพื่อไม่ให้กระทบต่อลูปการประมวลผลหลัก การออกแบบนี้ช่วยป้องกันปัญหาแท็บเบราว์เซอร์เพียงแท็บเดียวทำให้ระบบทั้งระบบค้าง
การเชื่อมต่อทุกอย่างเข้าด้วยกัน
# src/main.py
import asyncio
import logging
from contextlib import asynccontextmanager

from fastapi import FastAPI, Request
from sse_starlette.sse import EventSourceResponse

from .broadcaster import Broadcaster
from .filters import Stage1Filter
from .stream_source import wikipedia_event_stream
from .agent import evaluate_signal
from .schemas import AgentVerdict

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("streaming-local-agent")

broadcaster = Broadcaster()
stage1 = Stage1Filter()

async def run_pipeline() -> None:
    """รับข้อมูลจากสตรีมสดตลอดกาล รันขั้นตอนที่ 1 ในทุกเหตุการณ์
    และจะเรียกขั้นตอน LLM เฉพาะเหตุการณ์ที่ผ่านด่านแรกมาได้เท่านั้น"""
    async for event in wikipedia_event_stream():
        signal = stage1.evaluate(event)
        if signal is None:
            continue

logger.info("Stage 1 flagged: %s by %s (%s)", signal.event.title, signal.event.user, signal.reason)
        await broadcaster.publish({"type": "flagged", "title": signal.event.title, "reason": signal.reason})

try:
            async for item in evaluate_signal(signal):
                if isinstance(item, str):
                    await broadcaster.publish({"type": "token", "title": signal.event.title, "text": item})
                elif isinstance(item, AgentVerdict):
                    await broadcaster.publish({
                        "type": "verdict", "title": signal.event.title, "user": signal.event.user,
                        **item.model_dump(),
                    })
        except Exception:
            logger.exception("Stage 2 failed for %s, skipping this signal", signal.event.title)

@asynccontextmanager
async def lifespan(app: FastAPI):
    task = asyncio.create_task(run_pipeline())
    logger.info("Streaming local agent started, watching for edits...")
    yield
    task.cancel()
    logger.info("Streaming local agent shutting down")

app = FastAPI(title="Streaming Local Agent", lifespan=lifespan)

@app.get("/events")
async def events(request: Request):
    async def event_generator():
        async for message in broadcaster.stream():
            if await request.is_disconnected():
                break
            yield message
    return EventSourceResponse(event_generator())

@app.get("/health")
def health():
    return {"status": "ok"}
ฟังก์ชัน run_pipeline คือหัวใจสำคัญที่เชื่อมต่อทุกส่วนเข้าด้วยกัน โดยมี lifespan ของ FastAPI คอยจัดการการเริ่มและหยุดทำงานอย่างเป็นระบบ ส่วนเอนด์พอยต์ /events จะสตรีมข้อมูลทั้งสถานะ flagged, token และ verdict ไปยังเบราว์เซอร์ และมีการตรวจสอบการตัดการเชื่อมต่อเพื่อป้องกันทรัพยากรรั่วไหล
// วิธีการรัน
เริ่มต้นใช้งาน Ollama และดึงโมเดล:
ollama pull llama3.1:8b
ollama serve   # หากยังไม่ได้รันเป็นบริการพื้นหลัง
จากนั้นรันโปรเจกต์:
python -m venv venv
source venv/bin/activate
pip install -r requirements.txt
uvicorn src.main:app --reload
ทดสอบฟีดสดผ่าน Terminal:
curl -N http://localhost:8000/eventsคุณจะเห็นสถานะการคัดกรองและการวิเคราะห์จาก Local Model ปรากฏขึ้นแบบเรียลไทม์เฉพาะรายการที่น่าสงสัยเท่านั้น
หมายเหตุเกี่ยวกับการขยายขนาด (Scaling)
โครงสร้างนี้เหมาะสำหรับการรันบนเครื่องเดียว หากต้องการขยายไพพ์ไลน์ไปยังระดับการใช้งานจริงที่มีหลายแหล่งข้อมูลและหลายกระบวนการ ควรเปลี่ยนจาก asyncio.Queue ในตัวไปใช้ Message Bus เช่น Kafka เพื่อคั่นกลางระหว่างส่วนรับข้อมูลและส่วนวิเคราะห์
บทสรุป
หัวใจสำคัญของโปรเจกต์นี้คือประสิทธิภาพต้องไม่ใช่สิ่งที่ค่อยมาปรับแต่งภายหลัง เมื่อคุณสร้าง Agent แบบ "เปิดตลอดเวลา" ทุกการตัดสินใจออกแบบ ตั้งแต่การกรองสองขั้นตอนไปจนถึงการจัดการหน่วยความจำและการเชื่อมต่ออัตโนมัติ ล้วนเป็นสิ่งจำเป็นเพื่อให้ระบบสามารถคงสภาพการทำงานได้ชั่วนิรันดร์ท่ามกลางกระแสข้อมูลที่ไหลบ่าเข้ามาอย่างต่อเนื่อง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร