
Buoyant เปิดตัว Kinference คอนโทรลเพลน Open Source สำหรับ vLLM
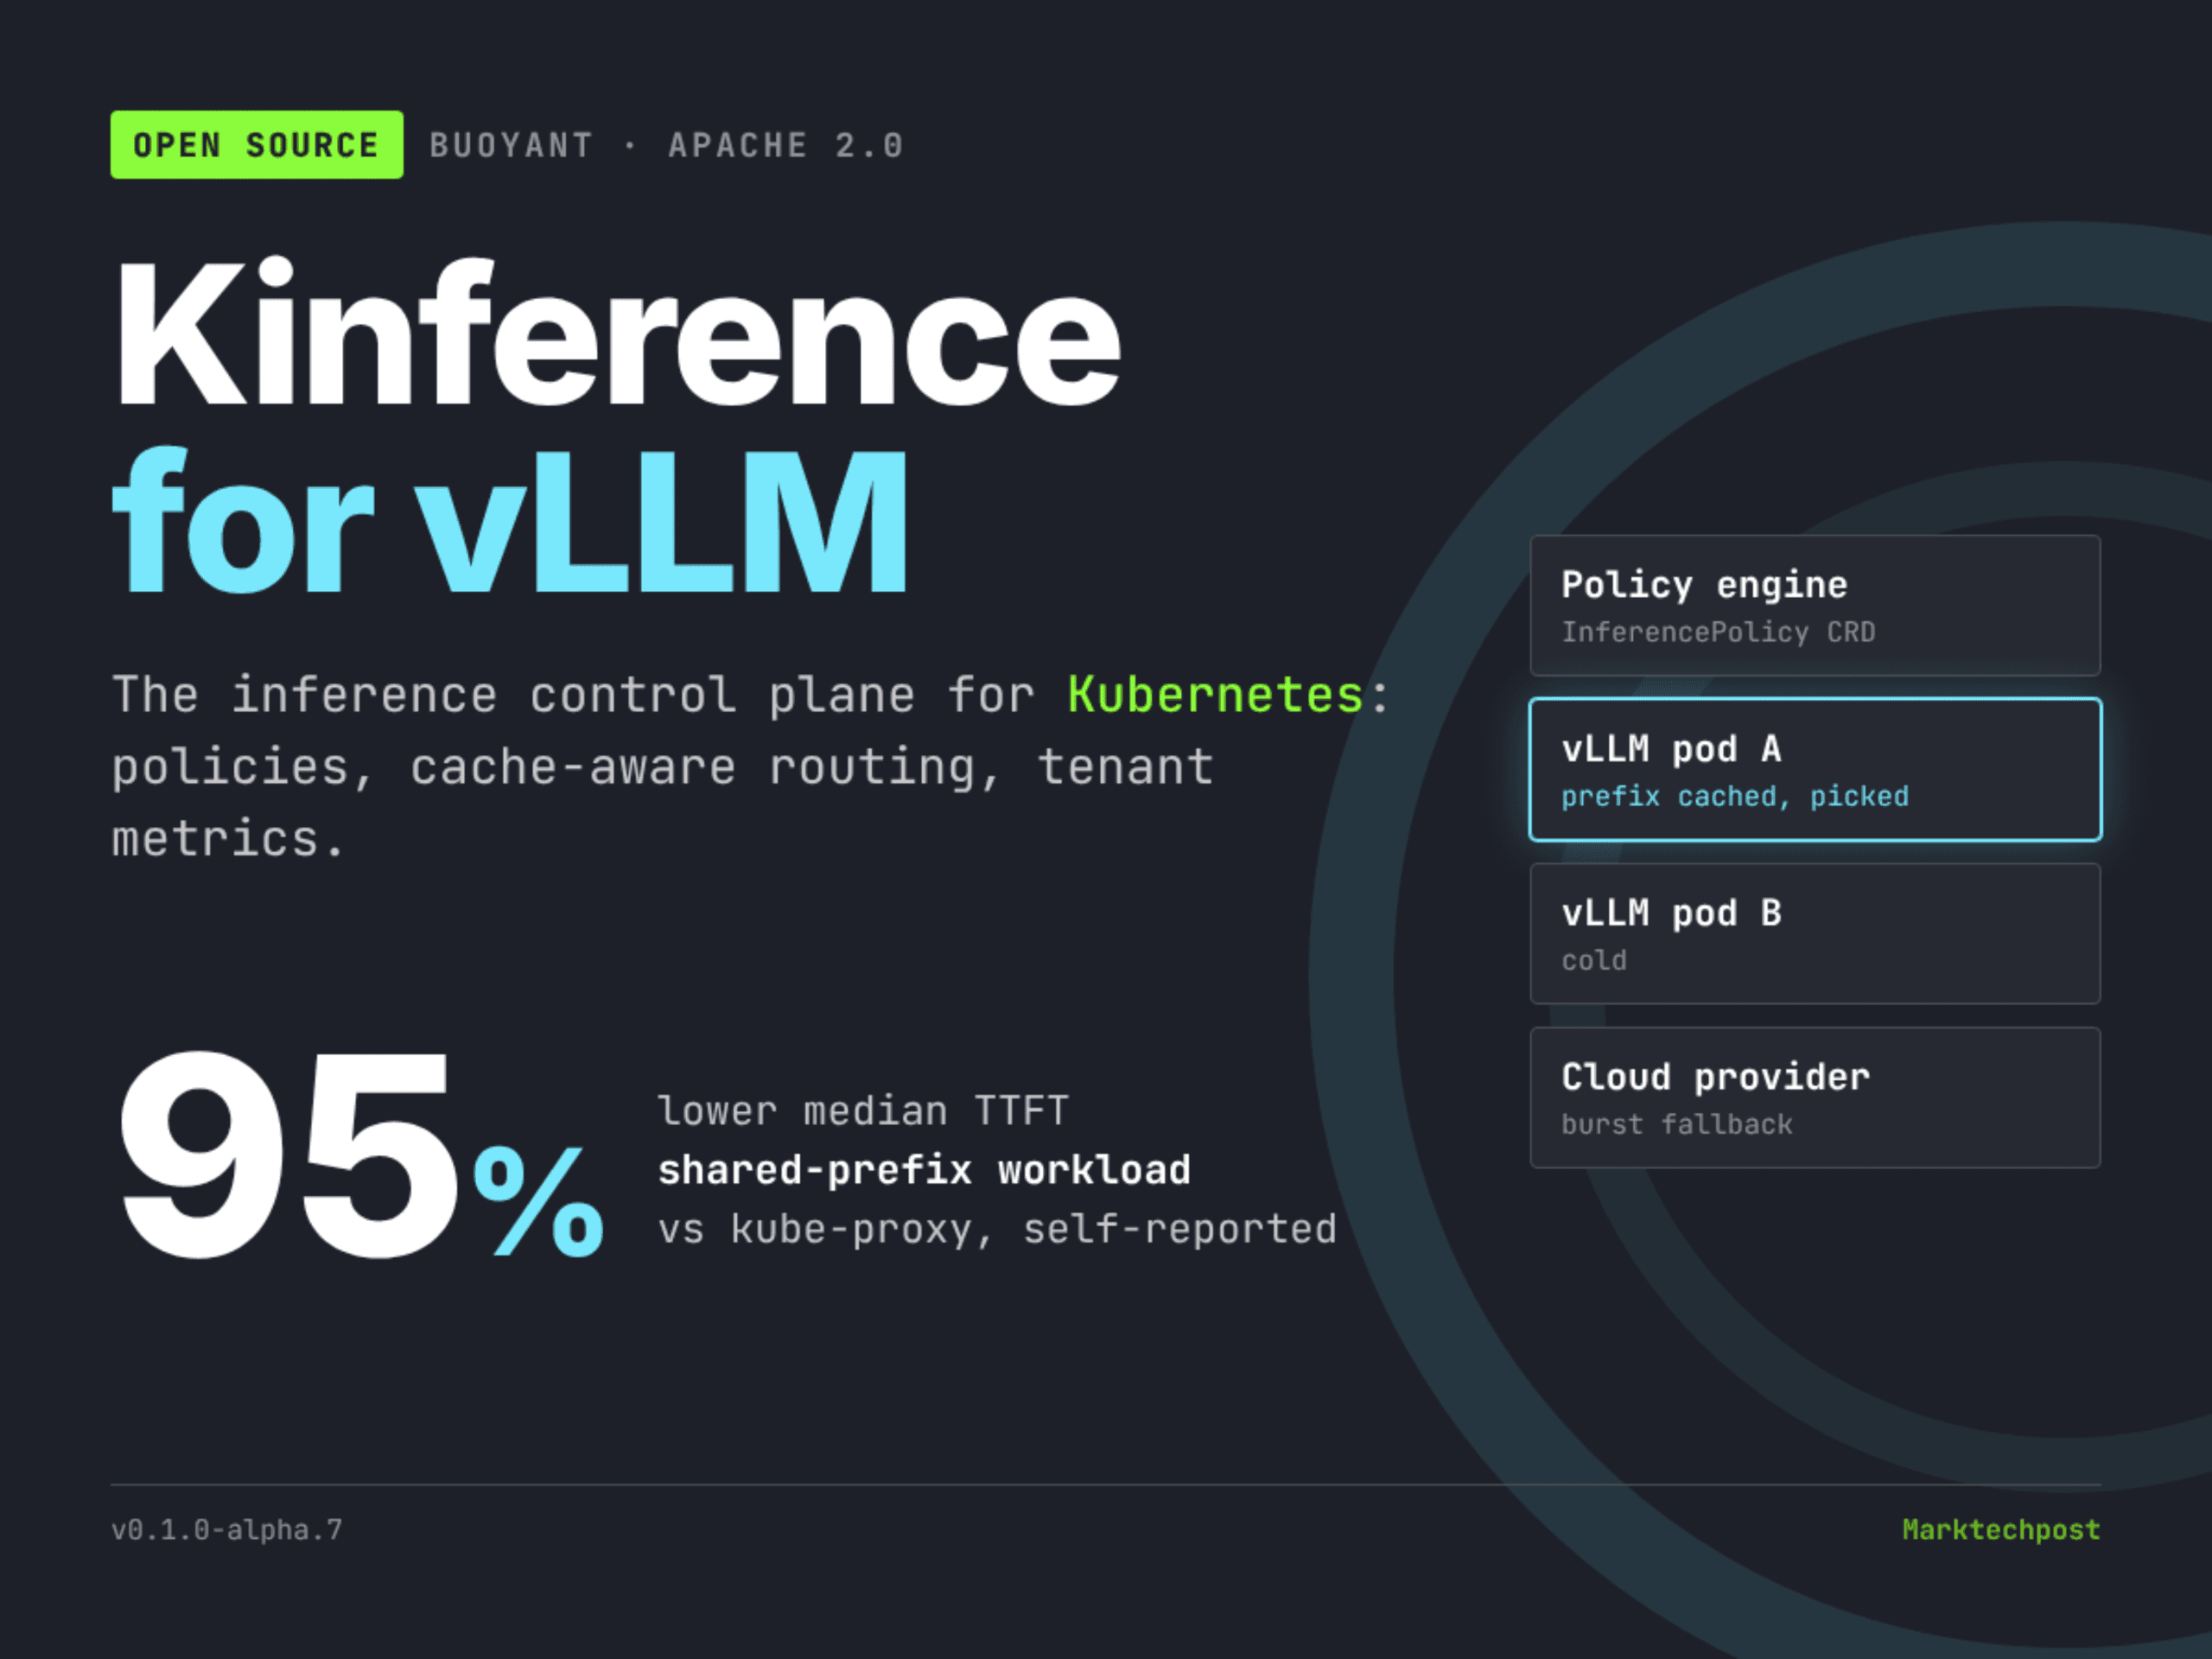
Buoyant บริษัทผู้พัฒนา Linkerd ได้เปิดตัว Kinference โปรเจกต์ open source สำหรับสร้างแพลตฟอร์มการทำ inference บน Kubernetes โดย Kinference ทำหน้าที่เป็น inference control plane สำหรับ Kubernetes และ vLLM ซึ่งจะติดตั้งอยู่หน้ากลุ่มตัวประมวลผล (vLLM workers) เพื่อตัดสินใจการส่งคำขอไปยังจุดที่เหมาะสมที่สุด
ระบบนี้รวมการทำงานหลายส่วนไว้ในเลเยอร์เดียว ทั้งนโยบายการจัดเส้นทาง (routing policies), การจำกัดอัตราโทเคน (token rate limits), การทำ load balancing ที่รับรู้ถึง KV-cache และการวัดผลรายผู้เช่า สำหรับทีมพัฒนาที่ต้องให้บริการโมเดล open-weight แก่ไคลเอนต์ภายในจำนวนมาก โปรเจกต์นี้วางตำแหน่งเป็นเลเยอร์เหนือ model server โดยใช้สัญญาอนุญาตแบบ Apache 2.0 และปัจจุบันอยู่ในเวอร์ชัน v0.1.0-alpha.7
สรุปข้อมูลสำคัญ (TL;DR)
- ทางเทคนิค: เวอร์ชัน v0.1.0-alpha.7 พัฒนาด้วยภาษา Rust ใช้สัญญาอนุญาต Apache 2.0 และกำหนดค่าผ่าน 5 Kubernetes CRDs
- ข้อกำหนด: รันบนคลัสเตอร์ Kubernetes ที่รองรับ GPU และรัน vLLM โดยในการทดสอบของ Buoyant ใช้ GPU รุ่น L40S จำนวน 3 ตัวต่อพูล
- ประสิทธิภาพ: พัฒนาขึ้นอย่างมากในการรับส่งข้อมูลที่มี prefix หนัก เมื่อเทียบกับการจัดเส้นทางผ่าน Kubernetes Service ปกติ
- จุดเด่นที่สุด: ค่ากลางของ TTFT ลดลงจาก 6.88 วินาที เหลือเพียง 0.31 วินาที (ลดลง 95%) ในเวิร์กโหลดที่มี prefix ร่วมกัน
- จุดด้อย: ไม่พบความต่างของค่ากลาง TTFT ในพรอมต์ที่ไม่มี prefix ร่วมกัน (6.92 วินาที เทียบกับ 6.83 วินาที)
Kinference คืออะไรและทำงานอย่างไร?
Kinference เป็น control plane ที่ขับเคลื่อนด้วยนโยบาย ซึ่งจะเปลี่ยน Kubernetes และ vLLM ให้กลายเป็นแพลตฟอร์ม inference แบบ multi-tenant โดย Buoyant อธิบายว่า vLLM เปรียบเสมือน data plane และ Kinference คือ control plane
ระบบประกอบด้วย 2 ส่วนหลักคือ traffic gateway และ inference handler โดยตัว handler จะเปิดพอร์ตอินเทอร์เฟซ gRPC เพื่อรับคำขอและส่งคืน endpoint ที่เลือกพร้อมข้อมูลที่ปรับแต่งแล้ว ซึ่งทำงานร่วมกับพร็อกซีอย่าง Buoyant Gateway ได้ทันที
นโยบายการทำ inference จะใช้กฎแบบ declarative เพื่อกำหนดวิธีจัดเส้นทางหรือปฏิเสธคำขอ โดยพิจารณาจากผู้เช่า (tenant), โมเดลที่เรียกใช้, สถานะพูล GPU และแท็กทางความหมาย (semantic tags) ตัวอย่างรูปแบบนโยบายที่รองรับมีดังนี้:
- Simple to cheaper: ส่งพรอมต์ที่ไม่ซับซ้อนไปโมเดลเล็ก เว้นแต่โมเดลใหญ่จะทำงานเร็วกว่าเนื่องจากมีแคชเหลือ
- Burst to cloud: หากคิวประมวลผลยาวเกินไป จะส่งไปใช้ผู้ให้บริการภายนอกอย่าง Bedrock แทน
- PII stays local: ปฏิเสธการส่งข้อมูลไปยังผู้ให้บริการภายนอกหากตรวจพบแท็ก PII เพื่อความปลอดภัย
- Batch on idle GPUs: ส่งงานแบบ batch ไปยังตัวประมวลผลที่มีการใช้งาน KV-cache ต่ำกว่า 70% เท่านั้น
- Model aliasing: กำหนดชื่อกลาง เช่น
standard-modelโดยมีโมเดลหลายตัวสลับกันรองรับอยู่เบื้องหลัง
กฎส่วนใหญ่มักใช้คำสั่ง minimize: PredictedTTFT โดย Kinference จะทำนายเวลาที่ใช้สำหรับโทเคนแรก (time-to-first-token) ของแต่ละ endpoint จากข้อมูลส่วนเหลื่อมของแคชและความยาวคิว ซึ่งนโยบายเหล่านี้สามารถเก็บไว้ใน git และตรวจสอบความถูกต้องผ่าน kinfctl CLI ได้
ประสิทธิภาพจากการทดสอบ
จากการรายงานผลการทดสอบ ค่ากลางของ latency แบบ end-to-end ลดลง 45% สำหรับกรณีที่มี prefix ร่วมกัน และลดลง 32% ในกรณี multiturn ส่วนค่า p95 TTFT ลดลงจาก 21.46 วินาที เหลือ 12.33 วินาที ซึ่งเป็นผลมาจากการทำ load balancing ที่รับรู้ถึงสถานะคิว
ในการทดสอบความจุ (capacity test) เพื่อวัดค่า goodput หรือจำนวนคำขอที่ทำได้ตาม SLO พบว่าค่า peak goodput เพิ่มขึ้นเป็น 103.0 จากเดิม 14.0 req/min ในกรณีที่มี prefix ร่วมกัน (ดีขึ้นราว 7.4 เท่า) และเพิ่มขึ้นเป็น 82.7 จากเดิม 23.8 ในกรณี multiturn (ดีขึ้นราว 3.5 เท่า) ขณะที่ Service พื้นฐานไม่สามารถทำตาม SLO ได้เลย
อย่างไรก็ตาม ตัวเลขนี้เป็นการจัดเส้นทางเทียบกับวิธีสุ่มแบบพื้นฐาน ไม่ได้เทียบกับตัวจัดเส้นทางที่รับรู้แคชเจ้าอื่น เช่น llm-d หรือ Dynamo นอกจากนี้ Buoyant ยังระบุว่า SLO ที่ใช้ทดสอบ (8 และ 4 วินาที) เหมาะสำหรับงานกลุ่ม AI Agent แบบออฟไลน์มากกว่าการใช้งานแชทสด
ตารางเปรียบเทียบ Kinference กับตัวเลือกอื่นในตลาด
| คุณสมบัติ | Kinference | llm-d | NVIDIA Dynamo | vLLM Production Stack |
|---|---|---|---|---|
| ผู้สนับสนุน | Buoyant | CNCF sandbox | NVIDIA | โปรเจกต์ vLLM |
| สัญญาอนุญาต | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| สถานะความพร้อม | v0.1.0-alpha.7 | v0.7 (พฤษภาคม 2026) | 1.x (คอนเทนเนอร์ 1.5.1) | Reference stack |
| เอนจินที่รองรับ | vLLM (อนาคต: SGLang) | vLLM, SGLang | vLLM, SGLang, TRT-LLM | vLLM |
| การจัดเส้นทาง KV-cache | มี (ทำนาย TTFT) | มี (ทำนาย latency) | มี (KV-aware router) | อยู่ระหว่างพัฒนา |
| นโยบาย Declarative | มี (InferencePolicy) | ไม่มีข้อมูล | ไม่มีข้อมูล | ไม่มีข้อมูล |
| Burst ไปภายนอก | มี (InferenceProvider) | ไม่มีข้อมูล | ไม่มีข้อมูล | ไม่มีข้อมูล |
| การจัดการ Multi-tenant | การวัดผลรายผู้เช่า | Flow control | Rate limiting (GAIE) | ไม่มีข้อมูล |
จุดเด่นสำคัญของ Kinference คือเรื่องการกำกับดูแล (governance) ทั้งการกำหนดนโยบาย, การใช้นามแฝงโมเดล, ระบบสำรองเมื่อโหลดเกิน และการบันทึกข้อมูลแยกรายผู้เช่า ขณะที่คู่แข่งอย่าง llm-d และ Dynamo จะเน้นไปที่ประสิทธิภาพการประมวลผลดิบและการรองรับเอนจินที่หลากหลายกว่า
การติดตั้งและก้าวต่อไป
ผู้ที่สนใจสามารถติดตั้งได้ผ่าน 5 ขั้นตอน โดยต้องมี Gateway API v1.5.1 CRDs และติดตั้ง Helm chart ของ Buoyant gateway ตามด้วย Kinference chart ระบบจะส่งข้อมูลการวัดผลไปยัง Prometheus และแสดงผลผ่าน Grafana แดชบอร์ด ซึ่งครอบคลุมทั้ง TTFT, ITL และสถานะแคชแยกตามผู้เช่า
ปัจจุบัน Kinference ยังอยู่ในสถานะอัลฟ่า ซึ่งคุณสมบัติบางอย่าง เช่น การจำกัดอัตรา (rate limiting), ตัวจำแนกประเภท (classifiers) และการรองรับ Anthropic API ยังอยู่ระหว่างการพัฒนาและยังไม่มีให้ใช้งานในเวอร์ชันนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร