
AI จะตรวจพบ Data Leakage ได้หรือไม่ ก่อนความแม่นยำจะพุ่งถึง 99%
Data scientist ทุกคนต่างรู้ซึ้งถึงความรู้สึกนี้: เมื่อโมเดลทำความแม่นยำได้ถึง 99% แทนที่จะดีใจ เรากลับเริ่มสงสัย และเก้าในสิบครั้ง สาเหตุคือ Data Leakage หรือการรั่วไหลของข้อมูล ซึ่งเกิดจากข้อมูลบางส่วนในชุดข้อมูลสำหรับเทรน (training data) ที่ในความเป็นจริงจะไม่สามารถนำมาใช้ได้ในขณะทำการพยากรณ์
เราต้องการหาคำตอบในสองประเด็นหลัก ชุดแรกคือความแม่นยำที่พุ่งสูงขึ้นนั้นรุนแรงแค่ไหนในข้อมูลจริงที่ไม่ใช่แค่ตัวอย่างจำลอง และชุดที่สองคือหากเราอธิบาย pipeline ให้โมเดล AI ฟังก่อนการรันจริงโดยไม่มีการบอกใบ้ มันจะตรวจพบการรั่วไหลหรือไม่ และคำตอบจะเปลี่ยนไปตามรุ่นของโมเดลที่เราถามหรือไม่
ดังนั้น เราจึงนำโปรเจกต์ข้อมูลจริง 4 โปรเจกต์มาฝังรูปแบบการรั่วไหลที่แตกต่างกันลงไป จากนั้นเทรนโมเดลจริงทั้งแบบที่มีและไม่มีการรั่วไหล เพื่อบันทึกตัวเลขที่เกิดขึ้นจริงไว้เทียบกับผลลัพธ์จาก AI
หลังจากนั้น เราได้อธิบายแต่ละ pipeline ด้วยภาษาทั่วไปและถามโมเดล Claude 4 รุ่น ตั้งแต่รุ่นที่เร็วที่สุดไปจนถึงรุ่นที่แข็งแกร่งที่สุด เพื่อดูว่าพวกมันจะตรวจพบความผิดปกติอะไรบ้างก่อนที่จะเชื่อถือผลลัพธ์
การตั้งค่าการทดลอง
การรั่วไหลแต่ละรูปแบบเข้าสู่ pipeline ผ่านเส้นทางที่ต่างกัน ได้แก่ feature ที่ระบุ label โดยกลไก, feature ที่สร้างขึ้นจากข้อมูลในอนาคต, การแบ่งข้อมูล (split) ที่ละเลยโครงสร้างความสัมพันธ์ และขั้นตอนการเตรียมข้อมูล (preprocessing) ที่ทำผิดลำดับ
ในฝั่งของ AI เราได้ทดสอบ Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 และ Claude Fable 5.1 ครอบคลุมทั้งช่วงความเร็วและความสามารถที่เราเข้าถึงได้
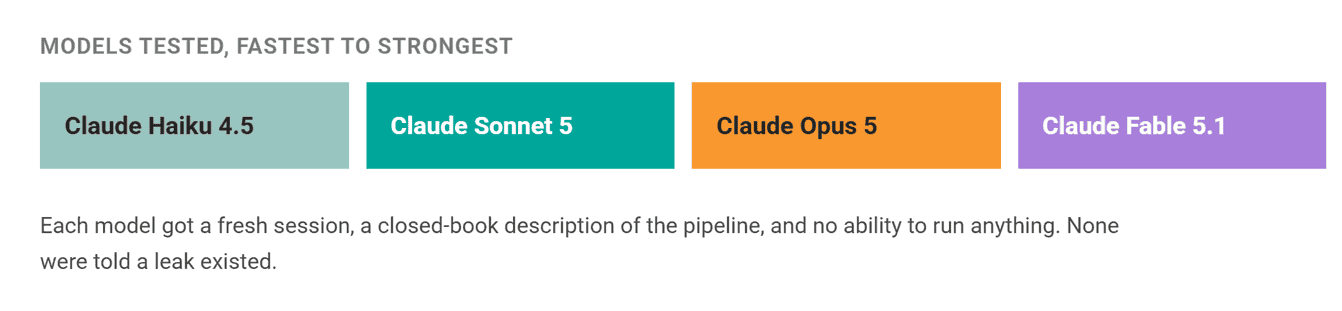
เราเจาะจงระบุชื่อโมเดลที่ทดสอบโดยไม่ได้มีเจตนาเปรียบเทียบข้ามผู้ผลิต แต่ละโมเดลจะได้รับเซสชันใหม่ที่ไม่มีความจำเกี่ยวกับรุ่นอื่น มีเพียงคำอธิบาย pipeline แบบ closed-book รวมถึง feature หรือโค้ด และไม่สามารถรันคำสั่งใดๆ ได้ โดยไม่มีตัวไหนถูกบอกล่วงหน้าว่ามีการรั่วไหลซ่อนอยู่
กรณีที่ 1: Feature ที่รู้อยู่แล้วว่าคำตอบคืออะไร
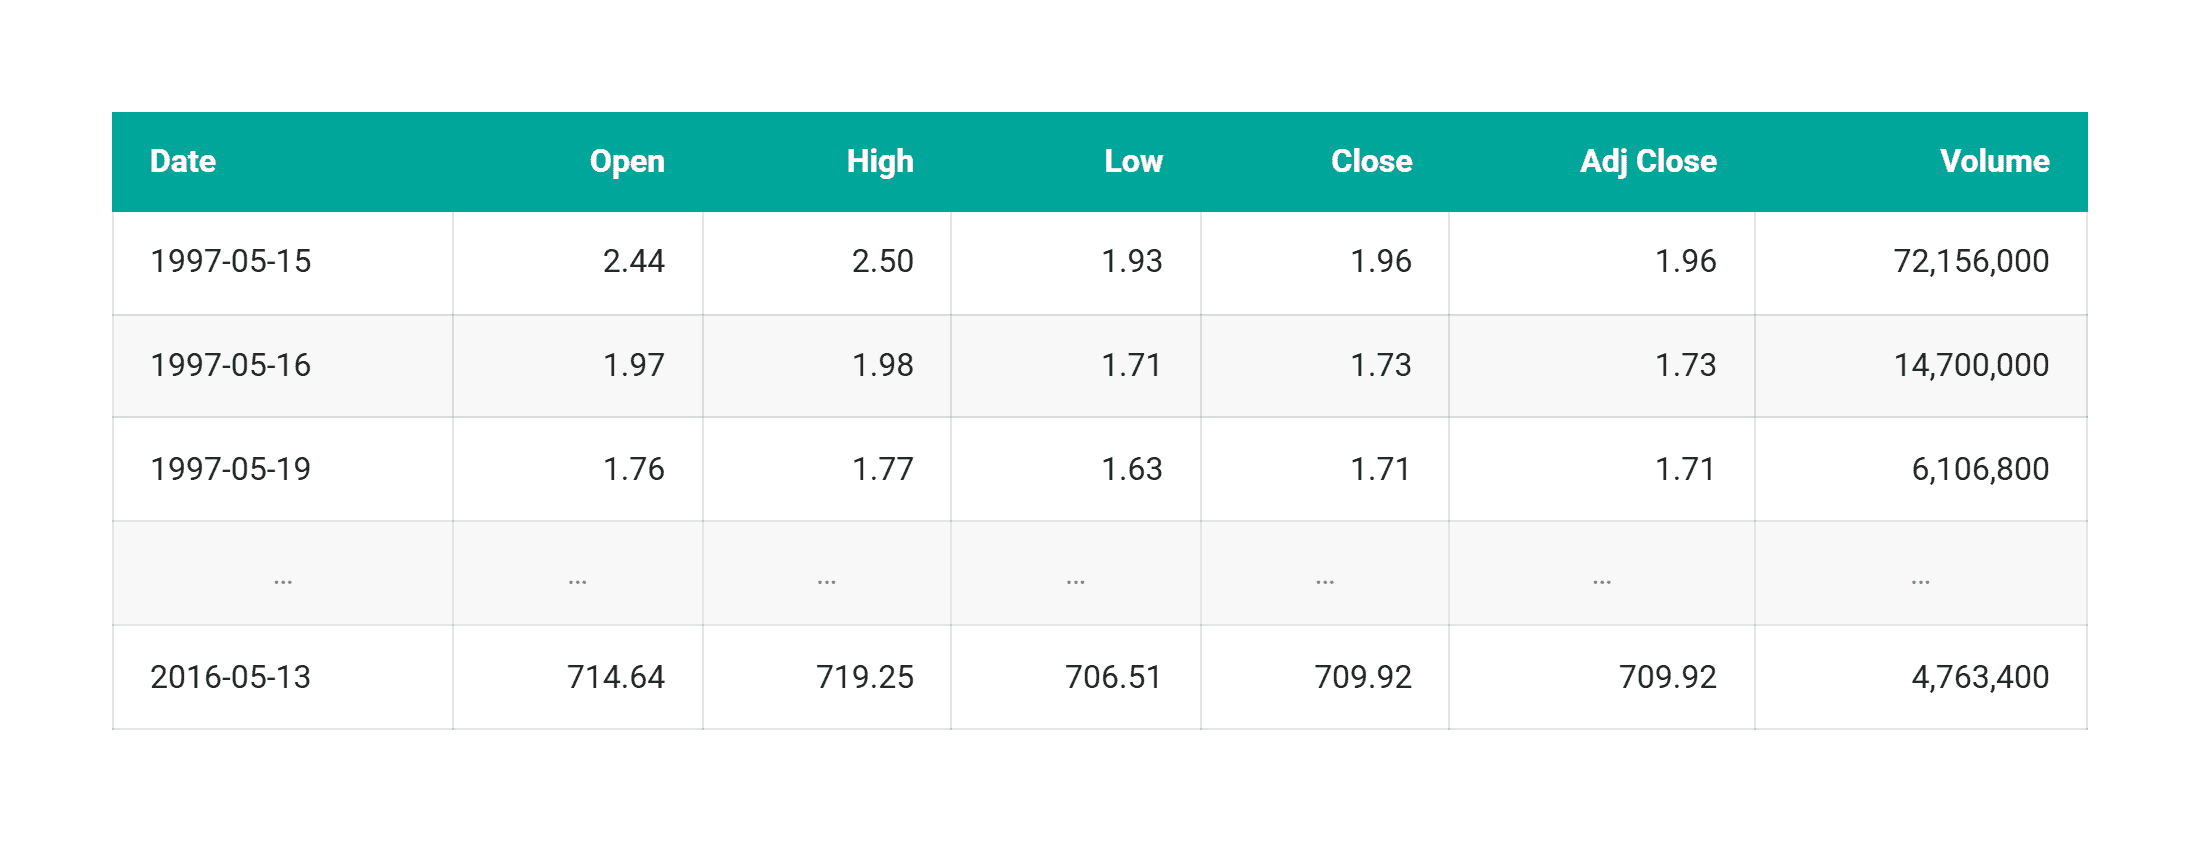
สำหรับกรณีนี้ เราใช้ชุดข้อมูลจากโปรเจกต์ Prediction of Stock Price Direction โดยงานคือพยากรณ์ว่าราคาปิด (closing price) ของ Amazon จะสูงกว่าราคาเปิด (opening price) ของวันเดียวกันหรือไม่
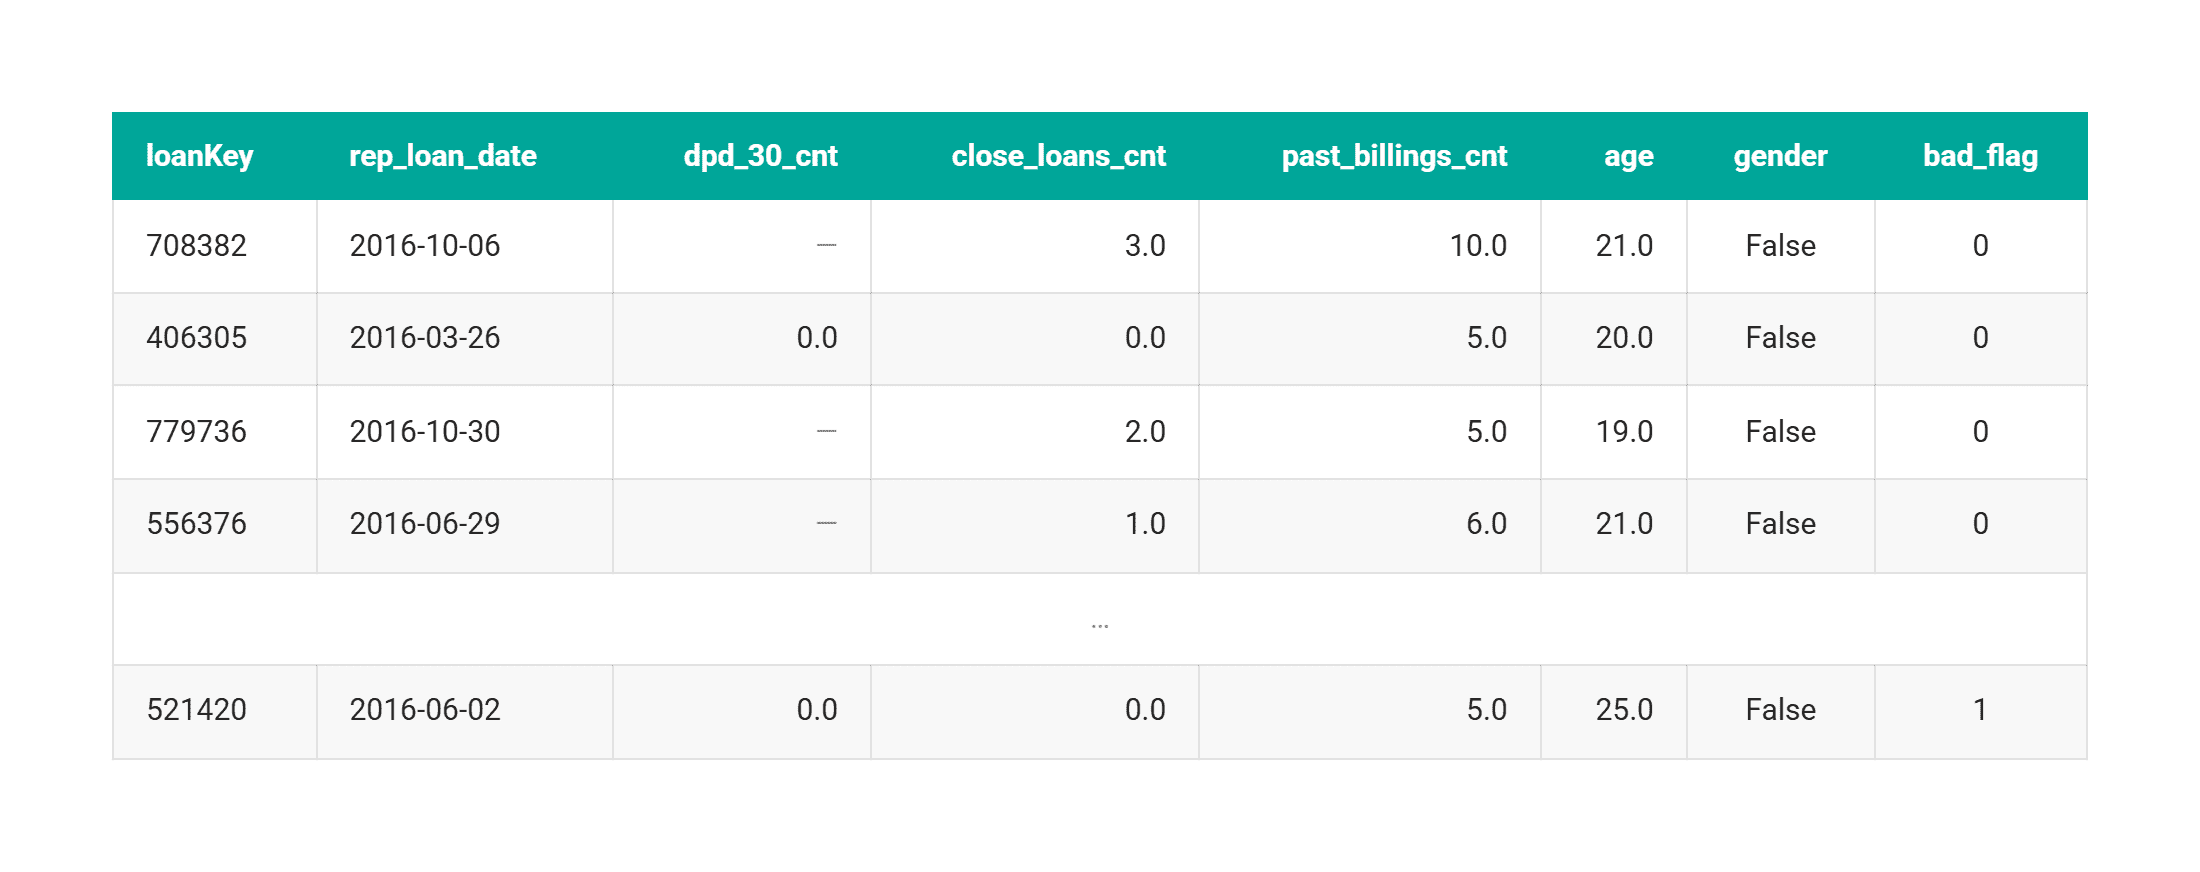
นี่คือตัวอย่างหนึ่งของชุดข้อมูลในไฟล์ AMZN_train.csv:
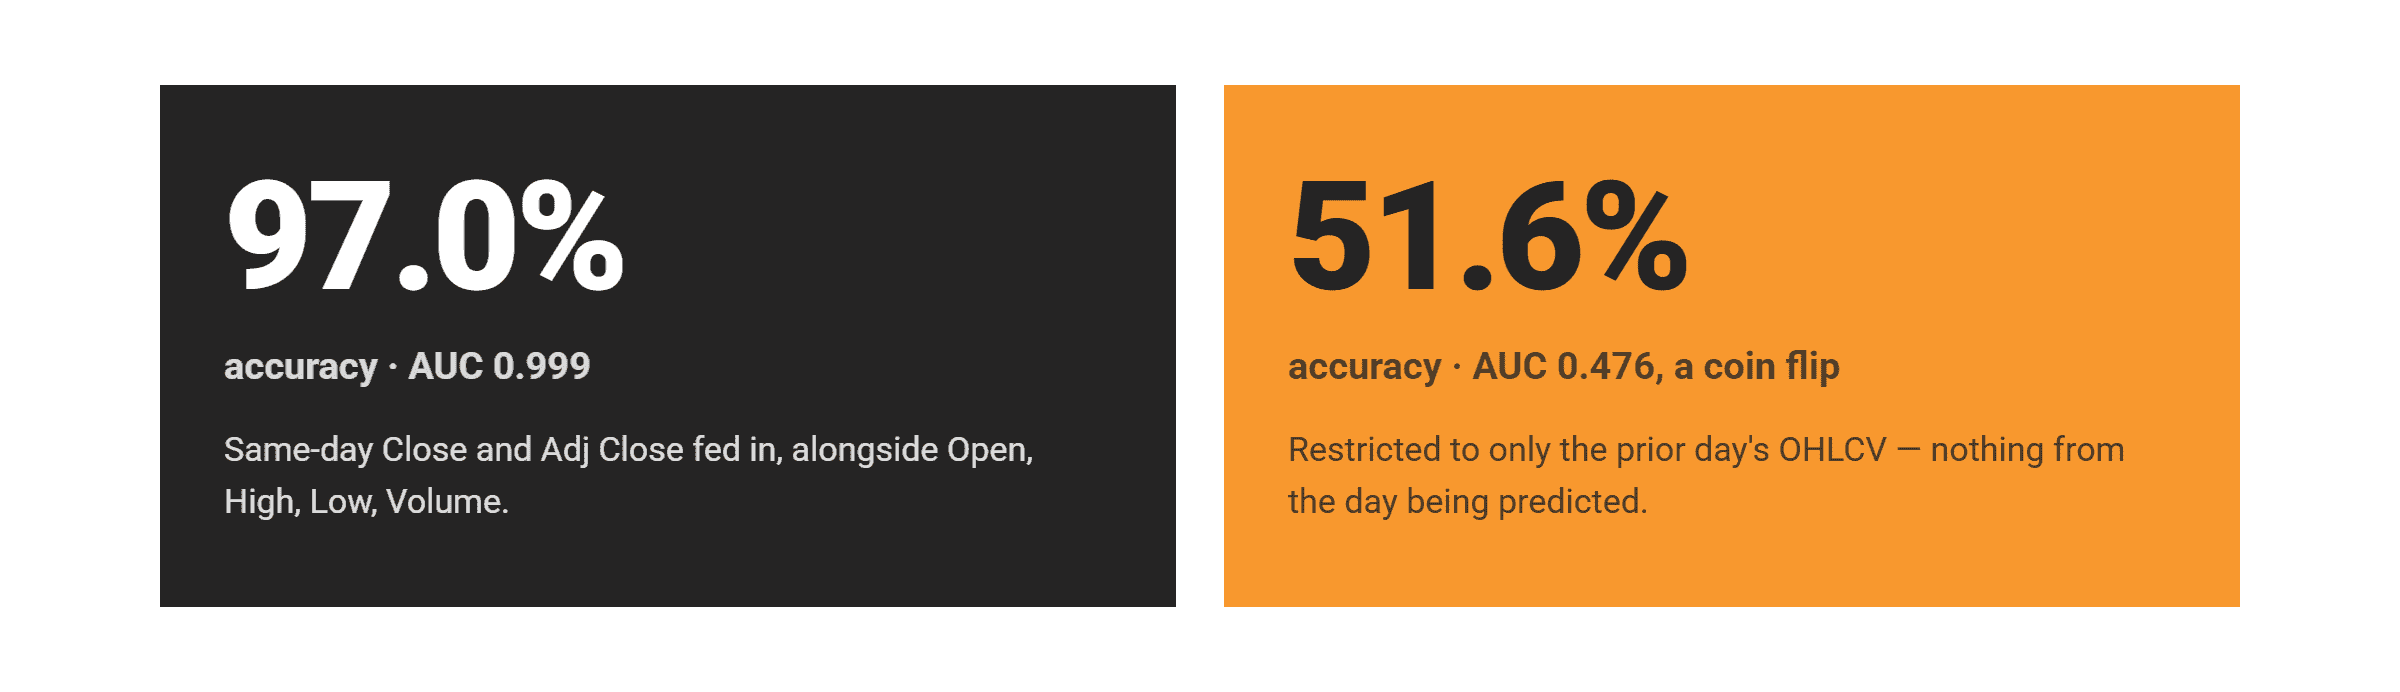
การเปรียบเทียบประสิทธิภาพระหว่างแบบที่รั่วไหลและไม่รั่วไหล
หากป้อน Close และ Adj Close ของวันเดียวกันให้โมเดล ความแม่นยำในการทดสอบ (validation accuracy) จะพุ่งสูงถึง 97.0% โดยมี AUC อยู่ที่ 0.999 แต่ถ้าจำกัดให้เห็นเฉพาะข้อมูลของวันก่อนหน้า ความแม่นยำจะลดลงเหลือ 51.6% และ AUC 0.476 ซึ่งเท่ากับการสุ่มเหรียญหัวก้อย ส่วนต่างมหาศาลนี้คือประเด็นสำคัญของความผิดปกติ
ตรวจสอบสิ่งที่ AI พบ
ทั้ง 4 โมเดลตรวจพบได้ทันทีว่า Close เป็นตัวกำหนด label โดย Haiku เรียกสิ่งนี้ว่า "การคิดแบบเป็นวงกลม (circular)" ขณะที่ Sonnet ระบุว่าโมเดลสามารถสร้าง label ใหม่ได้จากการเปรียบเทียบเพียงครั้งเดียว
ด้าน Opus วิเคราะห์ลึกไปกว่านั้นโดยชี้ให้เห็นว่า หาก High เท่ากับ Open แสดงว่าวันนั้นราคาไม่เคยสูงกว่าราคาเปิด label จึงต้องเป็น 0 แน่นอน พร้อมทั้งคาดการณ์ว่าโมเดลที่ยุติธรรมควรมีความแม่นยำเพียง 50 ต้นๆ ซึ่งตรงกับผลลัพธ์จริงในรอบที่ข้อมูลสะอาด
กรณีที่ 2: ชุดข้อมูลที่บอกคุณแล้วว่าเส้นแบ่งอยู่ตรงไหน
กรณีนี้ใช้ชุดข้อมูลจากโปรเจกต์ Delivery Duration Prediction เพื่อพยากรณ์ duration_sec หรือระยะเวลาตั้งแต่สั่งซื้อจนถึงจัดส่งของ DoorDash
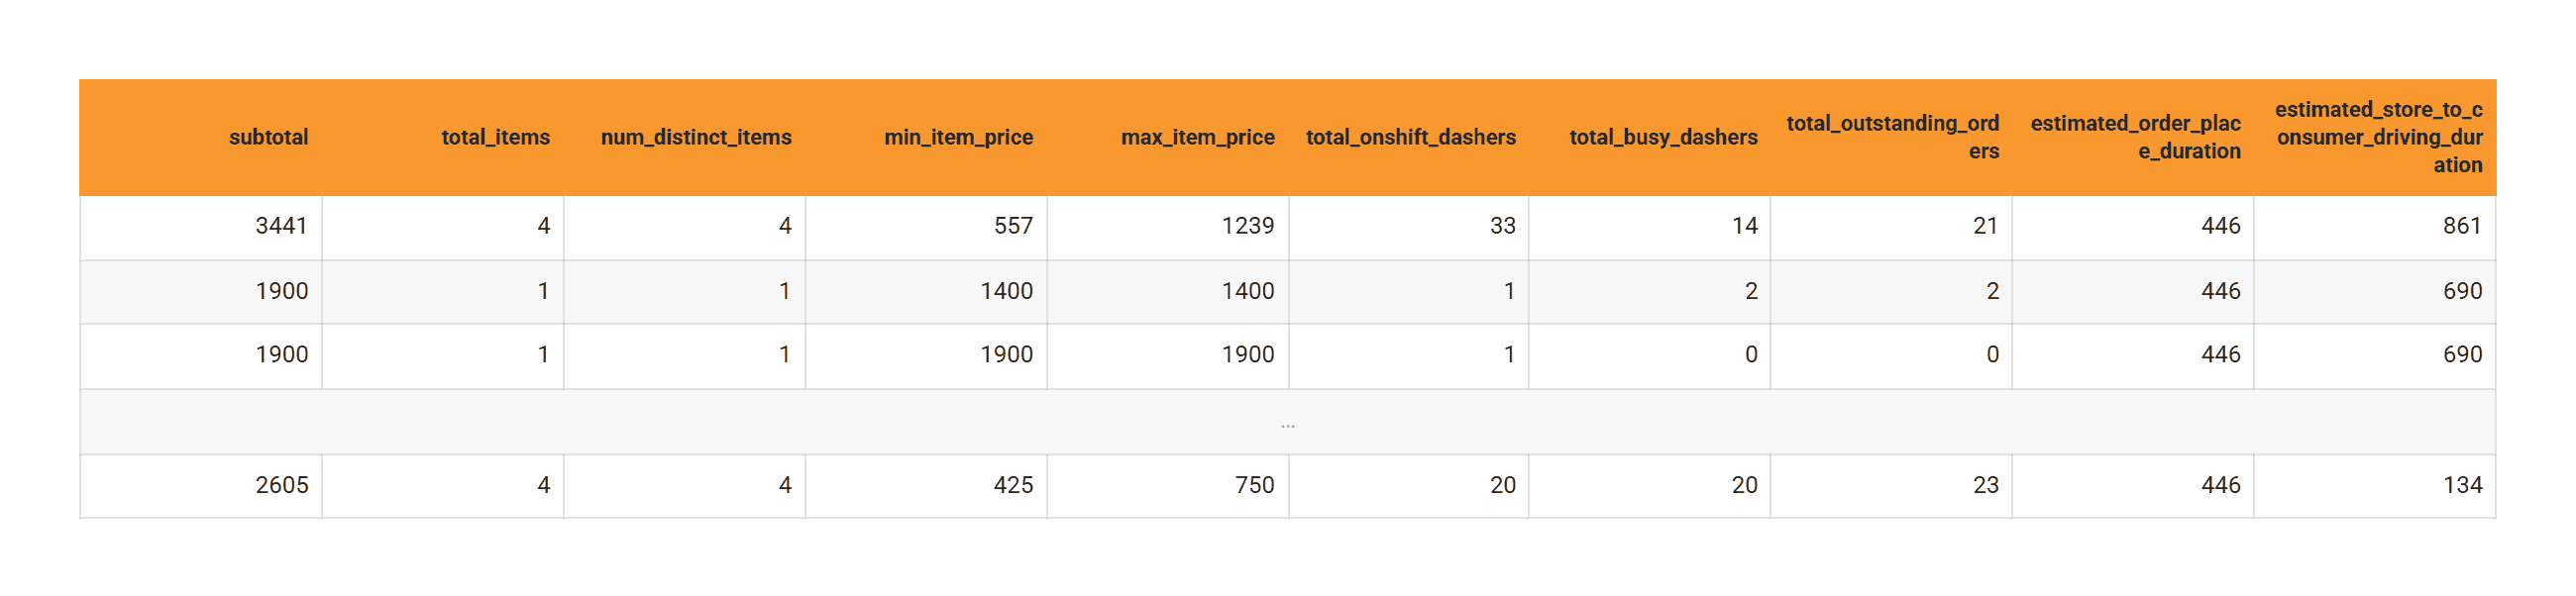
เราได้เพิ่ม feature ที่สร้างขึ้นมาหนึ่งตัว คือค่าเฉลี่ยระยะเวลาจัดส่งของร้าน ซึ่งคำนวณได้สองวิธี:
# leaked: ใช้ทุกแถว รวมถึงแถวที่กำลังจะถูกวัดคะแนน
store_avg = df.groupby("store_id")["duration_sec"].transform("mean")
df_shuffled = df.sample(frac=1.0)  # สุ่มแบ่งข้อมูลบนข้อมูลที่มีไทม์สแตมป์

# clean: ใช้เฉพาะคำสั่งซื้อในช่วงเวลาเทรนเท่านั้น แล้วจึงแบ่งตามลำดับเวลา
store_avg = train.groupby("store_id")["duration_sec"].mean()
train["store_avg"] = train["store_id"].map(store_avg)
test["store_avg"] = test["store_id"].map(store_avg)
Feature นี้มีการรั่วไหลสองจุด จุดแรกคือการรวมกลุ่มทั้งตารางทำให้โมเดลอ่านคำตอบที่ถูกเกลี่ยค่ามาแล้ว จุดที่สองคือการสลับข้อมูล (shuffling) ที่มีไทม์สแตมป์ก่อนแบ่งข้อมูล ทำให้ข้อมูลในอนาคตหลุดเข้าไปอยู่ในชุดเทรน
การเปรียบเทียบประสิทธิภาพระหว่างแบบที่รั่วไหลและไม่รั่วไหล
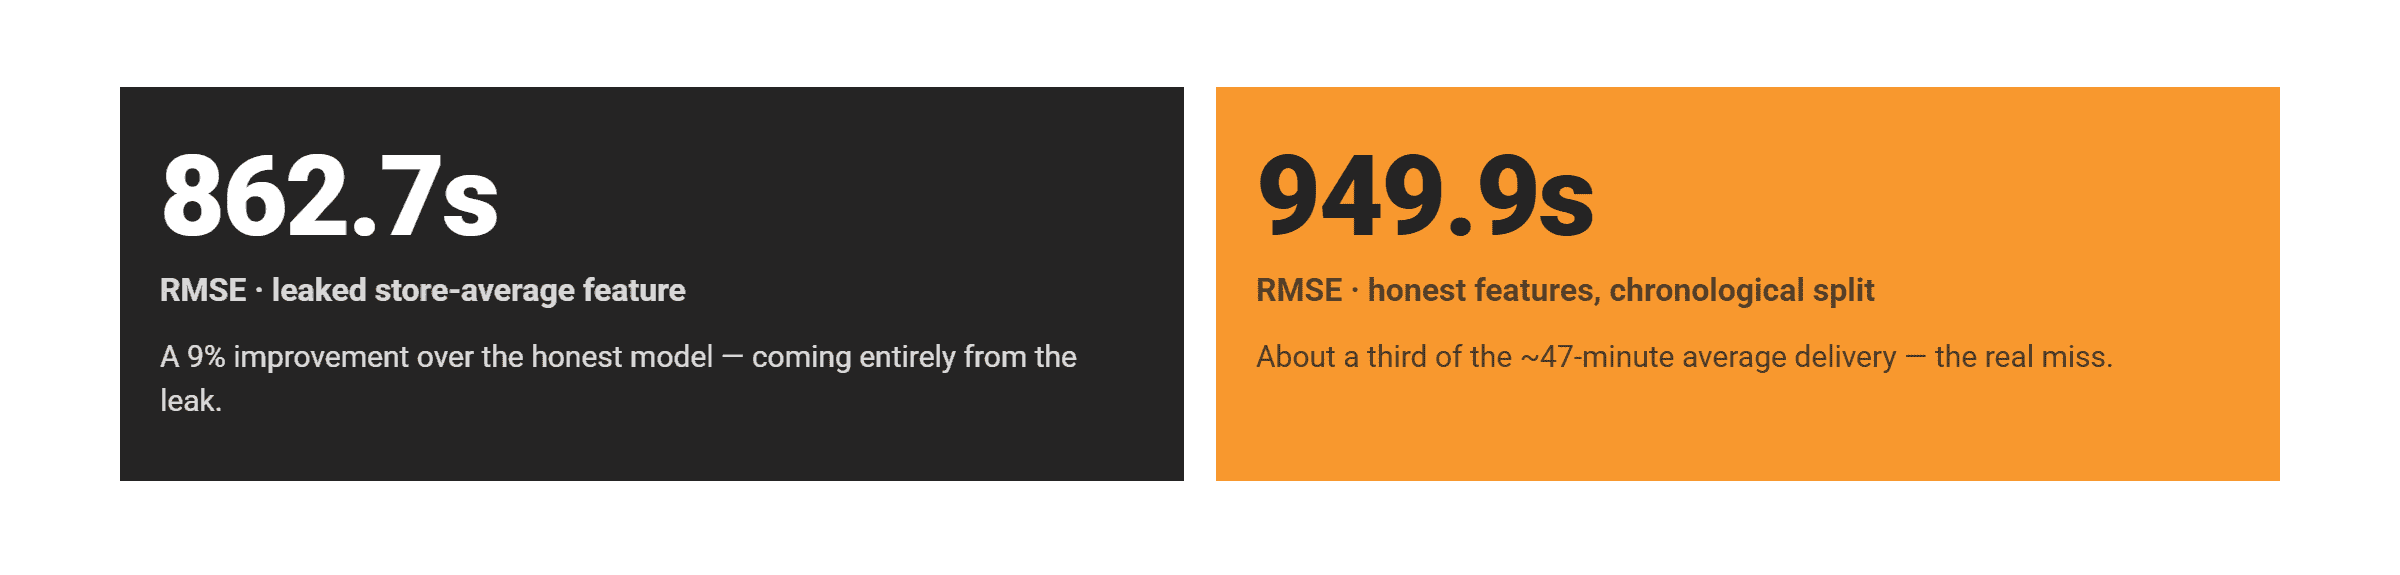
เวอร์ชันที่มีการรั่วไหลมีค่า RMSE อยู่ที่ 862.7 วินาที เทียบกับ 949.9 วินาทีในเวอร์ชันที่ซื่อสัตย์ แม้จะดูดีขึ้น 9% แต่ความก้าวหน้านี้เกิดจากการรั่วไหล ไม่ใช่การเรียนรู้ที่แท้จริง
ตรวจสอบสิ่งที่ AI พบ
ทุกโมเดลตรวจพบการรั่วไหลของค่าเฉลี่ยร้านค้า แต่มีเพียง Sonnet, Opus และ Fable ที่พบปัญหาเรื่องการสลับตารางไทม์สแตมป์ โดย Fable อธิบายชัดเจนว่าชุดเทรนอาจมีคำสั่งซื้อที่เกิดขึ้นหลังชุดทดสอบ ส่วน Opus เสริมเรื่องการใช้เกณฑ์พื้นฐาน (baseline) ในการเปรียบเทียบค่า RMSE ให้ชัดเจนขึ้น
กรณีที่ 3: การรั่วไหลที่คุณมองไม่เห็นในคอลัมน์เดียว
ใช้ชุดข้อมูลจากโปรเจกต์ Fraudsters Detection (Revolut) เพื่อพยากรณ์การฉ้อโกงรายผู้ใช้ โดยข้อมูลมีโครงสร้างแบบหนึ่งรายชื่อต่อหลายธุรกรรม
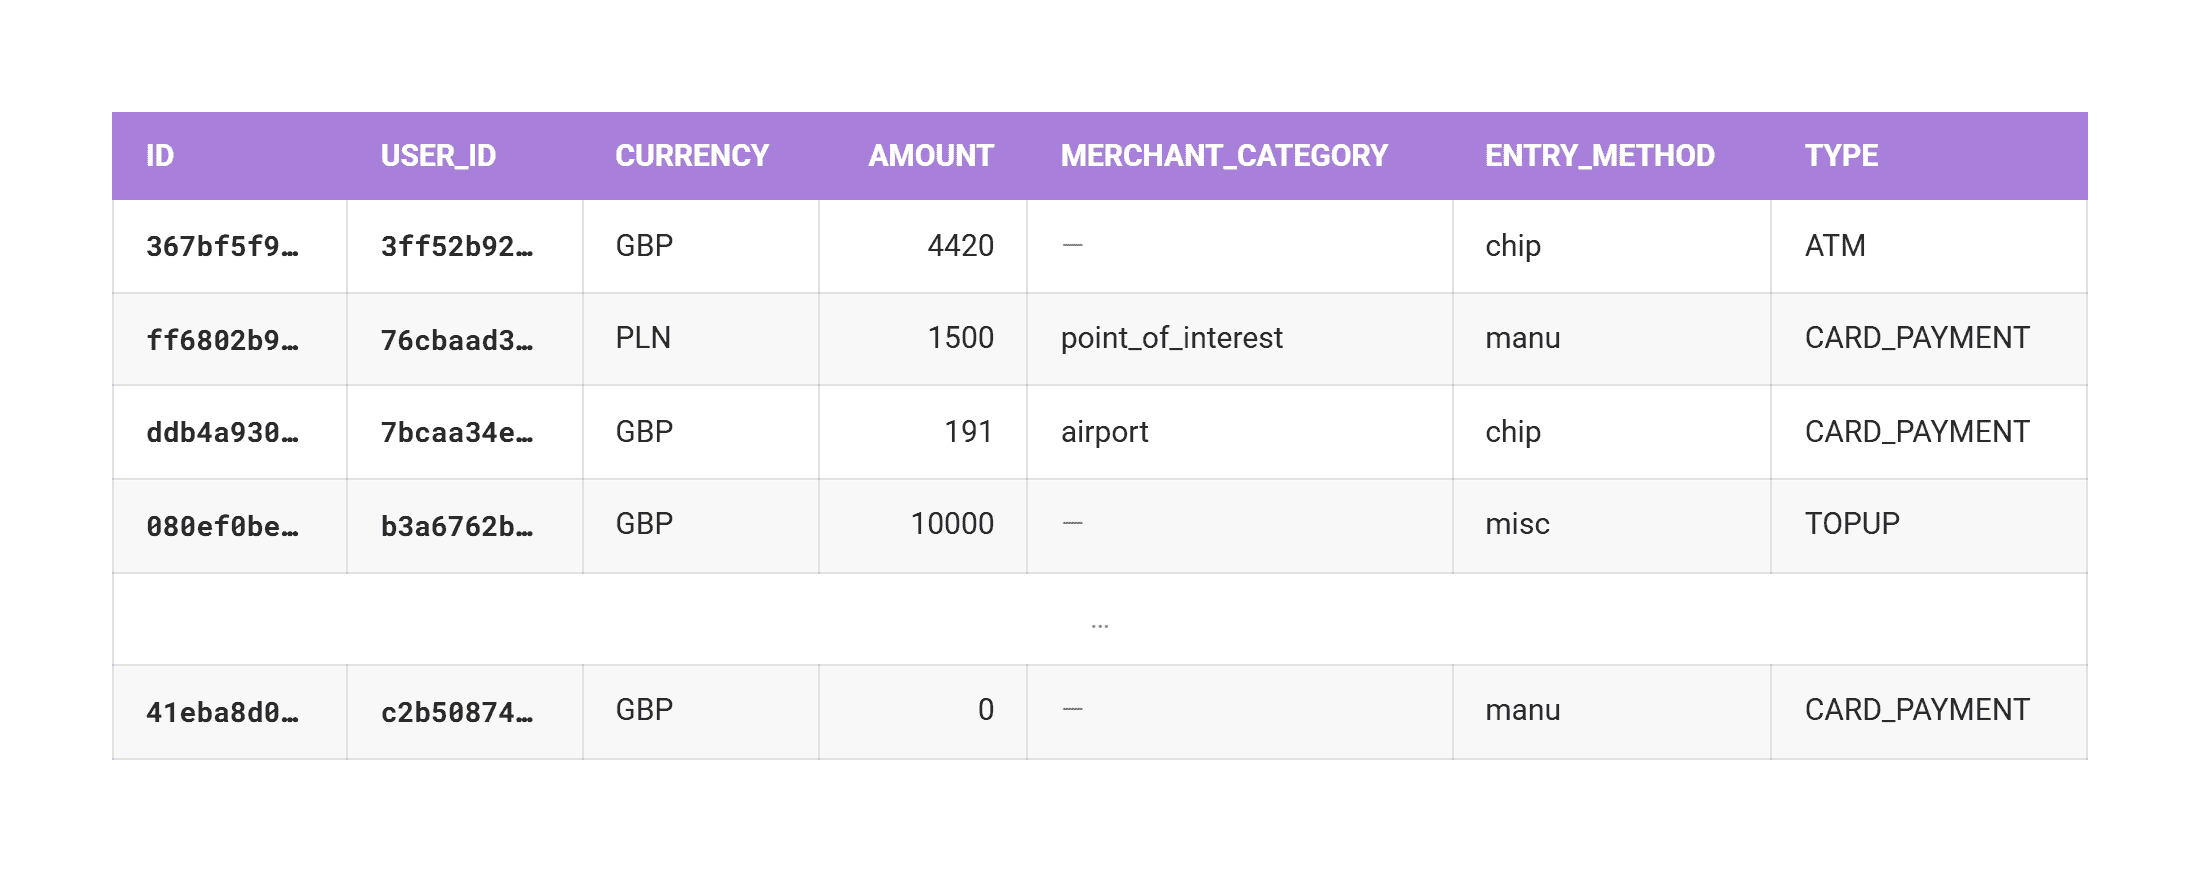
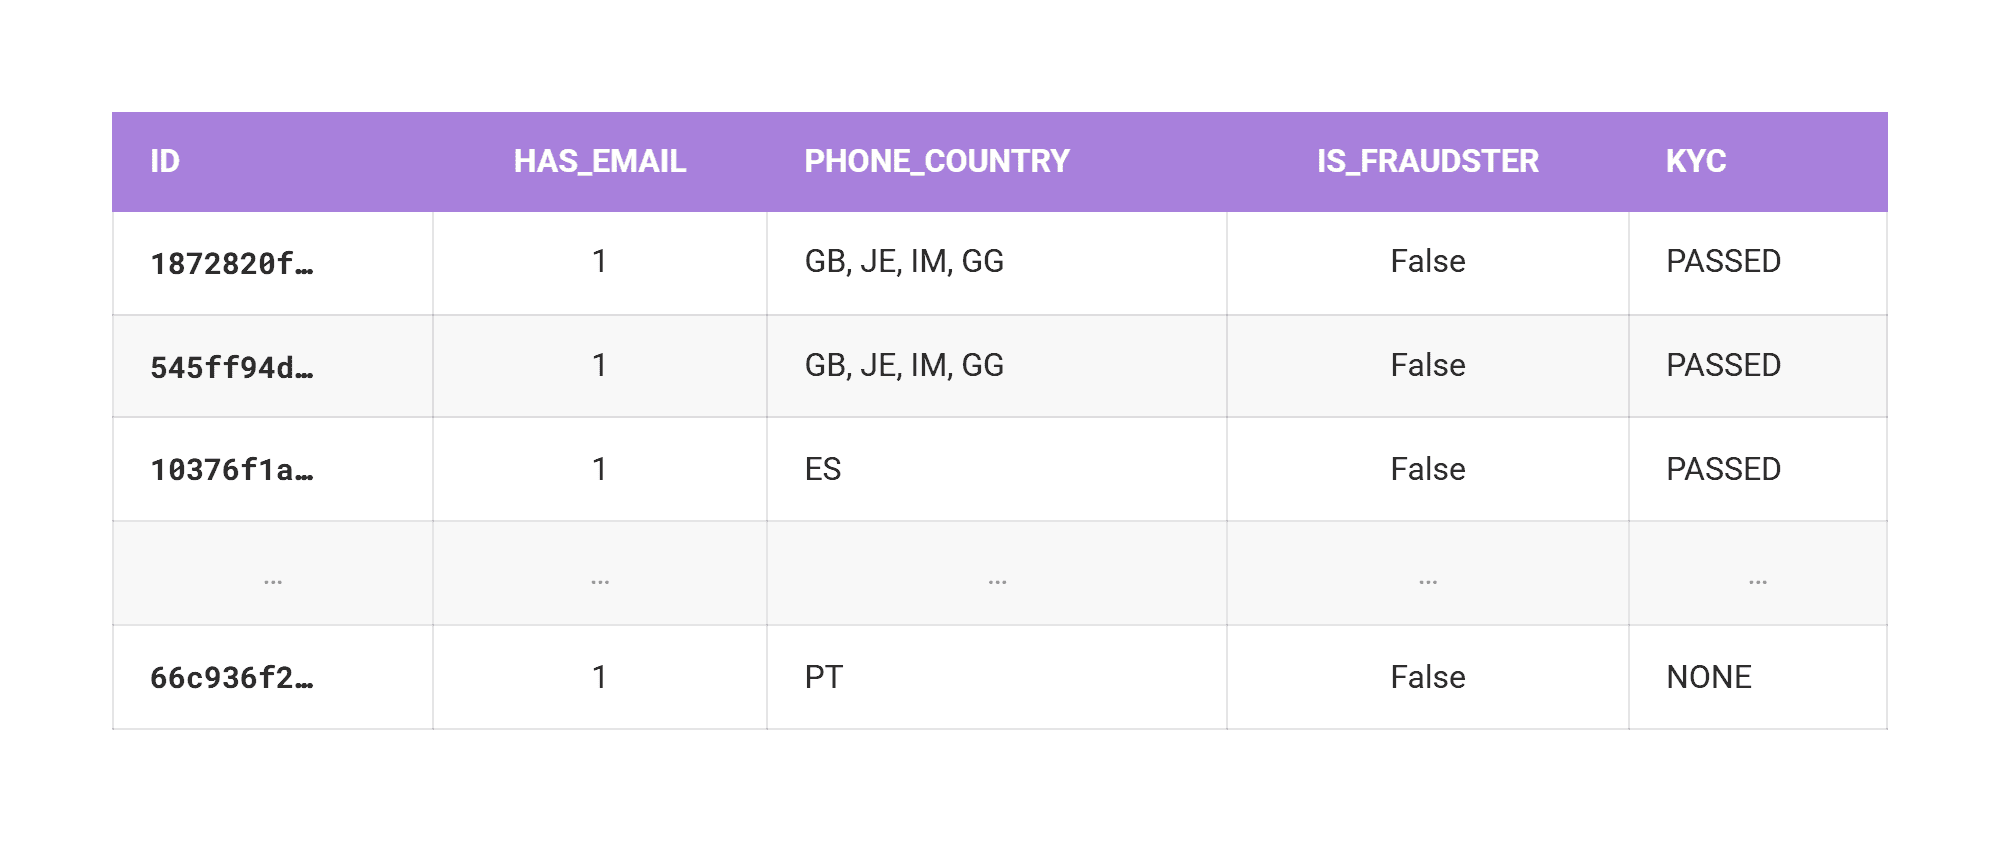
ปัญหาเกิดขึ้นเมื่อแบ่งข้อมูลระดับธุรกรรมแบบสุ่ม ทำให้ผู้ใช้รายเดิมปรากฏทั้งในชุดเทรนและชุดทดสอบ โมเดลจึงจดจำผู้ใช้ได้แทนที่จะเป็นการเรียนรู้พฤติกรรมการฉ้อโกง
การเปรียบเทียบประสิทธิภาพระหว่างแบบที่รั่วไหลและไม่รั่วไหล
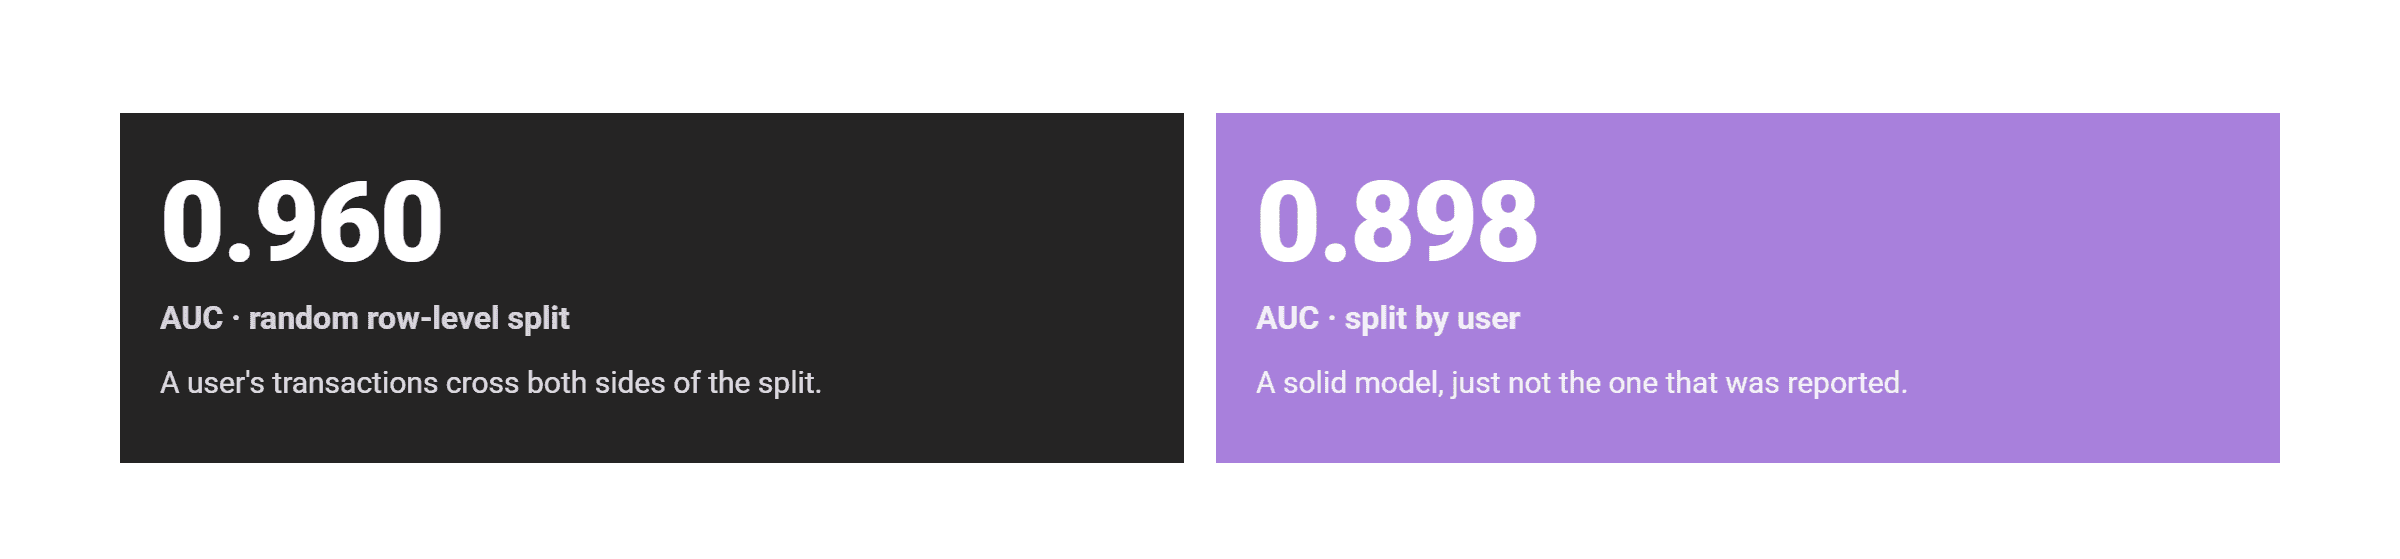
โมเดลที่รั่วไหลได้ AUC 0.960 แต่หากแบ่งข้อมูลตามรายผู้ใช้ให้ถูกต้อง ค่า AUC ที่แท้จริงจะอยู่ที่ 0.898 ซึ่งถือว่าแข็งแกร่งแต่ไม่เท่ากับตัวเลขแรกที่รายงาน
ตรวจสอบสิ่งที่ AI พบ
ทั้ง 4 โมเดลระบุปัญหาการแบ่งข้อมูลระดับแถวธุรกรรมได้อย่างถูกต้อง โดย Opus ให้คำตอบสมบูรณ์ที่สุดว่ากลุ่มตัวอย่างควรเป็นรายผู้ใช้ ไม่ใช่รายธุรกรรม และยังชี้ให้เห็นว่าฟิลด์สถานะบัญชีที่เกิดขึ้นหลังการตรวจสอบการฉ้อโกงก็ถือเป็นการรั่วไหลเช่นกัน
กรณีที่ 4: การรั่วไหลที่ไม่ได้อยู่ในข้อมูลเลย
ใช้ชุดข้อมูล Flagging Loans (Chime) เพื่อพยากรณ์หนี้เสีย โดยทดสอบผ่านโค้ดสั้นๆ โดยไม่มีข้อมูลตัวเลขประกอบ:
X_bal, y_bal = oversample(X, y)  # คัดลอกแถวกลุ่มน้อยก่อน
X_train, X_test, y_train, y_test = train_test_split(
    X_bal,
    y_bal,
    stratify=y_bal
)
การเปรียบเทียบประสิทธิภาพระหว่างแบบที่รั่วไหลและไม่รั่วไหล
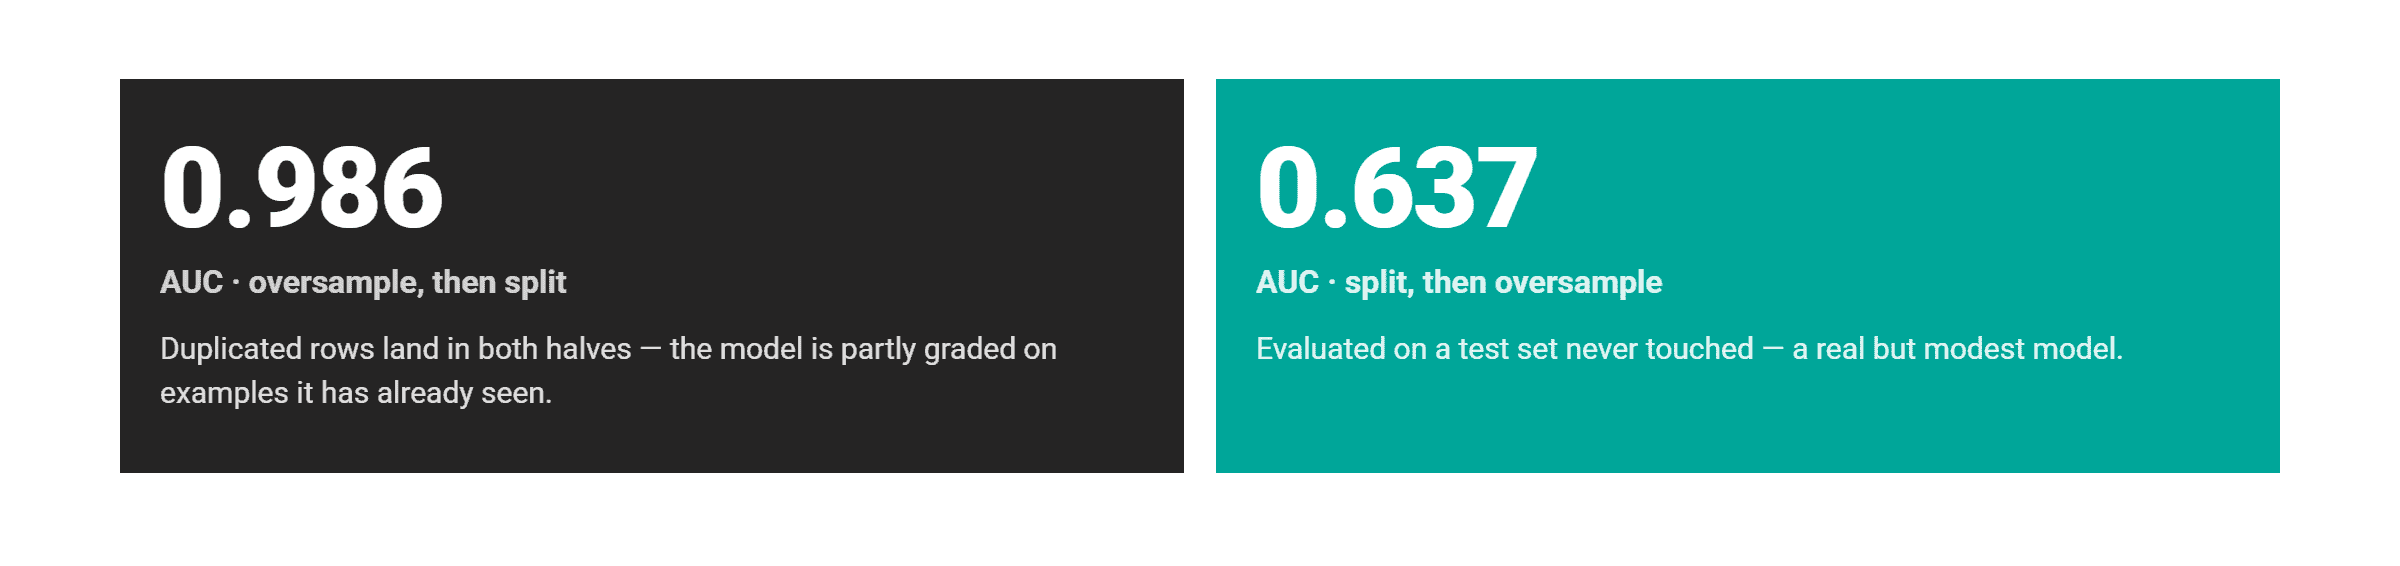
วิธี Oversample ก่อนแบ่งข้อมูลให้ค่า AUC 0.986 แต่เมื่อสลับลำดับเป็นแบ่งข้อมูลก่อนทำ oversample ค่า AUC จะเหลือเพียง 0.637 เนื่องจากในวิธีแรกสำเนาข้อมูลที่เหมือนกันหลุดเข้าไปอยู่ในทั้งสองฝั่ง ทำให้โมเดลได้คะแนนจากสิ่งที่เคยเห็นมาแล้ว
ตรวจสอบสิ่งที่ AI พบ
โมเดลทั้ง 4 ตรวจพบความผิดปกตินี้ได้ทันทีจากโค้ดเพียงอย่างเดียว โดย Opus ชี้ให้เห็นว่าการทำ stratify บนข้อมูลที่สมดุลแล้วไม่มีประโยชน์ และยังตั้งคำถามถึงความเหมาะสมของการทำ oversampling เมื่อเทียบกับวิธีอื่นๆ
สรุป: สิ่งที่ทุกโมเดลตรวจพบ
ในการทดลองนี้ ทุกโมเดลรวมถึงรุ่นที่เร็วและถูกที่สุด สามารถตรวจพบการรั่วไหลที่ฝังไว้ได้ทุกกรณีเมื่อถูกขอให้ตรวจสอบ pipeline โดยตรง
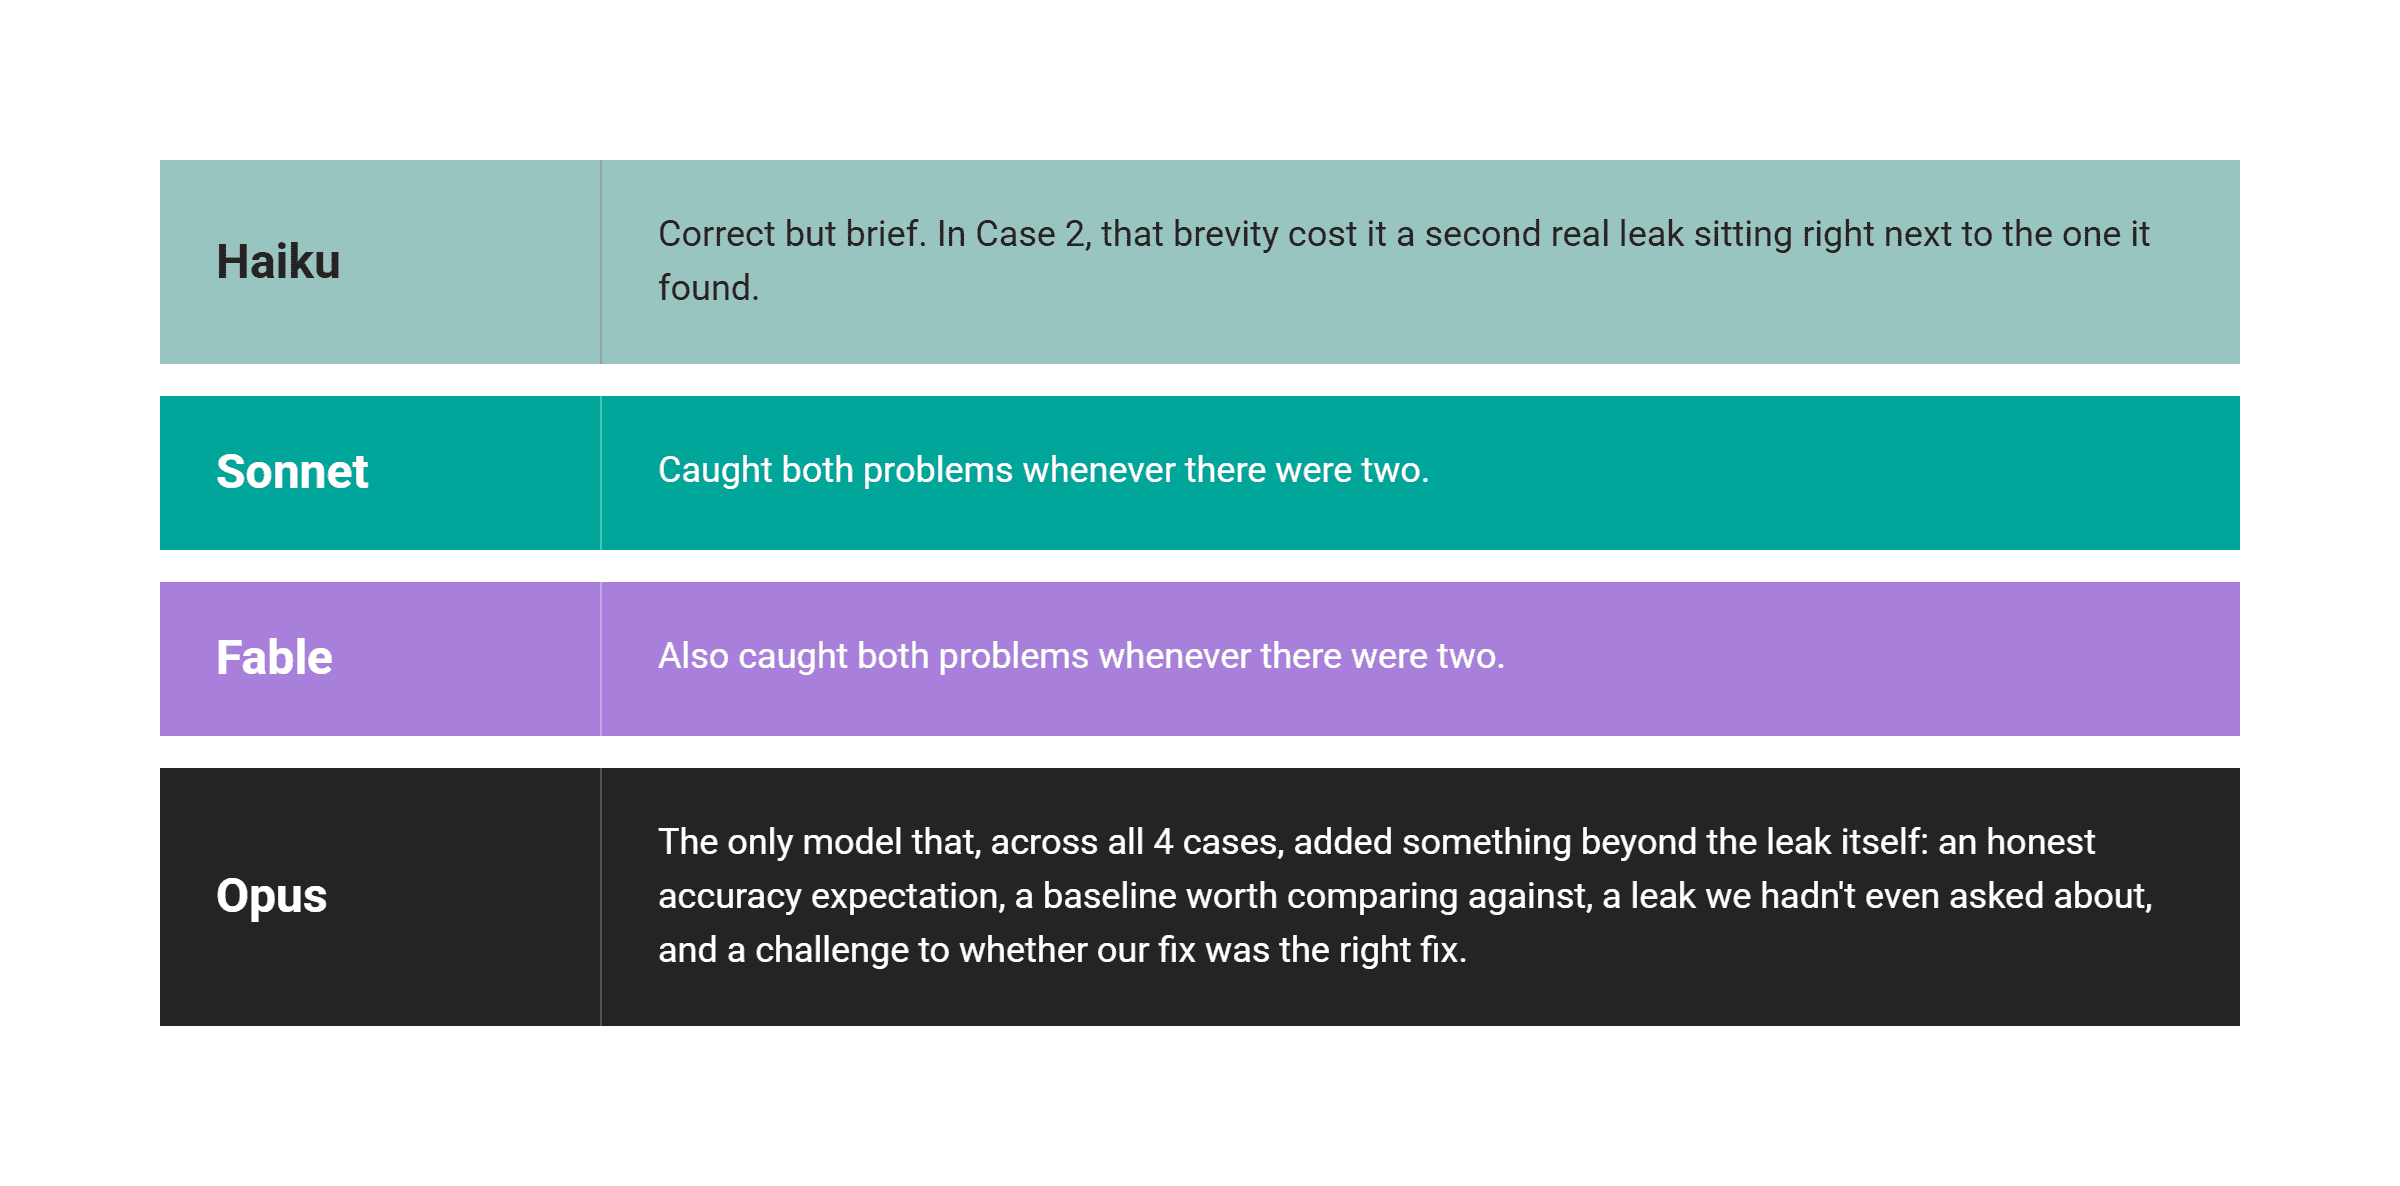
ความแตกต่างสำคัญอยู่ที่รายละเอียดเพิ่มเติม โดย Haiku จะตอบกระชับจนอาจพลาดจุดย่อยที่อยู่ติดกัน ขณะที่ Sonnet และ Fable ตรวจพบปัญหาคู่เสมอ ส่วน Opus โดดเด่นที่สุดในการวิเคราะห์บริบทที่เหนือกว่าการตรวจจับ เช่น การท้าทายวิธีการแก้ไขและตั้งเกณฑ์เปรียบเทียบที่สมเหตุสมผล
การใช้ AI ตรวจสอบ pipeline ก่อนเชื่อตัวเลขผลลัพธ์เป็นวิธีที่รวดเร็วและมีประสิทธิภาพสูง โดยความละเอียดของการตรวจพบจะขึ้นอยู่กับรุ่นของโมเดลและขอบเขตของ pipeline ที่เราอนุญาตให้ AI มองเห็น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร