
ความท้าทายและการพัฒนามาตรฐาน Red Teaming สำหรับระบบ AI
ในบทความนี้ เราจะลงรายละเอียดข้อมูลเชิงลึกจากตัวอย่างแนวทางการทำ red teaming ที่เราใช้เพื่อทดสอบระบบ AI ของเรา จากการปฏิบัติจริง เราได้รวบรวมข้อมูลเชิงประจักษ์เกี่ยวกับเครื่องมือที่เหมาะสมในแต่ละสถานการณ์ รวมถึงวิเคราะห์ประโยชน์และความท้าทายของแต่ละวิธี เราหวังว่าโพสต์นี้จะเป็นประโยชน์สำหรับบริษัทที่กำลังพัฒนาเทคโนโลยี AI ผู้กำหนดนโยบายที่สนใจกระบวนการทำงานจริง และองค์กรที่ต้องการประเมินความปลอดภัยของระบบ AI
Red teaming คืออะไร?
Red teaming คือเครื่องมือสำคัญในการยกระดับความปลอดภัยและความมั่นคงของระบบ AI โดยใช้วิธีทดสอบเชิงรุก (adversarially testing) เพื่อค้นหาจุดอ่อนที่อาจแฝงอยู่ ปัจจุบันนักวิจัยและนักพัฒนา AI ใช้เทคนิคที่หลากหลายซึ่งต่างก็มีข้อดีและข้อเสียเฉพาะตัว
อย่างไรก็ตาม การขาดมาตรฐานที่ชัดเจนในการทำ AI red teaming ทำให้สถานการณ์ซับซ้อนขึ้น นักพัฒนาอาจเลือกใช้เทคนิคที่ต่างกันแม้จะประเมินความเสี่ยงประเภทเดียวกัน และวิธีการดำเนินการในทางปฏิบัติก็อาจแตกต่างกันอย่างมาก ความไม่สอดคล้องกันนี้ทำให้การเปรียบเทียบความปลอดภัยระหว่างระบบ AI ต่างๆ อย่างเป็นธรรมทำได้ยาก
วงการ AI จึงจำเป็นต้องมีแนวทางปฏิบัติและมาตรฐานที่เป็นระบบสำหรับการทำ red teaming ซึ่งเราเชื่อว่าการเริ่มสร้างมาตรฐานตั้งแต่วันนี้เป็นเรื่องสำคัญ เพื่อให้องค์กรพร้อมจัดการความเสี่ยงในปัจจุบันและรับมือภัยคุกคามในอนาคตเมื่อโมเดลเก่งขึ้น เราได้สรุปวิธี red teaming ที่เราใช้และแสดงให้เห็นการบูรณาการเข้ากับกระบวนการแบบวนซ้ำ (iterative process) พร้อมข้อเสนอแนะสำหรับผู้กำหนดนโยบายเพื่อสร้างระบบนิเวศการทดสอบ AI ที่แข็งแกร่ง
วิธีการ red teaming ที่โพสต์นี้ครอบคลุม:
การทำ red teaming โดยผู้เชี่ยวชาญเฉพาะด้าน (Domain-specific, expert red teaming)
- Trust & Safety: การทดสอบความเปราะบางด้านนโยบาย (Policy Vulnerability Testing)
- ความมั่นคงแห่งชาติ: การทำ red teaming สำหรับภัยคุกคามระดับสูง (Frontier threats red teaming)
- เฉพาะภูมิภาค: การทำ red teaming หลากภาษาและพหุวัฒนธรรม
การใช้โมเดลภาษาในการทำ red team
- การทำ red teaming แบบอัตโนมัติ (Automated red teaming)
การทำ red teaming ในรูปแบบใหม่ๆ (New modalities)
- Multimodal red teaming
การทำ red teaming ทั่วไปแบบปลายเปิด
- การทำ red teaming แบบ Crowdsourced สำหรับอันตรายทั่วไป
- การทำ red teaming โดยชุมชนสำหรับความเสี่ยงทั่วไปและข้อจำกัดของระบบ
ในส่วนถัดไป เราจะเจาะลึกวิธีการแต่ละประเภท โดยพิจารณาถึงข้อดีและความท้าทายเฉพาะตัวที่เกิดขึ้น
การทำทีมโดยผู้เชี่ยวชาญเฉพาะด้าน (Domain-specific, expert teaming)
การร่วมมือกับผู้เชี่ยวชาญในเนื้อหานั้นๆ ช่วยให้เราสามารถระบุและประเมินความเสี่ยงเชิงลึกในสาขาที่ซับซ้อนและเฉพาะเจาะจงตามบริบทได้ดีกว่าการทดสอบทั่วไป
การทดสอบความเปราะบางด้านนโยบายสำหรับความเสี่ยงด้าน Trust & Safety
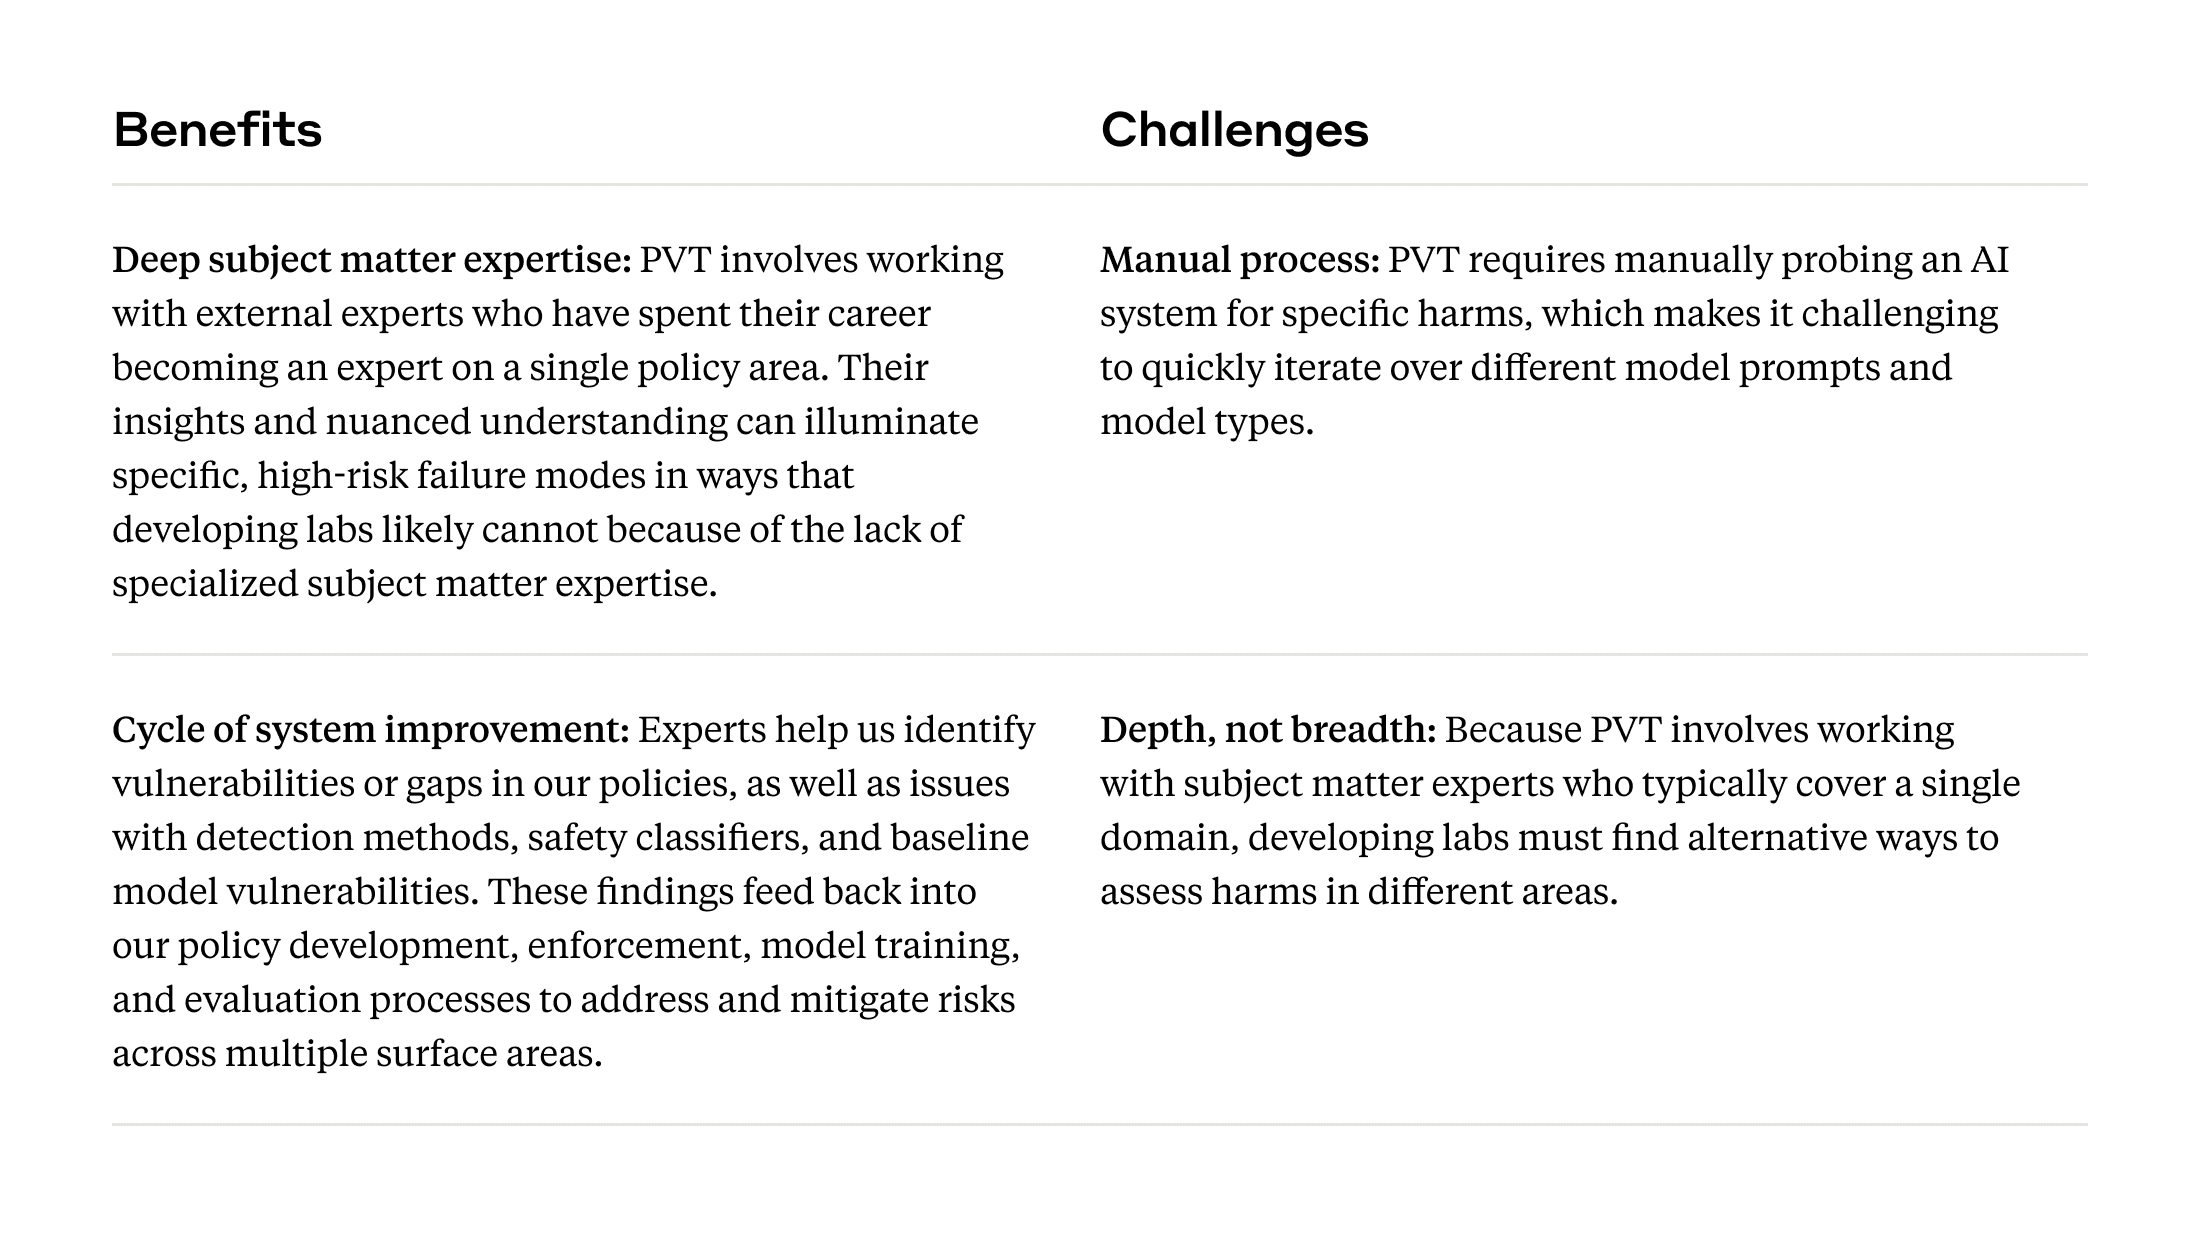
ภัยคุกคามที่มีความเสี่ยงสูง เช่น สิ่งที่ก่ออันตรายร้ายแรงต่อบุคคลหรือสังคม จำเป็นต้องใช้การร่วมมือกับผู้เชี่ยวชาญภายนอกผ่านรูปแบบ “Policy Vulnerability Testing” (PVT) ซึ่งเป็นการทดสอบเชิงคุณภาพเชิงลึกตามหัวข้อใน Usage Policy ของเรา เราได้ร่วมงานกับองค์กรอย่าง Thorn ด้านความปลอดภัยของเด็ก, Institute for Strategic Dialogue ด้าน ความสมบูรณ์ของการเลือกตั้ง, และ Global Project Against Hate and Extremism ในเรื่องการป้องกันแนวคิดสุดโต่ง
การทำ red teaming สำหรับภัยคุกคามระดับสูงต่อความมั่นคงแห่งชาติ
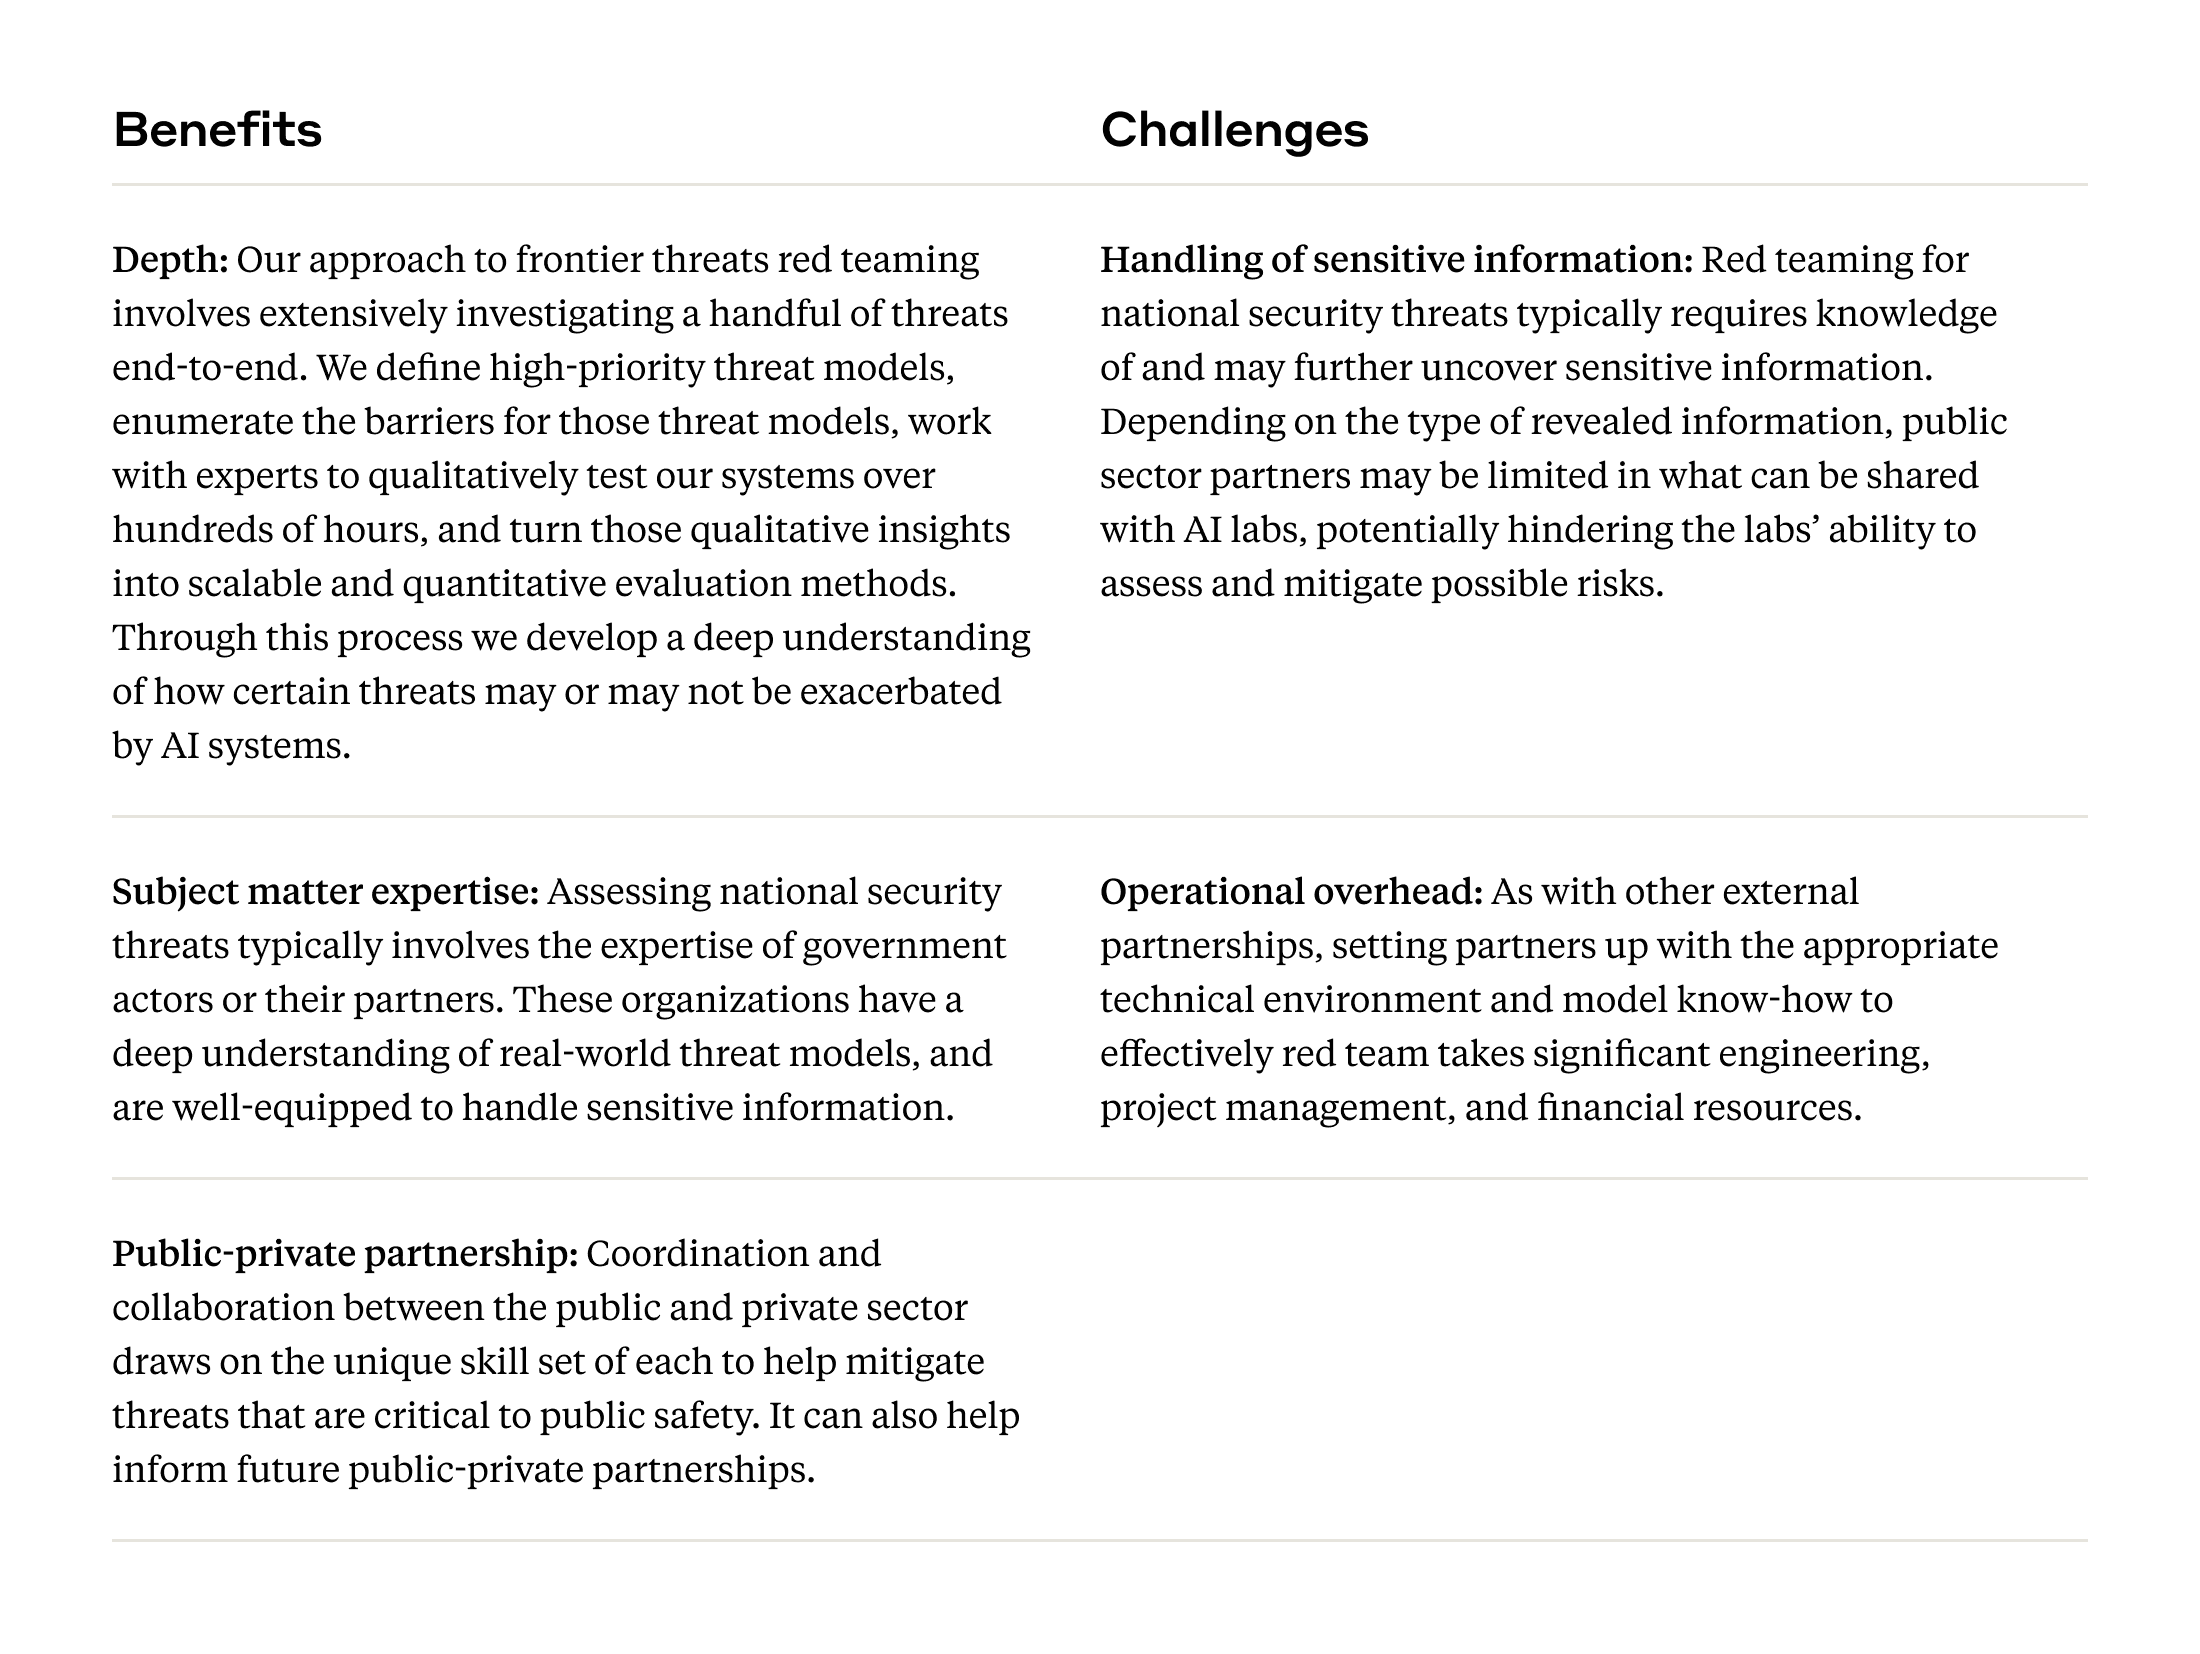
นับตั้งแต่เผยแพร่ บล็อกโพสต์ เกี่ยวกับความเสี่ยงด้านความมั่นคงแห่งชาติ เราได้พัฒนาเทคนิคการประเมิน “frontier threats” อย่างต่อเนื่อง ครอบคลุมด้านเคมี ชีวภาพ รังสี นิวเคลียร์ (CBRN), ความมั่นคงปลอดภัยไซเบอร์ และความเสี่ยงจาก AI อิสระ โดยร่วมมือกับผู้เชี่ยวชาญทดสอบทั้งใน Claude เวอร์ชันมาตรฐานและเวอร์ชันพิเศษที่ใช้ทดลองการบรรเทาความเสี่ยงในรูปแบบต่างๆ
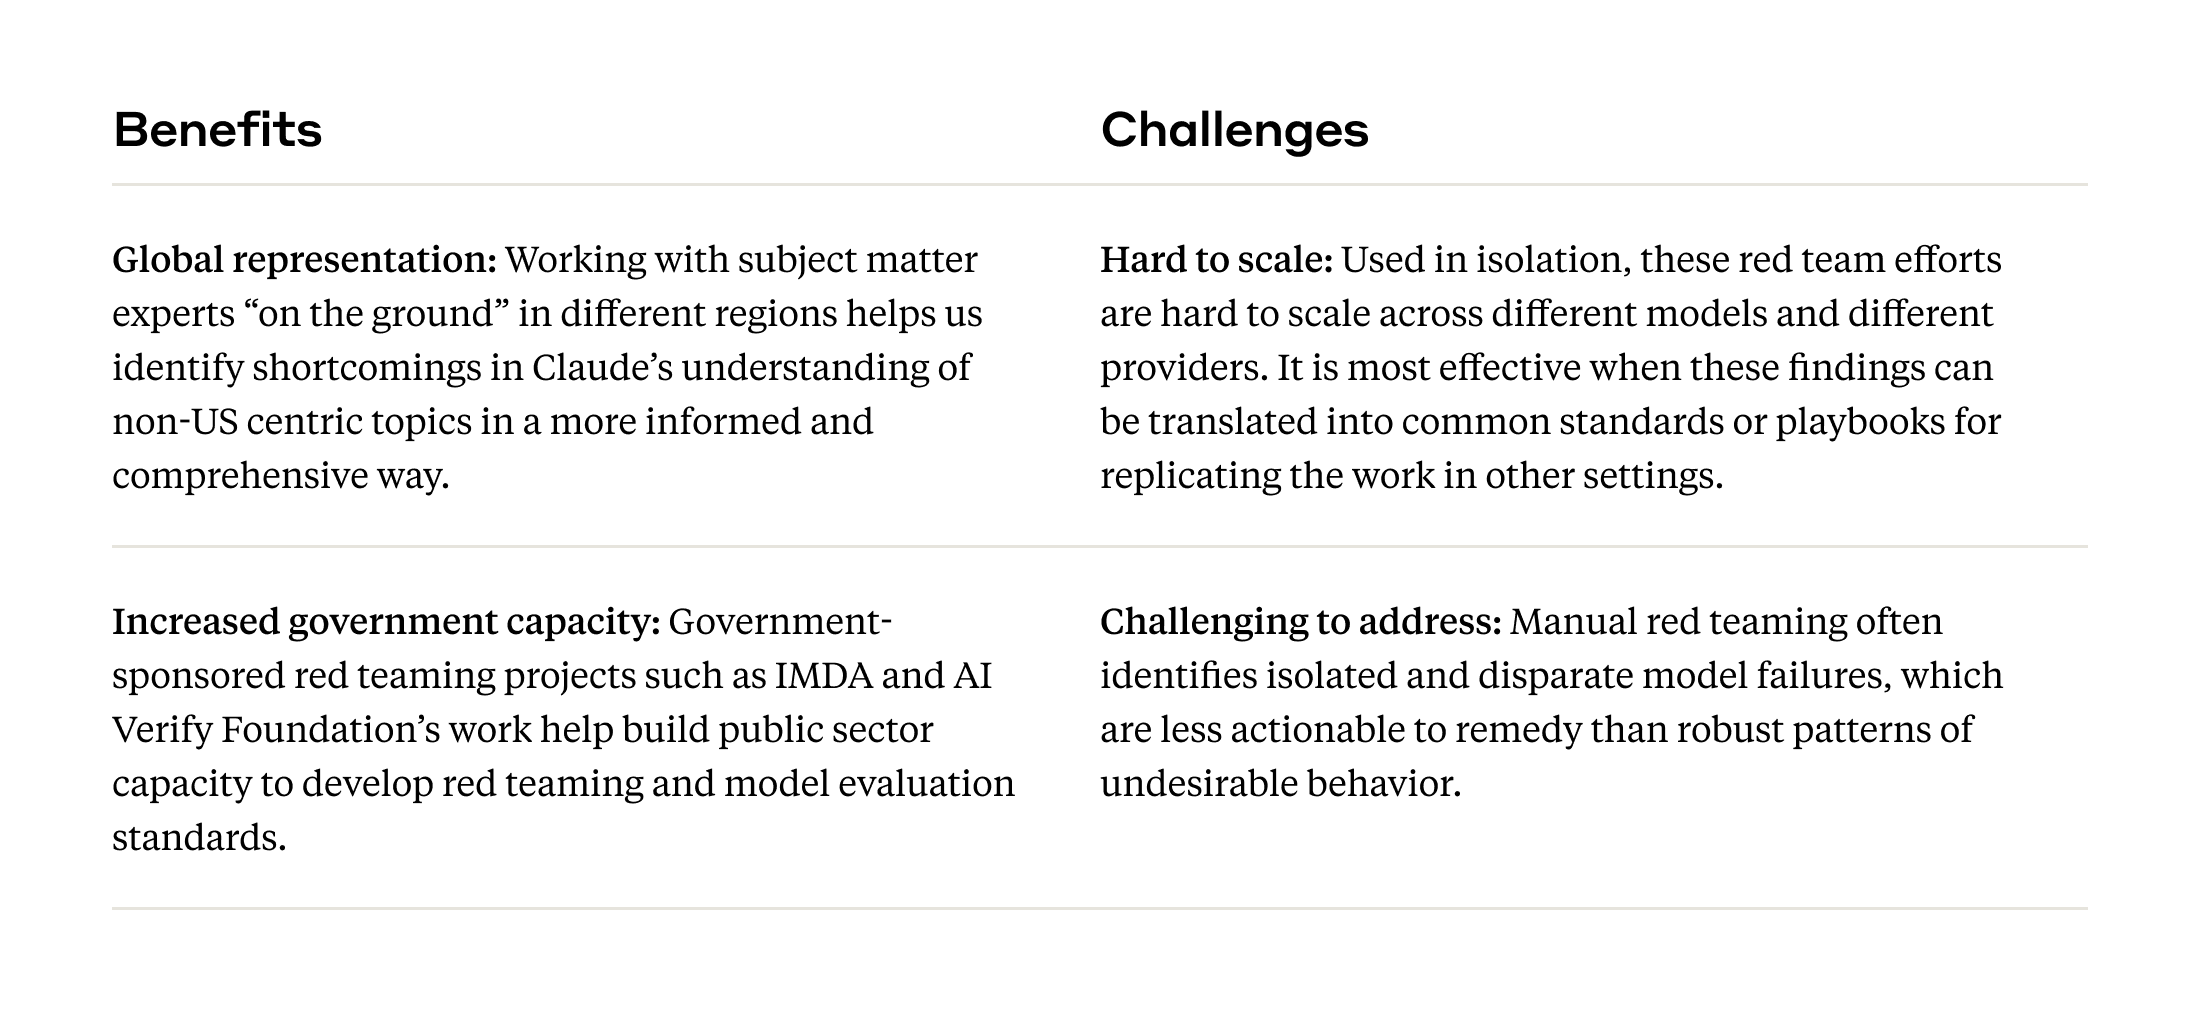
การทำ red teaming หลากภาษาและพหุวัฒนธรรม เนื่องจากการทดสอบส่วนใหญ่เน้นภาษาอังกฤษและมุมมองแบบสหรัฐฯ เราจึงให้ความสำคัญกับการทำ red teaming ในบริบทวัฒนธรรมอื่น เช่น การเป็นพันธมิตรกับ Infocomm Media Development Authority (IMDA) และ AI Verify Foundation ของสิงคโปร์ เพื่อทดสอบระบบใน 4 ภาษา (อังกฤษ, ทมิฬ, จีนกลาง และมลายู) ในหัวข้อที่เกี่ยวข้องกับคนสิงคโปร์โดยเฉพาะ
การใช้โมเดลภาษาในการทำ red team
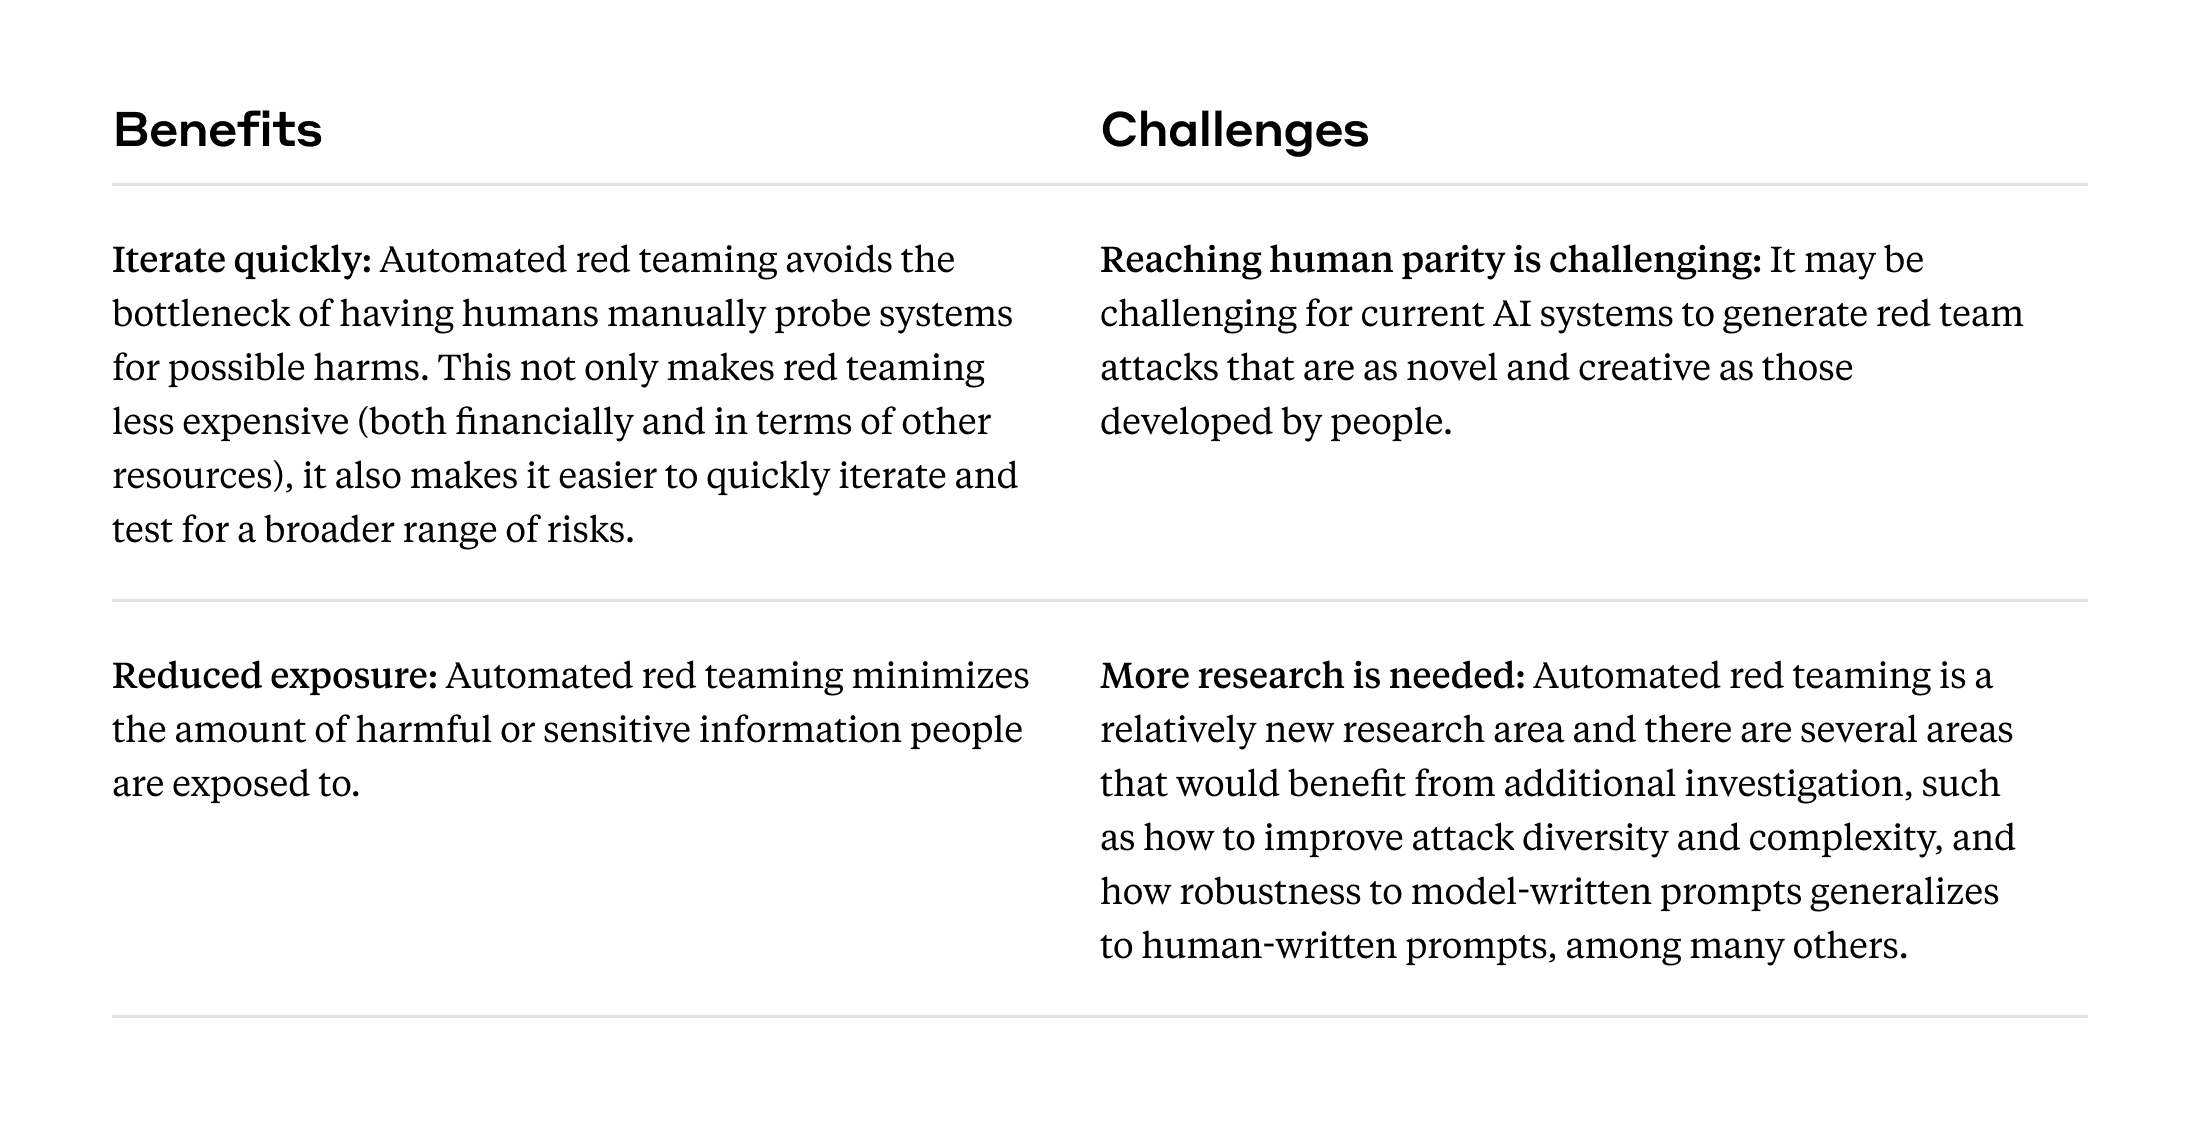
เทคนิคนี้คือการใช้ระบบ AI สร้างตัวอย่างเชิงรุก (adversarial examples) เพื่อทดสอบความทนทานของโมเดล AI อื่นๆ โดยอัตโนมัติ ซึ่งช่วยเพิ่มประสิทธิภาพและความครอบคลุมให้กับการทดสอบด้วยมนุษย์
การทำ red teaming แบบอัตโนมัติ
เราใช้กลไก red team / blue team โดยให้โมเดลหนึ่งทำหน้าที่โจมตีเพื่อกระตุ้นพฤติกรรมที่ไม่พึงประสงค์ (red team) จากนั้นนำผลที่ได้มา fine-tune อีกโมเดลให้มีภูมิต้านทานมากขึ้น (blue team) กระบวนการวนซ้ำนี้ช่วยให้เราค้นพบรูปแบบการโจมตีใหม่ๆ และสร้างระบบที่ทนทานต่อการโจมตีในวงกว้างได้
การทำ red teaming ในรูปแบบใหม่ๆ (New modalities)
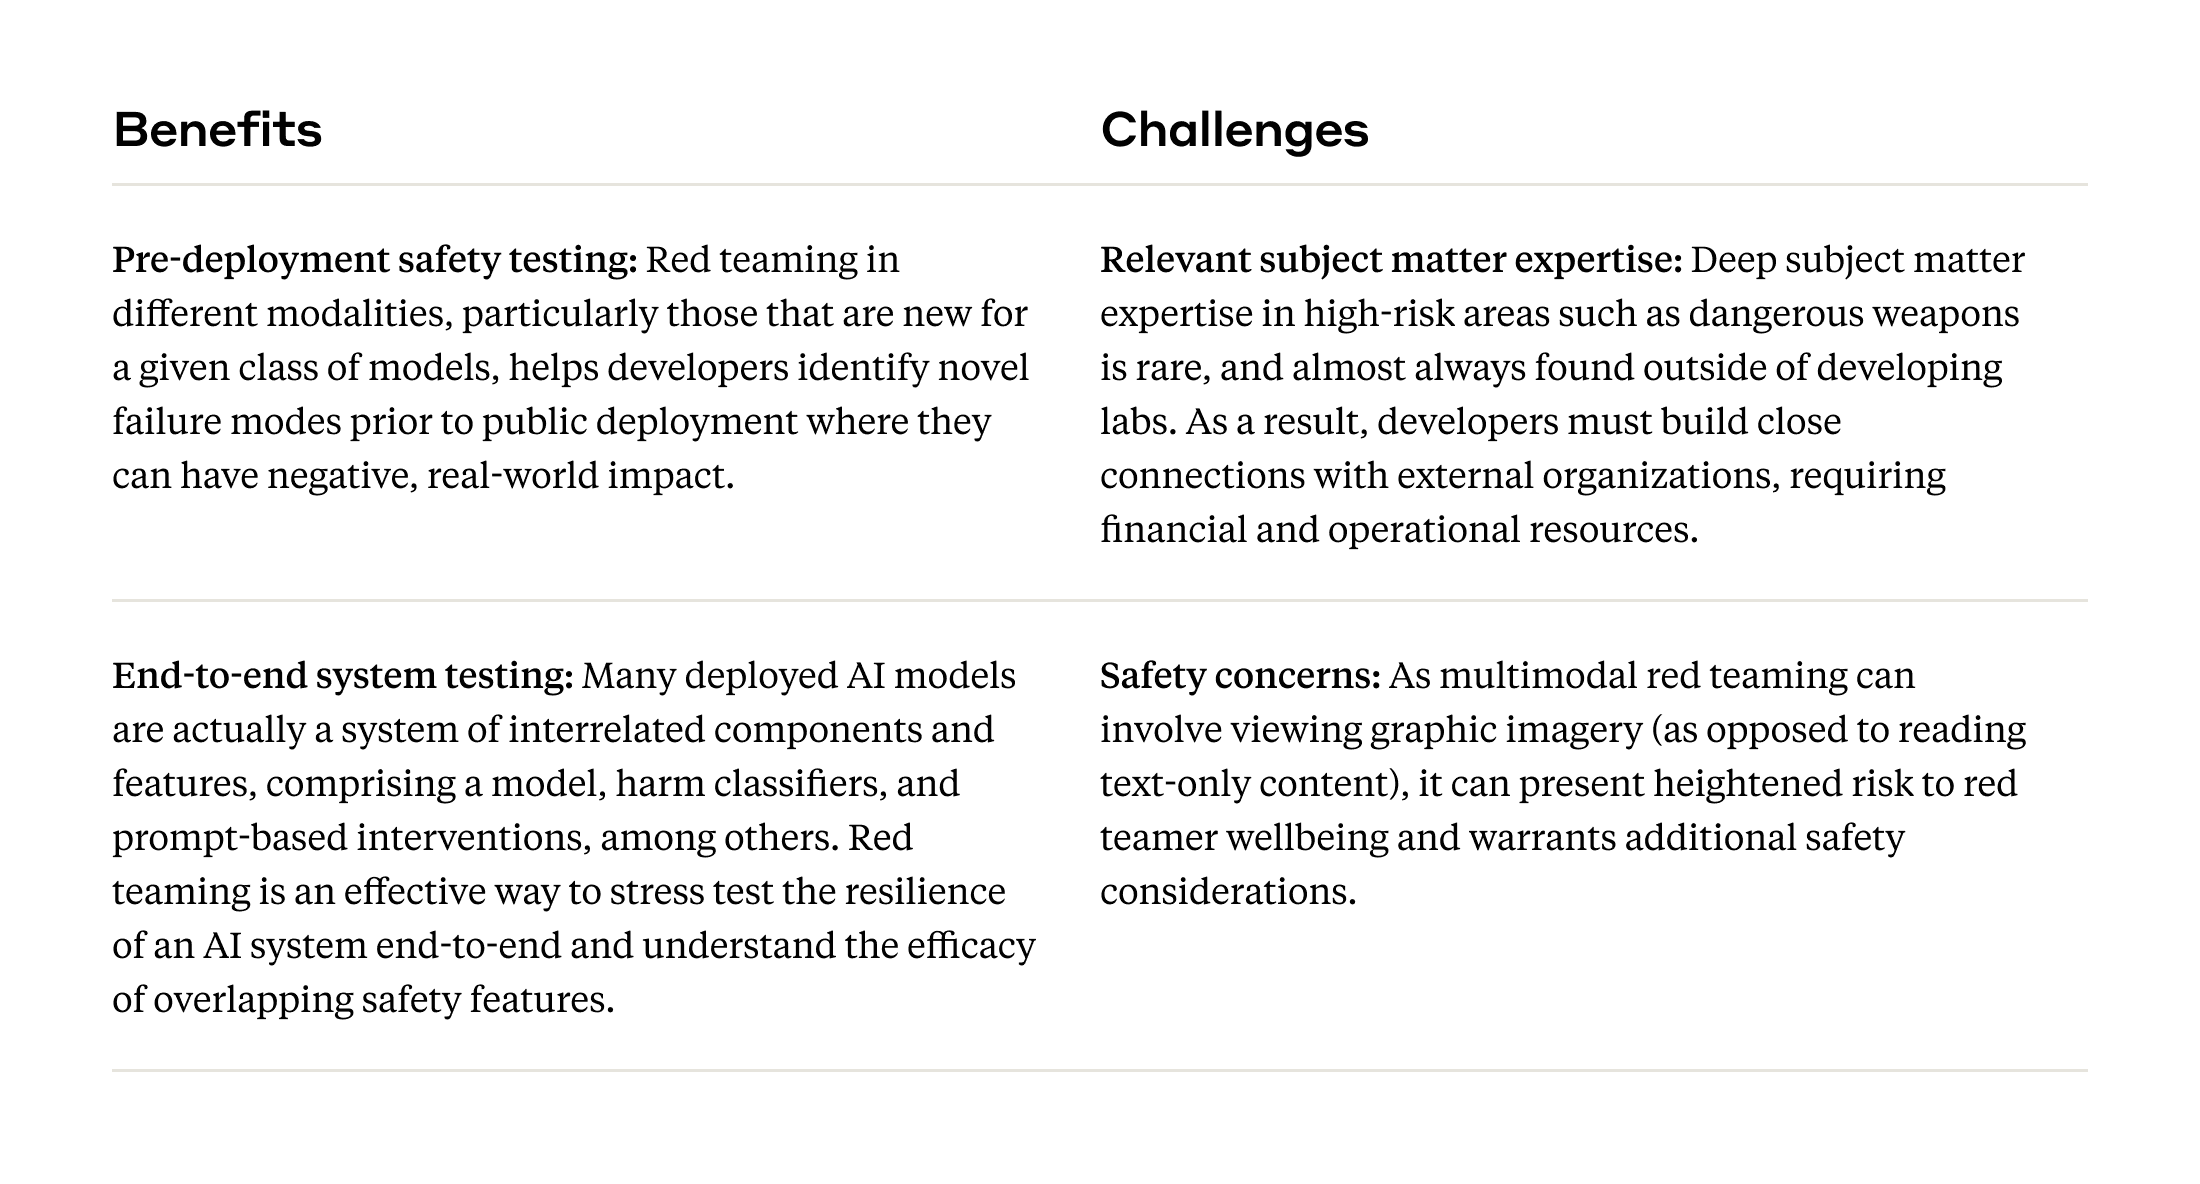
การทดสอบระบบที่รับอินพุตหลากหลาย เช่น รูปภาพหรือเสียง ช่วยให้เราตรวจพบความเสี่ยงใหม่ๆ ก่อนที่จะนำระบบไปใช้งานจริงในวงกว้าง
Multimodal red teaming
แม้โมเดล Claude 3 จะไม่ได้สร้างรูปภาพ แต่สามารถรับข้อมูลภาพได้ ซึ่งนำไปสู่ความเสี่ยงใหม่ๆ เช่น การฉ้อโกงหรือภัยต่อเด็ก ก่อนเปิดตัวทีม Trust & Safety จึงได้ ทำ red team ระบบของเรา เพื่อประเมินว่าโมเดลปฏิเสธคำสั่งที่เป็นอันตรายได้ดีเพียงใด ซึ่งถือเป็นขั้นตอนสำคัญสำหรับการเปิดตัวฟีเจอร์ใหม่ทุกครั้ง
การทำ red teaming ทั่วไปแบบปลายเปิด
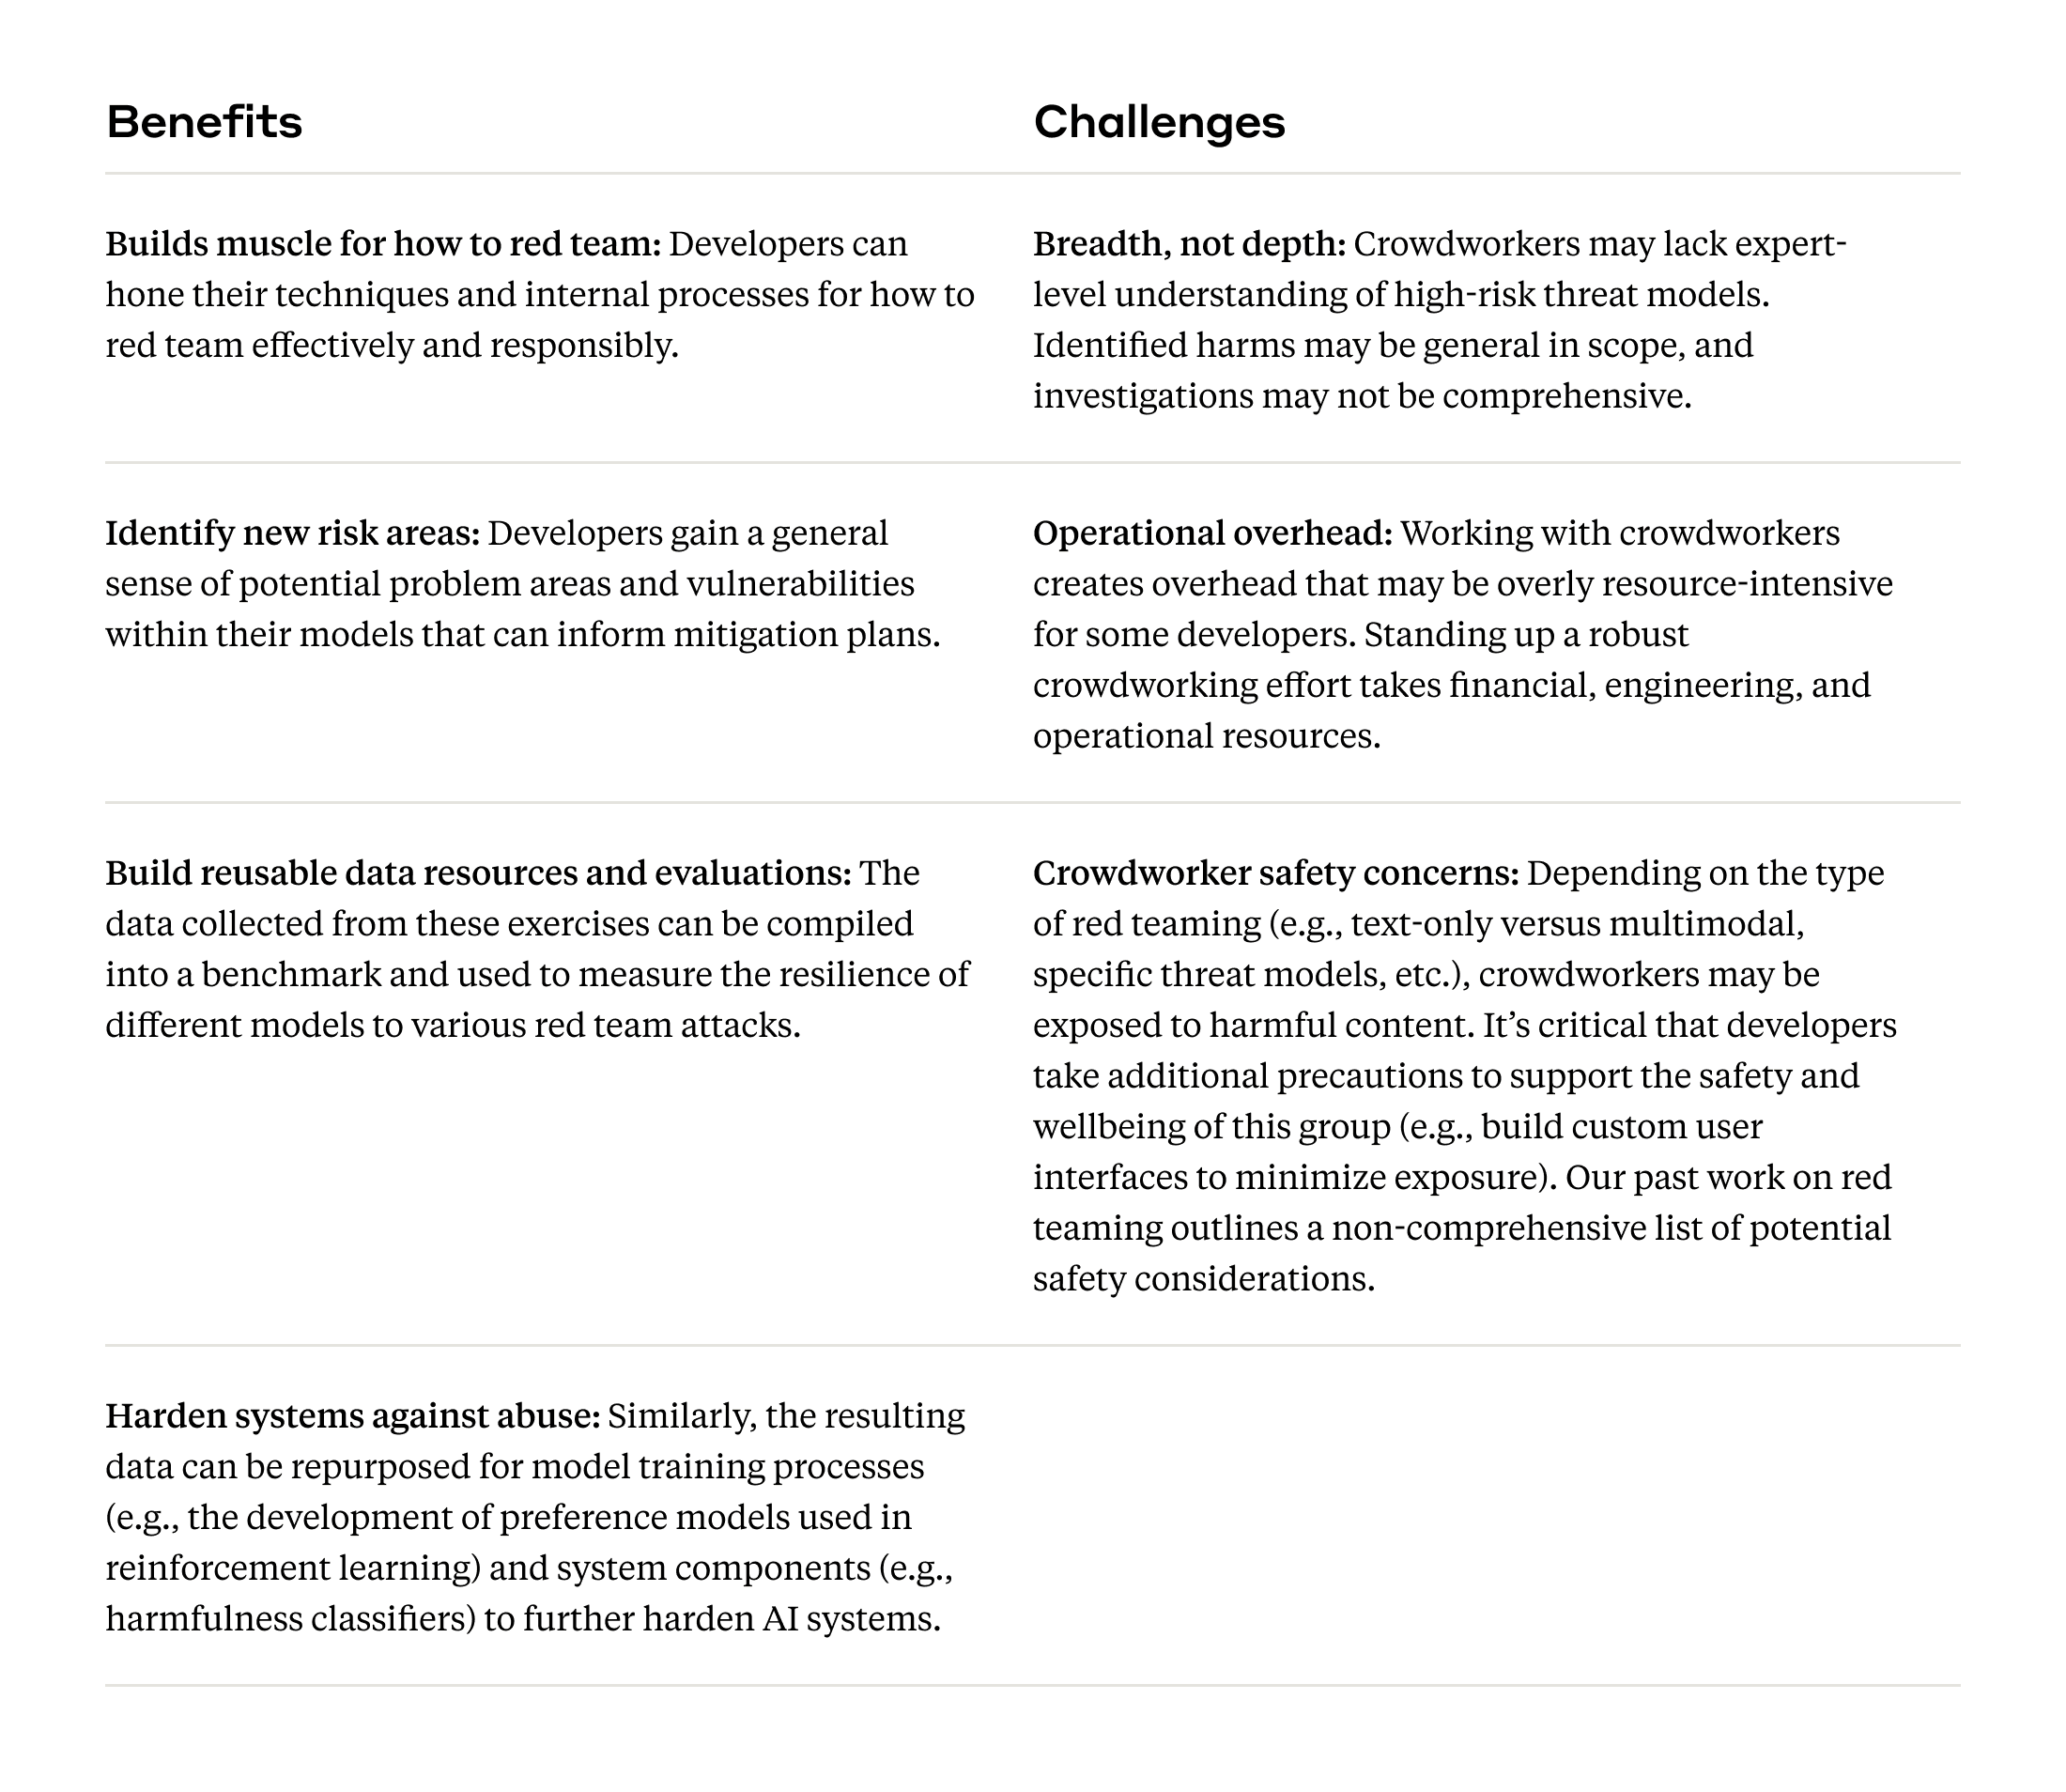
การทำ red teaming แบบ Crowdsourced สำหรับอันตรายทั่วไป
ในช่วงเริ่มต้นของ การวิจัย red teaming ปี 2022 ที่เรายังไม่ได้เปิดตัว Claude ต่อสาธารณะ เราได้ทำงานร่วมกับ crowdworkers ในสภาพแวดล้อมที่ควบคุม เพื่อให้พวกเขาทดสอบการโจมตีตามดุลยพินิจของตนเอง ซึ่งช่วยสร้างรากฐานงานวิจัยในยุคที่มาตรฐานการทดสอบโมเดลภาษายังมีน้อย
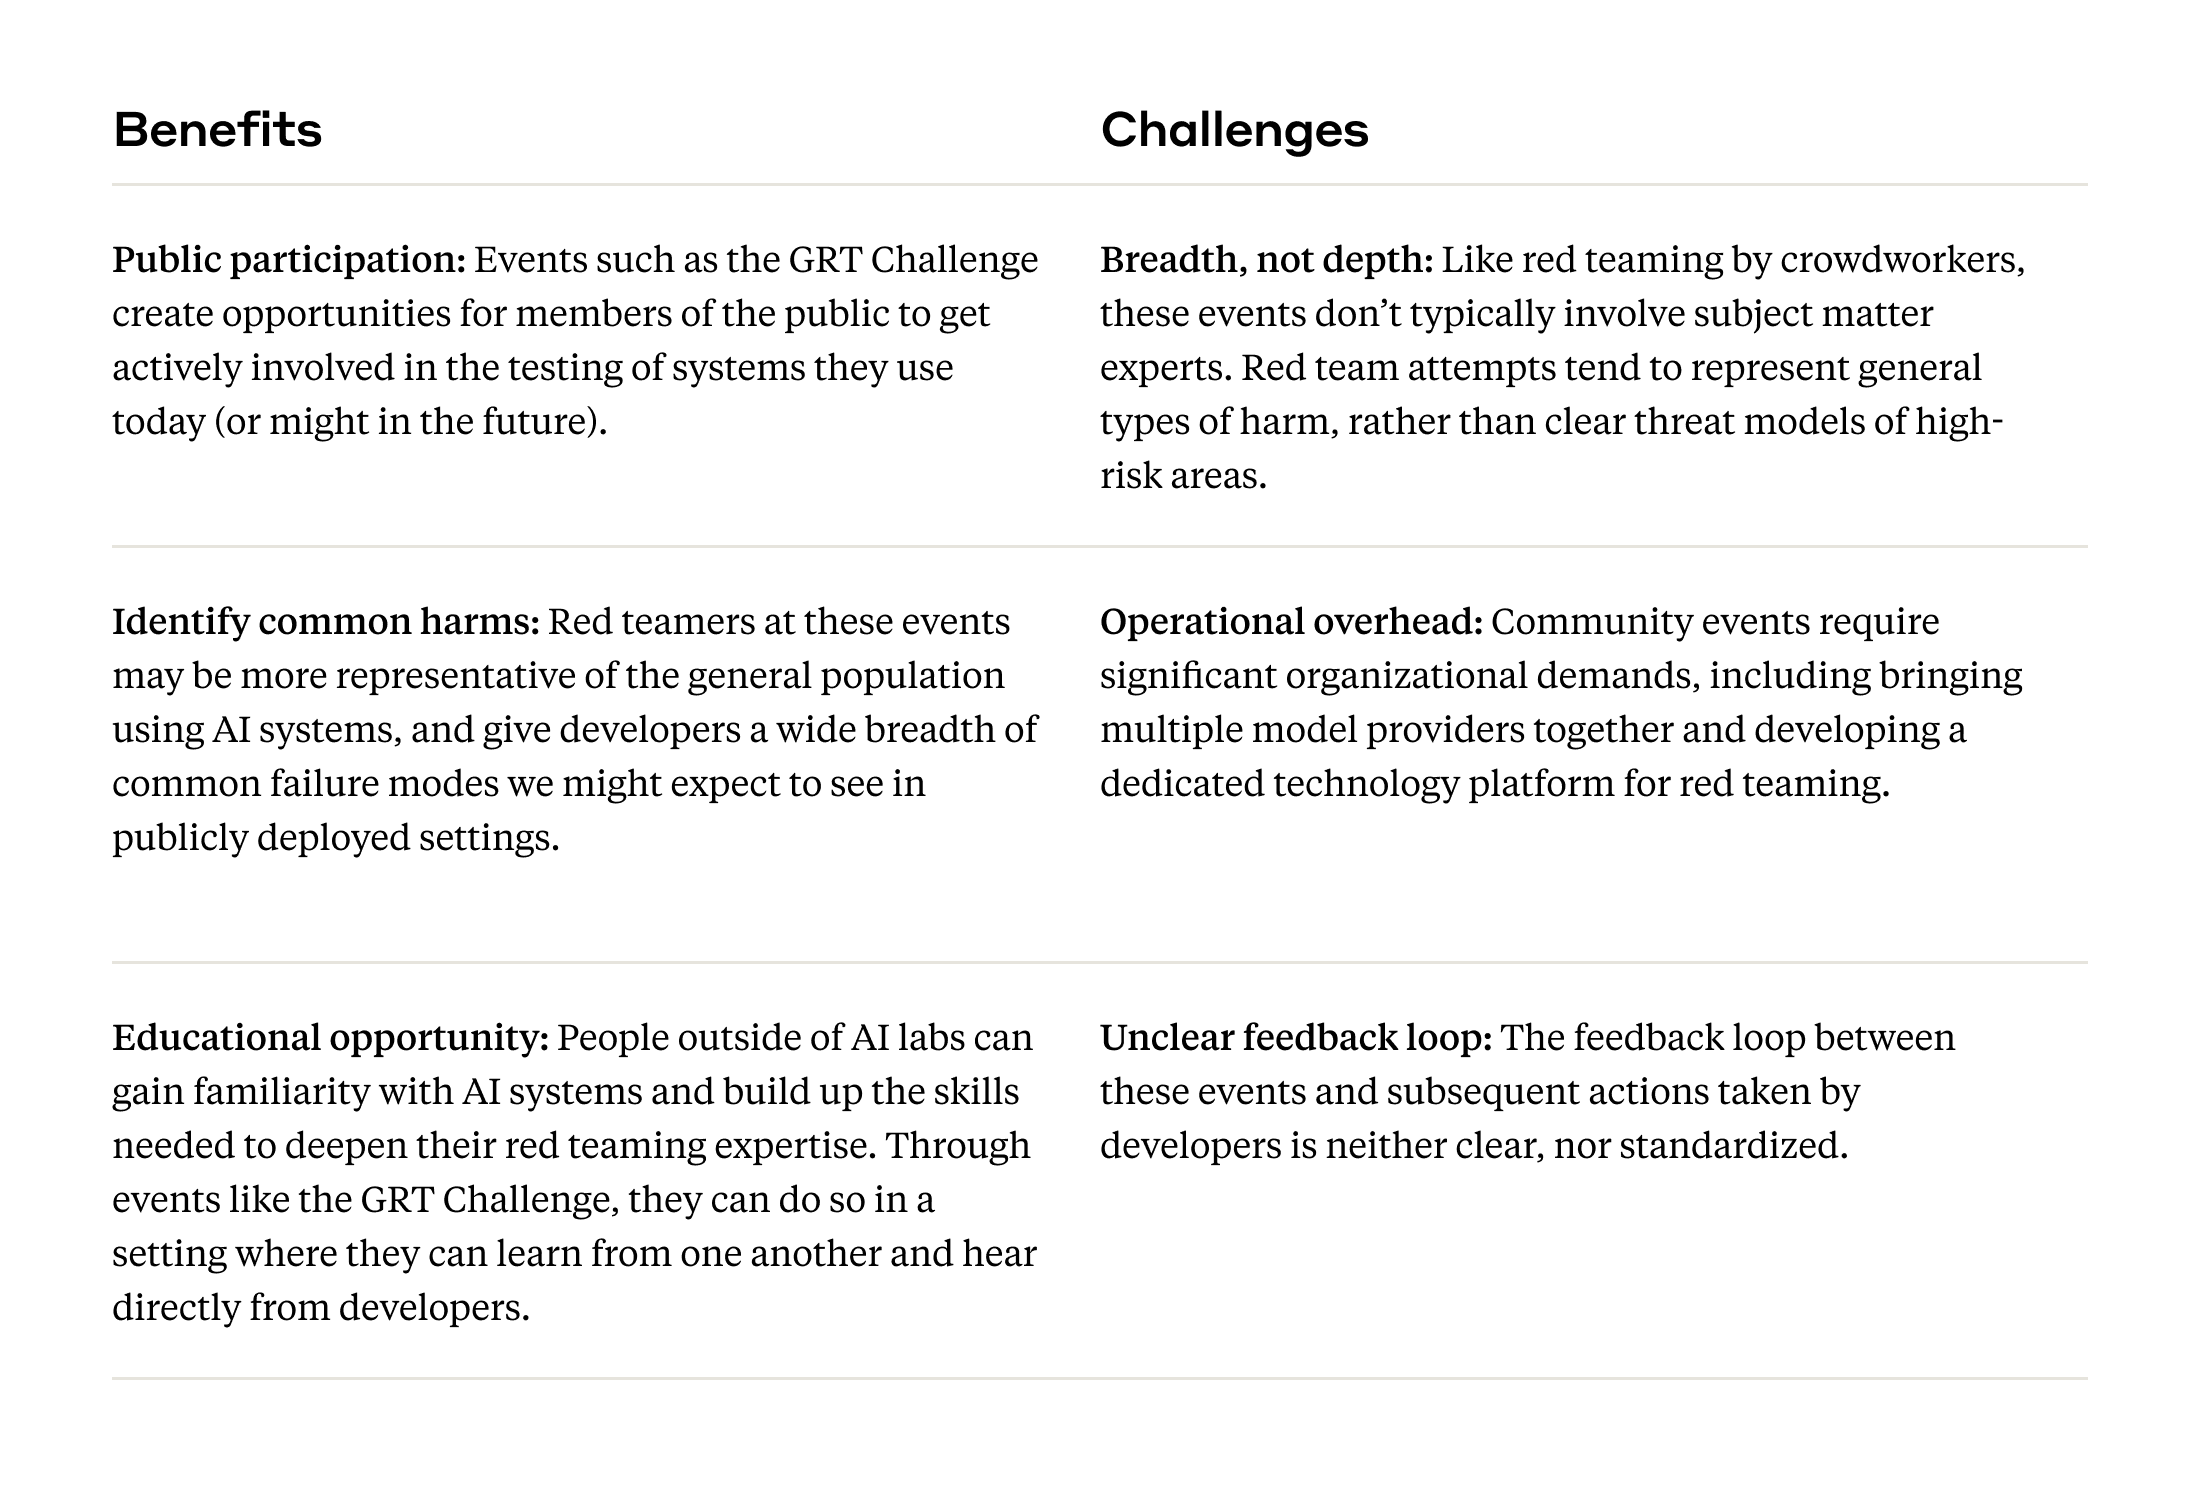
การทำ red teaming โดยชุมชนสำหรับความเสี่ยงทั่วไปและข้อจำกัดของระบบ
กิจกรรมอย่าง AI Village ของ DEF CON และ Generative Red Teaming (GRT) Challenge ได้เปิดโอกาสให้ผู้คนหลากหลายสาขาอาชีพรวมถึงผู้ที่ไม่มีทักษะทางเทคนิคมาช่วยทดสอบโมเดลของ Anthropic ความคิดสร้างสรรค์จากชุมชนเหล่านี้เป็นแรงบันดาลใจสำคัญในการสร้างระบบความปลอดภัยของ AI ให้ทั่วถึงยิ่งขึ้น
เราจะเปลี่ยนจากการทำ red teaming เชิงคุณภาพไปสู่การประเมินผลเชิงปริมาณได้อย่างไร?
เป้าหมายสูงสุดคือการเปลี่ยนผลลัพธ์จากการทดสอบเชิงคุณภาพ (การลองผิดลองถูก) ให้เป็นลูปการประเมินเชิงปริมาณแบบอัตโนมัติที่ทำซ้ำได้ โดยเริ่มจากผู้เชี่ยวชาญกำหนด threat model และทดสอบแบบ ad hoc เพื่อสร้างความเข้าใจ จากนั้นจึงกำหนดเป็นมาตรฐานการโจมตีที่ได้ผล
เมื่อได้มาตรฐานแล้ว เราจะใช้โมเดลภาษาจำลองการโจมตีเหล่านี้นับพันรูปแบบเพื่อความครอบคลุมและรวดเร็ว เราได้นำแนวทางนี้ไปใช้แล้วในการทดสอบด้านความมั่นคงแห่งชาติและ ความสมบูรณ์ของการเลือกตั้ง และมีแผนจะขยายผลไปยังความเสี่ยงด้านอื่นๆ ต่อไป
ข้อเสนอแนะเชิงนโยบาย เพื่อให้เกิดมาตรฐานร่วมกัน เราขอเสนอให้ผู้กำหนดนโยบายดำเนินการดังนี้:
- สนับสนุนงบประมาณแก่ NIST เพื่อพัฒนามาตรฐานเทคนิคการทำ red team ระบบ AI
- สนับสนุนหน่วยงานรัฐอิสระและองค์กรไม่แสวงหากำไร ให้ร่วมทดสอบความเสี่ยงเฉพาะด้าน เช่น ความมั่นคงแห่งชาติ
- ส่งเสริมตลาดบริการ red teaming ระดับมืออาชีพและระบบการรับรองมาตรฐาน
- สนับสนุนให้บริษัท AI เปิดทางให้บุคคลที่สามที่ผ่านการตรวจสอบเข้าถึงโมเดลเพื่อทดสอบความปลอดภัย
- กระตุ้นให้บริษัท AI ผูกโยงการทำ red teaming เข้ากับนโยบายการขยายขนาดโมเดลที่รับผิดชอบ เช่น Responsible Scaling Policy
บทสรุป
Red teaming เป็นเทคนิคที่ทรงพลังในการระบุและบรรเทาความเสี่ยงของ AI เราหวังว่าจะได้ร่วมมือกับทุกภาคส่วนเพื่อสร้างมาตรฐานความปลอดภัยร่วมกัน การลงทุนในกระบวนการนี้จะช่วยให้เรามั่นใจได้ว่า AI จะได้รับการพัฒนาอย่างรอบคอบและสร้างประโยชน์ต่อสังคมอย่างแท้จริง
เนื้อหาที่เกี่ยวข้อง
การสนับสนุนงบประมาณเพื่อการประเมินผลกระทบของ AI ต่อความมีสุขภาพดีที่ดีขึ้น
เรามอบทุน 5 ล้านดอลลาร์เพื่อวิจัยว่า AI ส่งผลต่อความเป็นอยู่ที่ดี (wellbeing) ของผู้ใช้อย่างไร อ่านเพิ่มเติม
วิธีการทำงานของลายน้ำข้อความของ Claude
เจาะลึกการทำงานของลายน้ำข้อความเพื่อตรวจสอบที่มาของเนื้อหาจาก Claude อ่านเพิ่มเติม
การปรับปรุงมาตรการป้องกันด้านชีววิทยาของ Fable 5
อัปเดตระบบป้องกันด้านชีววิทยาเพื่อลดการแจ้งเตือนผิดพลาดและเพิ่มความแม่นยำในการใช้งาน อ่านเพิ่มเติม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร