
Kimi K3.1 Pro จากจีนแรงจัด ไล่จี้ Claude 5.5 ขึ้นอันดับ 4 โลก
ประเด็นสำคัญ
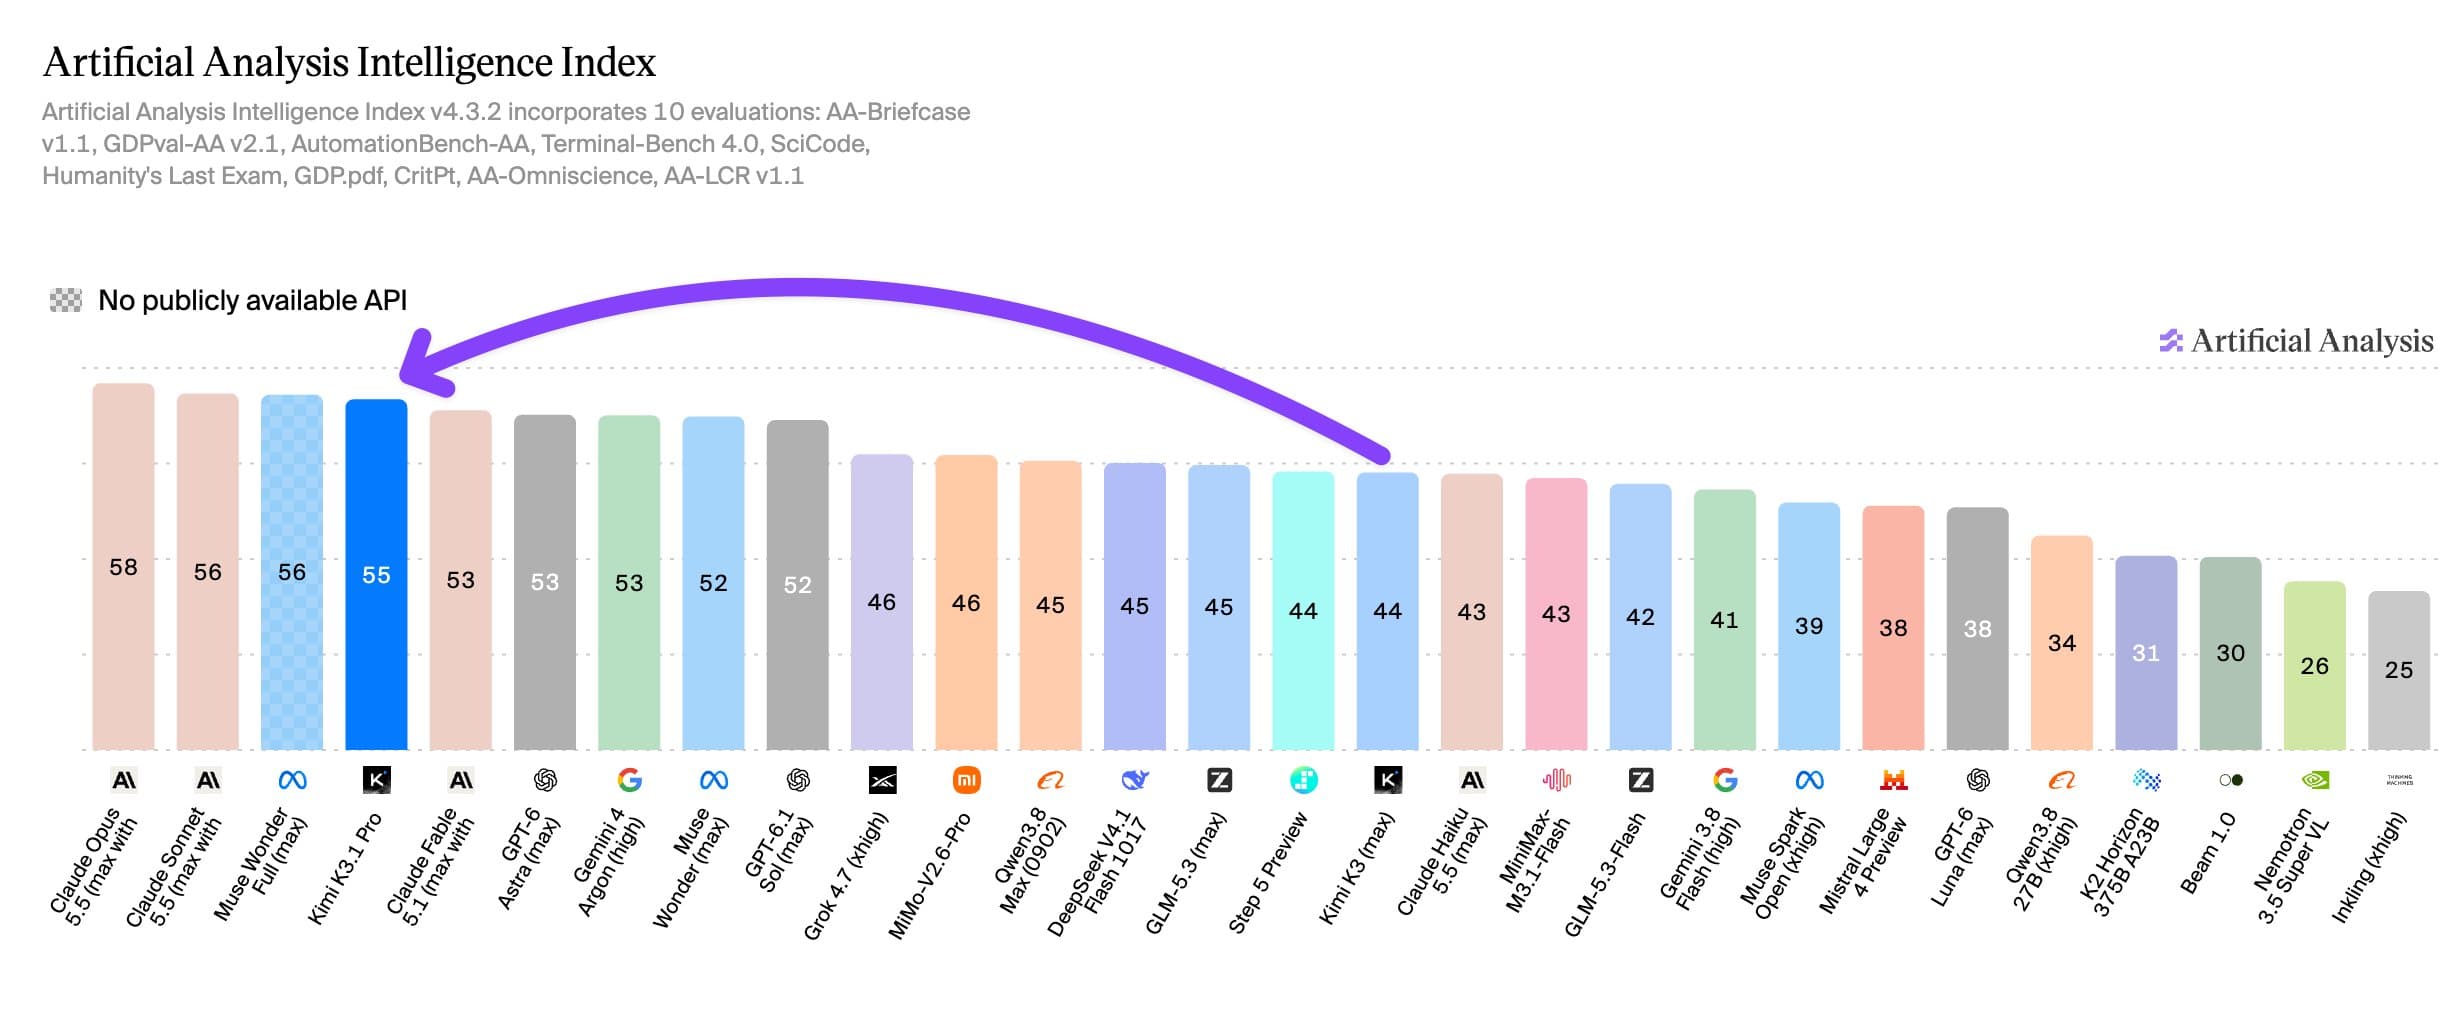
- Moonshot AI บริษัทเทคโนโลยีจากจีนเปิดตัว Kimi K3.1 Pro ซึ่งก้าวกระโดดขึ้นมาอยู่อันดับ 4 บนดัชนี Artificial Analysis Intelligence Index ด้วยคะแนน 55 คะแนน ตามหลัง Claude Opus 5.5 เพียงเล็กน้อย
- โมเดลรุ่นนี้แสดงให้เห็นถึงการพัฒนาที่สำคัญในด้านงานที่เป็นเอเจนต์ (agentic tasks), การเขียนโค้ด และการสร้างแบบจำลอง 3 มิติ
- แม้จำนวนพารามิเตอร์จะคงอยู่ที่ 2.8 ล้านล้าน แต่ราคา API ลดลงถึง 33% โดย Moonshot วางแผนที่จะปล่อย weights ของโมเดลภายในเดือนพฤศจิกายน 2026
Kimi K3.1 Pro โมเดลการให้เหตุผล (reasoning model) ตัวใหม่จาก Moonshot AI ผงาดขึ้นแท่นอันดับ 4 ในดัชนี Artificial Analysis Intelligence Index โดยตามหลังโมเดลแบบปิด (proprietary models) ระดับท็อปเพียง 3 คะแนนเท่านั้น
Moonshot AI ได้เปิดตัว Kimi K3.1 Pro ซึ่งเป็นเวอร์ชันที่ผ่านการทำ post-trained จากรุ่น Kimi K3 เดิม โดยใช้ทรัพยากรประมวลผลเพิ่มขึ้นอย่างมีนัยสำคัญ ส่งผลให้ทำคะแนนได้ 55 คะแนนบน Artificial Analysis Intelligence Index เพิ่มขึ้นจากรุ่น K3 ถึง 11 คะแนน
ปัจจุบันมีเพียง Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) และ Muse Wonder Full (56) เท่านั้นที่อยู่ในอันดับสูงกว่า ตามรายงานของ Artificial Analysis หาก Moonshot ปล่อย weights ของโมเดลตามแผนภายในวันที่ 4 พฤศจิกายน 2026 K3.1 Pro จะกลายเป็นโมเดลแบบเปิด (open-weights model) ที่มีคะแนนสูงสุด ซึ่งจะช่วยลดช่องว่างระหว่างโมเดลแบบเปิดและแบบปิดให้เหลือเพียง 3 คะแนน หากไม่มีการเปลี่ยนแปลงอื่นในตลาด
นอกจากรุ่นหลักแล้ว Moonshot ยังได้เปิดตัวรุ่นย่อย K3.1 Pro Highspeed ที่ทำงานเร็วกว่าเดิม 2-3 เท่า โดยทั้งสองรุ่นพร้อมใช้งานแล้วผ่านทาง Kimi.ai, Kimi Work, Kimi Code และ Kimi API
| รายการ | Kimi-K3.1-Pro | Kimi-K3.1-Pro-Highspeed |
|---|---|---|
| Input | $2.00 / MTok | $4.00 / MTok |
| Output | $10.00 / MTok | $20.00 / MTok |
| Cache Input | $0.20 / MTok | $0.20 / MTok |
งานด้านเอเจนต์เห็นการพัฒนามากที่สุด
การปรับปรุงที่โดดเด่นที่สุดของ K3.1 Pro ปรากฏในงานด้านเอเจนต์ โดยในเบนช์มาร์ก GDPval-AA โมเดลทำคะแนนได้ 1,846 Elo ซึ่งสูงกว่ารุ่น K3 ถึง 312 คะแนน ตามหลังเพียง Claude Opus 5.5 (1,866) และ Muse Wonder Full (1,857) เท่านั้น ส่วนใน Terminal-Bench 4.0 ทำได้ 65.7% นำหน้า GPT-6 Astra (58.2%) และตามหลัง Claude Opus 5.5 (66.4%) เพียงเล็กน้อย
ด้านความแม่นยำพบว่าอัตราการเกิดอาการหลอน (hallucination rates) ลดลงอย่างมาก โดยในการทดสอบ Kimi Hallu Bench Hard ภายในพบว่าอาการหลอนระดับการอ้างสิทธิ์ลดลงจาก 23.4% เหลือเพียง 8.3% แม้ GPT-6 Astra จะยังนำอยู่ที่ 5.5% ในการทดสอบความเครียด (stress test) เดียวกันนี้ก็ตาม
สำหรับเบนช์มาร์กด้านการเงิน K3.1 Pro มีคะแนนเพิ่มขึ้น 7.2 คะแนนในด้าน Financial Modeling และ 11.6 คะแนนในด้าน Financial Research ส่วนงานสำนักงานทั่วไป โมเดลนี้ครองอันดับสูงสุดบน OfficeQA Pro v2 เหนือกว่าทุกโมเดลที่ผ่านการทดสอบตามข้อมูลของ Moonshot
| เบนช์มาร์ก | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 | 42.3 | 41.8 |
| SWE Marathon v1.1 | 51.7 | 46.3 | 42.5 | 45.6 | 40.0 | 42.5 |
| DeepSWE v1.1 | 75.5 | 74.2 | 74.1 | 67.4 | 77.0 | 66.9 |
| BenchCAD (ใช้เครื่องมือ) | 92.7 | 96.2 | 95.9 | 92.6 | 81.6 | -- |
| HLE-Full (ใช้เครื่องมือ) | 70.0 | 67.7 | 57.2 | 65.6 | 58.8 | 62.5 |
| BrowseComp | 92.1 | 90.8 | 91.5 | -- | -- | -- |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 | 40.4 | 31.1 |
| Automation Bench-AA | 73.3 | 69.5 | 68.5 | 59.4 | 66.6 | 62.2 |
| GDPval-AA v2.1 (Elo) | 1,846 | 1,866 | 1,573 | 1,754 | 1,746 | 1,650 |
| GPQA-Diamond | 94.2 | 93.9 | 96.1 | 93.7 | 92.2 | 91.7 |
| ExploitBench | 74.7 | 91.0 | 100 | 83.0 | -- | 54.4 |
ผลลัพธ์เบนช์มาร์กจาก Moonshot ทั้งหมดใช้การตั้งค่าระดับความพยายามในการให้เหตุผล (reasoning effort) ไว้ที่ "สูงสุด"
การสร้างแบบจำลอง 3 มิติและการเขียนโค้ด
K3.1 Pro สามารถทำงานร่วมกับเอนจินเกมระดับสากลอย่าง Unity, Unreal Engine และ Godot ได้โดยตรง รองรับตั้งแต่การแก้ไขจุดเล็กน้อยไปจนถึงการสร้างโปรเจกต์เต็มรูปแบบ ในเบนช์มาร์ก BenchCAD โมเดลทำได้ 92.7% เมื่อใช้เครื่องมือ ซึ่งใกล้เคียงกับ Claude Opus 5.5 และ GPT-6 Astra อย่างมาก
Moonshot ระบุว่าโมเดลมีความโดดเด่นในด้านการสร้างแบบจำลองพารามิเตอร์ (parametric modeling) ทั้งชิ้นส่วนเครื่องกลและสถาปัตยกรรม โดยสามารถเขียนและรันสคริปต์สำหรับ Blender และ CAD ได้โดยตรงไม่ต้องใช้ตัวเชื่อมต่อ MCP นอกจากนี้ยังมีฟีเจอร์ "3D Make" บน Kimi.com ให้ผู้ใช้แก้ไขและส่งออกโมเดล 3 มิติได้ทันที
ขนาดเท่าเดิมแต่ประสิทธิภาพต่อราคาคุ้มค่าขึ้น
K3.1 Pro ยังคงใช้โครงสร้างเดิมที่มีพารามิเตอร์รวม 2.8 ล้านล้าน และพารามิเตอร์ที่ทำงานจริง (active parameters) 104 พันล้าน พร้อมหน้าต่างบริบท (context window) หนึ่งล้านโทเคน รองรับทั้งข้อความและรูปภาพ จากข้อมูลของ Artificial Analysis พบว่าไม่มีโมเดลที่มีขนาดใกล้เคียงกันตัวใดทำคะแนนได้สูงกว่าใน Intelligence Index
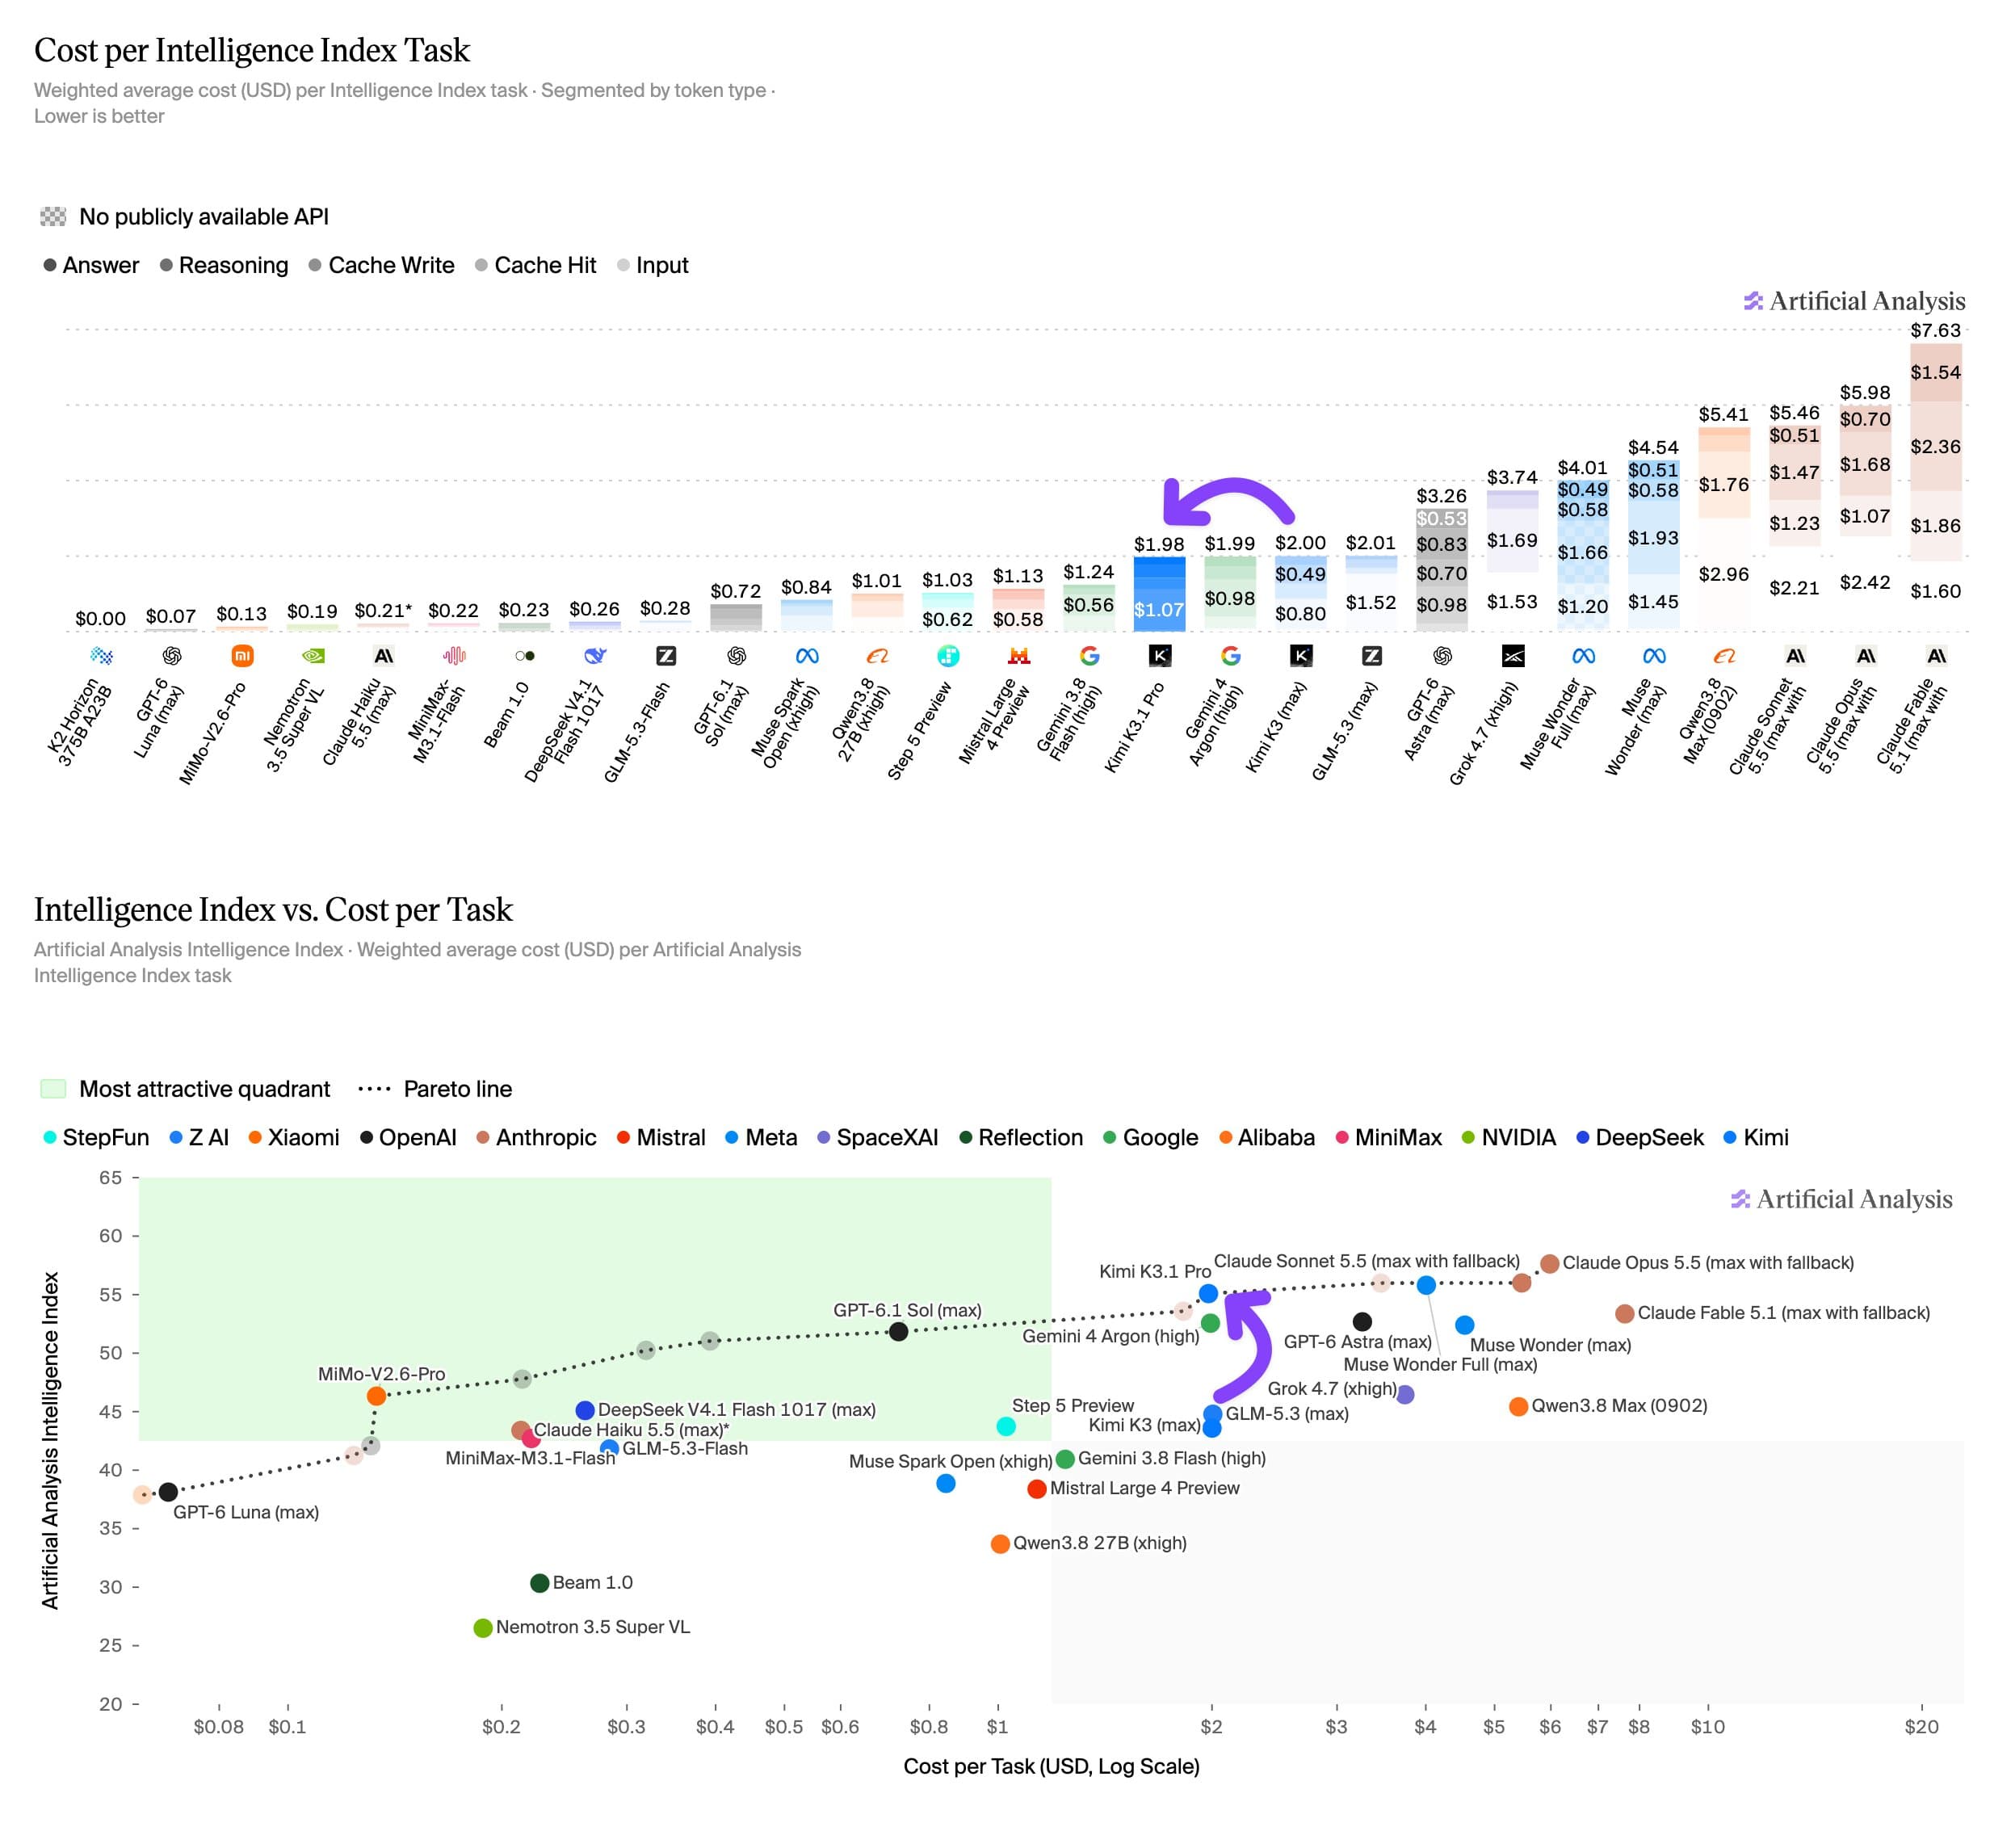
ด้านราคา API ลดลงถึง 33% โดยต้นทุน Input เหลือเพียง $2 ต่อล้านโทเคน และ Output เหลือ $10 แม้โมเดลจะสร้างโทเคน Output ได้มากขึ้น 14% แต่ต้นทุนต่อภารกิจใน Intelligence Index ยังคงอยู่ที่ประมาณ $1.98 ซึ่งใกล้เคียงกับรุ่น K3 เดิม
ความปลอดภัยทางไซเบอร์และการจำกัดขีดความสามารถโจมตี
Moonshot ให้ความสำคัญกับความปลอดภัยทางไซเบอร์อย่างมาก โดยระบุใน บล็อกโพสต์ทางเทคนิค ว่าความสามารถในการวิจัยช่องโหว่มักเติบโตตามขนาดของ post-training ดังนั้นในการเตรียมปล่อย open-weights บริษัทจึงได้ตัดข้อมูลที่สุ่มเสี่ยงต่อการโจมตีไซเบอร์ออกทั้งในช่วง mid-training และ RL environment mix
จากการทดสอบ xdev-bench-hard พบว่าเวอร์ชันที่ผ่านการคัดกรองข้อมูลแล้ว (cleaned) แก้โจทย์ช่องโหว่ซอฟต์แวร์ได้ 81.0% ลดลงจากเวอร์ชันเต็มที่ทำได้ 90.5% เพื่อป้องกันไม่ให้โมเดลแบบ open-weights ถูกนำไปใช้ในทางที่ผิด ในขณะที่ยังคงความสามารถในการป้องกันระบบไว้
ทั้งนี้ Anthropic เคยให้ข้อมูลว่าแม้แต่โมเดลอย่าง GLM-5.3 ซึ่งมีคะแนนเพียง 45 บน AA Index ก็มีความสามารถในการสร้างโค้ดโจมตี (exploits) ได้ใกล้เคียงกับ Claude Mythos ซึ่งเป็นเหตุผลที่ Moonshot ต้องระมัดระวังเป็นพิเศษ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร