
เจาะลึกนโยบายเก็บข้อมูล AI: รู้จัก 2 รูปแบบมาตรฐานของ API
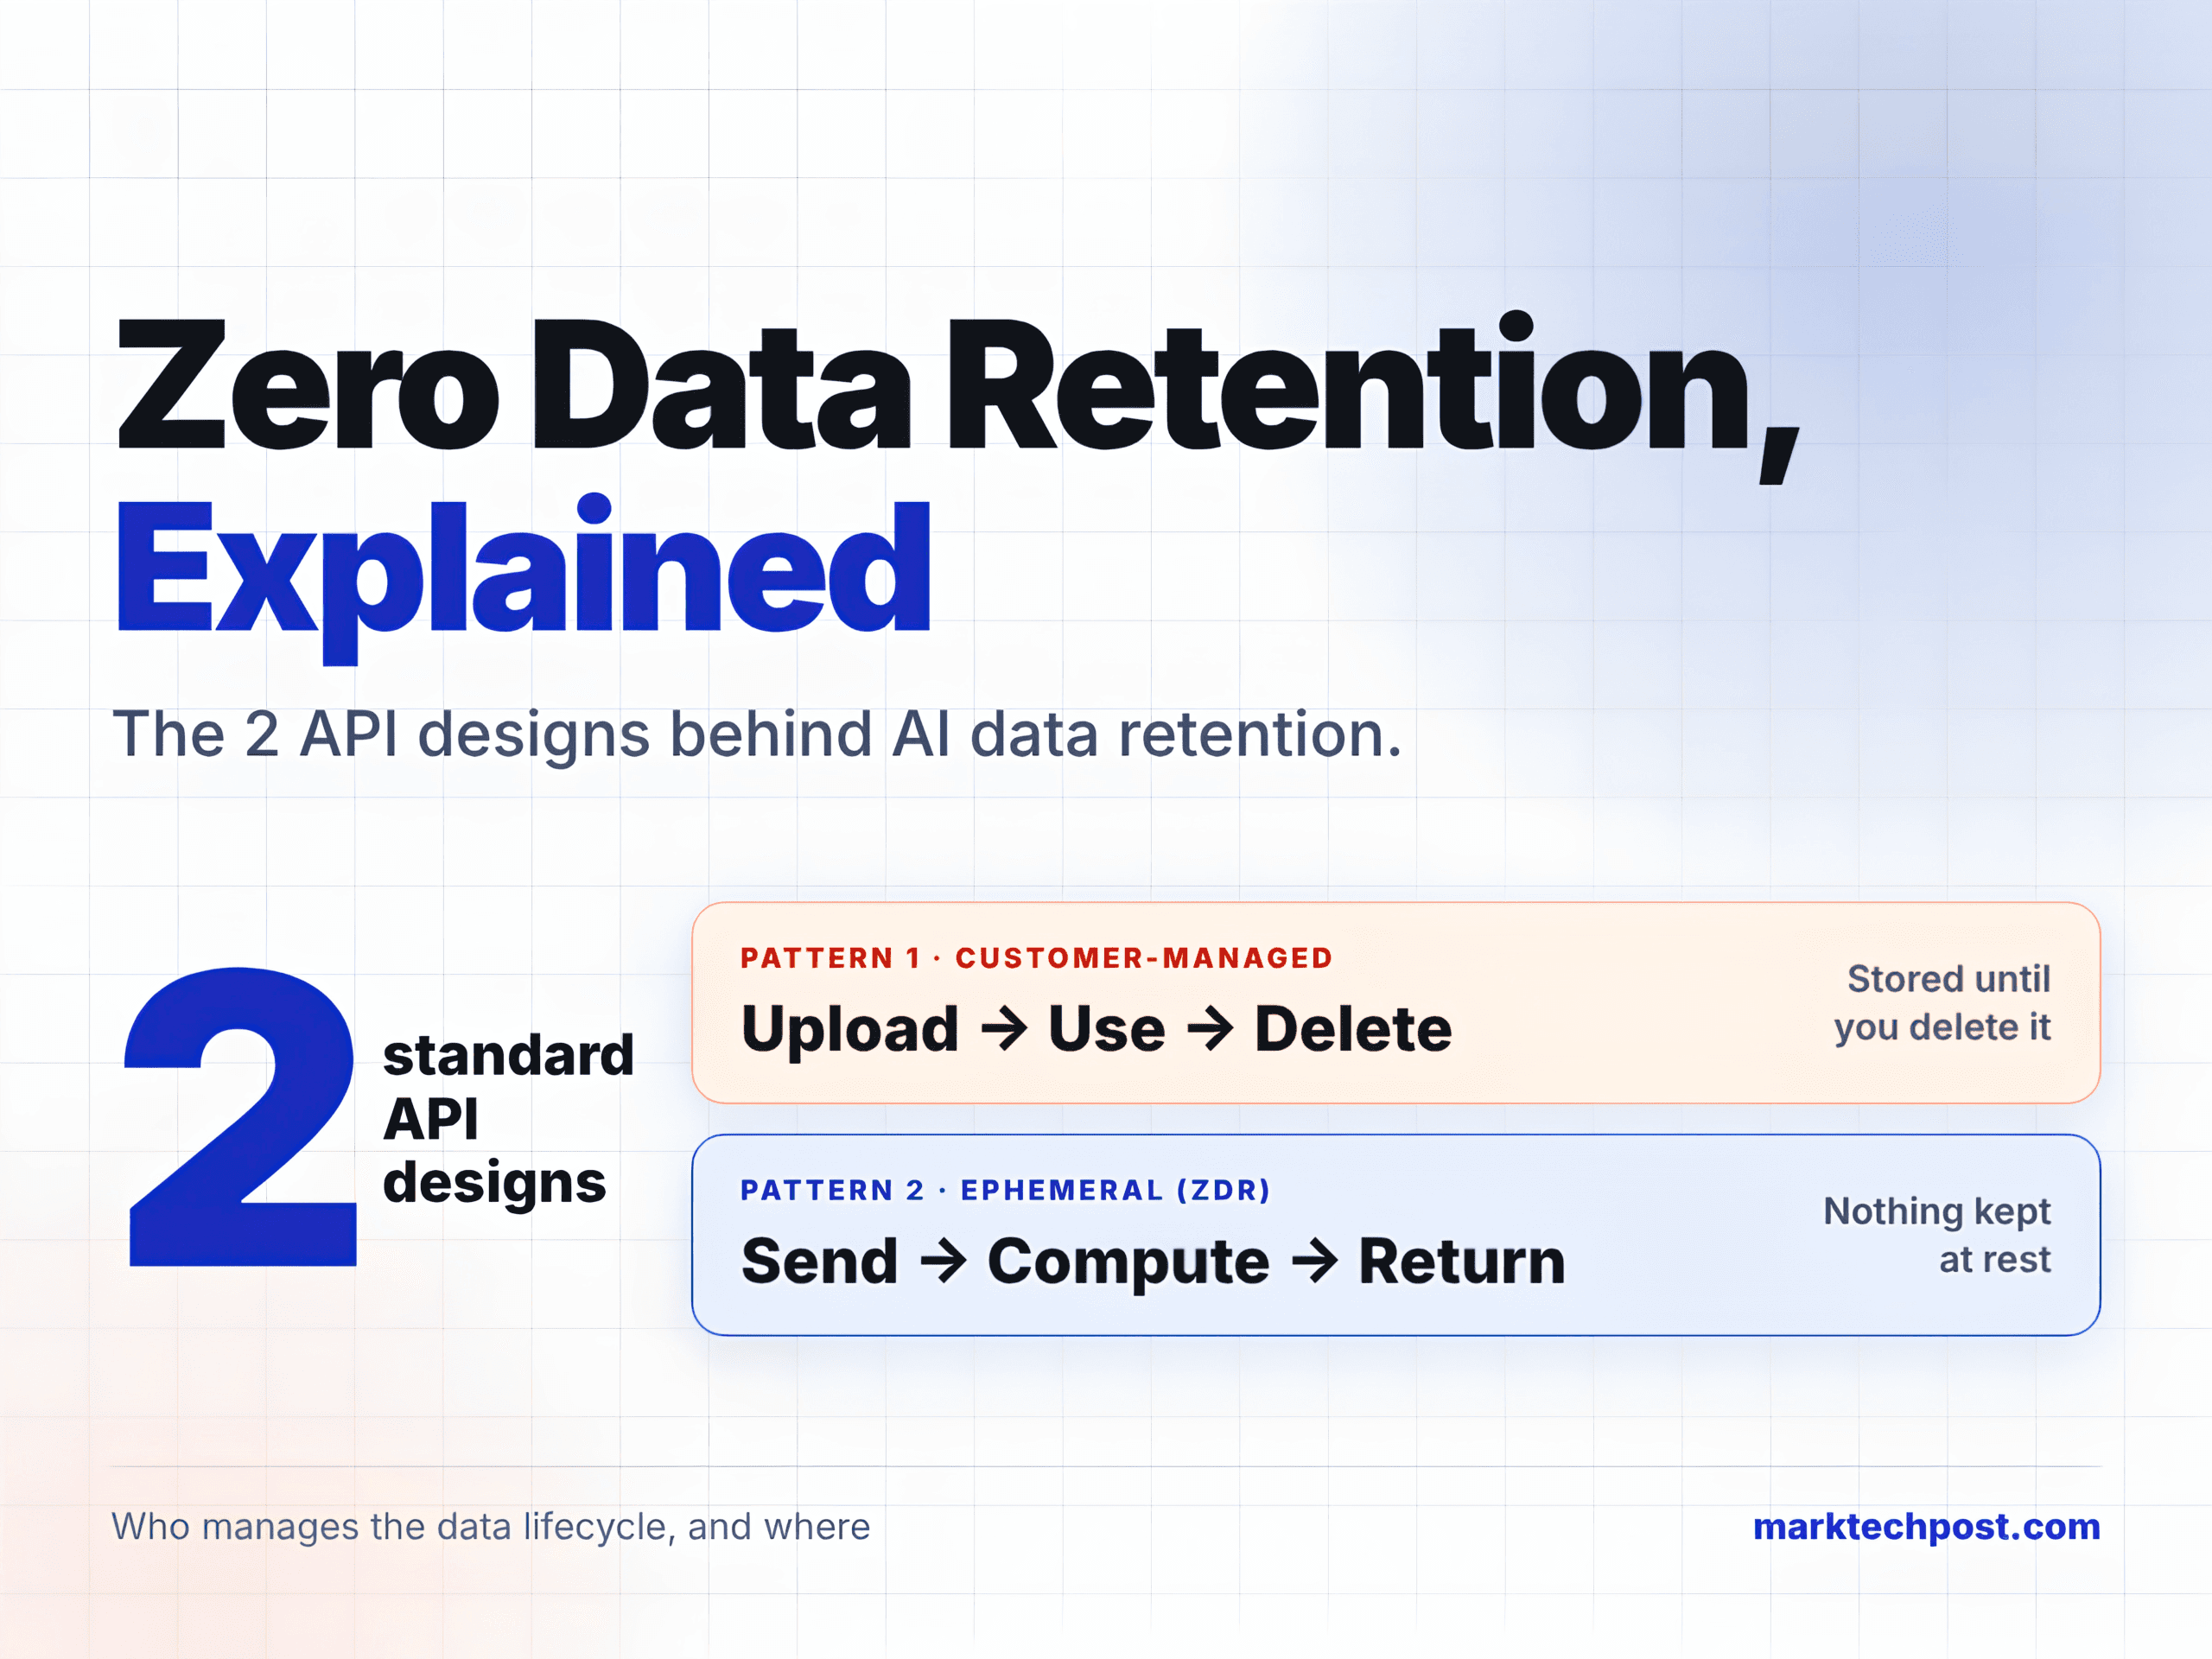
การเก็บรักษาข้อมูล (Data retention) กลายเป็นประเด็นที่มักถูกเข้าใจผิดในโครงสร้างพื้นฐานของ AI ท่ามกลางกระแสความกังวลด้านความปลอดภัย หลายทีมพัฒนาจึงเริ่มตั้งคำถามว่าผู้ให้บริการ AI เก็บข้อมูลส่วนตัวไว้หรือไม่ คำตอบนั้นขึ้นอยู่กับวิธีการส่งข้อมูลของคุณ หากคุณส่งคำสั่ง (prompt) ไปยัง inference API ข้อมูลจะถูกประมวลผลและส่งกลับทันทีโดยไม่มีการจัดเก็บ ซึ่งเรียกว่า zero data retention (ZDR)
อย่างไรก็ตาม หากคุณอัปโหลดชุดข้อมูลสำหรับงานแบบ batch ข้อมูลนั้นจะถูกเก็บไว้จนกว่าคุณจะเป็นผู้สั่งลบ ทั้งสองกรณีล้วนเป็นการออกแบบมาตรฐานที่ลูกค้าเป็นผู้ควบคุมสิ่งสำคัญคือใครเป็นผู้จัดการวงจรชีวิตของข้อมูลและจัดการในจุดใด
Lin Qiao ผู้ร่วมก่อตั้งและ CEO ของ Fireworks AI ได้เสนอแนวคิดที่ชัดเจนเกี่ยวกับเรื่องนี้ผ่าน โพสต์บน X เมื่อวันที่ 13 พฤศจิกายน 2026 โดยอธิบายการออกแบบ API มาตรฐาน 2 แบบที่เป็นตัวกำหนดจุดควบคุมวงจรชีวิตข้อมูล ซึ่งโครงสร้างนี้เป็นพื้นฐานของระบบประมวลผลข้อมูลมานานหลายทศวรรษ บทความนี้จะพาไปเจาะลึกรายละเอียดพร้อมตัวอย่างจากเอกสาร API สากล
TL;DR
- โครงสร้างหลัก: การออกแบบ API มาตรฐาน 2 แบบ คือ "อัปโหลด, ใช้, ลบ" (upload, use, delete) หรือ "ส่ง, ประมวลผล, ส่งกลับ" (send, compute, return)
- ZDR คืออะไร: ข้อตกลงระดับ endpoint ที่จะไม่เก็บ prompt และ output ไว้ถาวรหลังจากเสร็จสิ้นคำขอที่มีสิทธิ์
- จุดที่มีผล: การใช้งานขึ้นอยู่กับ endpoint, request flags และการตั้งค่าบัญชี ไม่ใช่ขึ้นอยู่กับชื่อผู้ให้บริการเพียงอย่างเดียว
- ฟีเจอร์ที่จัดเก็บข้อมูล: งานแบบ Batch, file และ dataset จะเก็บข้อมูลไว้จนกว่าผู้ใช้จะลบหรือข้อมูลหมดอายุเอง
- สรุปสั้นๆ: หากต้องการความเป็นส่วนตัวสูงสุดควรเลือก endpoint แบบชั่วคราว (ephemeral) แต่หากต้องอัปโหลดไฟล์ การลบข้อมูลเป็นหน้าที่ของคุณโดยตรง
นโยบายการเก็บรักษาข้อมูล AI คืออะไร?
นโยบายนี้จะกำหนดว่าแพลตฟอร์มจะจัดเก็บข้อมูลใดจากคำขอของคุณและจัดเก็บไว้นานเท่าใด ตัวอย่างเช่น การควบคุมข้อมูลของ OpenAI แบ่งการจัดเก็บเป็นสองระดับ คือ สถานะแอปพลิเคชัน (Application state) เช่น ไฟล์ที่อัปโหลด และบันทึกการตรวจสอบการละเมิด (Abuse-monitoring logs) ซึ่งเป็นสำเนาเพื่อความปลอดภัย โดยแต่ละระดับอาจมีนโยบายการเก็บข้อมูลที่ต่างกัน
การออกแบบ API ทั่วไป 2 แบบมีอะไรบ้าง?
AI inference และ training API มักดำเนินตามวงจรชีวิต 2 รูปแบบหลัก โดยมีความแตกต่างสำคัญคือผู้ที่ทำหน้าที่จัดการข้อมูล
รูปแบบที่ 1: การเก็บรักษาข้อมูลที่จัดการโดยลูกค้า (อัปโหลด, ใช้, ลบ)
ในรูปแบบนี้คุณต้องสร้างชุดข้อมูล รันงาน แล้วจึงลบทิ้ง แพลตฟอร์มจะเก็บข้อมูลไว้พร้อมใช้งานเสมอจนกว่าจะมีคำสั่งลบ เนื่องจากระบบไม่สามารถทราบได้ว่าคุณใช้งานเสร็จสิ้นเมื่อใด การจัดการข้อมูลจึงเป็นหน้าที่ของนักพัฒนาผ่าน API
ตัวอย่างมาตรฐานของ Batch API ได้แก่:
- OpenAI Batch: อัปโหลดไฟล์ JSONL ก่อนสร้าง batch
- Amazon Bedrock batch inference: เก็บไฟล์อินพุตไว้ใน S3 ที่คุณกำหนดเอง
- Gemini Batch API: รันงานจากไฟล์อินพุตที่เตรียมไว้
- Fireworks AI Batch: สร้างชุดข้อมูลและส่งงานไปประมวลผล
เมื่อมีการลบ ข้อมูลจะหายไปทันที โดย CEO ของ Fireworks ยืนยันว่าแพลตฟอร์ม จะไม่เก็บสิ่งใดไว้หลังจากมีคำขอให้ลบ อย่างไรก็ตามควรตรวจสอบวันหมดอายุอัตโนมัติด้วย เช่น ไฟล์ batch ของ OpenAI จะอยู่ได้ 30 วัน หรือ Anthropic อยู่ได้ 29 วัน เป็นต้น
รูปแบบที่ 2: การประมวลผลแบบชั่วคราว (ส่ง, ประมวลผล, ส่งกลับ)
คุณส่งข้อมูล แพลตฟอร์มประมวลผล และส่งผลลัพธ์กลับโดยไม่มีการคงสถานะไว้ ประวัติการสนทนาจะถูกเก็บไว้ที่ฝั่งแอปพลิเคชันของคุณเอง รูปแบบนี้คือจุดที่ ZDR มีผลใช้บังคับอย่างแท้จริง
ตัวอย่างจากเอกสารทางเทคนิค:
- OpenAI Chat Completions: ค่า
storeเริ่มต้นเป็น false - Amazon Bedrock Converse: ใช้ข้อมูลเพื่อสร้างการตอบสนองเท่านั้น
- Fireworks AI Training SDK: ข้อมูลการฝึก ไม่ได้ถูกจัดเก็บไว้ในหน่วยความจำถาวร
เปรียบเทียบง่ายๆ คือการบันทึกสเปรดชีตลงคลาวด์ไดรฟ์ (รูปแบบที่ 1) เทียบกับการกดตัวเลขบนเครื่องคิดเลข (รูปแบบที่ 2) เครื่องคิดเลขจะส่งคำตอบกลับมาและไม่จำค่าใดๆ ทิ้งไว้
Zero data retention ครอบคลุมทุก endpoint หรือไม่?
คำตอบคือ "ไม่" ZDR ถูกกำหนดเป็นราย endpoint และแต่ละแพลตฟอร์มมีค่าเริ่มต้นต่างกัน เช่น OpenAI จะเก็บ abuse-monitoring logs นาน 30 วัน แต่ Amazon Bedrock ในโหมด none จะไม่เขียนข้อมูลลงหน่วยความจำถาวรเลย
แม้แต่พารามิเตอร์เพียงตัวเดียวก็เปลี่ยนรูปแบบได้ เช่น ใน Interactions API ของ Google ค่า store เริ่มต้นเป็น true ซึ่งหมายถึงมีการเก็บข้อมูล แต่ที่ OpenAI การตั้งค่า store เป็น false ยังไม่ถือเป็น ZDR เต็มรูปแบบ เพราะต้องได้รับอนุมัติก่อน
| แพลตฟอร์ม | Synchronous inference: ค่าเริ่มต้น | ตัวเลือก Zero retention | ฟีเจอร์ที่มีการจัดเก็บ (รูปแบบที่ 1) |
|---|---|---|---|
| OpenAI API | เก็บ abuse-monitoring logs 30 วัน | ZDR ต้องขออนุมัติล่วงหน้า | ไฟล์ Batch หมดอายุใน 30 วัน ไฟล์ทั่วไปอยู่จนกว่าจะลบ |
| Amazon Bedrock | ใช้เนื้อหาเพื่อตอบสนองเท่านั้น | โหมด none ไม่บันทึกลงหน่วยความจำถาวร | Batch inference อ่าน/เขียนบน S3 ของลูกค้า |
| Google Gemini | แคชถาวรล้างออกใน 24 ชั่วโมง | ปิดแคชถาวรและตั้ง store เป็น false | Interactions API เก็บข้อมูล 55 วัน (แบบจ่ายเงิน) |
| Anthropic Claude | ลบภายใน 30 วัน | ZDR ต้องตกลงแยกตามองค์กร | Message Batches เก็บรักษา 29 วัน |
| Fireworks AI | ZDR เป็นค่าเริ่มต้นสำหรับโมเดลเปิด | เป็นค่าเริ่มต้นในหลายบริการ | ชุดข้อมูลคงอยู่จนกว่าลูกค้าจะลบทิ้ง |
ทำไมการประมวลผลแบบชั่วคราว (Ephemeral) จึงปลอดภัยกว่า?
ข้อมูลที่ไม่เคยถูกบันทึกลงดิสก์ย่อมไม่สามารถถูกเจาะหรือรั่วไหลได้ การประมวลผลแบบชั่วคราวช่วยสนับสนุนหลักการ GDPR เรื่องข้อจำกัดในการจัดเก็บข้อมูล (storage limitation) และลดความเสี่ยงจากความผิดพลาดของมนุษย์ เช่น การลืมลบชุดข้อมูลที่เลิกใช้แล้ว
Lin Qiao ระบุว่า "การประมวลผลแบบชั่วคราวเป็นสิ่งที่ควรเลือกใช้มากกว่าเมื่อใดก็ตามที่เวิร์กโฟลว์เอื้ออำนวย" อย่างไรก็ตาม ฟีเจอร์แบบจัดเก็บยังจำเป็นต่องานเฉพาะทาง เช่น การทำ fine-tuning ที่ต้องรันบนชุดข้อมูลเดิมซ้ำๆ
นักพัฒนาควรตรวจสอบอะไรบ้างในตอนนี้?
- ระบุว่าแต่ละ endpoint ที่ใช้งานเป็นรูปแบบที่ 1 (จัดเก็บ) หรือรูปแบบที่ 2 (ชั่วคราว)
- เลือกใช้ endpoint แบบชั่วคราวเป็นค่าเริ่มต้นหากต้องการเพียงผลลัพธ์
- วางแผนการเรียกคำสั่งลบข้อมูลสำหรับการอัปโหลดทุกครั้ง และตรวจสอบ
expires_afterถ้ามี - ตรวจสอบ flag สำคัญ เช่น
storeในคำขอ API - ห้ามใส่ความลับ (secrets) ไว้ใน prompt และหากหลุดเข้าไปให้ทำ Social Engineering หรือเปลี่ยนรหัสผ่านทันที
- ตรวจสอบเงื่อนไข ZDR ในสัญญากับการตั้งค่าในหน้าแดชบอร์ดให้ตรงกัน
สรุปได้ว่า ZDR เป็นคุณสมบัติเฉพาะของจุดเชื่อมต่อ ไม่ใช่ภาพรวมของผู้ให้บริการทั้งหมด นักพัฒนาต้องตระหนักว่าหากมีการอัปโหลดข้อมูล การบริหารจัดการวงจรชีวิตของข้อมูลนั้นถือเป็นความรับผิดชอบของคุณเอง
อ่านเพิ่มเติมได้ที่: โพสต์ของ Lin Qiao, การควบคุมข้อมูล OpenAI, ความปลอดภัย Amazon Bedrock
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร