
Cognition เปิดตัว SWE-2 โมเดลเขียนโค้ดอัจฉริยะ ทรงพลังเทียบชั้นคู่แข่งในราคาที่ถูกกว่า 64%
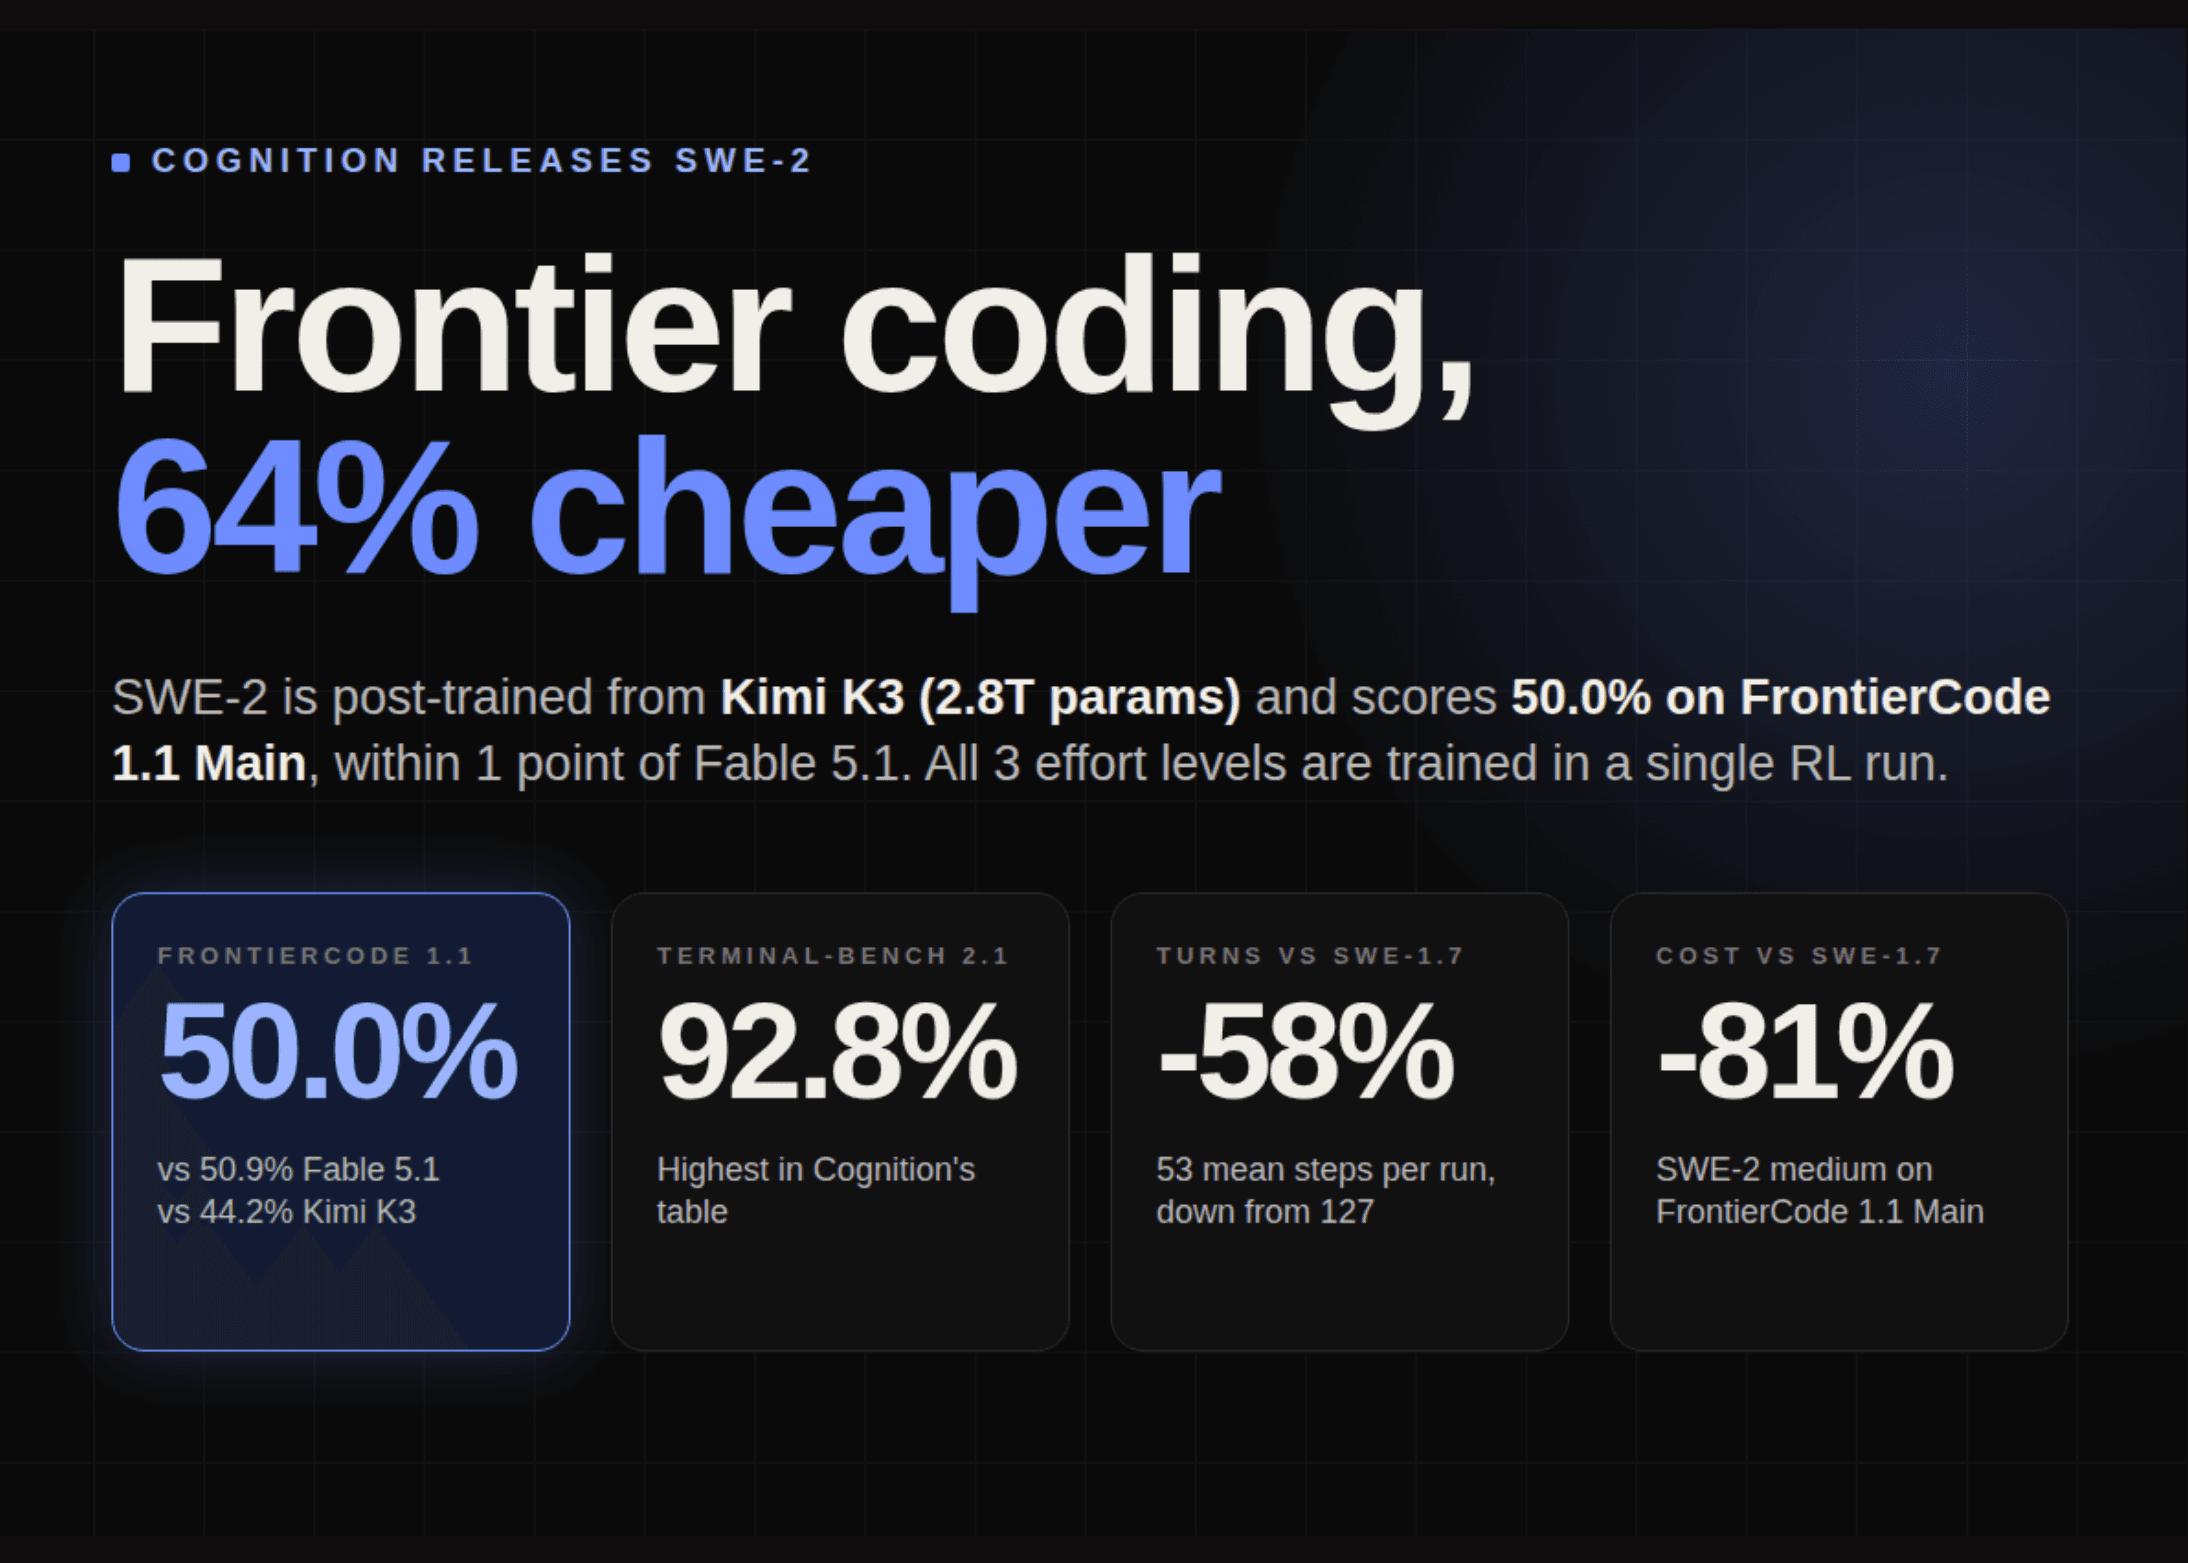
Cognition ผู้พัฒนา Devin เอเจนต์เขียนโค้ดชื่อดัง ประกาศเปิดตัว SWE-2 โมเดลรุ่นใหม่ที่มีประสิทธิภาพสูงที่สุดในปัจจุบัน โดยผ่านกระบวนการ post-trained ด้วย reinforcement learning (RL) จาก Kimi K3 ซึ่งเป็นโมเดลแบบเปิดขนาด 2.8 ล้านล้านพารามิเตอร์ของ Moonshot AI
จากการทดสอบบน FrontierCode 1.1 Main ของ Cognition พบว่า SWE-2 ทำคะแนนได้ 50.0% ซึ่งตามหลัง Fable 5.1 ไม่ถึง 1 จุด แต่มีจุดเด่นสำคัญคือประหยัดค่าใช้จ่ายได้มากกว่าถึง 64% นอกจากนี้ยังเป็นโมเดลแรกของค่ายที่สามารถเลือกปรับระดับความพยายามในการใช้เหตุผล (reasoning-effort levels) ได้ตามความต้องการ ซึ่งทั้งหมดนี้ถูกฝึกฝนในการรัน RL เพียงครั้งเดียว
อย่างไรก็ตาม SWE-2 ไม่ได้เปิดเป็นโมเดลแบบ Open Weights หรือมี API แยกให้ใช้งานทั่วไป แต่จะเปิดให้ใช้งานเฉพาะภายในเครื่องมือของบริษัทอย่าง Desktop และ CLI เท่านั้น ส่วนแพลตฟอร์ม Web และ Fusion จะทยอยเปิดตัวตามมาในภายหลัง
SWE-2 คืออะไร
SWE-2 พัฒนาต่อยอดจากโครงสร้างและสูตรการสร้างของ SWE-1.7 โดยรอบนี้ Cognition ได้ขยายขนาด RL สู่ระดับโมเดลหลายล้านล้านพารามิเตอร์ ซึ่งใช้โมเดลฐานที่มีขนาดพารามิเตอร์มากกว่าเดิมเกือบ 3 เท่า โดยผลการทดสอบชี้ให้เห็นว่า RL ช่วยเพิ่มขีดความสามารถเหนือโมเดล K3 เดิมได้อีก 5 ถึง 6 จุดในหลายเกณฑ์วัด
นวัตกรรมหลักอยู่ที่อัลกอริทึม RL ที่สามารถฝึกฝนระดับความพยายามทั้ง 3 ระดับได้ในการรันครั้งเดียว โดยแต่ละระดับจะมีบทลงโทษด้านต้นทุน (cost penalty) ที่แตกต่างกัน ส่งผลให้ประสิทธิภาพและค่าใช้จ่ายถูกปรับสมดุลให้เคลื่อนที่ไปพร้อมกันอย่างเหมาะสม
ผลลัพธ์ Benchmark
Cognition ได้เผยแพร่ข้อมูลเปรียบเทียบกับคู่แข่งในสภาพแวดล้อมที่ดึงประสิทธิภาพสูงสุดออกมา ดังนี้
| Benchmark | SWE-2 | Kimi K3 | Grok 4.6 | Fable 5.1 | GPT-5.6 Sol | GPT-6 Astra | SWE-1.7 |
|---|---|---|---|---|---|---|---|
| FrontierCode 1.1 Main | 50.0% | 44.2% | 48.0% | 50.9% | 47.5% | 53.3% | 42.0% |
| DeepSWE 1.1 | 73.0% | 68.5% | 67.5% | 67.4% | 72.7% | 74.1% | 37.7% |
| Terminal-Bench 2.1 | 92.8% | 88.3% | 88.4% | 91.4% | 88.8% | 89.9% | 81.5% |
| Terminal-Bench 4 | 27.3% | 21.5% | 20.3% | 55.8% | 37.3% | 57.9% | 7.6% |
SWE-2 แสดงศักยภาพโดดเด่นใน Terminal-Bench 2.1 และทำผลงานได้ดีกว่า K3 ในทุกด้าน โดยมีคะแนนตามหลัง GPT-6 Astra เพียงเล็กน้อยทั้งที่มีต้นทุนแค่ 1 ใน 4 อย่างไรก็ตามยังมีจุดที่ต้องพัฒนาคือ Terminal-Bench 4 ที่ยังตามหลังผู้นำตลาดอยู่ราว 30 จุด
พฤติกรรมของโมเดล: การทำงานที่แม่นยำและกระชับขึ้น
ปัญหาของ SWE-1.7 คือการสำรวจข้อมูลที่มากเกินความจำเป็น (over-explore) ในงานง่ายๆ ซึ่ง SWE-2 ได้รับการแก้ไขผ่านแนวทาง focused exploration ส่งผลให้ในระดับ Medium โมเดลสามารถทำคะแนนแซงรุ่นพี่ได้โดยใช้จำนวนรอบ (turns) น้อยลงถึง 58% และลดต้นทุนได้ 81%
ข้อมูลระบุว่าค่าเฉลี่ยขั้นตอนการทำงานลดลงอย่างเห็นได้ชัด โดย SWE-2 ระดับ Medium สามารถเริ่มแก้ไขงานจริงได้ในขั้นตอนที่ 18 เท่านั้น นอกจากนี้ทีมพัฒนายังพบพฤติกรรมเชิงบวก เช่น การทดสอบแบบ end-to-end ที่ดีขึ้น และความสามารถในการตรวจสอบตัวเองเพื่อหาข้อสรุปใหม่แทนการย้ำความผิดพลาดเดิม
เบื้องหลังการฝึกฝน
เทคนิค Pareto-informed cost penalties ถูกนำมาใช้เพื่อปรับสมดุลระหว่างความสำเร็จและต้นทุน โดยใช้บทลงโทษเชิงเส้น (linear penalty) เพื่อให้เป้าหมายของ RL สอดคล้องกับค่าใช้จ่ายจริงในสกุลเงิน USD และเวลาที่ใช้ ซึ่งค่า lambda ของแต่ละระดับความพยายามจะถูกคำนวณจากความชันของเส้นโค้ง Pareto ของโมเดลฐาน
นอกจากนี้ยังมีการใช้ Length-weighted reward baseline เพื่อลดความคลาดเคลื่อนในช่วงการฝึกฝน และระบบ Rollout serving ที่ใช้เทคนิค prefill delayer ร่วมกับ DSpark speculative decoding เพื่อเพิ่มความเร็วในการประมวลผลให้สูงขึ้น 10-20%
ทางด้านข้อมูล Cognition ได้เพิ่มสภาพแวดล้อมการเรียนรู้เป็น 3 เท่า และสร้างระบบ flywheel เพื่อใช้ checkpoint ของโมเดลรุ่นก่อนหน้าในการปรับปรุงตัวตรวจสอบ (verifiers) ให้แม่นยำยิ่งขึ้น ลดปัญหาการแจ้งผลผิดพลาดทั้งในรูปแบบผลบวกปลอมและผลลบปลอม
ความน่าเชื่อถือและความปลอดภัย
จากการประเมินด้านความน่าเชื่อถือผ่านคำถามที่อ่อนไหวทางการเมืองเกี่ยวกับประเทศจีนจำนวน 145 ข้อ SWE-2 สามารถผ่านเกณฑ์ได้สูงถึง 98.0% ในภาพรวม แบ่งเป็นภาษาอังกฤษ 99.8% และภาษาจีนที่ครอบคลุมทั้งตัวย่อและตัวเต็ม นอกจากนี้การทดสอบช่องโหว่ตามบริบทการใช้งานของลูกค้ายังไม่พบความผิดปกติที่มีนัยสำคัญทางสถิติ
สรุปประเด็นสำคัญ
- SWE-2 ทำคะแนนได้ 50.0% บน FrontierCode 1.1 Main เทียบชั้น Fable 5.1 ในราคาที่ประหยัดกว่า 64%
- พัฒนาจาก Kimi K3 ขนาด 2.8 ล้านล้านพารามิเตอร์ โดย RL ช่วยยกระดับประสิทธิภาพขึ้นอย่างชัดเจน
- มีโหมดปรับระดับความพยายาม (effort levels) ซึ่งช่วยลดต้นทุนได้สูงสุดถึง 81% เมื่อเทียบกับรุ่นก่อน
- ใช้งานได้ผ่านแพลตฟอร์ม Devin เท่านั้น โดยผู้ใช้งานระดับที่ชำระเงินสามารถใช้งานได้ฟรีจนถึงวันที่ 10 ตุลาคม 2026
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร