
ลดต้นทุน AI ด้วยตัวจำแนกประเภทงาน ระหว่าง Gemini และระดับการคิด
3 พ.ย. 2026
แม้ราคา API ต่อโทเค็นจะลดลงอย่างต่อเนื่อง แต่ค่าใช้จ่ายวิศวกรรมสำหรับเอเจนต์เขียนโค้ดอัตโนมัติกลับสูงขึ้น ทำให้ราคาต่อล้านโทเค็นไม่ใช่ตัวชี้วัดความคุ้มค่าอีกต่อไป หัวใจสำคัญในปัจจุบันคือ "ต้นทุนต่อหนึ่งงานที่สำเร็จ" (cost per successful task) ซึ่งคำนวณจากค่าใช้จ่ายทั้งหมดในกระบวนการทำงาน หารด้วยจำนวนงานที่ผ่านการตรวจสอบจริง
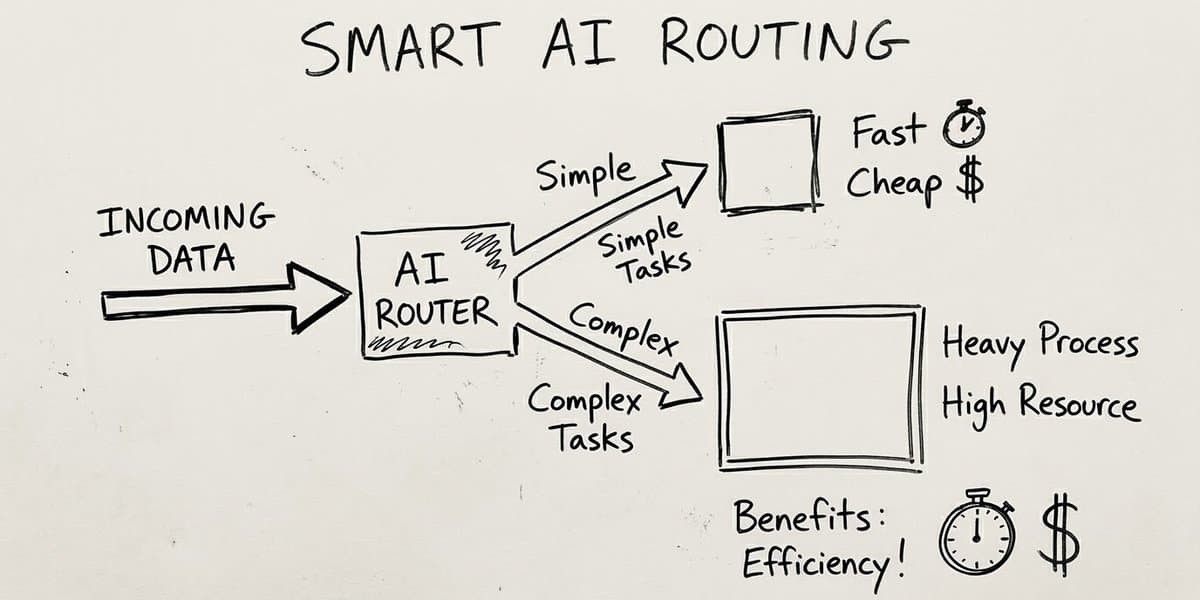
การใช้โมเดลการใช้เหตุผลขั้นสูง (high-thinking reasoning) กับทุกการตัดสินใจย่อยในระบบ ทำให้คุณต้องจ่ายราคาแพงเกินความจำเป็นสำหรับคำถามที่โมเดลรุ่นเล็กตอบได้แม่นยำอยู่แล้ว ทางออกคือการเพิ่มเลเยอร์การจัดเส้นทาง (routing layer) แบบน้ำหนักเบาเพื่อสกัดกั้นงานที่เป็นกิจวัตรก่อนส่งไปยังโมเดลราคาแพง
นี่คือแนวคิดการใช้ตัวจำแนกประเภท (classifier) Jev จาก TypeSafe วางไว้หน้าการเรียกโมเดล Google Antigravity แทนที่จะสร้างข้อความทีละโทเค็น Jev จะประเมินค่าพื้นฐานแบบมีโครงสร้างในการประมวลผลรอบเดียว (single forward pass) ไม่ว่าจะเป็น Choice จากรายการ, Score หรือ Noul ซึ่งให้ค่าความน่าจะเป็น 0 ถึง 1 สำหรับคำถามแบบไบนารี
ทั้งนี้ Google ไม่ได้เป็นพันธมิตรหรือรับรองผลิตภัณฑ์ของ TypeSafe โดย Jev ถูกยกมาเป็นเพียงตัวอย่างของตัวจำแนกประเภทน้ำหนักเบา ซึ่งคุณสามารถสร้างรูปแบบเดียวกันนี้ด้วยเครื่องมืออื่นได้ เช่น Codelab Getting started with discriminative models ที่ใช้ DiffusionGemma โมเดล open-weights จาก Google DeepMind บนโปรเจกต์ Google Cloud ของคุณ
จากการทดสอบเบนช์มาร์กเอเจนต์เขียนโค้ด 50 คำถาม พบว่าการขอให้ Jev จัดเส้นทางด้วยคำถามกว้างๆ แบบ simple หรือ complex มักจะได้ผลไม่ดีนัก โดย Jev มักส่งงานไปที่ simple เกือบทั้งหมด แม้จะเป็นงานยาก การแก้ไขคือต้องย่อยคำถามให้เป็นการตรวจสอบแบบอะตอม (atomic check) ผ่านคำถาม Noul ซึ่งช่วยให้การแยกประเภทแม่นยำขึ้นทันที
def call_jev(question_text):
    body = {
        "state": question_text,
        "model": "jev-latest",
        "questions": {
            "multi_step": {
                "type": "noul",
                "instructions": (
                    "Answering this requires performing more than one "
                    "sequential calculation, simulation step, or logical "
                    "deduction, rather than a single direct lookup, format "
                    "check, or one-step classification."
                ),
            }
        },
    }
    # Send the request above to the classifier's API.
    # response.answers["multi_step"].noul is the probability used to route.
จากการทดสอบในงานใหม่ (held-out tasks) 34 ข้อ Jev จำแนกงานที่ไม่เคยเห็นได้ถูกต้อง 100% ขณะที่การใช้ฮิวริสติกคีย์เวิร์ดหรือความยาวพรอมต์แบบเดิมมีคะแนนตกลงเหลือเพียง 70.6% เนื่องจากงานง่ายบางอย่างมีความยาวพรอมต์สูงทำให้เกิดการยกระดับที่ผิดพลาด (false escalations) ขณะที่งานยากบางอย่างใช้คำสั้นกระชับจนถูกจัดไปเส้นทางราคาถูกอย่างไม่ถูกต้อง
ข้อมูลยังระบุว่าการจำกัด maxOutputTokens ต่ำในโมเดลการใช้เหตุผลไม่ได้ช่วยประหยัดเงินในงานง่าย เพราะโมเดลยังคงใช้โทเค็นการคิด (thinking tokens) เท่าเดิม สิ่งเดียวที่เกิดขึ้นคือทำให้งานยากล้มเหลวเพราะพื้นที่ประมวลผลหมดก่อนได้คำตอบ
ดังนั้น วิธีที่เห็นผลที่สุดคือการปรับระดับการคิดโดยตรง เราได้ทดสอบโดยใช้ Gemini 3.8 Flash ที่ตั้งค่า thinkingLevel ไว้ที่ต่ำ (LOW) ซึ่งสามารถแก้ปัญหาได้ครบ 50 งาน เมื่อนำมาใช้ร่วมกับเราเตอร์ Jev ที่ส่งงานง่ายไป Flash-Lite และยกระดับงานยากไป Flash ระดับ LOW ผลลัพธ์ที่ได้คือความแม่นยำ 100% พร้อมต้นทุนและเวลาตอบสนองที่ลดลง
อย่างไรก็ตาม การจัดเส้นทาง (Routing) และการทำแคช (Caching) อาจมีทิศทางตรงกันข้ามกัน เนื่องจากแคชจะผูกกับโมเดลใดโมเดลหนึ่ง การสลับโมเดลไปมาอาจทำให้เสียส่วนลดค่าโทเค็นจาก Context Caching ได้ คำแนะนำคือให้จัดเส้นทางเฉพาะงานที่สั้นและจบในตัว ส่วนเทิร์นที่ยาวและมีบริบทหนักควรคงไว้ในโมเดลเดียว
สรุปกฎ 3 ข้อเพื่อความคุ้มค่า: 1. เริ่มต้นด้วย Flash ในการคิดระดับต่ำ (thinkingLevel: "LOW") 2. ใช้ตัวจำแนกประเภทอย่าง Jev จัดเส้นทางงานสั้นที่จบในตัว และ 3. วัดผลจากต้นทุนต่อหนึ่งงานที่สำเร็จจริงผ่าน Cloud Logging และ BigQuery เพื่อดูประสิทธิภาพที่แท้จริงของเอเจนต์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร