
Palette: ฝึกโมเดลจิ๋วสร้างสไลด์ตามดีไซน์ IBM โค่น Frontier AI
เมื่อขอให้ frontier model สร้างสไลด์ คุณจะได้ผลงานที่ดี แต่ถ้าขอสักสิบชุด พวกมันจะเริ่มดูคล้ายกันไปหมด ทั้งค่าเริ่มต้นและสไตล์จะมีกลิ่นอายของ "สไลด์ที่สร้างโดย AI" จางๆ ซึ่งเป็นปัญหาหากคุณต้องการให้สไลด์ตรงตามเทมเพลตเฉพาะขององค์กร เนื่องจาก frontier model มักจะยึดติดกับสไตล์ตัวเองและยากจะควบคุมผ่านการทำ prompting นอกจากนี้ข้อมูลเนื้อหาบางอย่างยังเป็นความลับที่ไม่สามารถส่งออกจากระบบได้
ด้วยเหตุนี้ การใช้โมเดลที่คุณเป็นเจ้าของเองแบบ open weights ที่รันบนโครงสร้างพื้นฐานและฝึกด้วยภาษาการออกแบบ (design language) ของตัวเองจึงเป็นทางออกที่ตอบโจทย์กว่า ทว่าโมเดลขนาดเล็กที่เหมาะกับการทำ self-host มักจะสร้างสไลด์ได้ไม่ดีนัก เช่น พาดหัวหายไปในพื้นหลัง ข้อความล้นสไลด์ หรือรูปทรงวางซ้อนทับกัน
Palette ถูกสร้างขึ้นเพื่อทดสอบสมมติฐานว่า โมเดล open-weight ขนาดเล็กที่ฝึกด้วยข้อมูลสังเคราะห์และตรวจสอบโดยระบบ harness สามารถแข่งขันกับ frontier model ได้ในขณะที่ยังรักษาความเป็นเจ้าของผลลัพธ์ไว้ เราได้ทำการ fine-tune โมเดลขนาด 20B ให้ทำงานเหมือนมนุษย์ โดยแบ่งบทบาทเป็นนักออกแบบผู้วางแผนและนักเขียนโค้ดผู้วาดสไลด์ ข้อมูลการฝึกอ้างอิงตาม IBM Design Language และจากการทดสอบใน PresentBench พบว่าโมเดลนี้คว้าอันดับหนึ่งในสองจากสามโดเมนที่วัดผล
ทำไมการทำสไลด์ถึงเป็นเรื่องยากสำหรับโมเดลขนาดเล็ก
การสร้างสไลด์โชว์ดูเหมือนง่าย แต่ต้องใช้ทักษะสามด้านที่โมเดลขนาดเล็กมักทำได้ไม่ดี:
-
การวางเลย์เอาต์โดยไม่เห็นผลลัพธ์: โมเดลไม่ได้วาดรูปโดยตรง แต่เขียนโค้ดกำหนดค่า x, y และขนาดฟอนต์ ซึ่งต้องคำนวณในใจว่าข้อความจะล้นหรือไม่ โมเดลขนาดเล็กมักคำนวณพลาดจนองค์ประกอบซ้อนทับกัน
-
การตัดสินใจสองด้านพร้อมกัน: โมเดลต้องคิดทั้งเนื้อหา (จะใช้แผนภูมิหรือตาราง) และเรขาคณิต (การวางตำแหน่ง) ให้สอดคล้องกันตลอดทั้งชุดสไลด์
-
ขาดข้อมูลขั้นตอนการสร้าง: แม้จะมีสไลด์ที่เสร็จสมบูรณ์มากมาย แต่กลับไม่มีข้อมูลที่อธิบายเหตุผลเบื้องหลังการเลือกดีไซน์หรือโค้ดที่ใช้สร้างขึ้นมา
สร้างแบบมนุษย์: นักออกแบบและนักเขียนโค้ด
Palette แบ่งการทำงานออกเป็นสองบทบาทผ่าน LoRA adapter ตัวเดียว เพื่อเลียนแบบขั้นตอนการทำงานของมนุษย์:
- นักออกแบบ (designer): อ่านแผนงานและเขียนบรีฟ JSON กำหนดจานสี ระบบตัวอักษร เลย์เอาต์ และเหตุผลการออกแบบ
- นักเขียนโค้ด (coder): รับบรีฟมาเขียน JavaScript ของ pptxgenjs เพื่อวาดสไลด์ทีละหน้า
การแยกบทบาททำให้แต่ละส่วนตัดสินใจเพียงเรื่องเดียว และเนื่องจากบรีฟถูกกำหนดไว้ล่วงหน้า การเขียนโค้ดจึงทำแบบขนานได้พร้อมกันหลายหน้า ส่งผลให้ทำงานเร็วขึ้น 6-7 เท่า เราเลือกใช้ LoRA ในการฝึกเพื่อรักษาความรู้เดิมของโมเดลฐานและประหยัดต้นทุน โดยพบว่าต้องทำการเพิ่มจำนวนตัวอย่าง (oversample) ของฝั่งนักออกแบบขึ้น 5 เท่าเพื่อให้สมดุลกับฝั่งนักเขียนโค้ดที่มีข้อมูลยาวกว่า
การสังเคราะห์สไลด์และเหตุผลเบื้องหลัง
เราสร้างชุดข้อมูลขึ้นเองโดยใช้โมเดล open ขนาดใหญ่เป็นผู้สอน (teacher) ครอบคลุมสไลด์ประมาณ 10,000 หน้า ทุกตัวอย่างจะมีเหตุผลเบื้องหลังแบบสมมติทางเลือก (counterfactual) เพื่อสอนให้โมเดลเรียนรู้ "กฎ" ไม่ใช่แค่ "ตัวเลือก" เช่น การเลือกแผนภูมิแท่งแทนตารางเพื่อแสดงแนวโน้มที่ชัดเจน หรือการลดขนาดฟอนต์เพื่อไม่ให้ทับแผนภูมิ
ข้อมูลที่สังเคราะห์ขึ้นจะถูกตรวจสอบด้วย harness หากพบสไลด์ที่เสียจะถูกซ่อมแซมและเขียนเหตุผลใหม่ว่าเลย์เอาต์เดิมผิดอย่างไร สิ่งที่น่าสนใจคือ การใช้สไลด์อ้างอิง (reference decks) ใน prompt ของโมเดลผู้สอนให้ผลลัพธ์ที่แม่นยำกว่าการเพิ่มกฎเกณฑ์เพียงอย่างเดียว
การสั่งการสไลด์ด้วยภาษาอังกฤษทั่วไป
ผู้ใช้สามารถควบคุมดีไซน์ได้ผ่าน directives หรือคำสั่งสั้นๆ ในแผนงานที่ห่อด้วย [[ ]] เช่น:
## แผนการเปิดตัว
- มีนาคม: โครงการนำร่องกับสองทีม
- พฤษภาคม: ตรวจสอบความปลอดภัยเสร็จสิ้น
[[ทำอันนี้เป็นไทม์ไลน์]]
โมเดลถูกฝึกให้เข้าใจเจตนาจาก 12 หมวดหมู่คำสั่ง ไม่ว่าจะเป็นเรื่องเลย์เอาต์ โทนเสียง หรือกลุ่มผู้ฟัง เพื่อเปลี่ยนรูปแบบการนำเสนอให้ตรงใจผู้ใช้ที่สุด
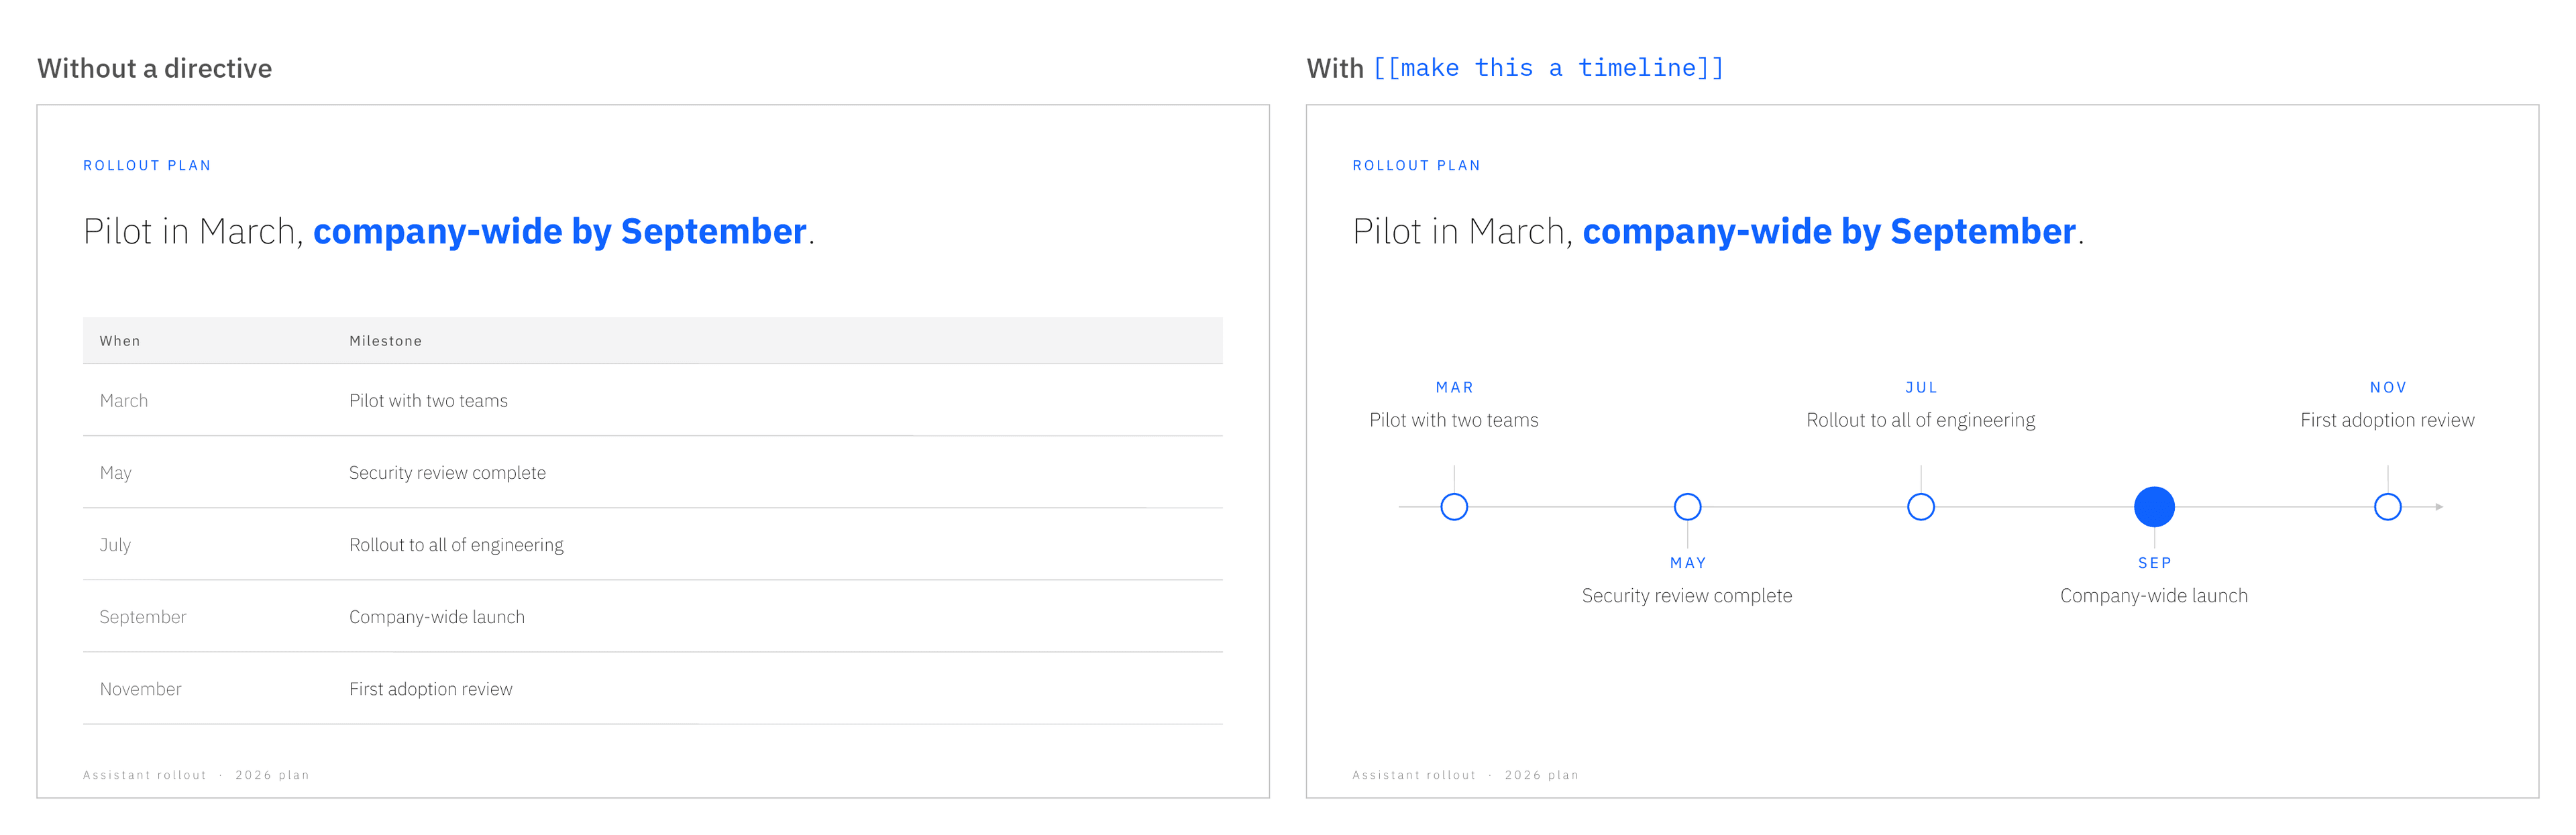
รูปที่ 1. ภาพประกอบของแผนงานเดียวกันแบบไม่มี (ซ้าย) และแบบมี (ขวา) directive [[make this a timeline]]
การสร้างระบบตรวจสอบและซ่อมแซม (Check-and-Repair Harness) เพื่อป้องกันข้อผิดพลาด Palette จะส่งสไลด์ผ่านระบบ harness ก่อนส่งมอบผลลัพธ์
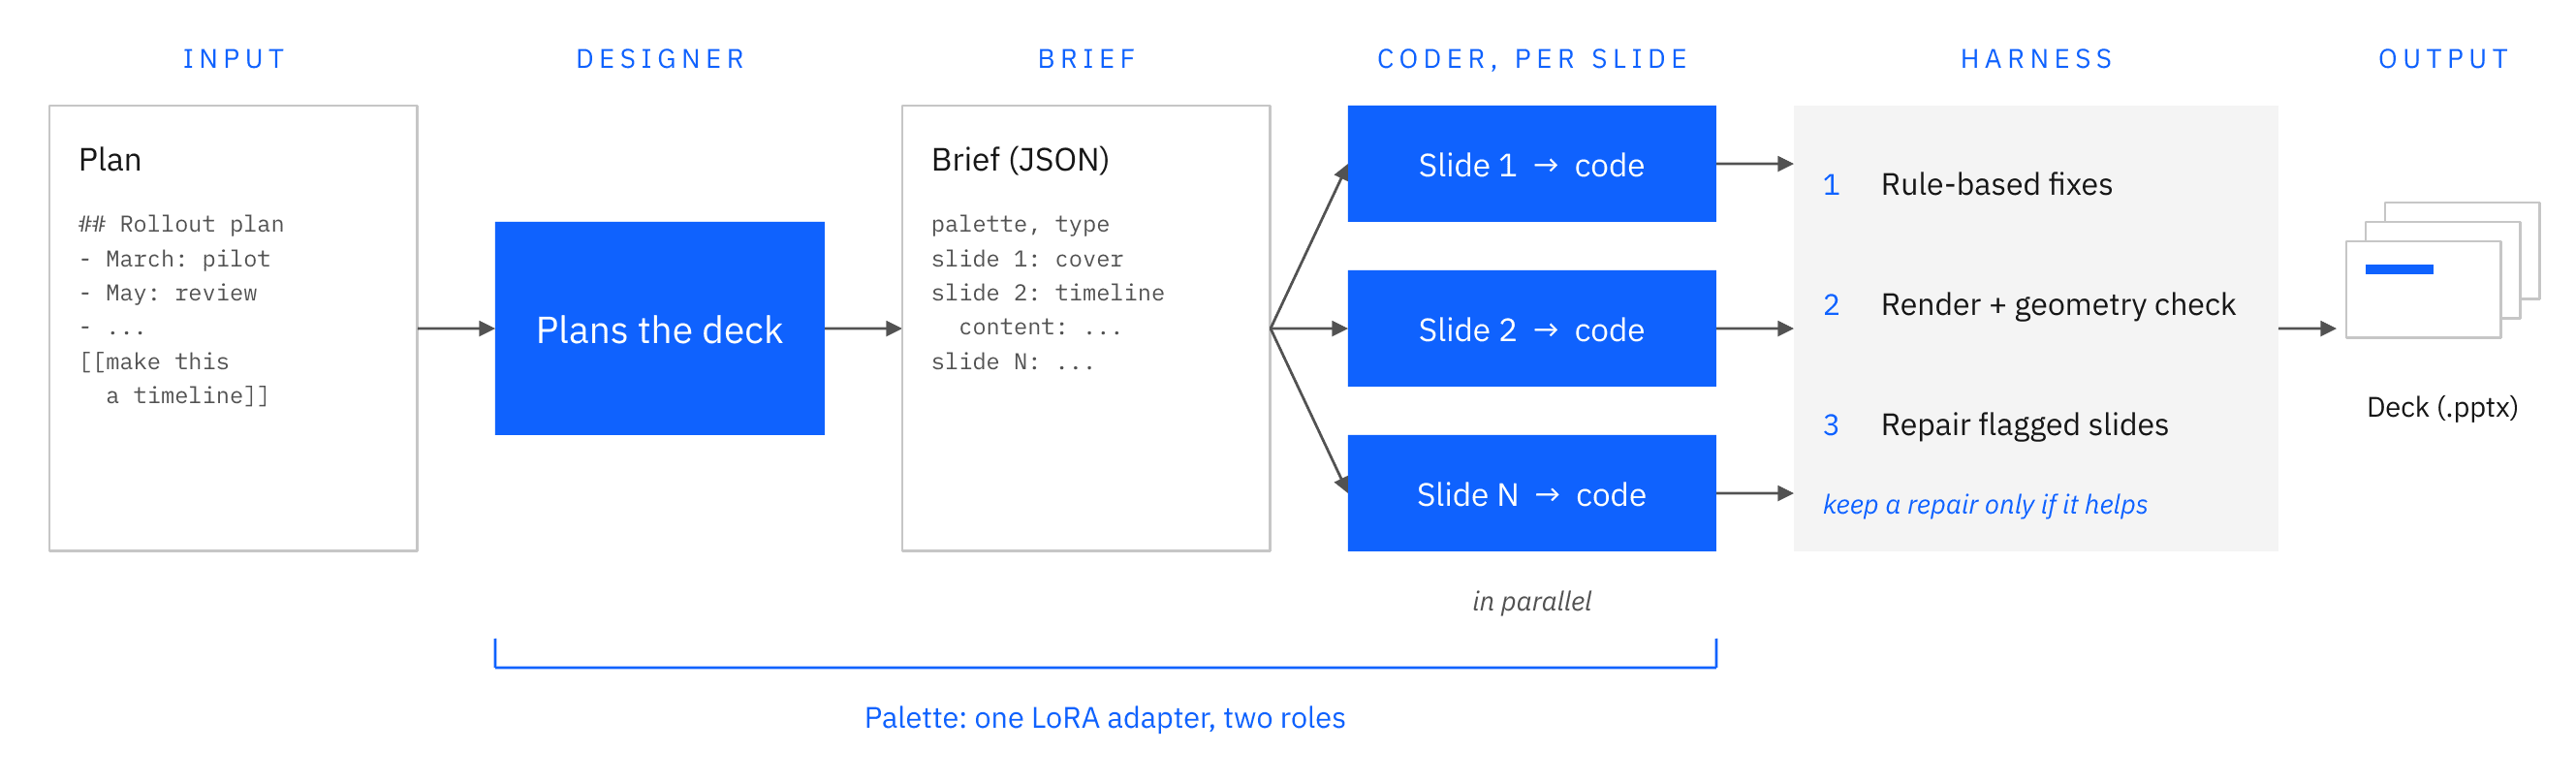
รูปที่ 2. นักออกแบบร่างบรีฟ, นักเขียนโค้ดเขียนโค้ดของแต่ละสไลด์พร้อมกัน และ harness จะตรวจสอบและซ่อมแซมทุกสไลด์ก่อนจะส่งมอบชุดสไลด์
ระบบจะใช้กฎพื้นฐานแก้สีที่ผิดเพี้ยน จากนั้นจะเรนเดอร์สไลด์เพื่อตรวจการซ้อนทับ หากพบปัญหาก็จะส่งให้โมเดลแก้ไข (editor model) เขียนโค้ดใหม่ โดยจะเก็บผลลัพธ์ใหม่ไว้ก็ต่อเมื่อตัวตรวจสอบยืนยันว่าดีขึ้นเท่านั้น ในการทดสอบพบว่า harness ช่วยเพิ่มคะแนนเฉลี่ยได้ถึง 3.5 คะแนน
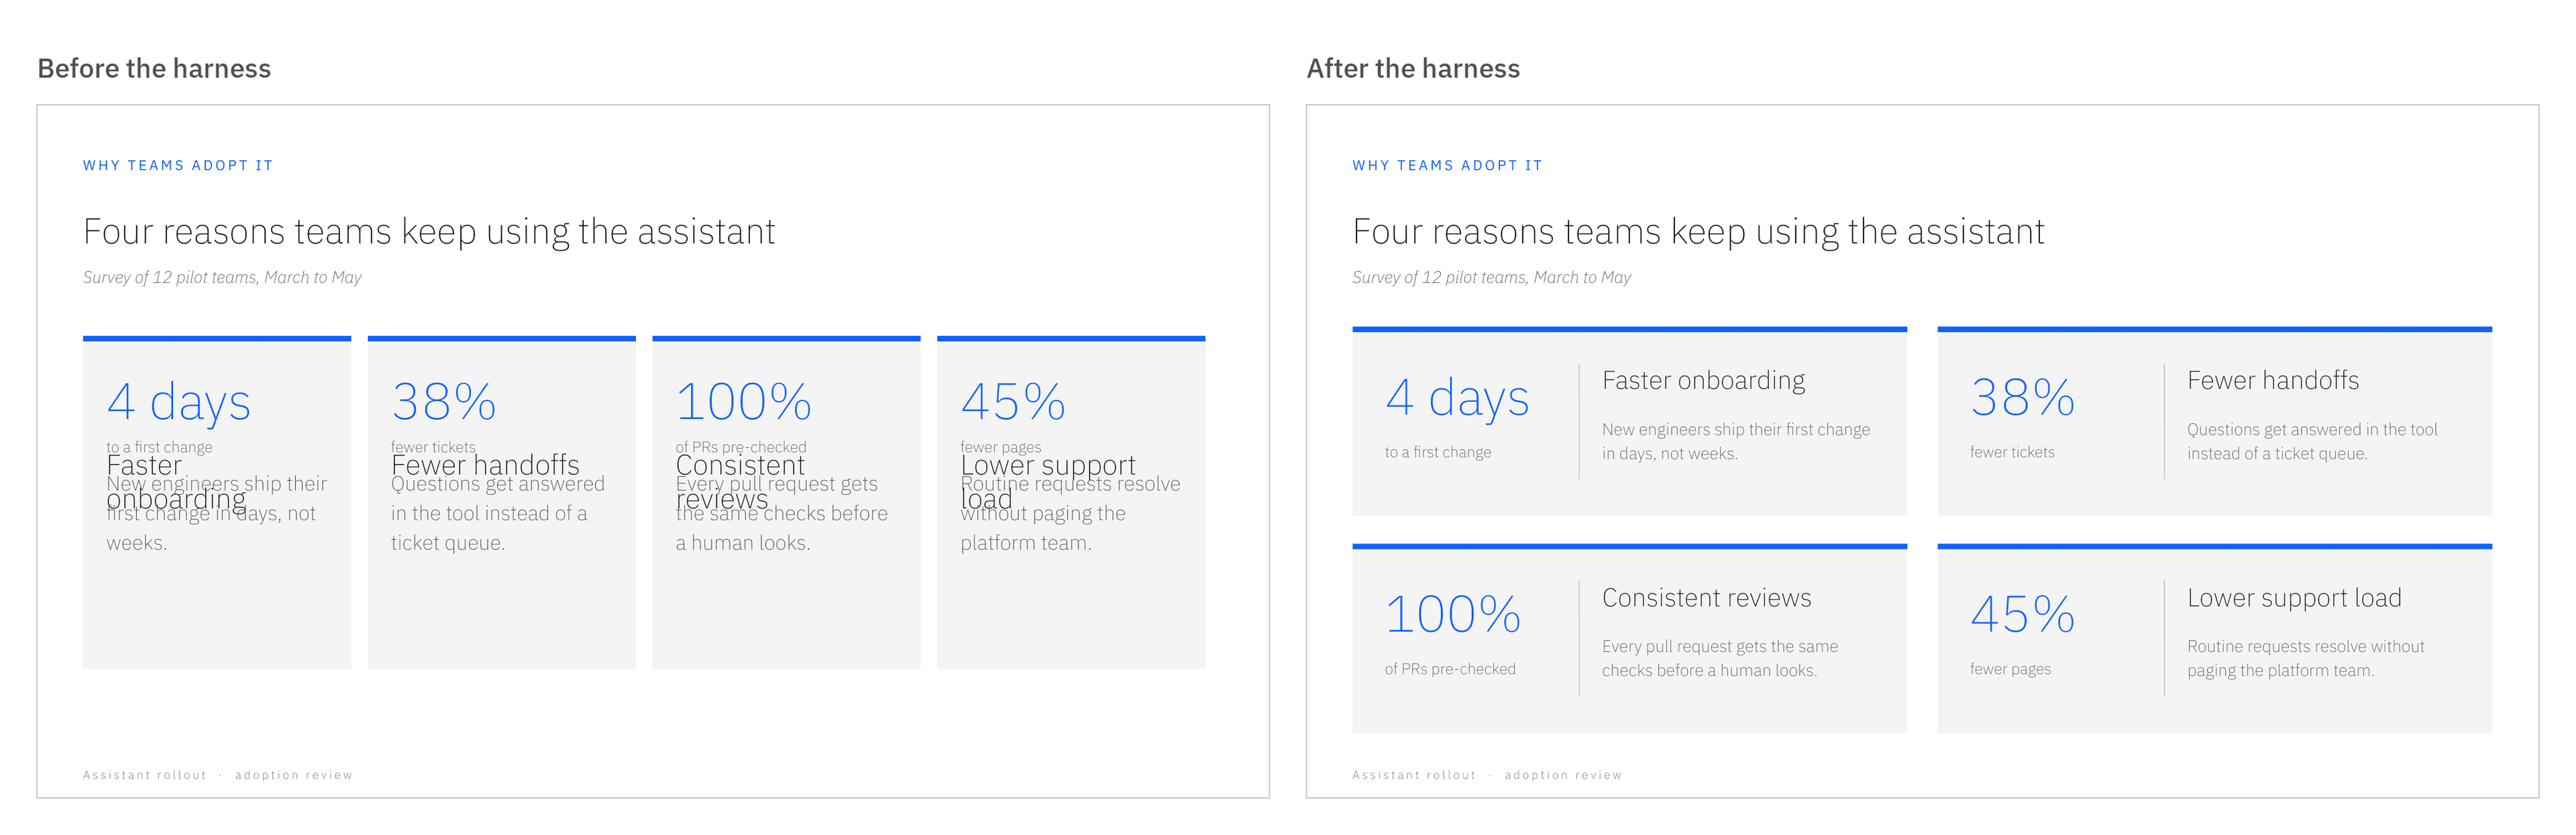
รูปที่ 3. ภาพประกอบของการซ่อมแซม เมื่อเริ่มสร้าง (ซ้าย) พาดหัวของแต่ละการ์ดวางทับซ้อนกับคำอธิบาย; harness ตรวจพบการซ้อนทับและจัดเรียงการ์ดใหม่เป็นตารางแบบ 2x2 (ขวา)
การประเมินผลและการพัฒนาต่อ
ในด้านการทดสอบกับ PresentBench Palette คว้าอันดับหนึ่งในด้านเศรษฐศาสตร์และการศึกษา และได้อันดับสองเมื่อเฉลี่ยทุกโดเมน โดยแพ้ NotebookLM ไปเพียง 1.1 คะแนน แม้จะเป็นโมเดลขนาดเล็กเพียง 20B
ก้าวต่อไปคือการนำการตรวจสอบนี้มาใช้เป็นรางวัลในการเรียนรู้แบบเสริมกำลัง (reinforcement learning) ด้วยเทคนิค GRPO เพื่อให้โมเดลเก่งขึ้นตั้งแต่ต้น รวมถึงการดึงรูปภาพจากเอกสารต้นทางผ่าน Docling และการนำเทมเพลตจากไฟล์ .pptx ของผู้ใช้มาประยุกต์ใช้โดยไม่ต้องฝึกใหม่
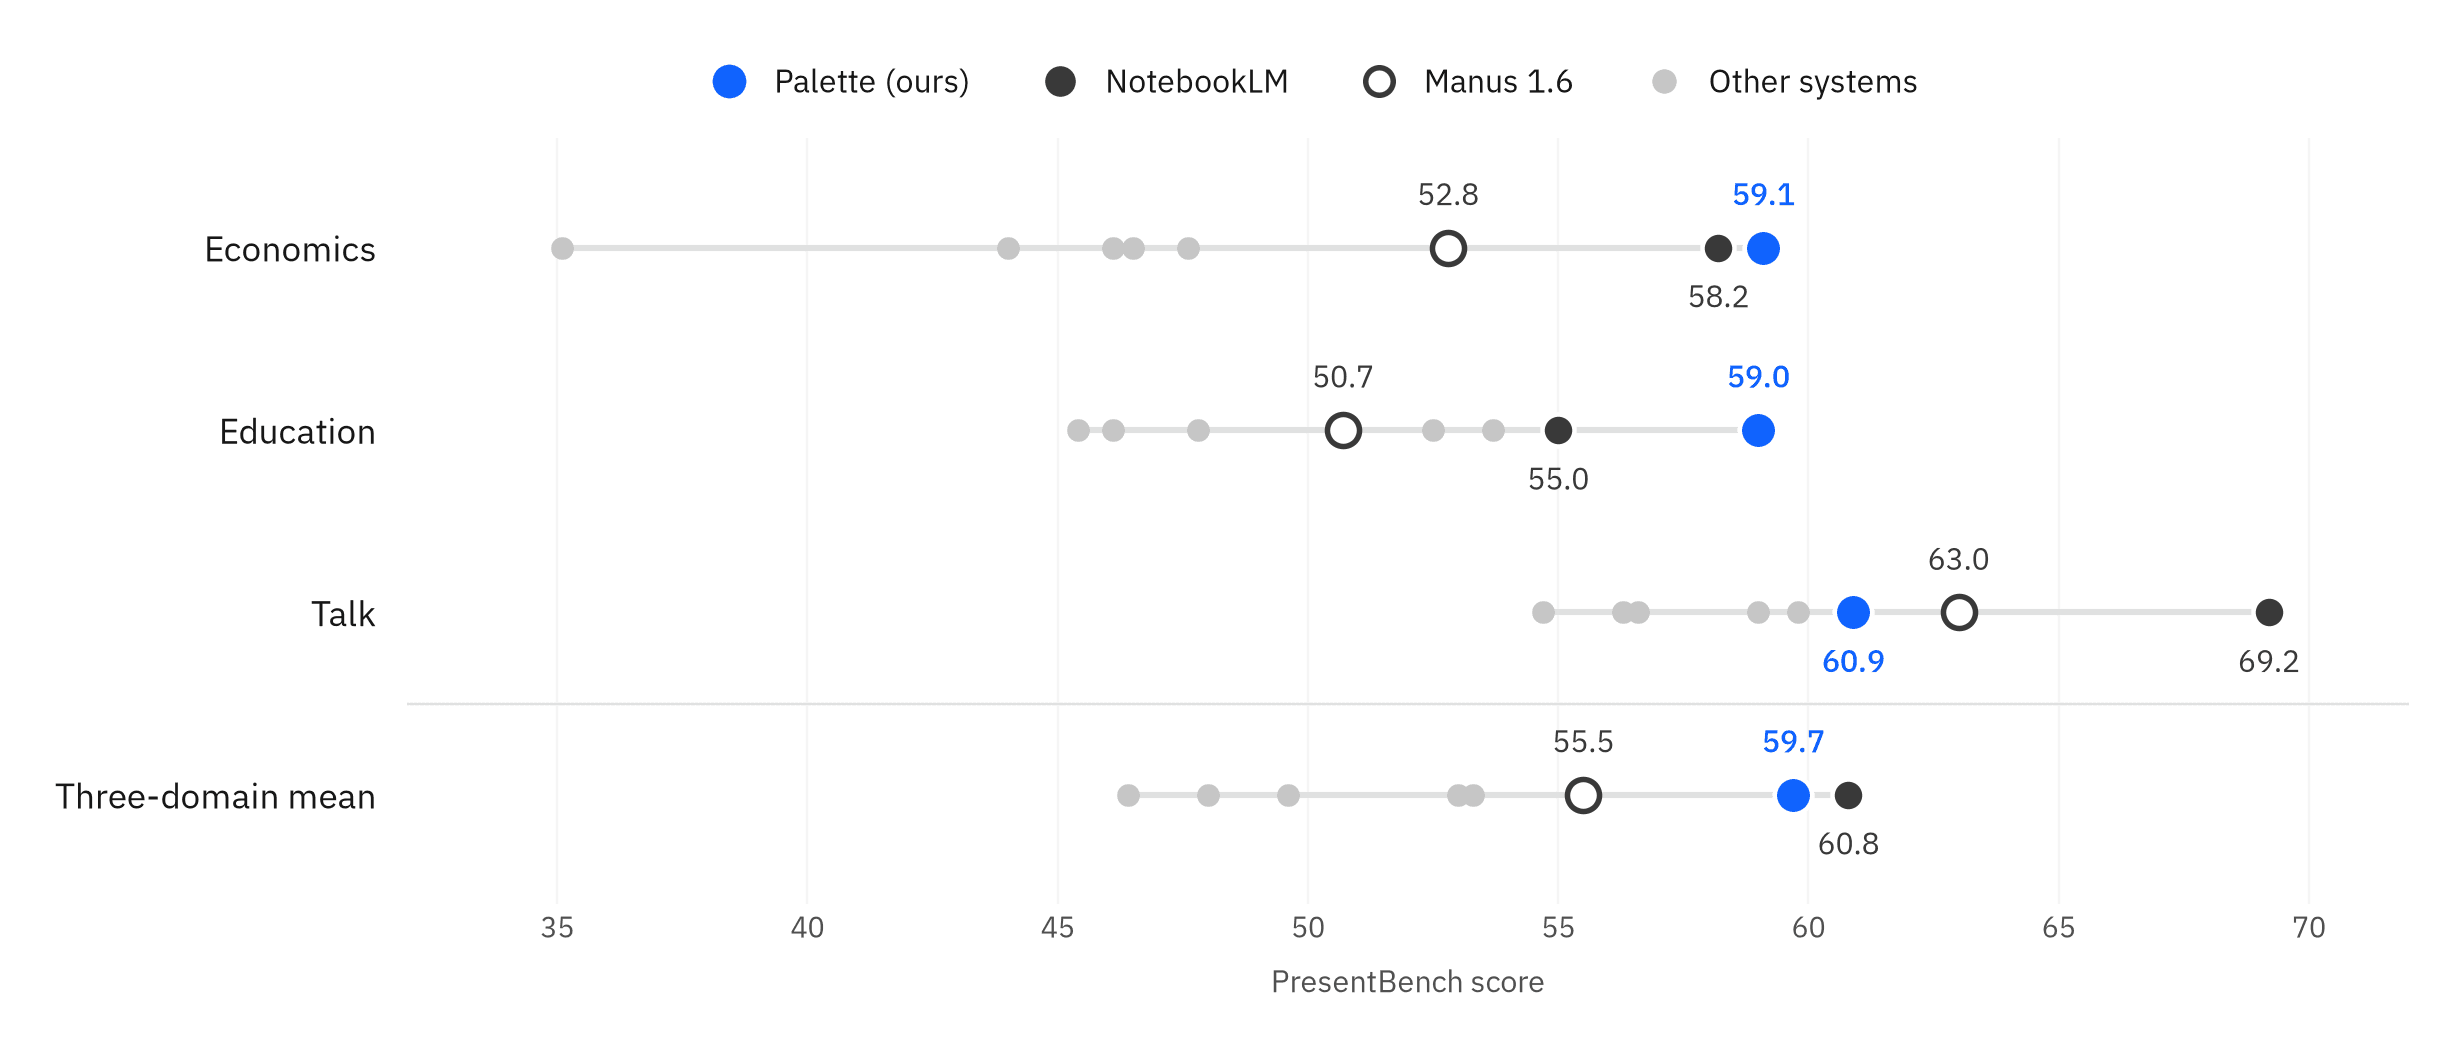
รูปที่ 4. คะแนน PresentBench แยกตามโดเมน Palette (สีน้ำเงิน) ครองอันดับหนึ่งในด้านเศรษฐศาสตร์และการศึกษา และเป็นโมเดล open-weight เพียงตัวเดียวที่ทำคะแนนได้สูงในกลุ่มผู้นำ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร