
Google DeepMind เปิดตัว AlphaGenome 2 เจาะลึกผลกระทบพันธุกรรม
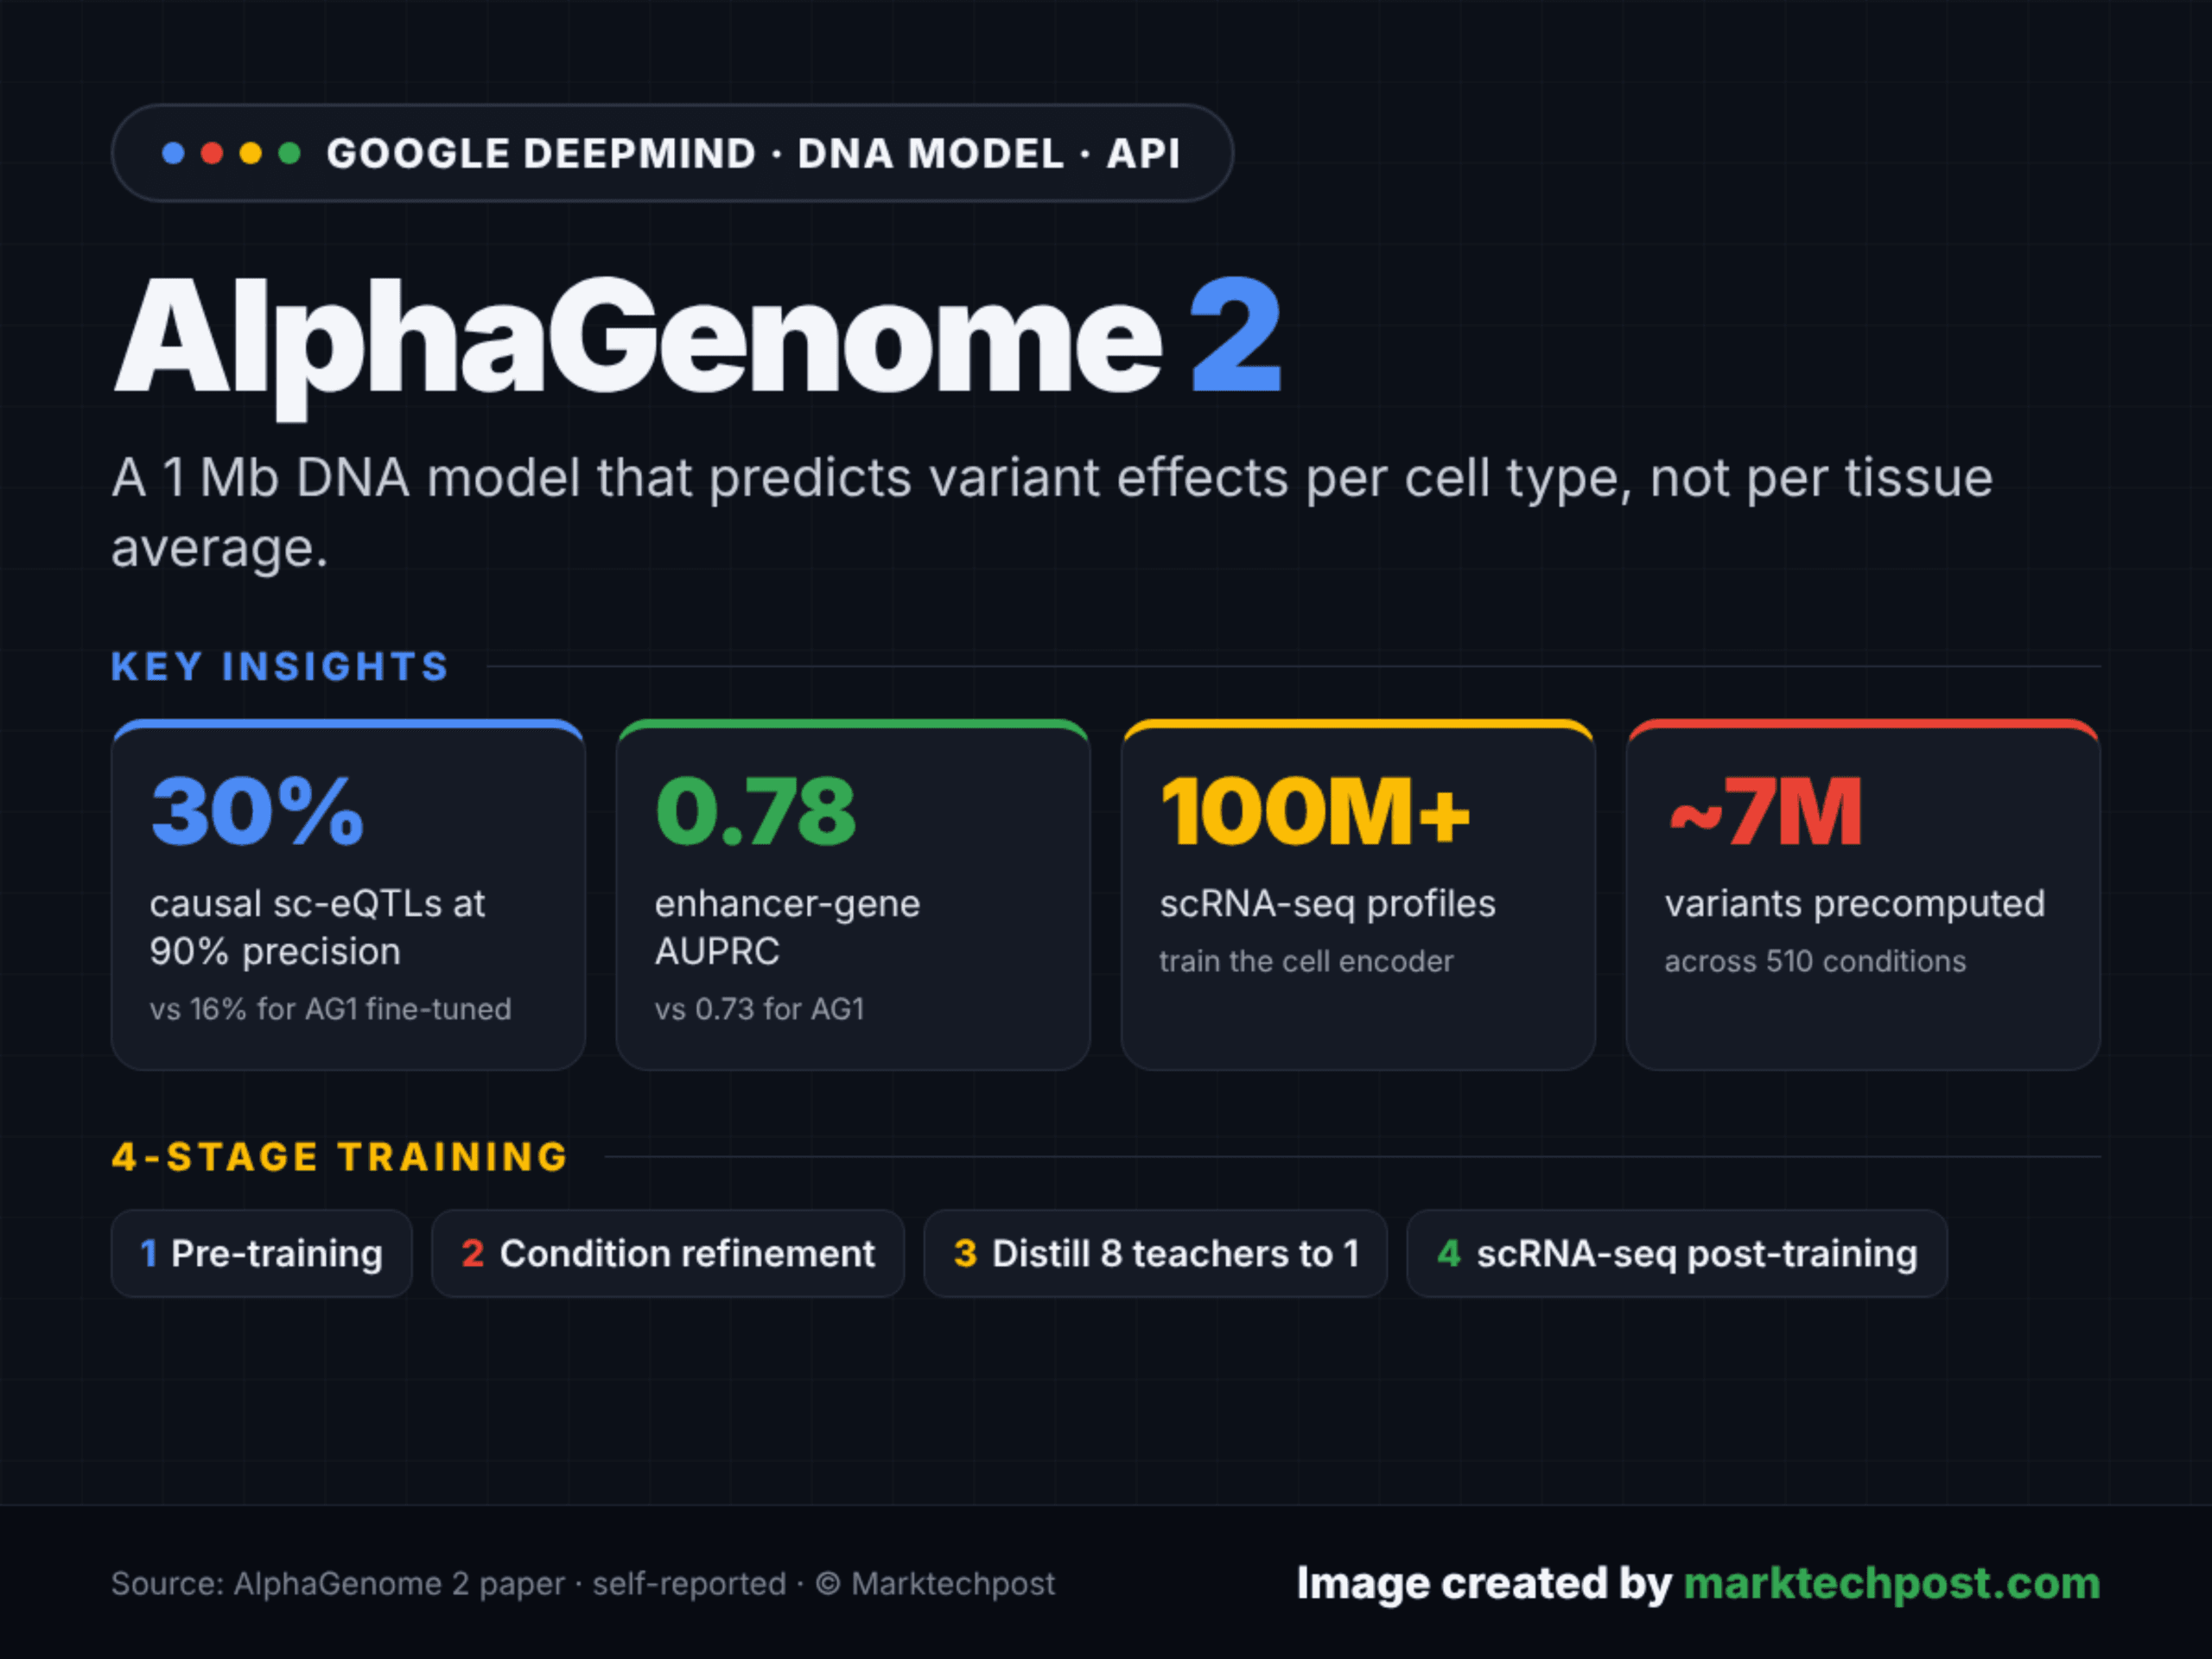
Google DeepMind ได้ released AlphaGenome 2 โมเดล DNA รุ่นล่าสุดที่สามารถทำนายผลกระทบของตัวแปรทางพันธุกรรมในเซลล์เฉพาะประเภทได้อย่างแม่นยำ โดย AlphaGenome 2 เป็นโมเดลประเภท sequence-to-function แบบมีเงื่อนไขที่สามารถอ่านข้อมูล DNA ขนาด 1 Mb พร้อมวิเคราะห์สถานะของเซลล์เป้าหมายไปพร้อมกัน
ความโดดเด่นของโมเดลรุ่นนี้คือการก้าวข้ามขีดจำกัดของรุ่นก่อนหน้าซึ่งทำได้เพียงหาค่าเฉลี่ยจากเนื้อเยื่อรวม (bulk tissues) แต่ AlphaGenome 2 สามารถแยกแยะประเภทเซลล์ที่ใกล้เคียงกันและปรับตัวเข้ากับชุดข้อมูล single-cell ใหม่ๆ ได้ทันทีโดยไม่ต้องทำ fine-tuning โดยปัจจุบันเปิดให้ใช้งานผ่าน AlphaGenome API สำหรับโครงการวิจัยที่ไม่แสวงหาผลกำไร
TL;DR
- ขนาด: รองรับอินพุต DNA ของมนุษย์หรือหนูขนาด 1 Mb (1,048,576 bp)
- การใช้งาน: ให้บริการผ่าน Hosted API เท่านั้น โดยการฝึกฝนใช้ชิป TPU v4 จำนวน 2,048 ตัว ส่วนน้ำหนักของโมเดล (weights) จะเปิดเผยหลังการตีพิมพ์ฉบับสมบูรณ์
- ประสิทธิภาพ: เหนือกว่า AlphaGenome 1, Borzoi และ Scooby ในการทดสอบ single-cell eQTL และ enhancer-gene benchmarks
- จุดเด่น: มีค่า recall สูงถึง 43% ที่ความแม่นยำ 90% ในการทดสอบ TenK10K sc-eQTLs ซึ่งดีกว่ารุ่นเดิมเกือบเท่าตัว
- ข้อจำกัด: บริเวณนอก accessible chromatin มีค่า AUROC เพียง 0.63 และปัจจุบันยังไม่เปิดให้ดาวน์โหลด weights มาใช้งานในเครื่อง local
AlphaGenome 2 คืออะไร?
AlphaGenome 2 พัฒนาขึ้นบนโครงสร้างสไตล์ U-Net ประกอบด้วย convolutional encoder, transformer 11 บล็อก และ decoder โดยเปลี่ยนวิธีการทำงานจากรุ่นแรกที่ทำนายแทร็กข้อมูลจำนวนมากแบบขนาน มาเป็นการทำนายผลลัพธ์แบบเจาะจง 1 เงื่อนไขต่อการเรียกใช้หนึ่งครั้ง
โมเดลใช้การกำหนดเงื่อนไขในรูปแบบ 256-dimensional embedding เพื่อปรับการกระตุ้น (activations) ผ่าน FiLM layers ซึ่งการใส่เงื่อนไขในส่วน encoder และ transformer เป็นกุญแจสำคัญที่ช่วยให้ประสิทธิภาพดีขึ้นอย่างมาก โดยผลลัพธ์ที่ได้ครอบคลุมทั้ง RNA coverage, CAGE, splicing, chromatin accessibility, histone marks รวมถึงการเพิ่ม CpG methylation เข้ามาใหม่
AlphaGenome 2 ถูกฝึกฝนอย่างไร?
กระบวนการฝึกฝนแบ่งออกเป็น 4 ขั้นตอนหลัก เริ่มจากการ Pre-training ด้วยข้อมูล bulk และแทร็กข้อมูล single-cell จำนวนมาก ตามด้วยการ Condition refinement เพื่อจูนส่วน embeddings ต่อด้วยกระบวนการ Distillation จากโมเดลครู 8 โมเดลสู่โมเดลนักเรียน และปิดท้ายด้วย Post-training เพื่อเชื่อมโยง single-cell expression encoder เข้ากับโมเดล
ตัว encoder ถูกฝึกด้วยโปรไฟล์ human scRNA-seq มากกว่า 100 ล้านโปรไฟล์จาก CELLxGENE ทำให้นักวิจัยสามารถส่งค่า raw counts เพื่อรับค่า condition embedding ได้ทันที โดยตาม เอกสาร ระบุว่ารองรับได้สูงสุด 256 เซลล์ต่อการเรียกใช้งานหนึ่งครั้ง
ประสิทธิภาพของ AlphaGenome 2 ในการทดสอบ benchmark
จากการทดสอบในเนื้อเยื่อ GTEx พบว่าความสามารถในการอธิบายความแปรปรวนของประเภทเซลล์เพิ่มขึ้นจาก 23% เป็น 34% และในระดับเซลล์ภูมิคุ้มกัน 28 ประเภท AlphaGenome 2 สามารถตรวจพบ causal variants ได้ถึง 30% ที่ระดับความแม่นยำ 90% เมื่อเทียบกับ AlphaGenome 1 ที่ทำได้เพียง 16%
นอกจากนี้ในการทดสอบด้วยข้อมูล CRISPRi พบว่าค่า AUPRC ของ enhancer-gene สูงถึง 0.78 ซึ่งเหนือกว่าทั้ง AlphaGenome 1 และ Borzoi อย่างชัดเจน โดยเฉพาะในกลุ่ม enhancer ที่อยู่ห่างไกลออกไป ยิ่งไปกว่านั้นในการทดสอบกับตัวอย่างโรคพาร์กินสันที่ไม่เคยเห็นมาก่อน โมเดลยังทำค่า recall ได้สูงถึง 41% ทิ้งห่าง Scooby ที่ทำได้ 17%
เปรียบเทียบกับโมเดลลำดับ DNA อื่นๆ
| คุณสมบัติ | AlphaGenome 2 | AlphaGenome 1 | Borzoi | Scooby |
|---|---|---|---|---|
| DNA อินพุต | 1 Mb | 1 Mb | 524 kb | 524 kb |
| การจัดการเงื่อนไข | Reference หรือ scRNA-seq embedding | แทร็ก multitask แบบคงที่ | แทร็ก multitask แบบคงที่ | Cell-embedding decoder ต่อชุดข้อมูล |
| ผลลัพธ์ Single-cell | scRNA, scATAC | ไม่มี | ไม่มี | scRNA, scATAC |
| พารามิเตอร์ | ไม่เปิดเผย | ไม่เปิดเผย | 235M | ไม่เปิดเผย |
| ฮาร์ดแวร์ | Hosted API | แนะนำ H100 | ไม่เปิดเผย | NVIDIA GPU (ทดสอบบน A40) |
| Weights / ใบอนุญาต | API ตอนนี้, weights ภายหลัง, ไม่แสวงหากำไร | Kaggle และ HF, เงื่อนไขไม่แสวงหากำไร | Apache-2.0 | MIT |
| TenK10K sc-eQTL causality AUPRC* | 0.76 | 0.72 (fine-tuned) | ไม่ได้ประเมิน | 0.69 |
| TenK10K sc-eQTL sign AUC* | 0.85 | 0.79 (fine-tuned) | ไม่ได้ประเมิน | 0.77 |
| rE2G held-out CRISPRi AUPRC* | 0.78 | 0.73 | 0.61 (4-model ensemble) | ไม่ได้ประเมิน |
*หมายเหตุ: ข้อมูลอ้างอิงจากการประเมินโดย DeepMind
ช่องทางการเข้าถึงสำหรับนักพัฒนา
นักวิจัยสามารถเข้าถึง AlphaGenome 2 และบทเรียน Colab ได้แล้วผ่าน API key ซึ่งเปิดให้ใช้ฟรีสำหรับงานที่ไม่แสวงหาผลกำไร (non-commercial use) ส่วนงานเชิงพาณิชย์กำลังเปิดทดสอบแบบส่วนตัว นอกจากนี้ยังมีแพ็คเกจ Python alphagenome ที่พร้อมให้เรียกใช้งานโมเดลภายใต้ alphagenome.models.v2 อีกด้วย
DeepMind ยังได้เผยแพร่แผนที่ฐานข้อมูล (atlases) ที่คำนวณไว้ล่วงหน้า ครอบคลุมความเชื่อมโยง enhancer-gene ในเซลล์กว่า 640 แบบ และคะแนนตัวแปร GWAS ประมาณ 7 ล้านรายการ ซึ่งสามารถดาวน์โหลดได้ที่ downloads page เพื่อนำไปศึกษาต่อยอดได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร