
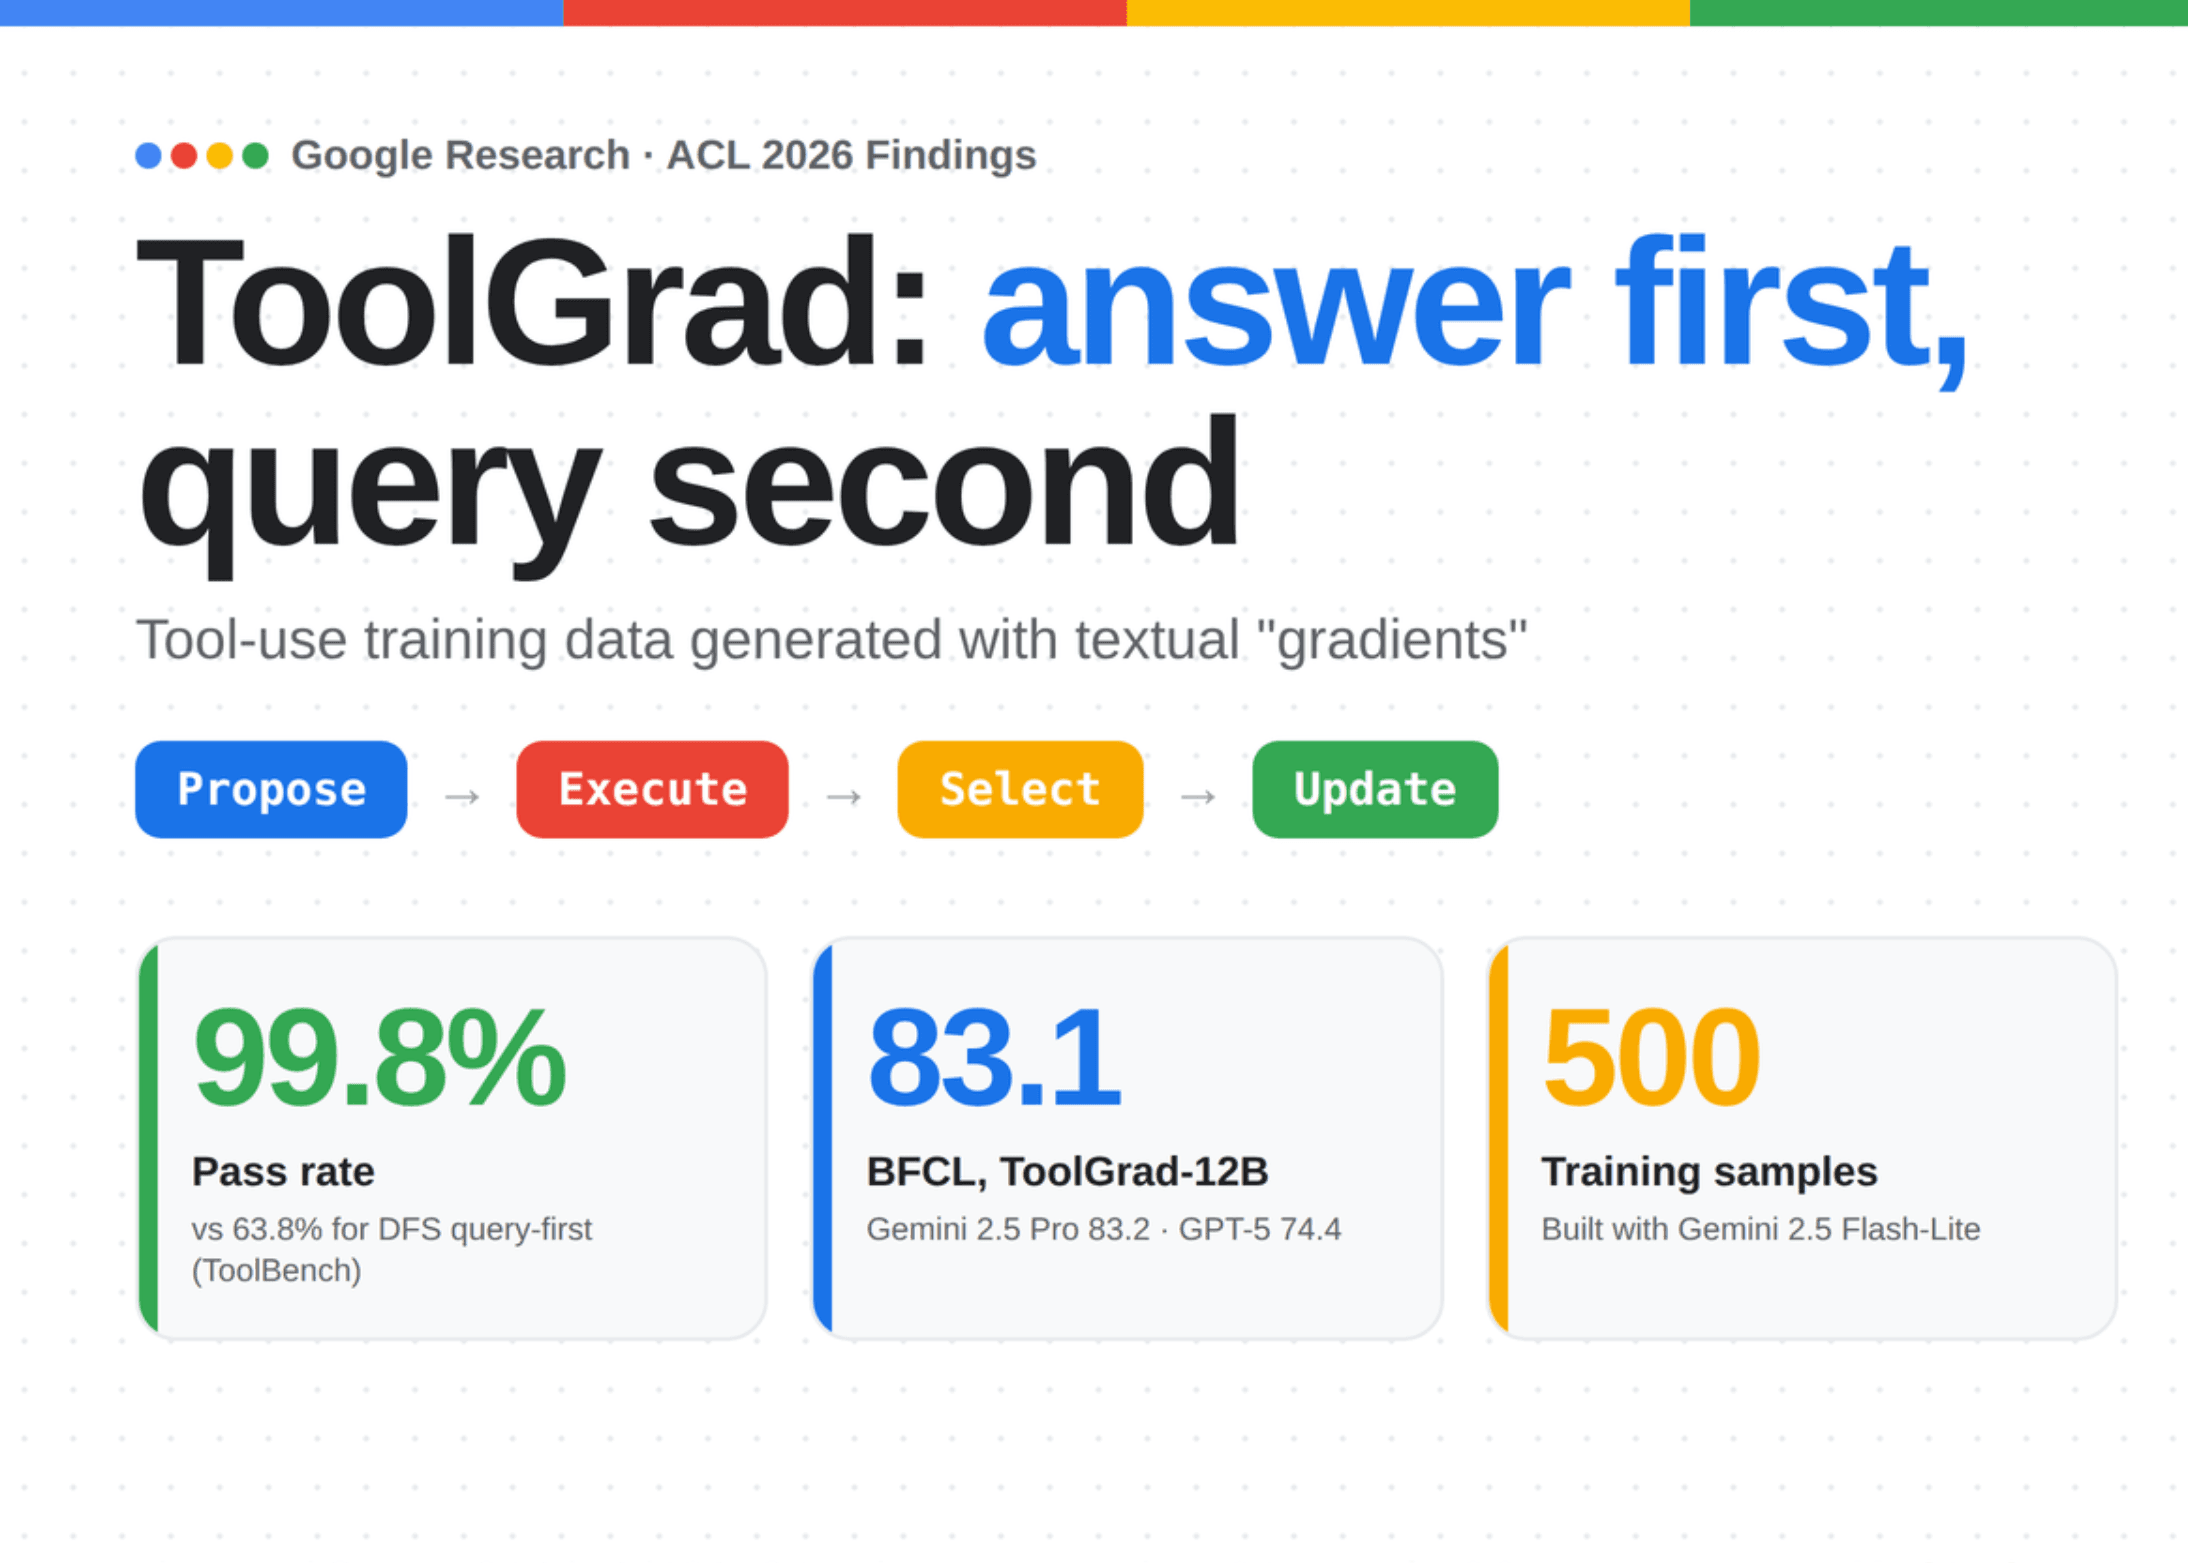
Google Research เปิดตัว ToolGrad: เฟรมเวิร์กสร้างข้อมูล Tool-Use แบบใหม่ ทำ Pass Rate สูงถึง 99.8%
การฝึกฝนโมเดลภาษาขนาดใหญ่ (LLM) ให้สามารถเรียกใช้เครื่องมือ (tools) ได้อย่างแม่นยำ จำเป็นต้องมีชุดข้อมูลคุณภาพสูงที่จับคู่ระหว่างคำสั่งผู้ใช้ (user queries) และลำดับการใช้เครื่องมือ (tool-use chains) ที่ถูกต้อง
อย่างไรก็ตาม การสร้างข้อมูลเหล่านี้ในปริมาณมากมักเผชิญกับปัญหาเรื่องความล่าช้าและค่าใช้จ่ายที่สูง ทีมนักวิจัยจาก Google, University of Tokyo, RIKEN AIP และ Tohoku University จึงได้นำเสนอ ToolGrad ซึ่งเป็นงานวิจัยที่พลิกกระบวนการสร้างข้อมูลแบบเดิม โดยเริ่มจากการสร้าง tool chain ที่ผ่านการตรวจสอบการทำงานจริงก่อน แล้วจึงค่อยเขียน query ให้สอดคล้องกับขั้นตอนนั้น
ผลลัพธ์ที่ได้น่าทึ่งมาก เพราะโมเดล Gemma-3 ที่ผ่านการ fine-tuned ด้วยข้อมูลจาก ToolGrad เพียง 500 ตัวอย่าง สามารถทำคะแนนบน Berkeley Function Calling Leaderboard ได้ใกล้เคียงกับโมเดลระดับเรือธงที่เป็นแบบปิด (proprietary)
สำหรับผู้ที่สนใจนำไปใช้งานจริง โค้ด ได้รับการเผยแพร่ภายใต้สัญญาอนุญาต Apache-2.0 โดยมีทั้ง ชุดข้อมูล ToolGrad-500 และ โมเดลขนาด 1B, 4B และ 12B บน Hugging Face รวมถึงมี แพ็คเกจ PyPI ให้พร้อมใช้งาน
ปัญหาของการสร้างข้อมูลแบบ query-first
กระบวนการสร้างข้อมูลแบบเดิม เช่น ToolBench และ ToolACE มักใช้แนวทางแบบ "สร้างคำถามก่อน" (query-first) โดยเริ่มจากการสุ่มกลุ่ม API ขึ้นมา แล้วให้ LLM ลองสร้างคำสั่งที่ดูน่าจะเป็นไปได้ จากนั้นจึงใช้เอเจนท์ค้นหาเส้นทางการใช้เครื่องมือผ่านระบบ depth-first search (DFS)
แต่ปัญหาคือการค้นหาแบบนี้ไม่มีอะไรรับประกันความสำเร็จ หากเอเจนท์เจอทางตัน ทรัพยากรที่ใช้ไปทั้งหมดจะสูญเปล่าและต้องทิ้งตัวอย่างนั้นไป งานวิจัยนี้มองว่าการพยายามสกัดขั้นตอนการทำงานจากระบบที่มักจะล้มเหลวเช่นนี้ เป็นกระบวนการที่ขาดประสิทธิภาพโดยธรรมชาติ
ToolGrad จึงเลือกสลับลำดับการทำงาน โดยเริ่มจากการสร้าง tool-use chain ที่ใช้งานได้จริงจากการรัน API ของจริงก่อน (ground-truth) แล้วค่อยกำกับดูแลให้ได้คำสั่งผู้ใช้ที่สอดคล้องกัน เนื่องจากขั้นตอนที่ใช้งานได้จริงมีความชัดเจนและคลุมเครือน้อยกว่าการสมมติเหตุการณ์ ทำให้ขั้นตอนการเปลี่ยน chain เป็น query ทำได้ง่ายและใช้การเรียก LLM เพียงครั้งเดียว
4 โมดูลหลักในหนึ่งรอบการทำงาน
กระบวนการทำงานของ ToolGrad ในแต่ละรอบจะประกอบด้วย 4 โมดูลที่ทำงานต่อเนื่องกันดังนี้:
- API Proposer: ทำหน้าที่คัดกรองกลุ่ม API ที่สุ่มมาให้เหลือเฉพาะรายการที่มีโอกาสขยายเวิร์กโฟลว์ปัจจุบันได้จริง
- API Executors: รัน API เหล่านั้นพร้อมกันและจัดทำรายงานผลการทำงานอย่างละเอียด
- API Selector: ตรวจสอบรายงานเพื่อเลือกการเรียกใช้ที่ดีที่สุดเพียงหนึ่งเดียวเพื่อเพิ่มเข้าสู่เวิร์กโฟลว์ โดยข้อมูลป้อนกลับที่ได้จะถูกส่งต่อไปในรูปแบบของ textual gradient
- LLM Updater: ทำหน้าที่เขียนคำสั่งผู้ใช้สังเคราะห์และคำตอบของ AI ใหม่ เพื่อให้สอดคล้องกับชุด API ล่าสุดที่เพิ่มเข้ามา
การทำซ้ำลูปนี้จะช่วยให้ได้หนึ่งตัวอย่างข้อมูลที่สมบูรณ์ ประกอบด้วยคำสั่งผู้ใช้, เวิร์กโฟลว์ API ที่ผ่านการตรวจสอบแล้ว และคำตอบสุดท้าย โดยค่าเริ่มต้นของระบบจะรันทั้งหมด 10 รอบ ต่อการสุ่ม 50 API ต่อหนึ่งเวิร์กโฟลว์
ประสิทธิภาพการสร้างข้อมูลบน ToolBench
ทีมนักวิจัยได้ประเมินประสิทธิภาพบนฐานข้อมูล ToolBench API ซึ่งประกอบด้วย API ในโลกจริงกว่า 16,000 รายการ โดยเปรียบเทียบ ToolGrad กับแนวทาง DFS แบบเดิม ตามที่ระบุใน รายงานวิจัย:
- อัตราการผ่าน (Pass rate) พุ่งสูงขึ้นจาก 63.8% เป็น 99.8%
- จำนวนการใช้เครื่องมือจริง (Ground-truth tool uses) เพิ่มขึ้นจาก 2.1 เป็น 3.4 ต่อตัวอย่าง ซึ่งแสดงถึงความซับซ้อนของ chain ที่มากขึ้น
- ขั้นตอนการใช้เครื่องมือต่อตัวอย่างลดลงอย่างเห็นได้ชัดจาก 34.3 เหลือ 20.0
- การเรียกใช้ LLM ต่อตัวอย่างลดลงเล็กน้อยจาก 64.5 เหลือ 63.9
สำหรับกรณีที่ล้มเหลวเพียง 0.2% นั้นเกิดขึ้นเมื่อเอเจนท์ไม่สามารถหาคำตอบที่สำเร็จได้เลยจากการเลือก API ตลอดทั้ง 10 รอบการทำงาน
ผลลัพธ์บน BFCL ด้วย Gemma-3
นักวิจัยได้สร้างชุดข้อมูล ToolGrad-500 จำนวน 500 ตัวอย่างด้วย Gemini 2.5 Flash-Lite เพื่อนำไปฝึกฝน (post-train) ให้กับ Gemma-3 ในขนาดต่างๆ และทดสอบบน Berkeley Function Calling Leaderboard (BFCL) ซึ่งถือเป็นการทดสอบแบบ out-of-distribution ที่มีเครื่องมือใหม่ๆ ที่โมเดลไม่เคยเห็นมาก่อน โดยมีผลลัพธ์ที่น่าสนใจดังนี้:
- การ fine-tuning ด้วย ToolGrad-500 ช่วยยกระดับความสามารถในการใช้เครื่องมือของโมเดลทุกขนาด
- ToolGrad-12B ทำคะแนนได้ 83.1 ซึ่งใกล้เคียงกับ Gemini 2.5 Pro (83.2) และสูงกว่า Claude 4.5 Opus (82.8) รวมถึง GPT-5 (74.4) ณ ช่วงเวลาที่ตีพิมพ์
- โมเดลขนาด 12B ที่ถูกฝึก (student) สามารถทำผลงานได้ดีกว่าโมเดลผู้สร้างข้อมูลอย่าง Gemini 2.5 Flash-Lite (teacher) เสียอีก
- ปัจจุบัน ToolGrad-12B กลายเป็นผู้นำในกลุ่มโมเดลเปิด (Open Models) ที่เชี่ยวชาญด้านการใช้เครื่องมือ เหนือกว่า ToolACE และ Hammer-2.1-7B
การทดสอบทั้งหมดสามารถทำซ้ำได้ผ่านสคริปต์ใน repository ซึ่งรองรับการรันผ่าน vLLM Docker image และได้รับการตรวจสอบแล้วว่าสามารถทำงานได้บน NVIDIA A100 40GB เพียงใบเดียว
ประเด็นสำคัญ
- ToolGrad พลิกนิยามการสร้างข้อมูล tool-use ด้วยการตรวจสอบ chain ก่อน แล้วค่อยสร้าง query ตาม
- เพิ่ม Pass rate บน ToolBench จาก 63.8% เป็น 99.8% พร้อมได้ลำดับการทำงานที่ยาวและกระชับขึ้น
- ข้อมูลเพียง 500 ชุด สามารถผลักดัน Gemma-3-12B ให้มีประสิทธิภาพทัดเทียมโมเดลระดับโปร
- พิสูจน์ให้เห็นว่าโมเดลขนาดเล็กสามารถพัฒนาจนเก่งกว่าโมเดลขนาดใหญ่ที่ใช้สอนมันได้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร