
Diffusion Controller: ยกระดับการคุมสร้างภาพ AI ให้แม่นยำยิ่งขึ้น
ความก้าวหน้าอย่างรวดเร็วของโมเดล AI แบบ text-to-image เช่น Nano Banana, Stable Diffusion และ Flux ได้เปลี่ยนโฉมวงการออกแบบไปอย่างสิ้นเชิง ช่วยให้ทุกคนสร้างภาพสมจริงจากคำบรรยายได้
อย่างไรก็ตาม การควบคุมโมเดลขนาดใหญ่เหล่านี้ให้ตรงตามความต้องการอย่างแม่นยำยังคงเป็นเรื่องยาก ตัวอย่างเช่น เมื่อสั่งคำว่า "กิ้งก่าสวมแว่นกันแดด" AI อาจสร้างภาพกิ้งก่าที่ไม่มีแว่น หรือหากบังคับให้ใส่แว่น รายละเอียดใบหน้ากิ้งก่าก็อาจบิดเบี้ยวจนเสียคุณภาพ
ปัจจุบันวิธีการปรับจูนการสร้างภาพมักกระจัดกระจาย ในด้านหนึ่งมีการใช้ inference-time techniques (เช่น classifier-free diffusion guidance) เพื่อคุมอิทธิพลของ Prompt แบบทันที
อีกด้านหนึ่งคือนักพัฒนาต้องพึ่งพาการ fine-tuning โดยใช้ตัวปรับต่ออย่าง LoRA, reward-weighted regressions หรือ policy gradients ซึ่งที่ผ่านมาเครื่องมือเหล่านี้ถูกมองว่าแยกจากกัน ทำให้ขาดหลักการทางคณิตศาสตร์ที่เป็นหนึ่งเดียวในการรักษาสมดุลระหว่างความต้องการของผู้ใช้และคุณภาพภาพ เพื่อแก้ปัญหานี้ ทีมวิจัยจึงนำเสนอเฟรมเวิร์ก Diffusion Controller ที่เปลี่ยนมุมมองกระบวนการกำจัดนอยส์ (denoising) ให้กลายเป็นปัญหาการควบคุมที่ต่อเนื่อง ผลลัพธ์แสดงให้เห็นว่าเครือข่ายส่วนเสริมน้ำหนักเบานี้มีประสิทธิภาพเหนือกว่ามาตรฐานอุตสาหกรรม โดยสามารถทำอัตราการชนะ (win rate) ได้ถึง 90% ในเวอร์ชันที่เข้าถึงน้ำหนักภายในโมเดลได้เต็มรูปแบบ
เฟรมเวิร์ก Diffusion Controller
Diffusion Controller ปฏิบัติต่อการสร้างภาพเหมือนการเดินทางที่ถูกควบคุมอย่างราบรื่น เปรียบเสมือนโมเดลตั้งต้น (pre-trained model) เป็นมอเตอร์ไซค์ทรงพลังที่การรื้อเครื่องยนต์ใหม่ทำได้ยากและเสี่ยง Diffusion Controller จึงทำหน้าที่เป็นเหมือน "แดมเปอร์พวงมาลัย" (steering damper) น้ำหนักเบาที่ติดตั้งเพิ่มเข้าไปโดยไม่ต้องแตะต้องตัวเครื่องหลัก
กลไกนี้จะปรับเส้นทางการสร้างภาพแบบไดนามิกในขณะที่ภาพกำลังถูกสร้าง โดยจะให้น้ำหนักกับทิศทางที่ตอบโจทย์ผู้ใช้มากที่สุด ไม่ว่าจะเป็นสไตล์ศิลปะหรือความสอดคล้องของบริบท โดยที่ยังคงความเสถียรของภาพไว้
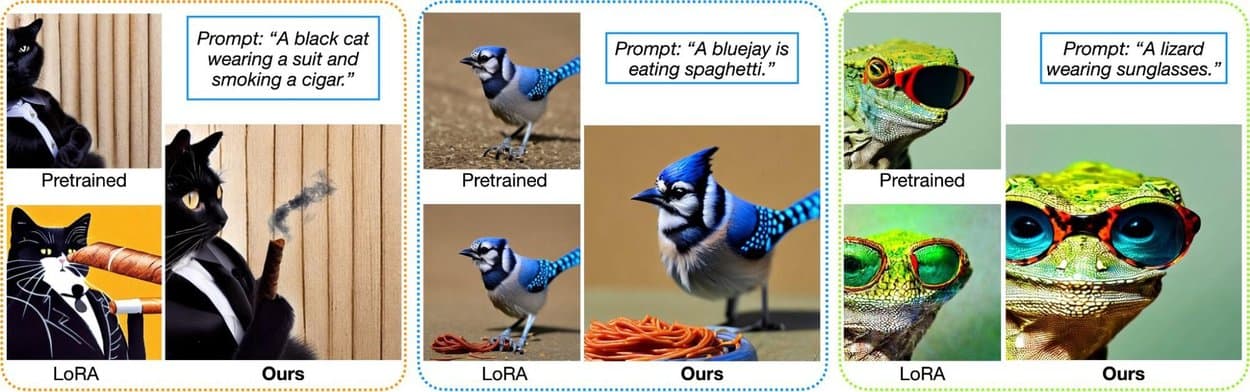
ตารางเปรียบเทียบภาพจากโมเดล pre-trained พื้นฐาน, LoRA และผลลัพธ์จาก Diffusion Controller ผ่าน prompt ที่ซับซ้อน
การใช้สมดุลทางคณิตศาสตร์นี้ช่วยให้ AI สร้างกิ้งก่าที่สวมแว่นกันแดดได้โดยไม่มีส่วนใดบิดเบี้ยว เนื่องจากมี "เกราะป้องกัน" (penalty guardrail) ที่คอยคุมไม่ให้ระบบทำลายรายละเอียดทางกายภาพของวัตถุเพื่อให้บรรลุเป้าหมายตาม Prompt เพียงอย่างเดียว
จากทฤษฎีสู่การปฏิบัติ
ทีมวิจัยได้เปลี่ยนสมการนามธรรมให้เป็นวิธีการ fine-tuning ที่ใช้งานได้จริง 2 รูปแบบ โดยอิงจากคะแนนรางวัล (reward score):
- วิธีที่ 1: Policy gradient และ PPO วิธีนี้จะปรับโมเดลแบบค่อยเป็นค่อยไป พร้อมมีกฎการตัด (clipping rule) คอยจำกัดความเร็วการเปลี่ยนพฤติกรรม เพื่อให้การฝึกฝนราบรื่นและมีเสถียรภาพ
- วิธีที่ 2: Reward-weighted loss เป็นทางลัดการเพิ่มประสิทธิภาพที่เน้นให้รางวัลกับกระบวนการที่ให้ผลลัพธ์คุณภาพสูง เพื่อให้โมเดลเรียนรู้การสร้างภาพตามต้องการได้อย่างแม่นยำ
เครือข่าย "แดมเปอร์พวงมาลัย"
จุดเด่นสำคัญของ Diffusion Controller คือความสามารถในการทำงานกับโมเดลแบบปิด (closed-source) หรือ Black Box ที่เข้าถึงรหัสต้นฉบับไม่ได้ เครือข่ายแดมเปอร์พวงมาลัยจะสังเกตภาพในขณะที่กำลังถูกกำจัดสัญญาณรบกวน และฉีดการแก้ไขการนำทางที่แม่นยำในระดับจุลภาคลงไป ช่วยให้วิศวกรควบคุมโมเดลชั้นนำที่ถูกล็อคไว้ได้โดยไม่ต้องแก้ไขโครงสร้างหลักเลย
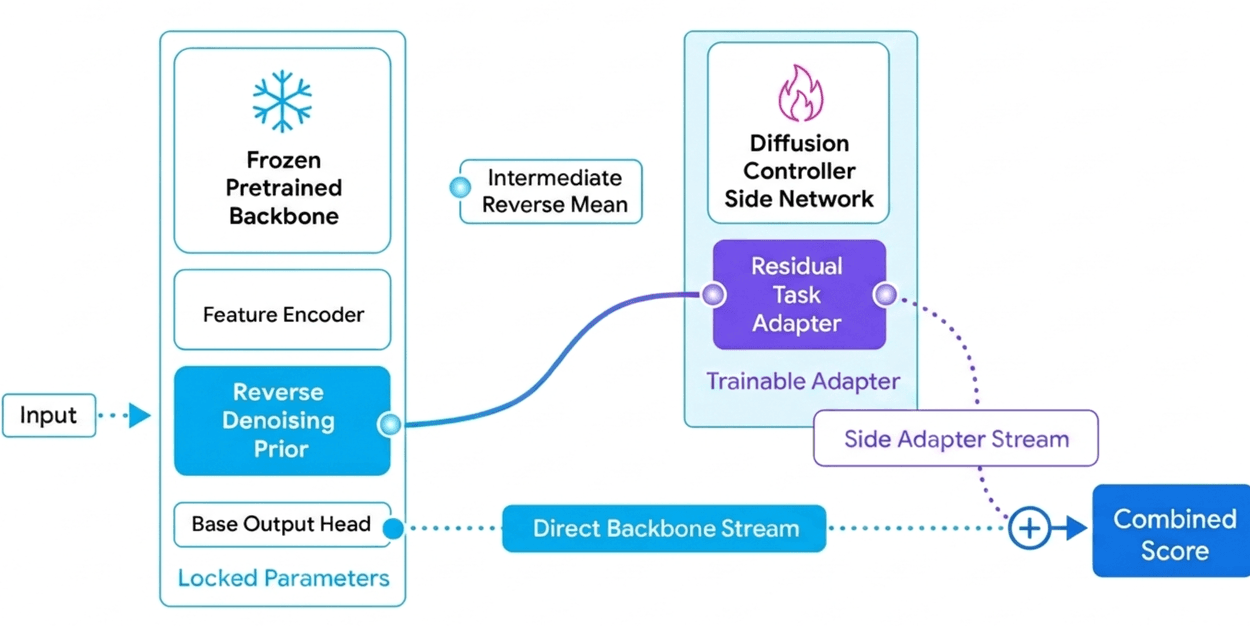
ผังภาพแสดงให้เห็นว่าโครงข่ายหลักที่ถูกแช่แข็งส่งค่าไปยัง Diffusion Controller Side Network เพื่อคำนวณคะแนนรวมอย่างไร
การทดลองและผลลัพธ์
ทีมวิจัยทดสอบโดยใช้ Stable Diffusion v1.4 เป็นแกนหลัก และวัดผลด้วย Human Preference Score (HPS-v2) เพื่อดูว่าภาพถูกใจมนุษย์แค่ไหน ผลลัพธ์แสดงให้เห็นว่า Diffusion Controller ทำผลงานได้ดีเยี่ยมทั้งในสภาพแวดล้อมแบบเปิด (white-box) และสภาพแวดล้อมที่มีข้อจำกัด (gray-box)
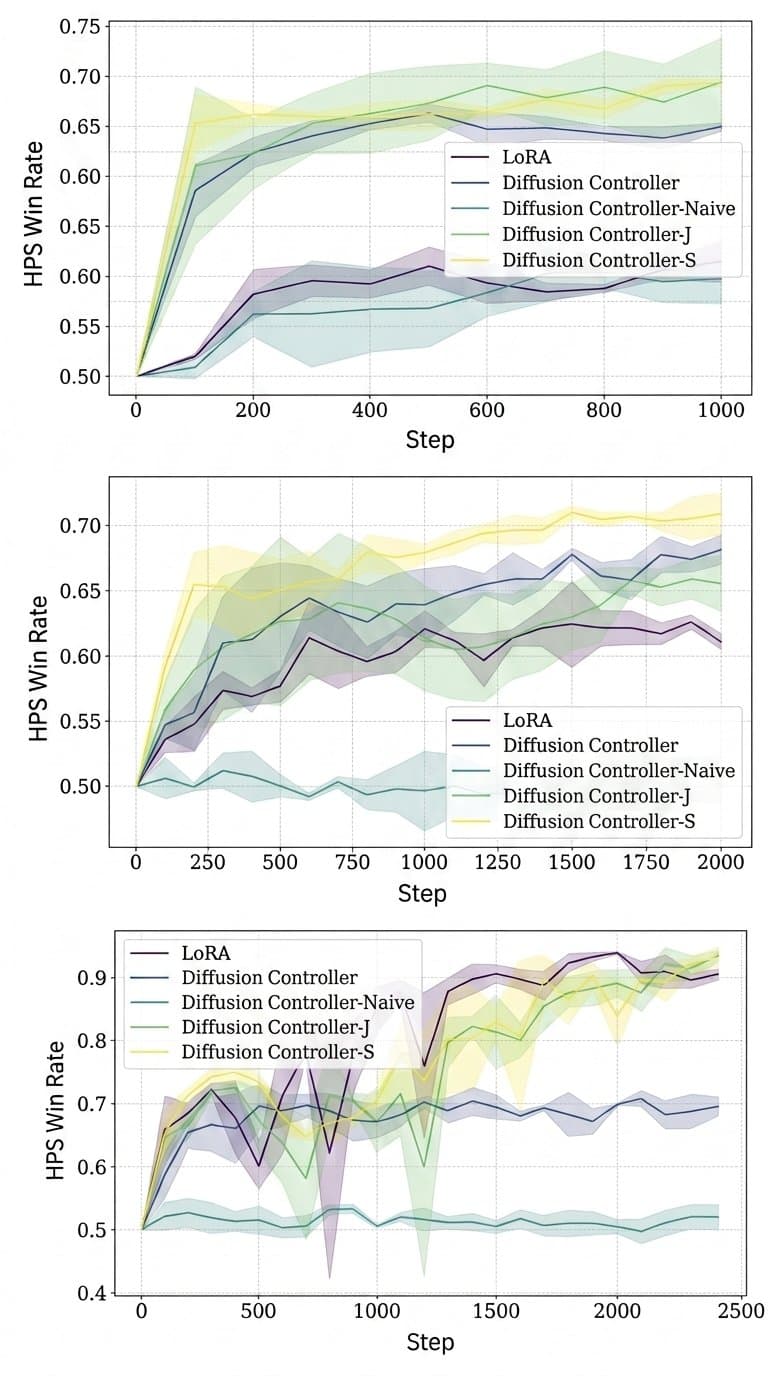
กราฟแสดงอัตราการชนะ HPS-v2 เมื่อเทียบกับโมเดลพื้นฐานในการตั้งค่าต่างๆ
ที่น่าสนใจคือ ในการตั้งค่าแบบ Gray-box ตัว Diffusion Controller ยังมีประสิทธิภาพเหนือกว่า LoRA ซึ่งเป็นแนวทางระดับแนวหน้าในด้านอัตราการชนะใจผู้ใช้ ทั้งที่จัดการเลเยอร์ภายในน้อยกว่ามาก นอกจากนี้ยังมีความยืดหยุ่นสูง ผู้ใช้สามารถปรับระดับการควบคุมได้ทันทีในขณะใช้งาน (inference) โดยไม่ทำให้ภาพเสียความเสถียร
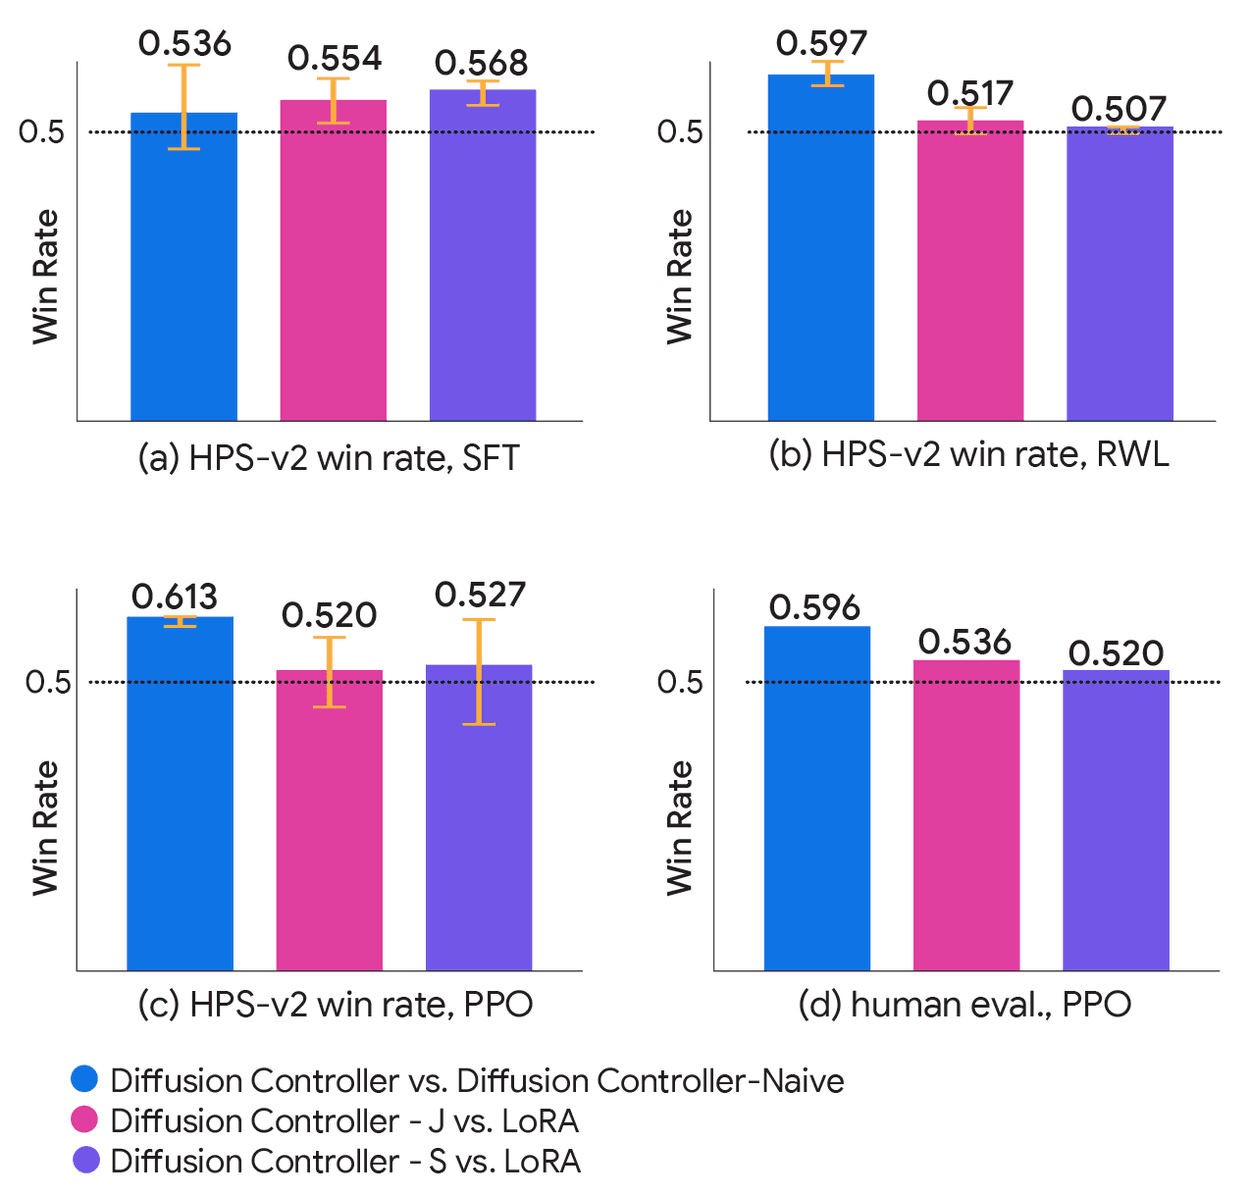
อัตราการชนะเมื่อสิ้นสุดการฝึกเทียบกับเกณฑ์มาตรฐานในรูปแบบต่างๆ
บทสรุป
Diffusion Controller ได้เชื่อมช่องว่างระหว่างคณิตศาสตร์และเครื่องมือสร้างสรรค์ มอบระบบการนำทางที่มั่นคงและมีน้ำหนักเบาสำหรับโมเดล AI ยุคใหม่ ในอนาคตเฟรมเวิร์กนี้อาจถูกต่อยอดเพื่อใช้สร้างเครื่องมือปรับแต่งภาพเฉพาะบุคคล การพัฒนากลไกความปลอดภัย และการควบคุมโมเดลวิดีโอที่ซับซ้อนยิ่งขึ้นต่อไป
กิตติกรรมประกาศ
เราขอขอบคุณผู้เขียนร่วมและผู้ร่วมงานจาก Google Research, Google DeepMind และภาควิชาการสำหรับความช่วยเหลือในผลงานชิ้นนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร