
VocabX ลดต้นทุน Inference ในระบบจริงได้ 77% ด้วยการปรับแต่ง Vocabulary
โมเดลภาษาที่ได้รับการปรับแต่งให้เฉพาะทางด้วยการ fine-tuning จากโมเดล open-source ทั่วไป เช่น Qwen หรือ Gemma มักจะสืบทอด vocabulary ที่ถูกสร้างมาเพื่อรองรับการใช้งานที่หลากหลายเกินความจำเป็น
ในระบบตรวจเรียงความที่เราใช้งานจริง Vocabulary ดังกล่าวได้แยกข้อความที่โมเดลเขียนบ่อยที่สุดออกเป็นหลายๆ token บทความนี้จะนำเสนอผลลัพธ์จากงานวิจัย VocabX ที่กำลังจะเผยแพร่เร็วๆ นี้ ซึ่งเป็นวิธีปรับแต่ง vocabulary ให้เฉพาะทางโดยพิจารณาจากต้นทุนของแต่ละ token แทนที่จะดูเพียงความถี่ ช่วยลดต้นทุน inference ที่วัดผลได้จริงลง 77% โดยไม่ต้องเปลี่ยน base model
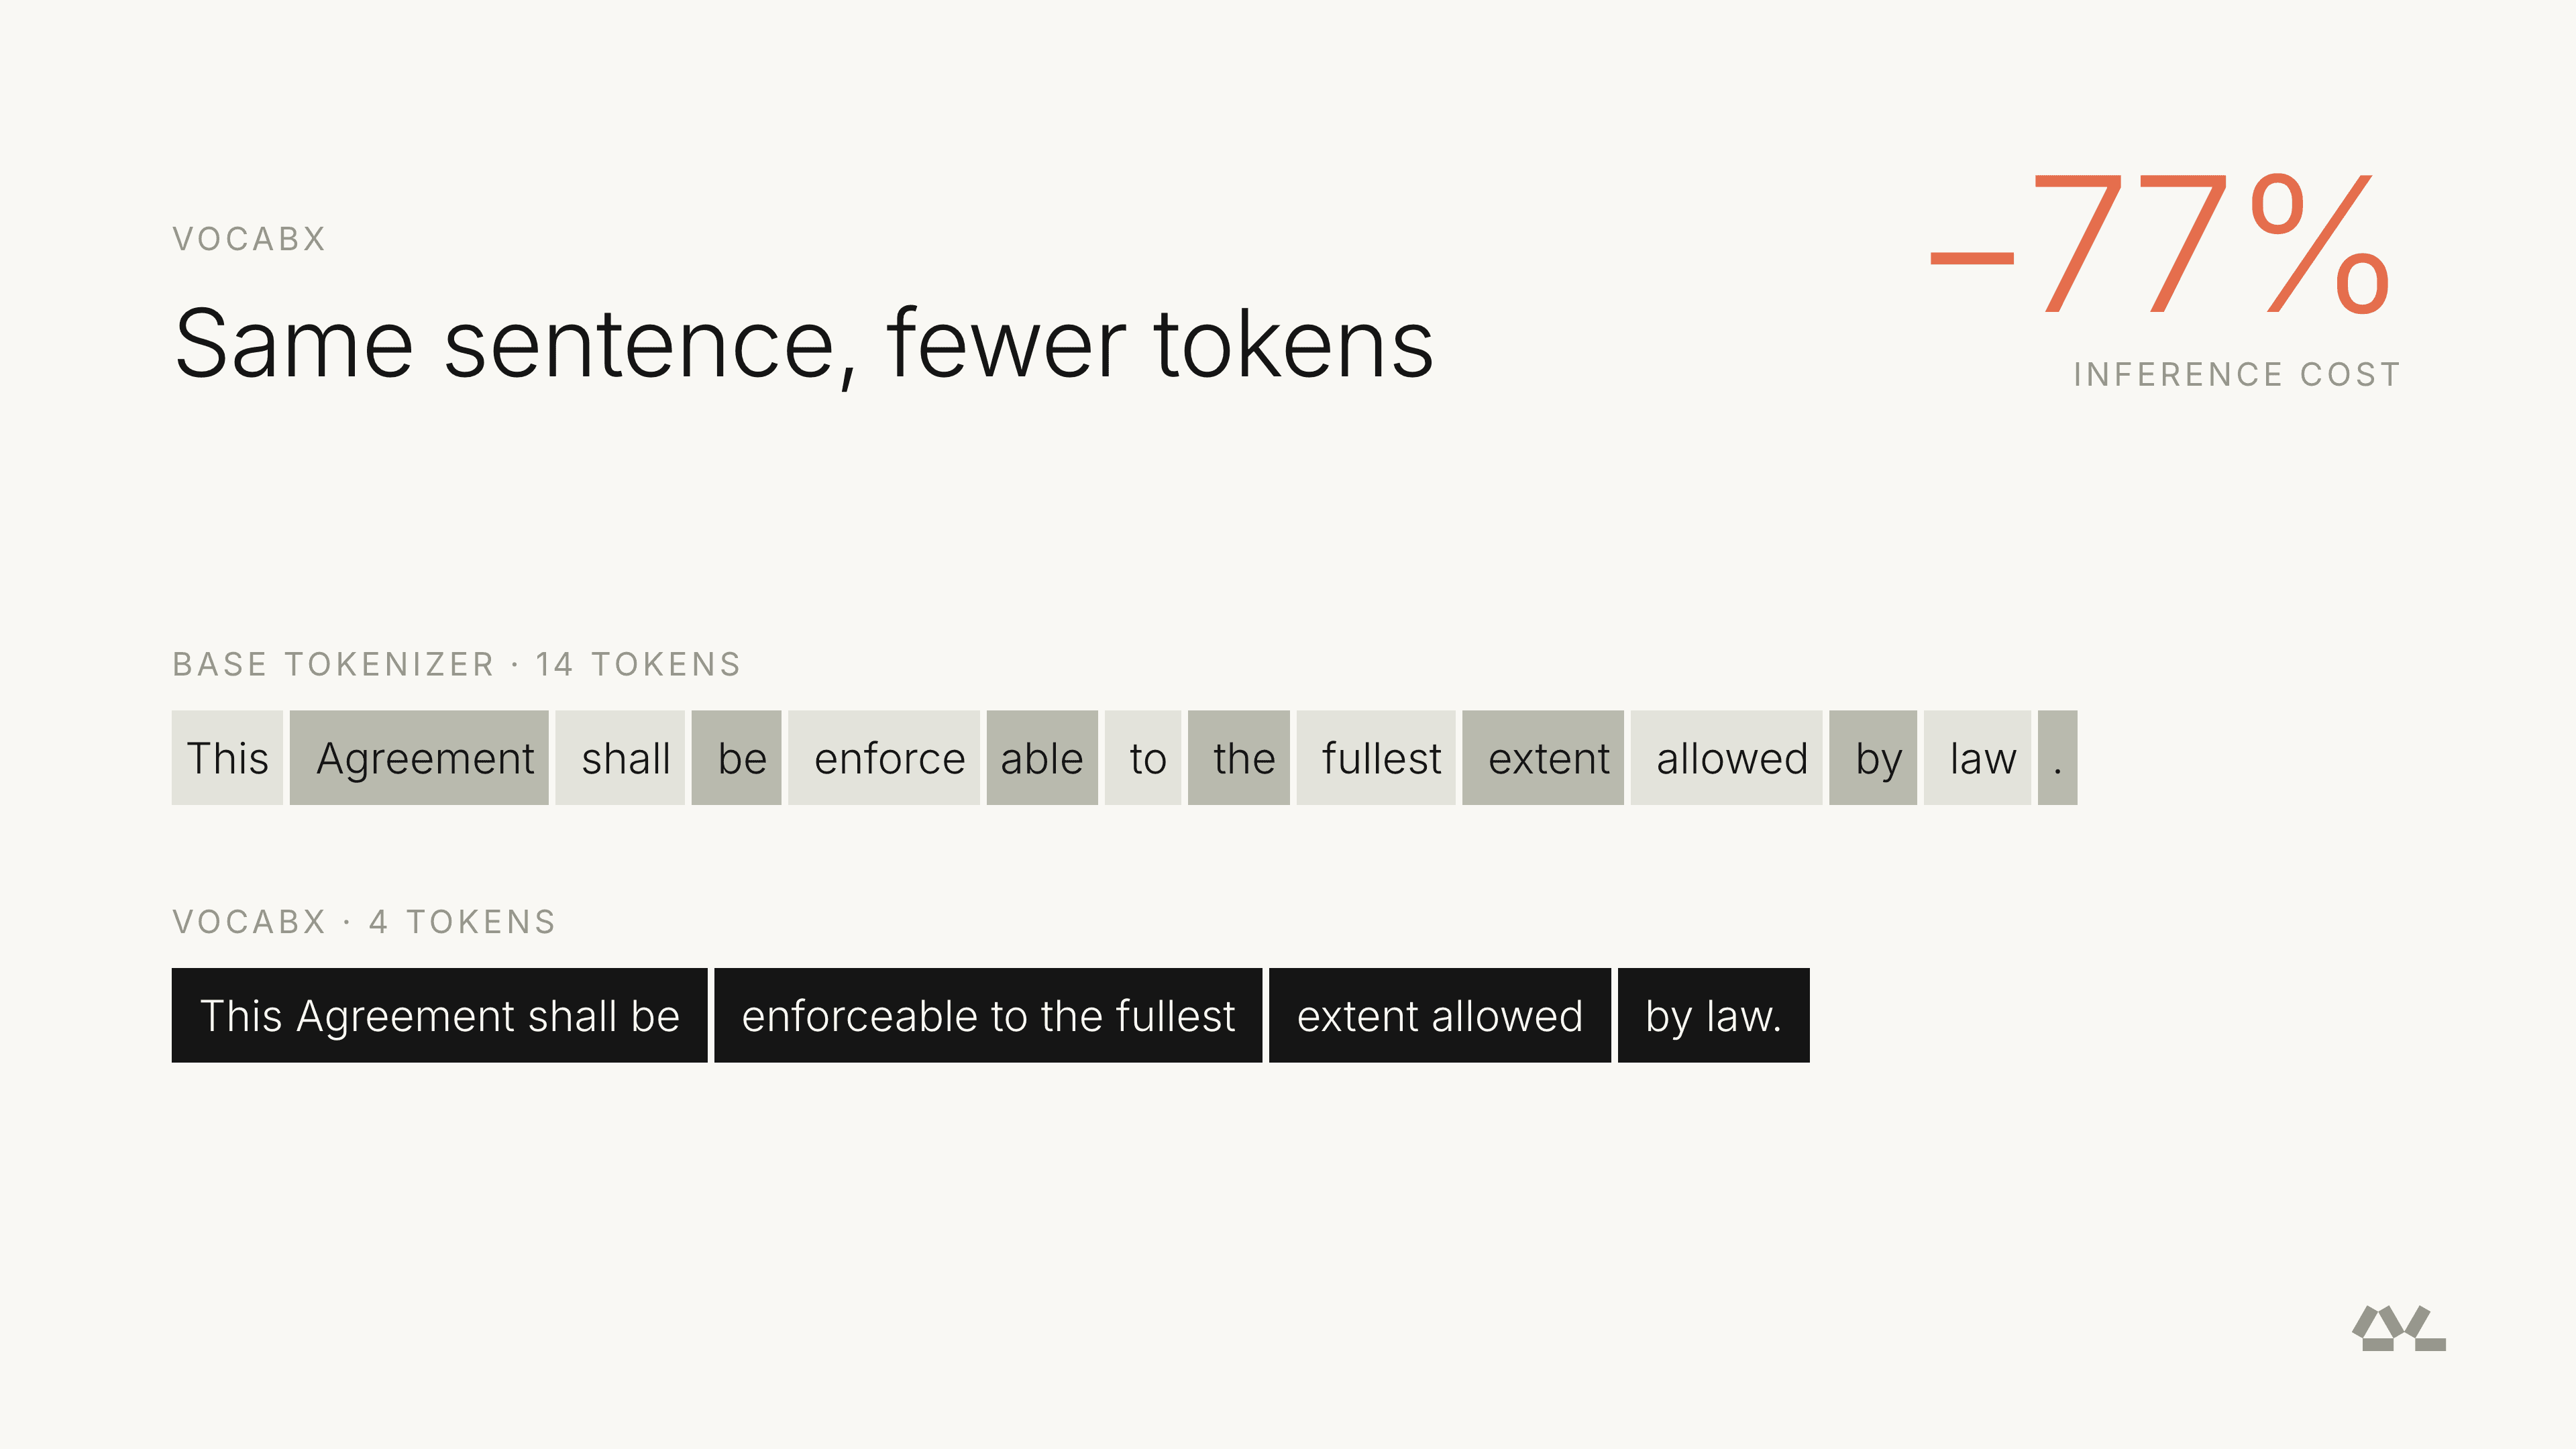
โดยทั่วไป tokenizer มักถูกมองว่าเป็นคุณสมบัติคงที่ของ base model ที่แก้ไขไม่ได้ แต่สำหรับโมเดลที่เชี่ยวชาญเฉพาะทาง มันอาจเป็นตัวขับเคลื่อนต้นทุนที่ใหญ่ที่สุด ซึ่งถูกกำหนดไว้ตั้งแต่ก่อนเริ่มขั้นตอน training
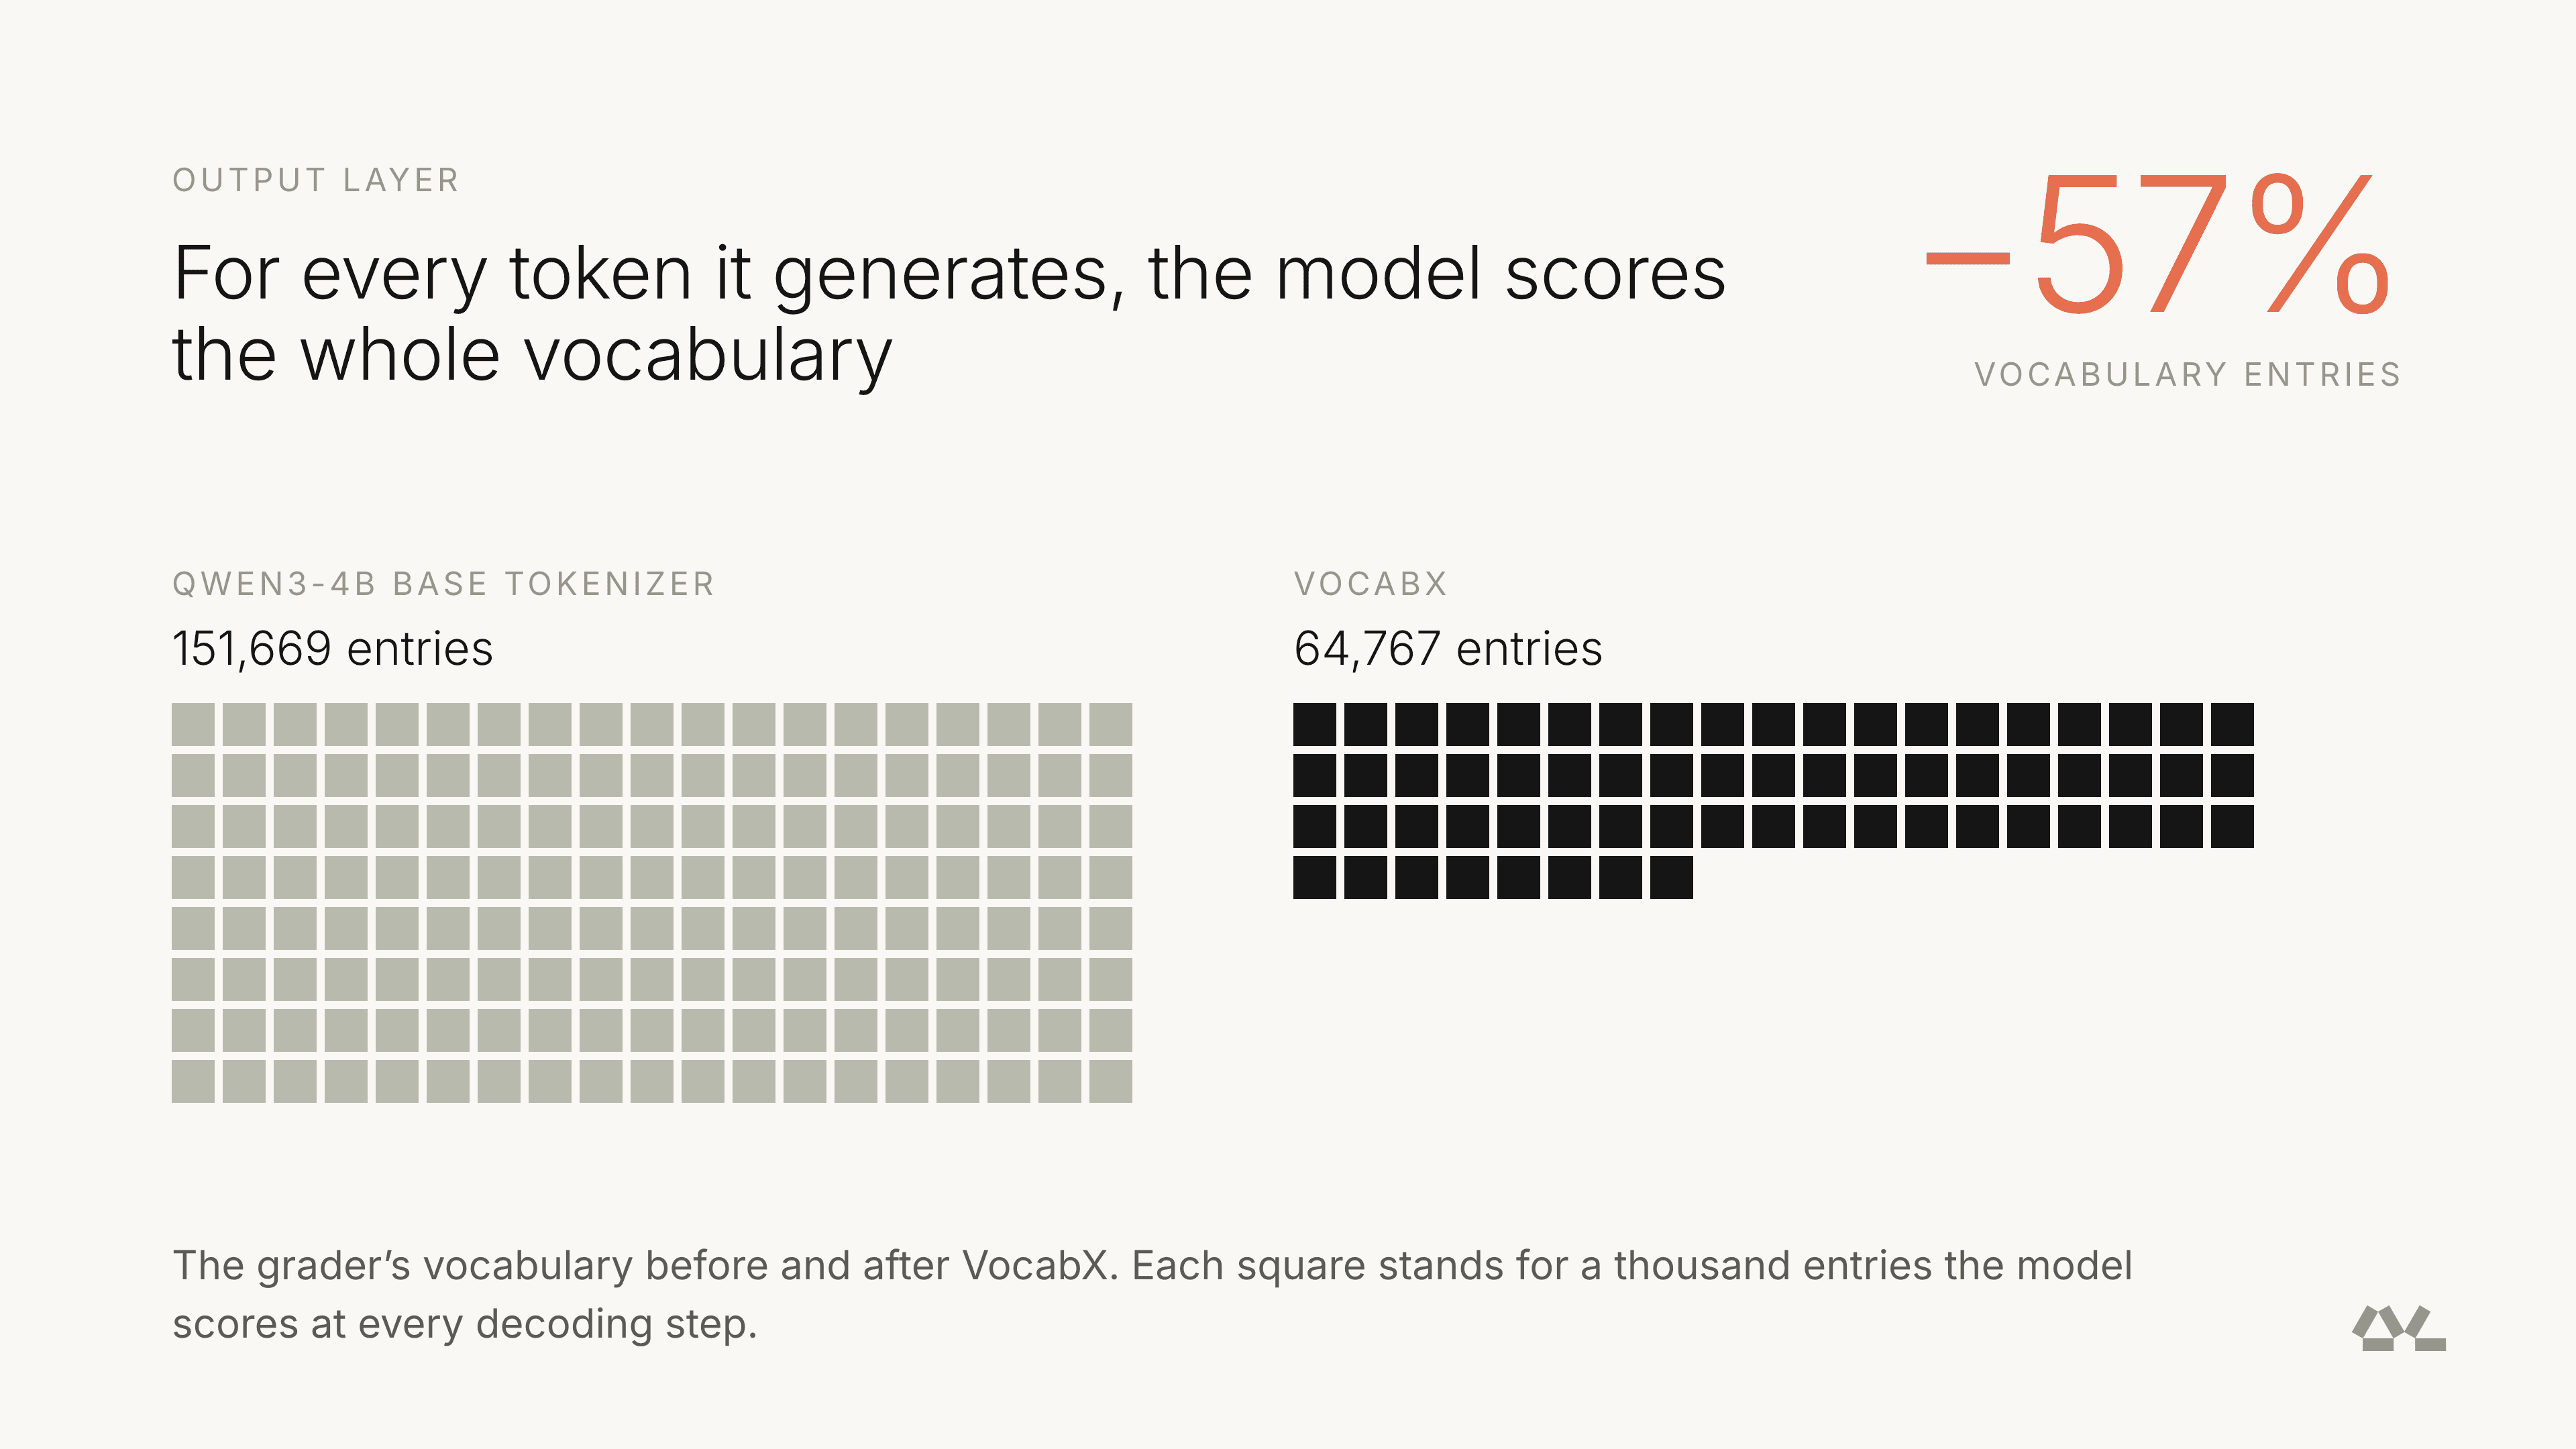
หนึ่งในตัวอย่างคือระบบตรวจเรียงความภาษาโปรตุเกสอัตโนมัติบน Qwen3-4B ที่ส่งคืนผลประเมินในรูปแบบ JSON แม้ตัวโมเดลจะมีขนาดเล็กเพียง 4 พันล้านพารามิเตอร์ แต่ tokenizer เดิมที่ออกแบบมาเพื่อหลายภาษาทำให้เกิดต้นทุนส่วนเกิน ทั้งจากจำนวน token ที่มากกว่าความจำเป็น และภาระที่โมเดลต้องให้คะแนน vocabulary ถึง 151,669 รายการ ซึ่งส่วนใหญ่แทบไม่ได้ใช้งาน
เราจึงสร้าง vocabulary ขึ้นใหม่ด้วยวิธี VocabX โดยใช้โมเดลและข้อมูลชุดเดิม ผลลัพธ์เบื้องต้นจากงานวิจัยที่อยู่ระหว่างการพิจารณาพบว่าสามารถเพิ่มประสิทธิภาพได้อย่างมีนัยสำคัญ
Vocabulary ที่สร้างมาเพื่อทุกคน
แม้โมเดลอเนกประสงค์จะเหมาะกับการใช้ tokenizer ที่รองรับหลายโดเมนและหลายภาษา แต่สำหรับโมเดลเฉพาะทาง มันสร้างความสูญเปล่าในสองด้าน:
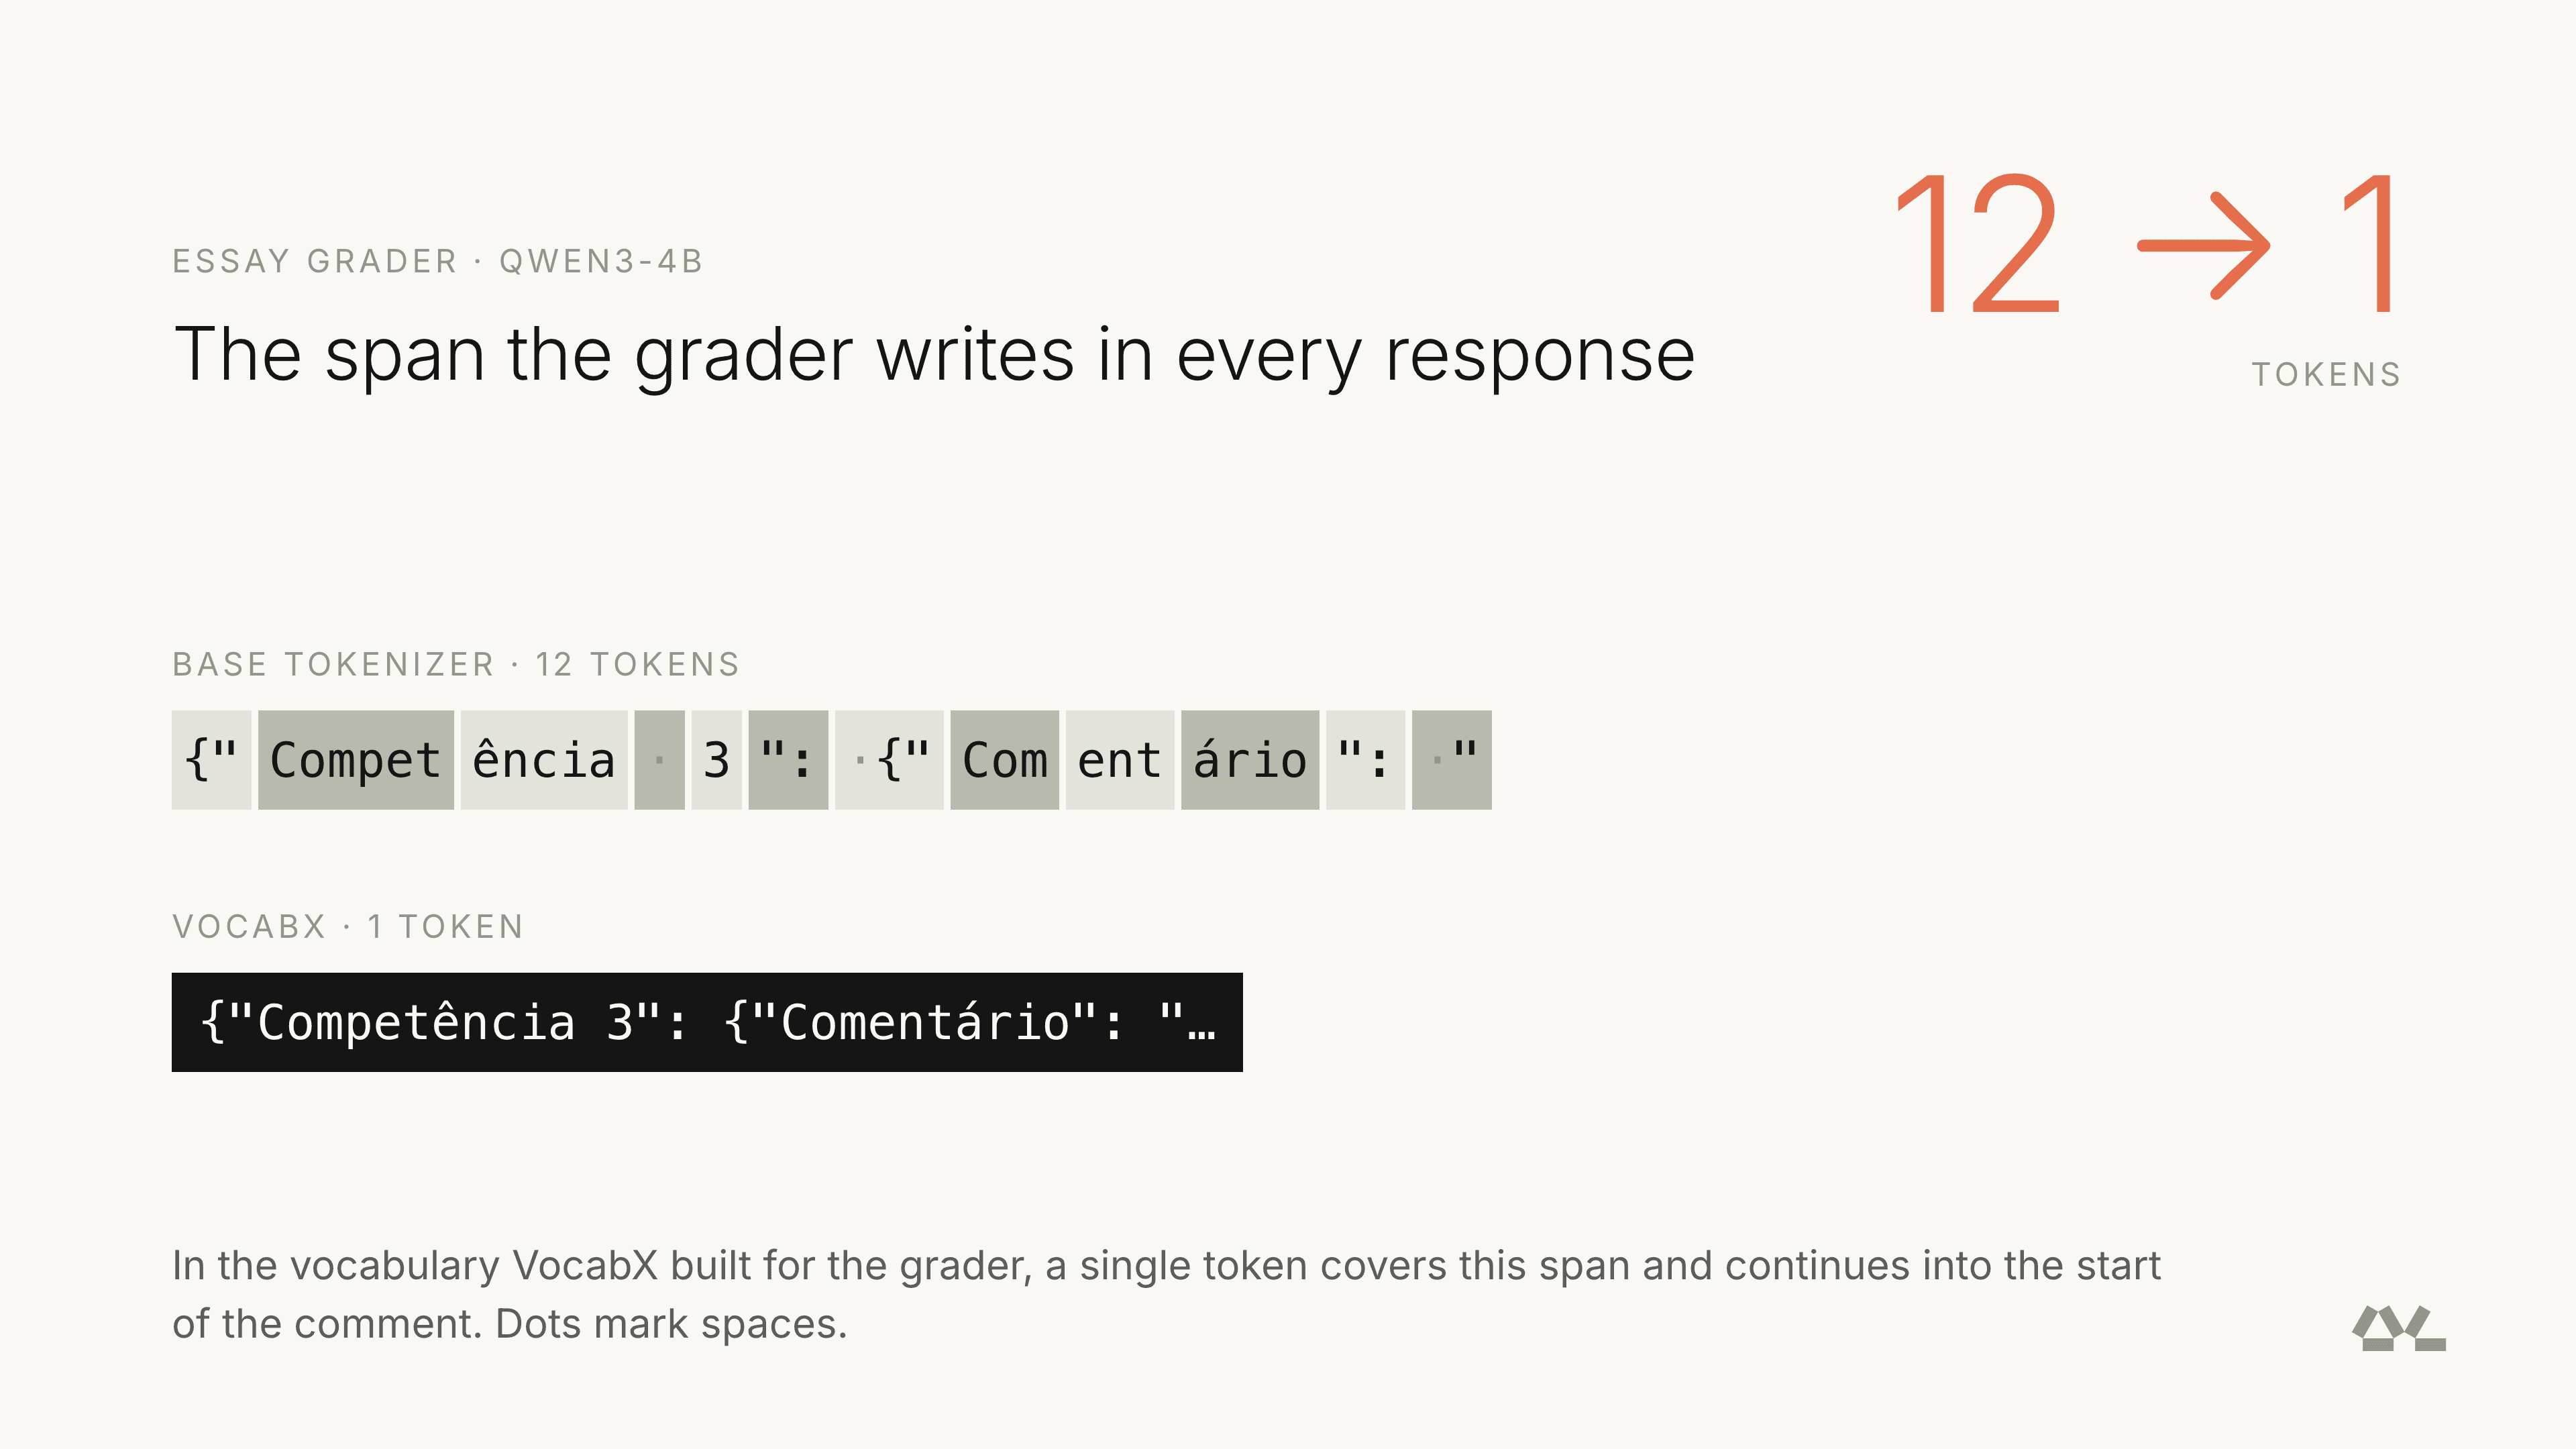
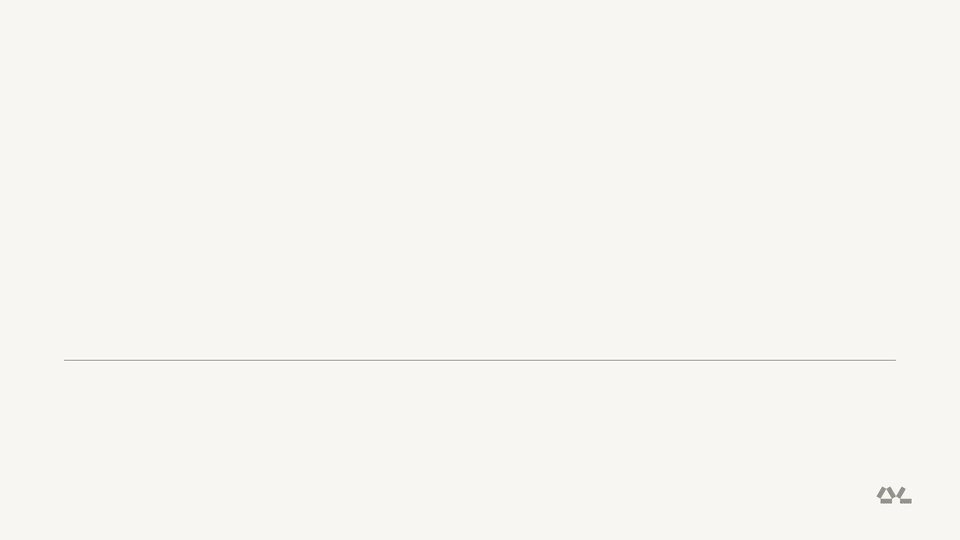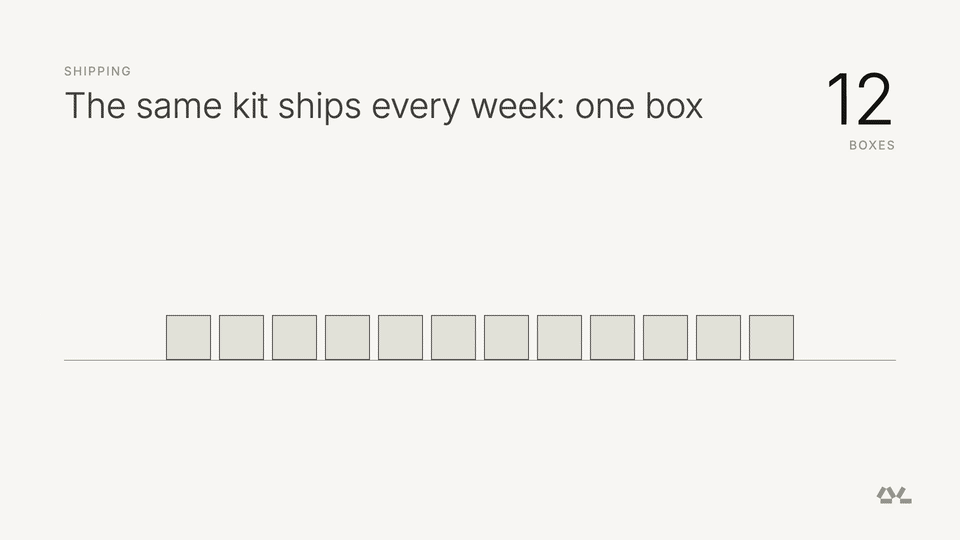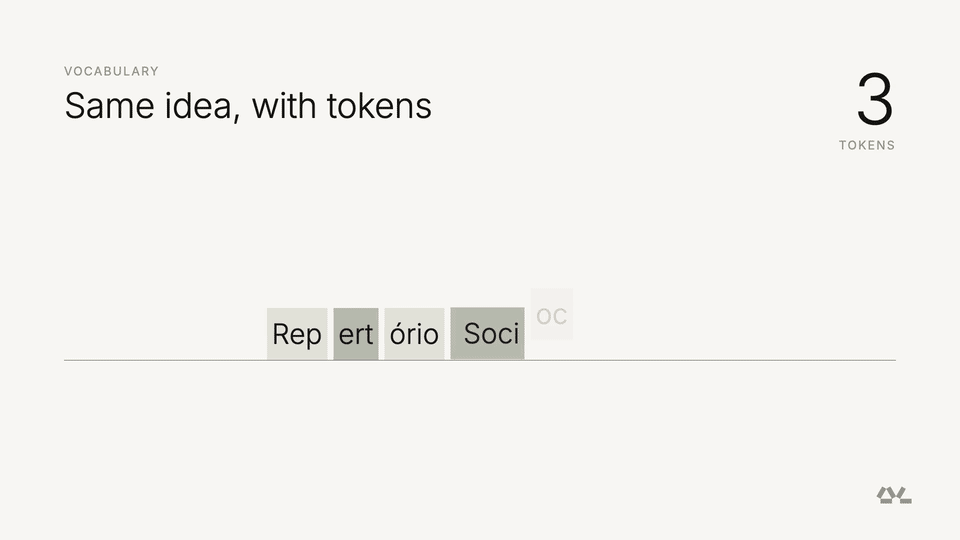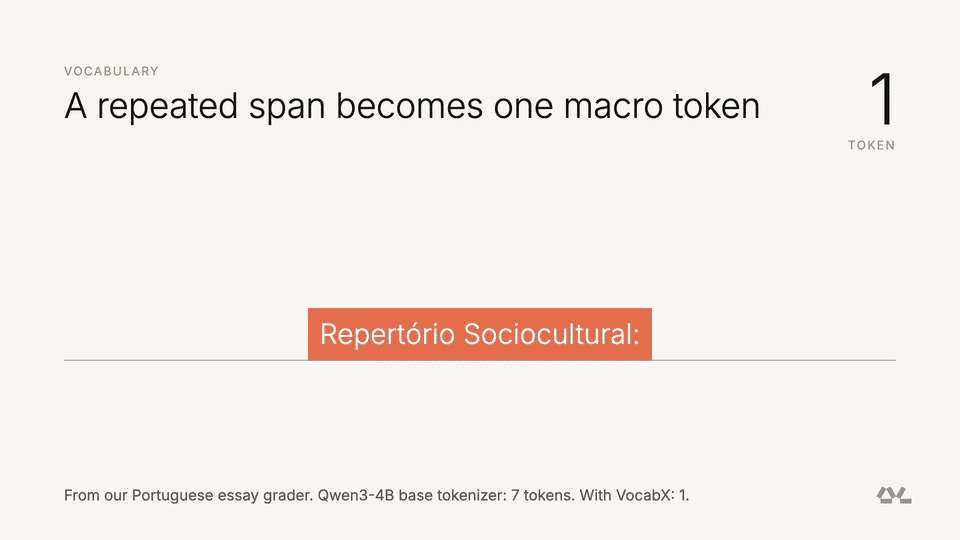
- การแตกกระจาย (Fragmentation): tokenizer จะแยกสิ่งที่โดเมนนั้นพูดซ้ำบ่อยๆ ออกเป็นหลายชิ้น เช่น JSON envelope หรือข้อความมาตรฐาน (boilerplate) ทำให้โมเดลต้องแบกรับต้นทุนทุก token ในทุกคำขอ
- ส่วนเกิน (Excess): vocabulary แบกรับรายการที่โดเมนนั้นไม่เคยใช้ ทำให้โมเดลต้องเสียเวลาคำนวณคะแนนให้รายการเหล่านั้นในทุกขั้นตอน เช่น โมเดลตรวจข้อสอบในอเมริกาแต่ยังต้องคำนวณความน่าจะเป็นของภาษาจีน
การอ่านนั้นถูก แต่การเขียนนั้นแพง
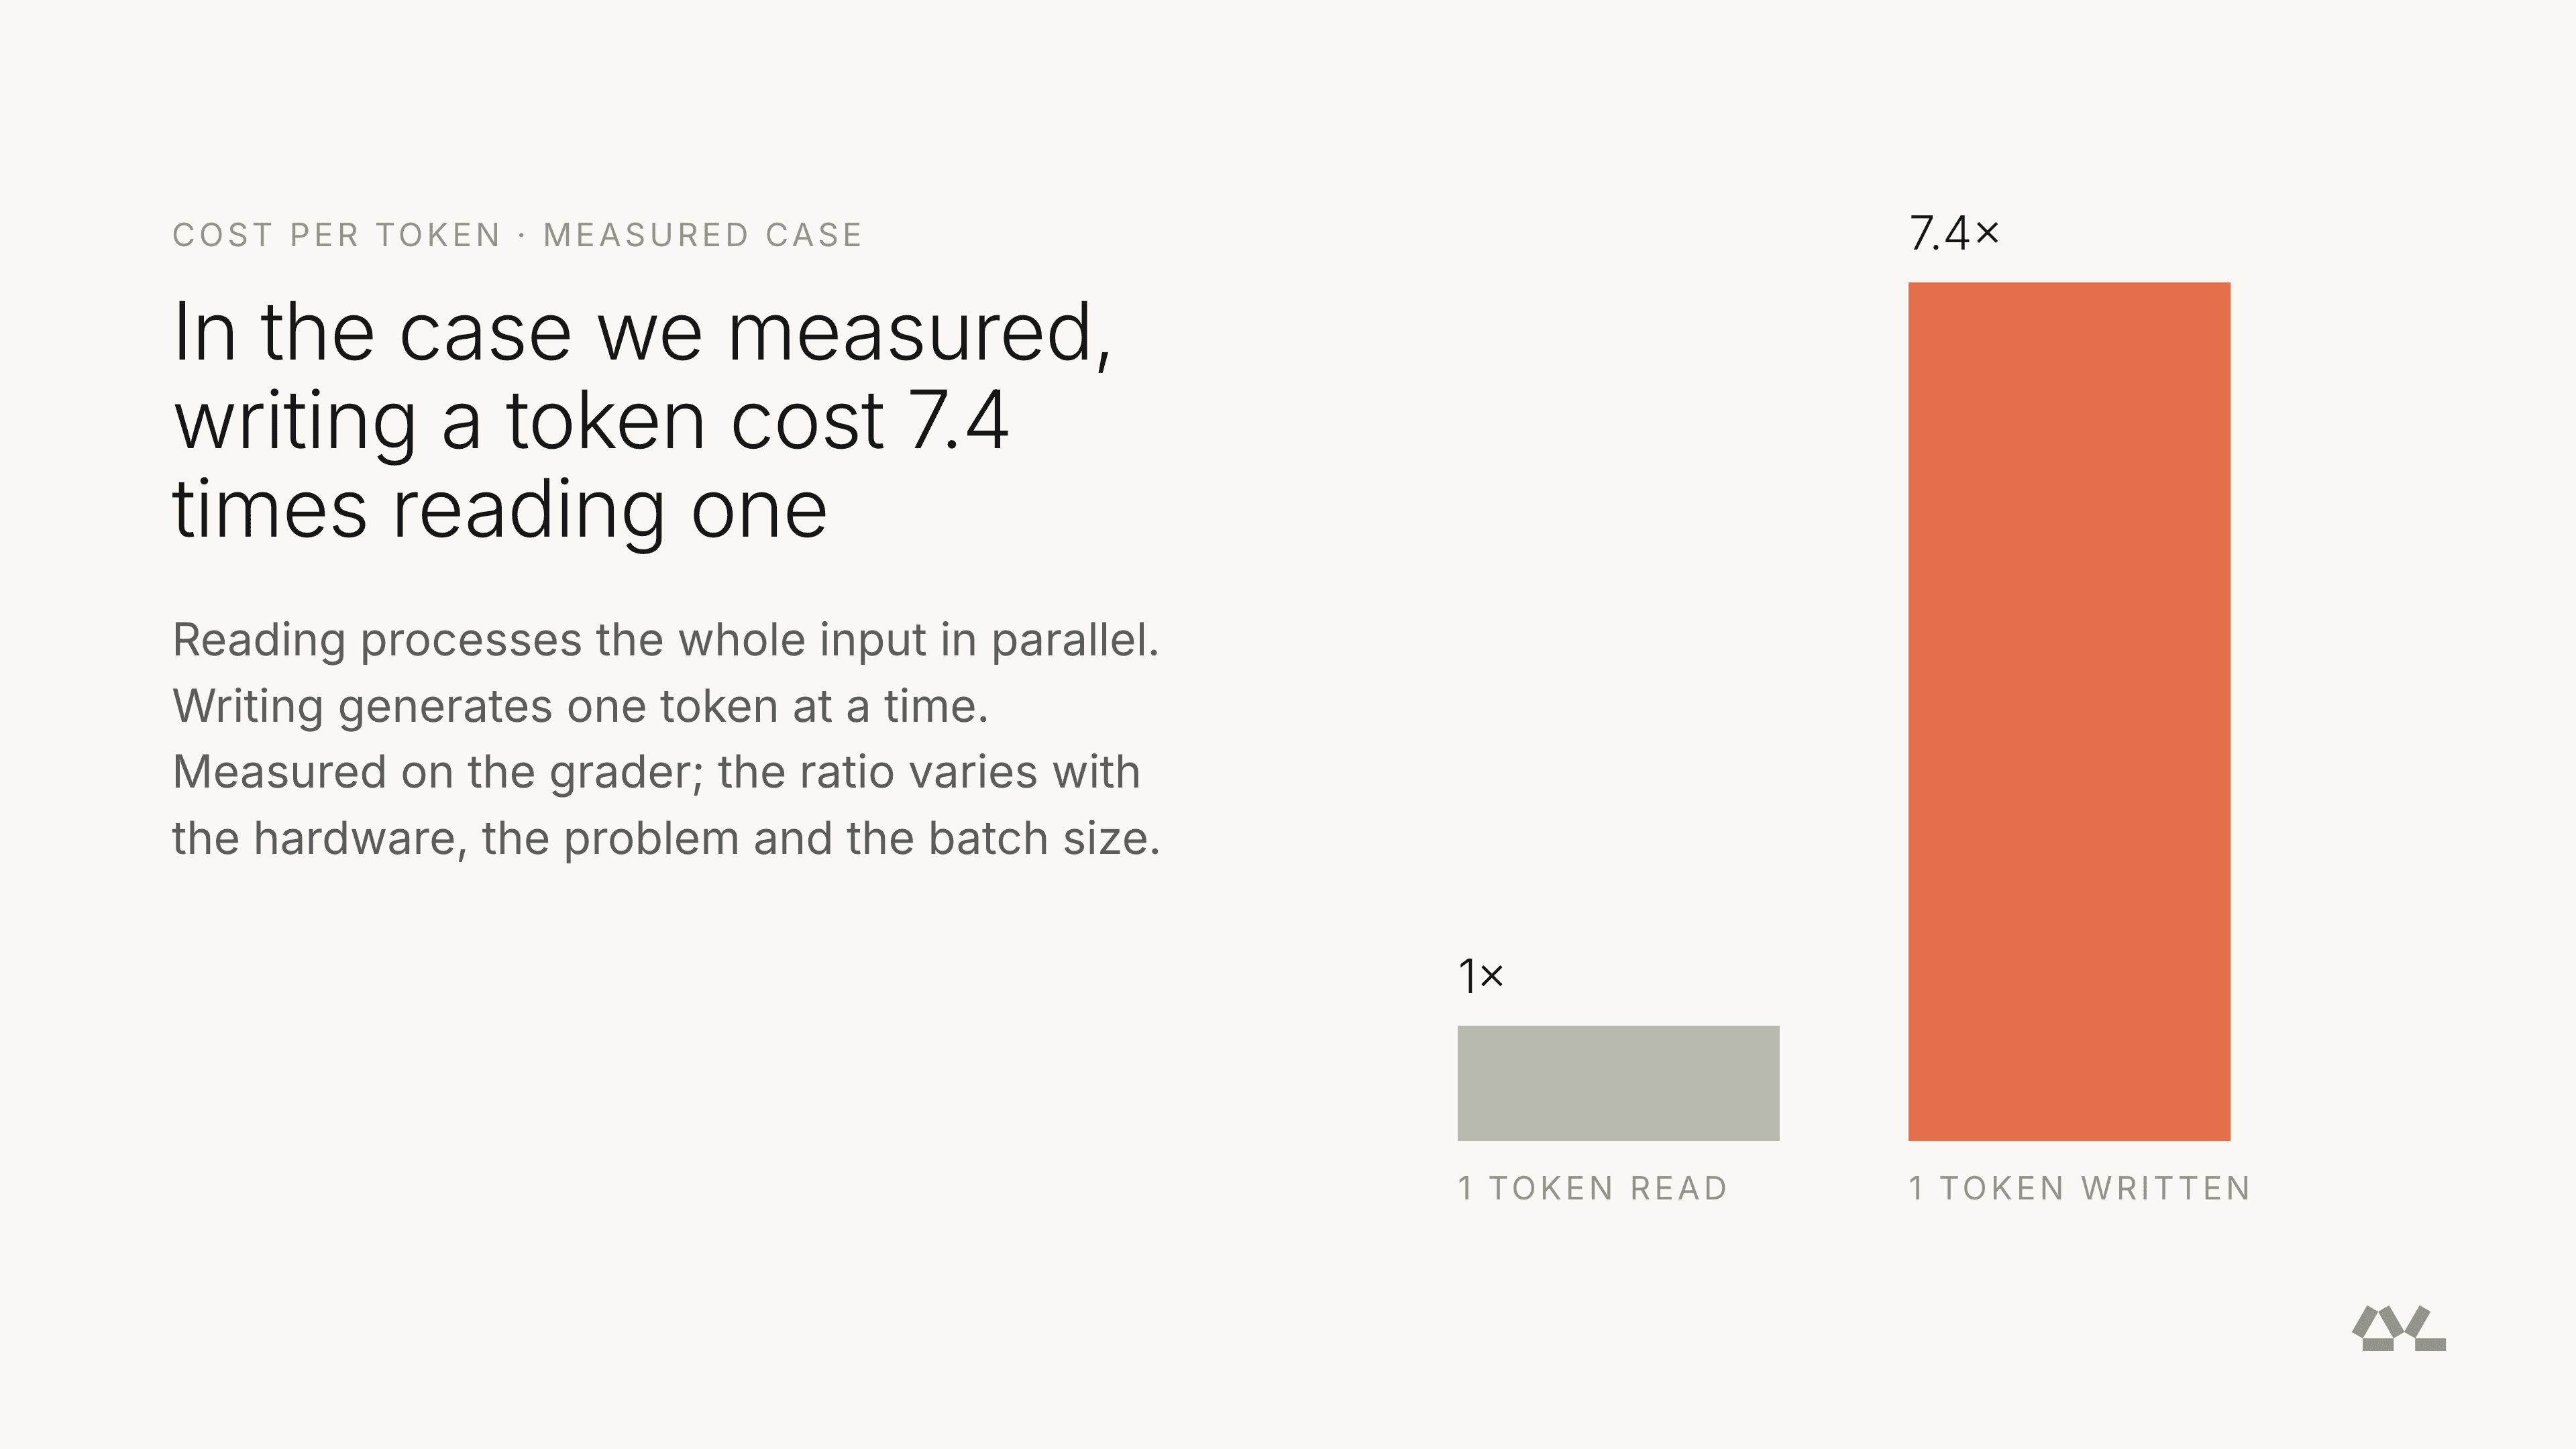
ในการให้บริการ (inference) ขั้นตอน decode ที่สร้างคำตอบออกมาทีละ token มีราคาแพงกว่าขั้นตอน prefill มาก เพราะถูกจำกัดด้วยแบนด์วิดท์ของหน่วยความจำ (memory bandwidth) ในระบบตรวจเรียงความที่เราพบ token ที่ถูกสร้างขึ้น (generate) มีต้นทุนสูงถึง 7.4 เท่าของ token ที่ถูกอ่าน
นอกจากนี้ layer สุดท้ายของโมเดล (LM head) ยังต้องแบกรับ matrix พารามิเตอร์ตามขนาด vocabulary ทุกแถวที่เพิ่มเข้ามาหมายถึงข้อมูลที่ต้องเคลื่อนย้ายมากขึ้นในทุกขั้นตอน VocabX จึงลดขนาด output layer ลงจาก 152,000 แถว เหลือประมาณ 65,000 แถวในระบบตรวจเรียงความ
ทำไมโซลูชันที่มีอยู่ถึงยังไม่ดีพอ
วิธีการเดิมๆ เช่น FVT หรือ MWT มักมีข้อจำกัดเพราะเลือก token ตามความถี่ไม่ใช่ตามต้นทุน และมักทำงานเพียง layer เดียว ทำให้ไม่สามารถจัดการกับข้อความซ้ำซ้อนยาวๆ อย่าง JSON envelope ได้อย่างมีประสิทธิภาพ
วิธีการแก้ปัญหาของ VocabX
VocabX จัดการปัญหานี้ด้วย 3 กลยุทธ์หลัก:
- เปลี่ยนเกณฑ์การคัดเลือก: คำนวณความประหยัดตามต้นทุนจริง โดยให้ความสำคัญกับการประหยัด token ในฝั่งขาออก (output) ที่แพงกว่าขาเข้าถึง 7.4 เท่า
- ทำงานสอง layer พร้อมกัน: ปรับปรุงทั้งระดับ sub-word และ multi-word โดยสร้าง "macro token" สำหรับช่วงข้อความที่ซ้ำกันยาวๆ
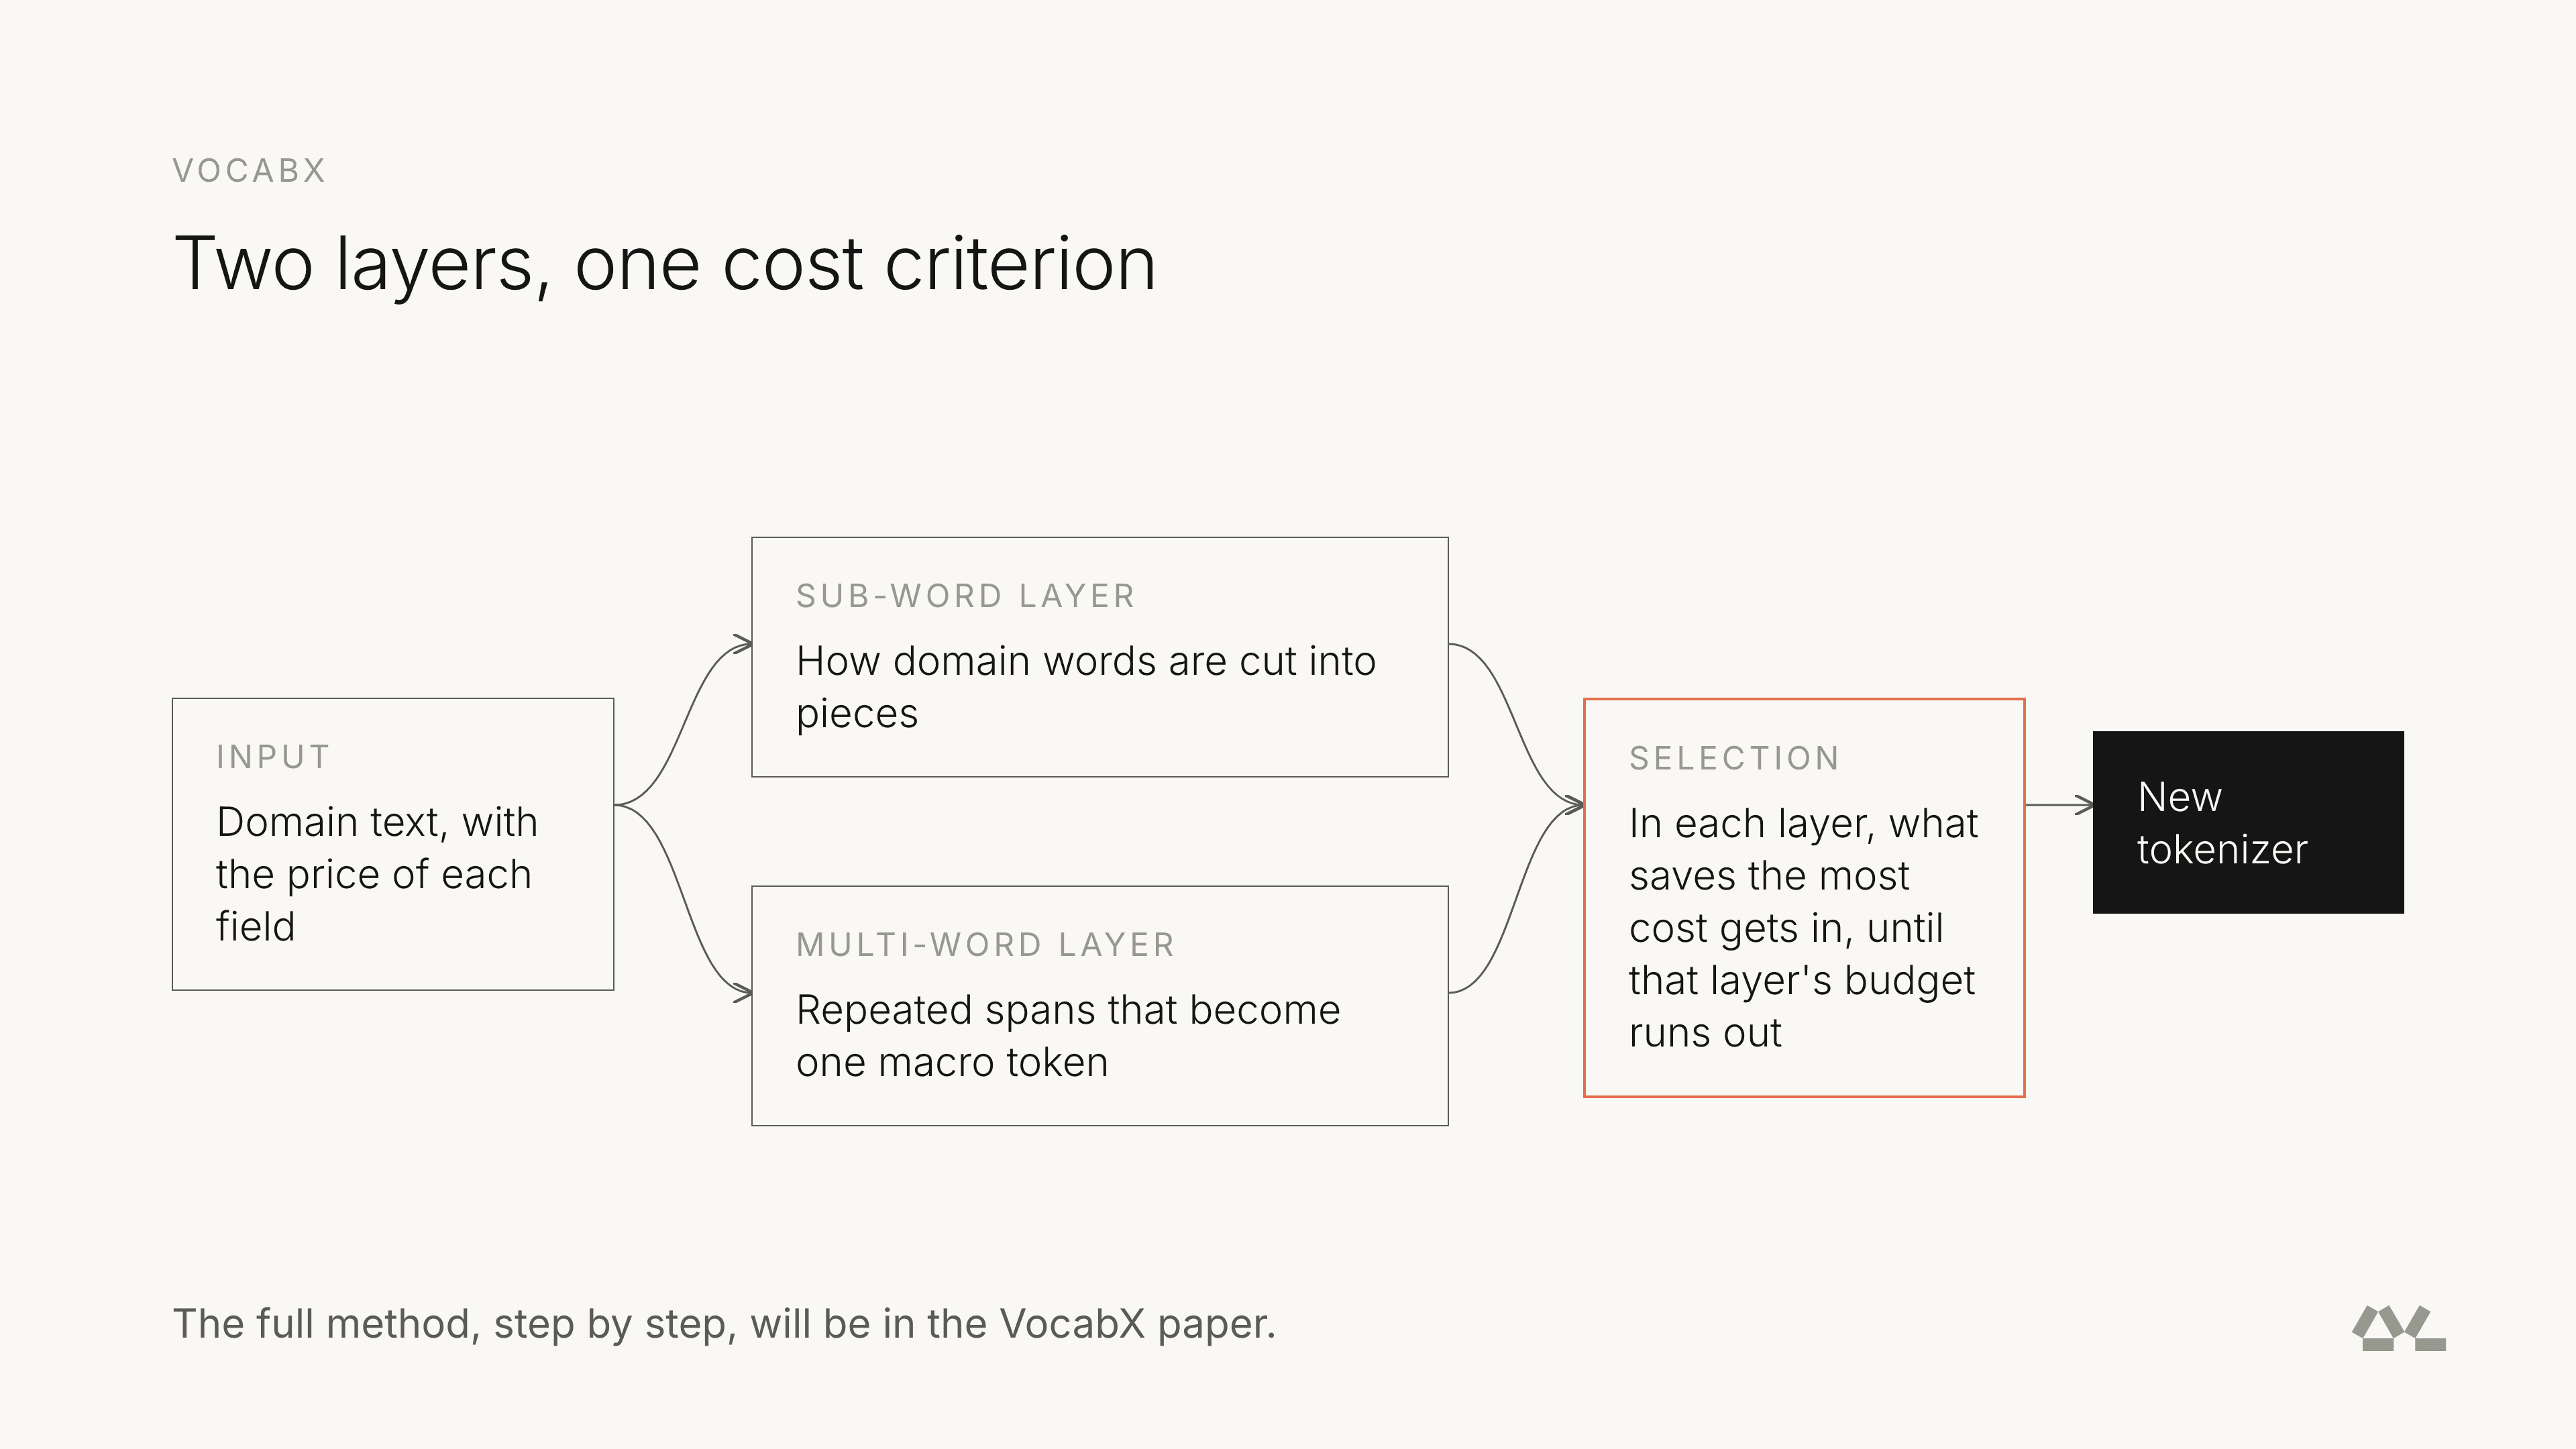
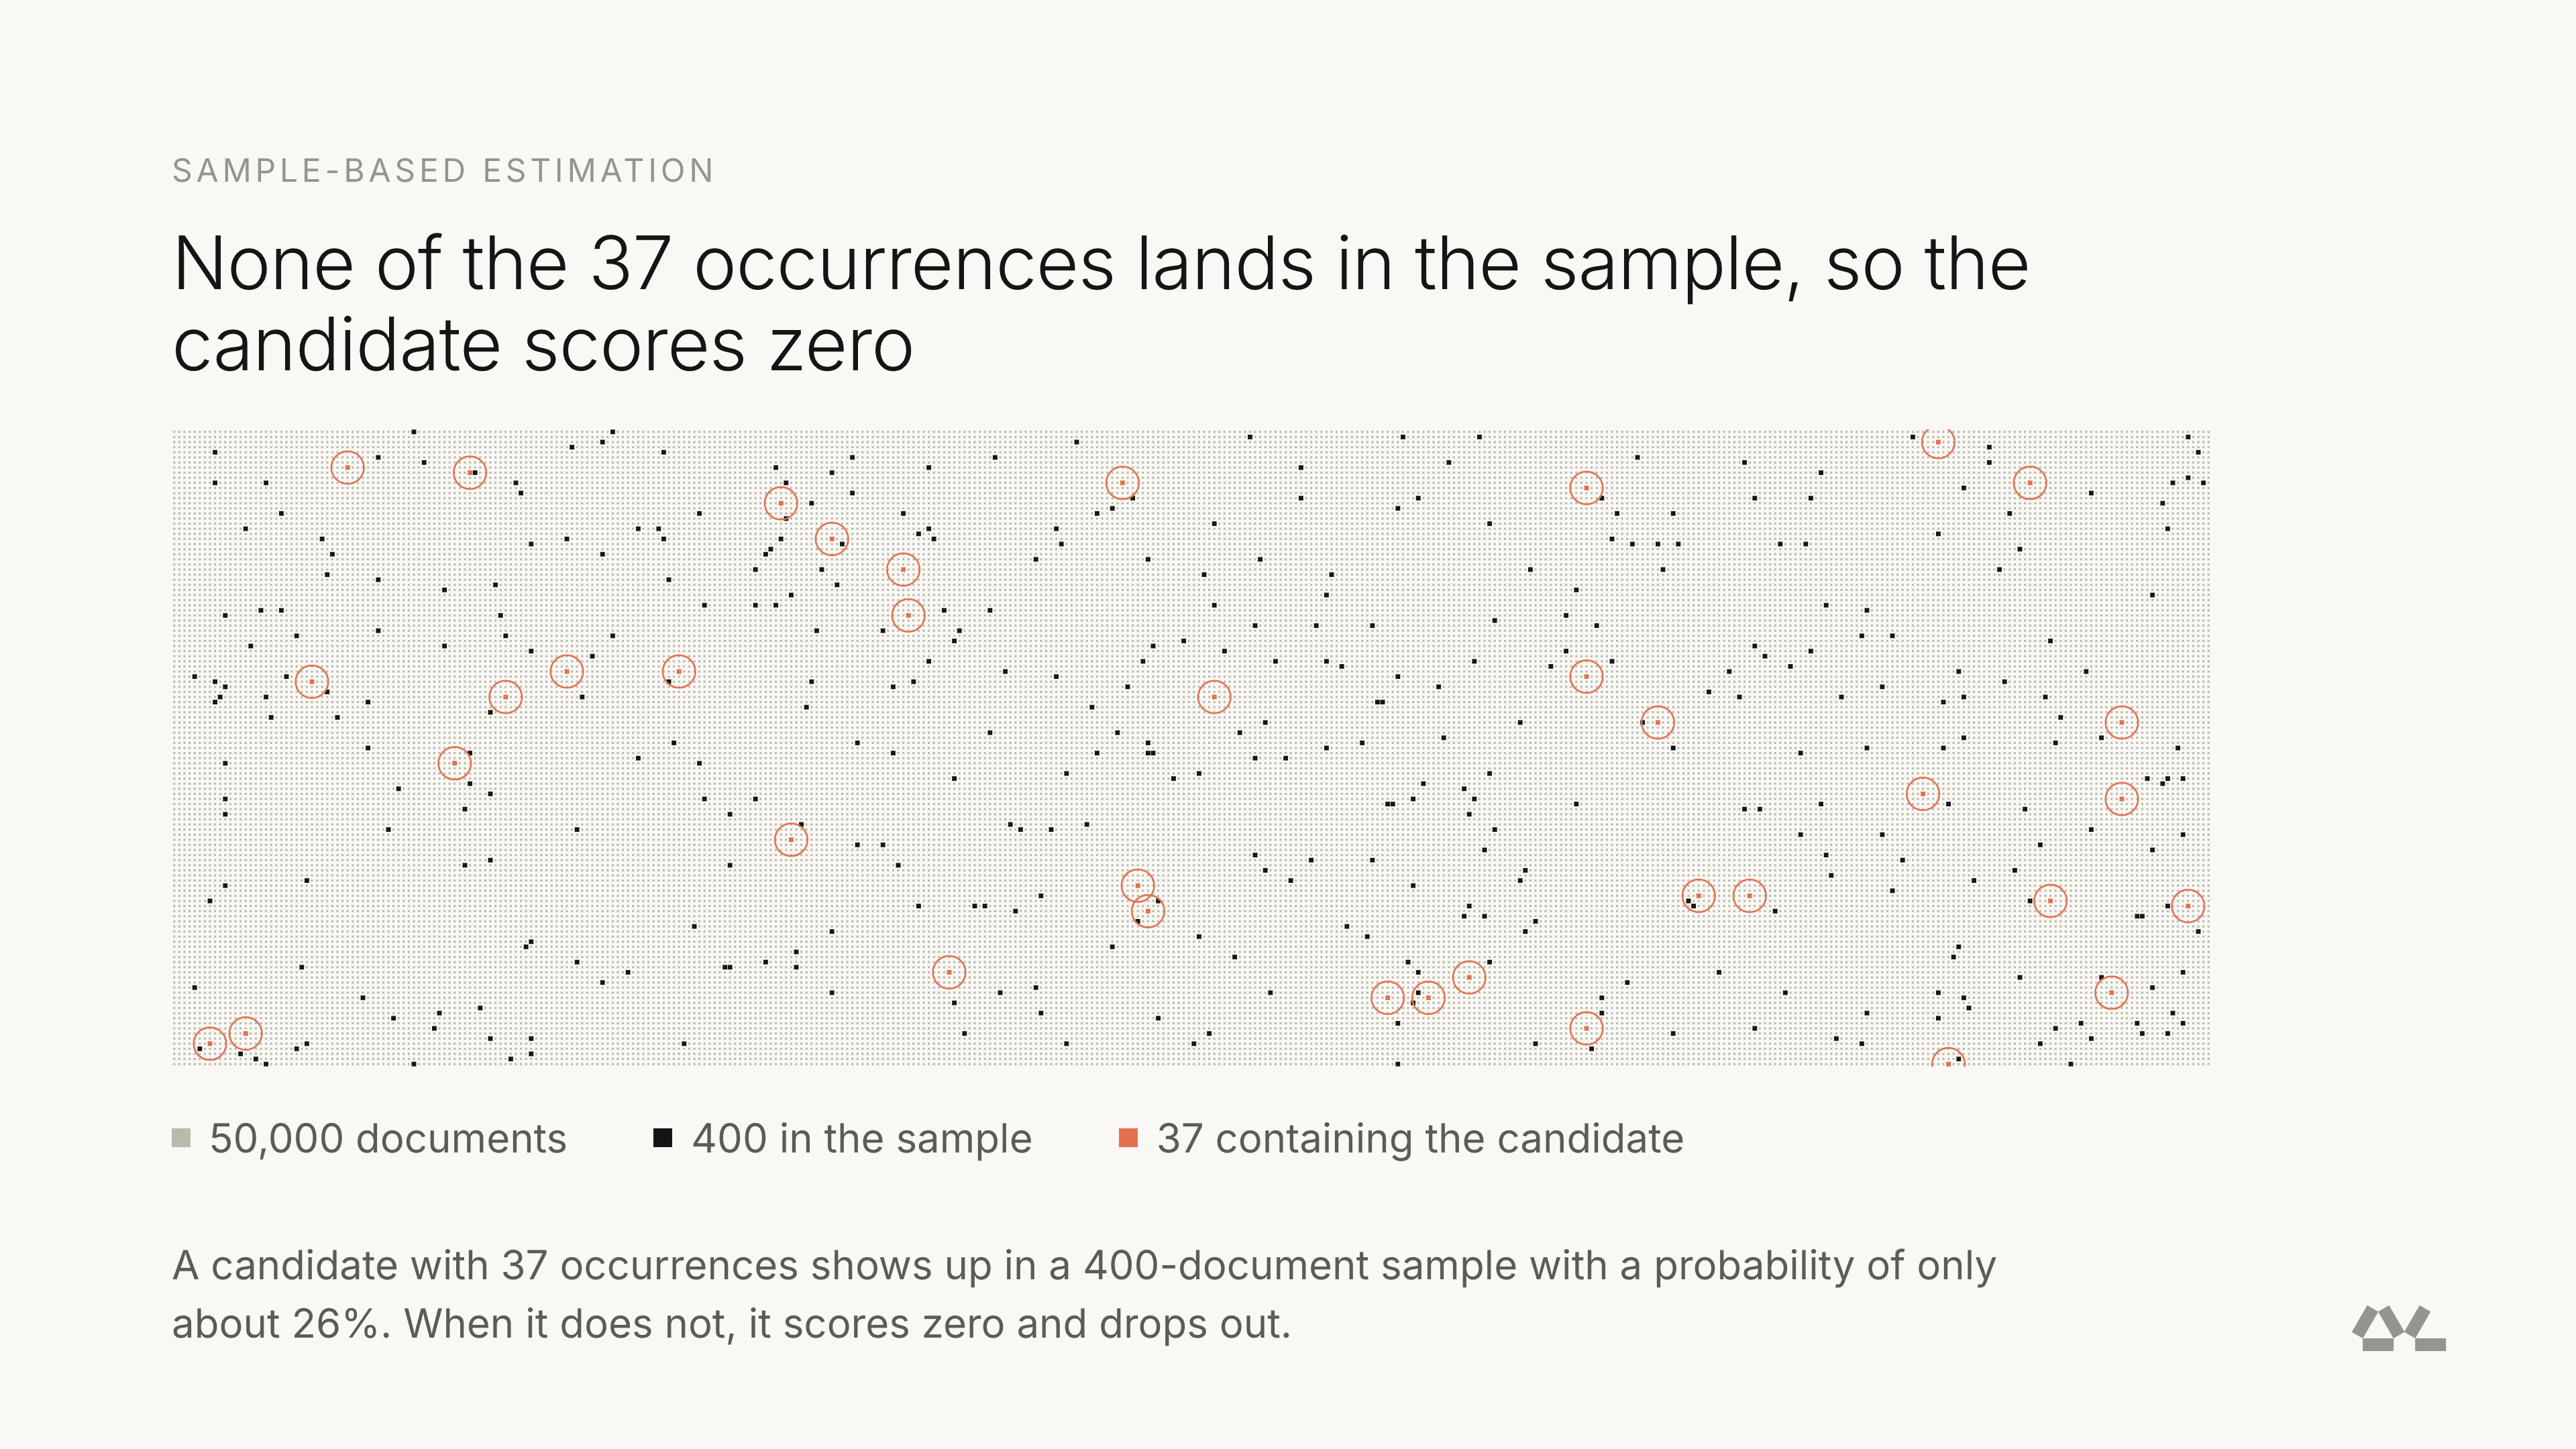
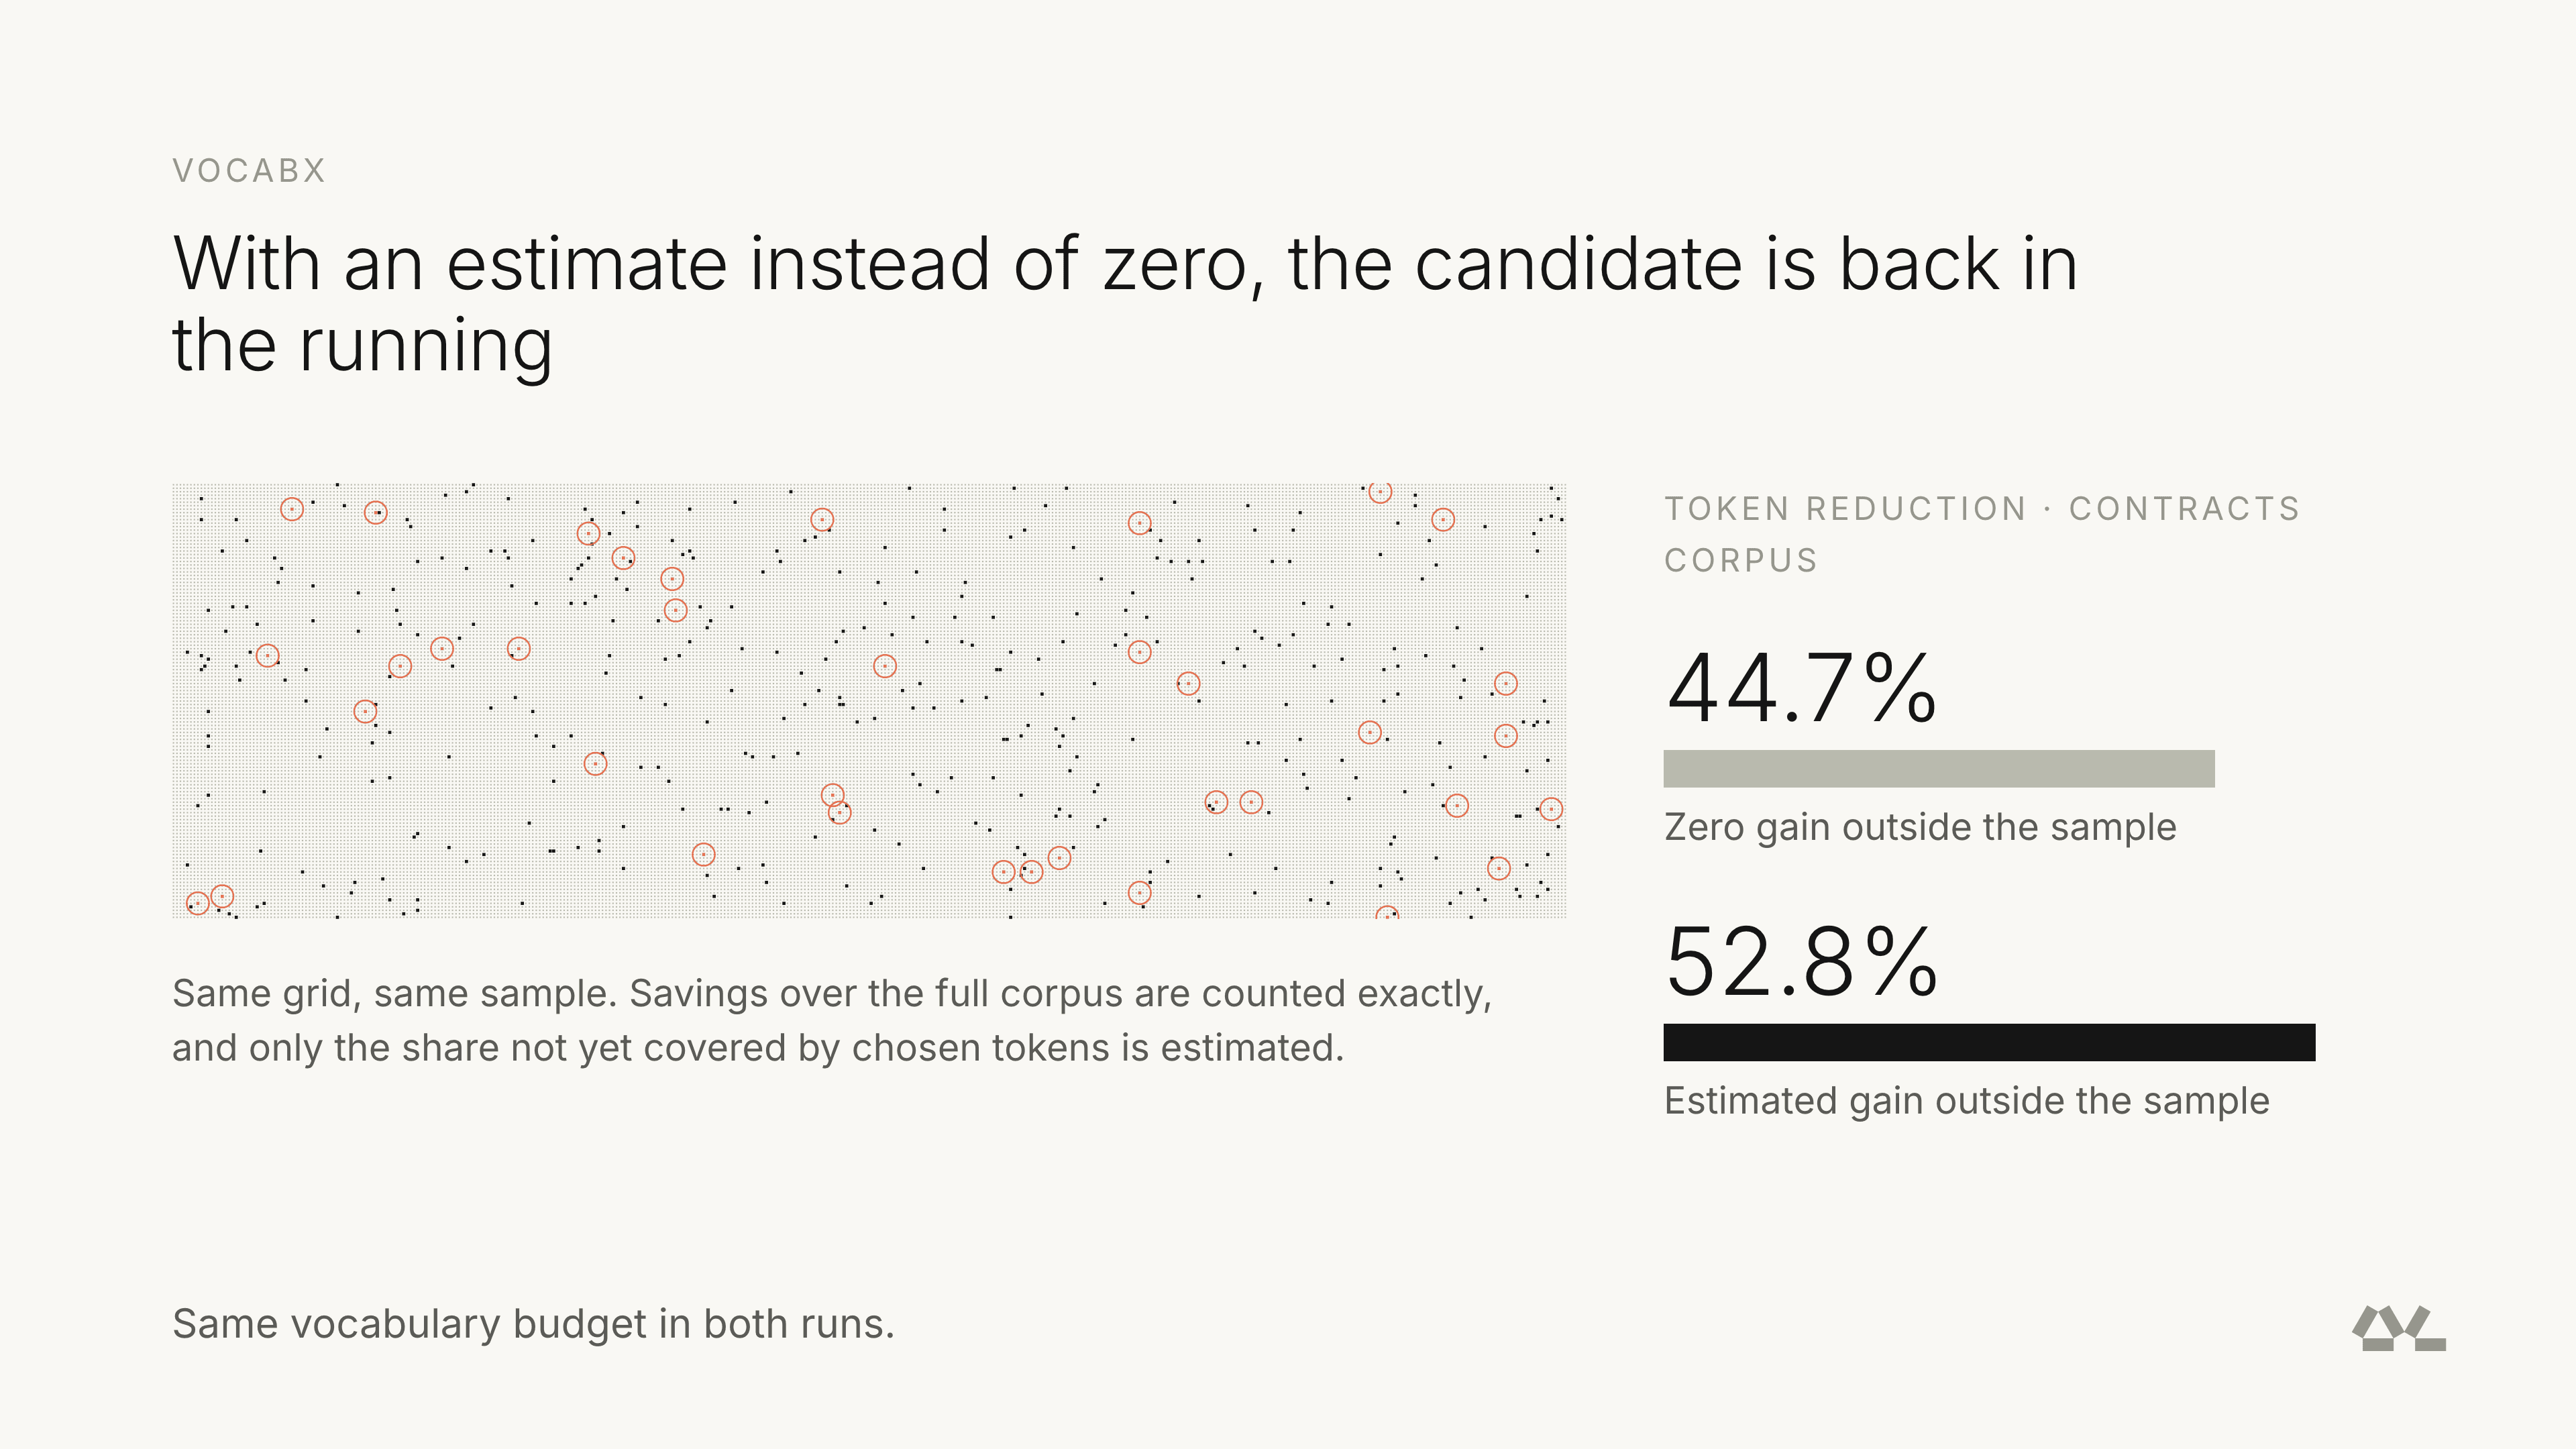
- ประมาณการข้อมูลนอกกลุ่มตัวอย่าง: ใช้การประมาณทางสถิติช่วยให้ token ที่พบไม่บ่อยในกลุ่มตัวอย่างแต่มีประโยชน์ในคลังข้อมูลจริงยังคงมีโอกาสถูกเลือก
ผลลัพธ์ในระบบตรวจเรียงความ
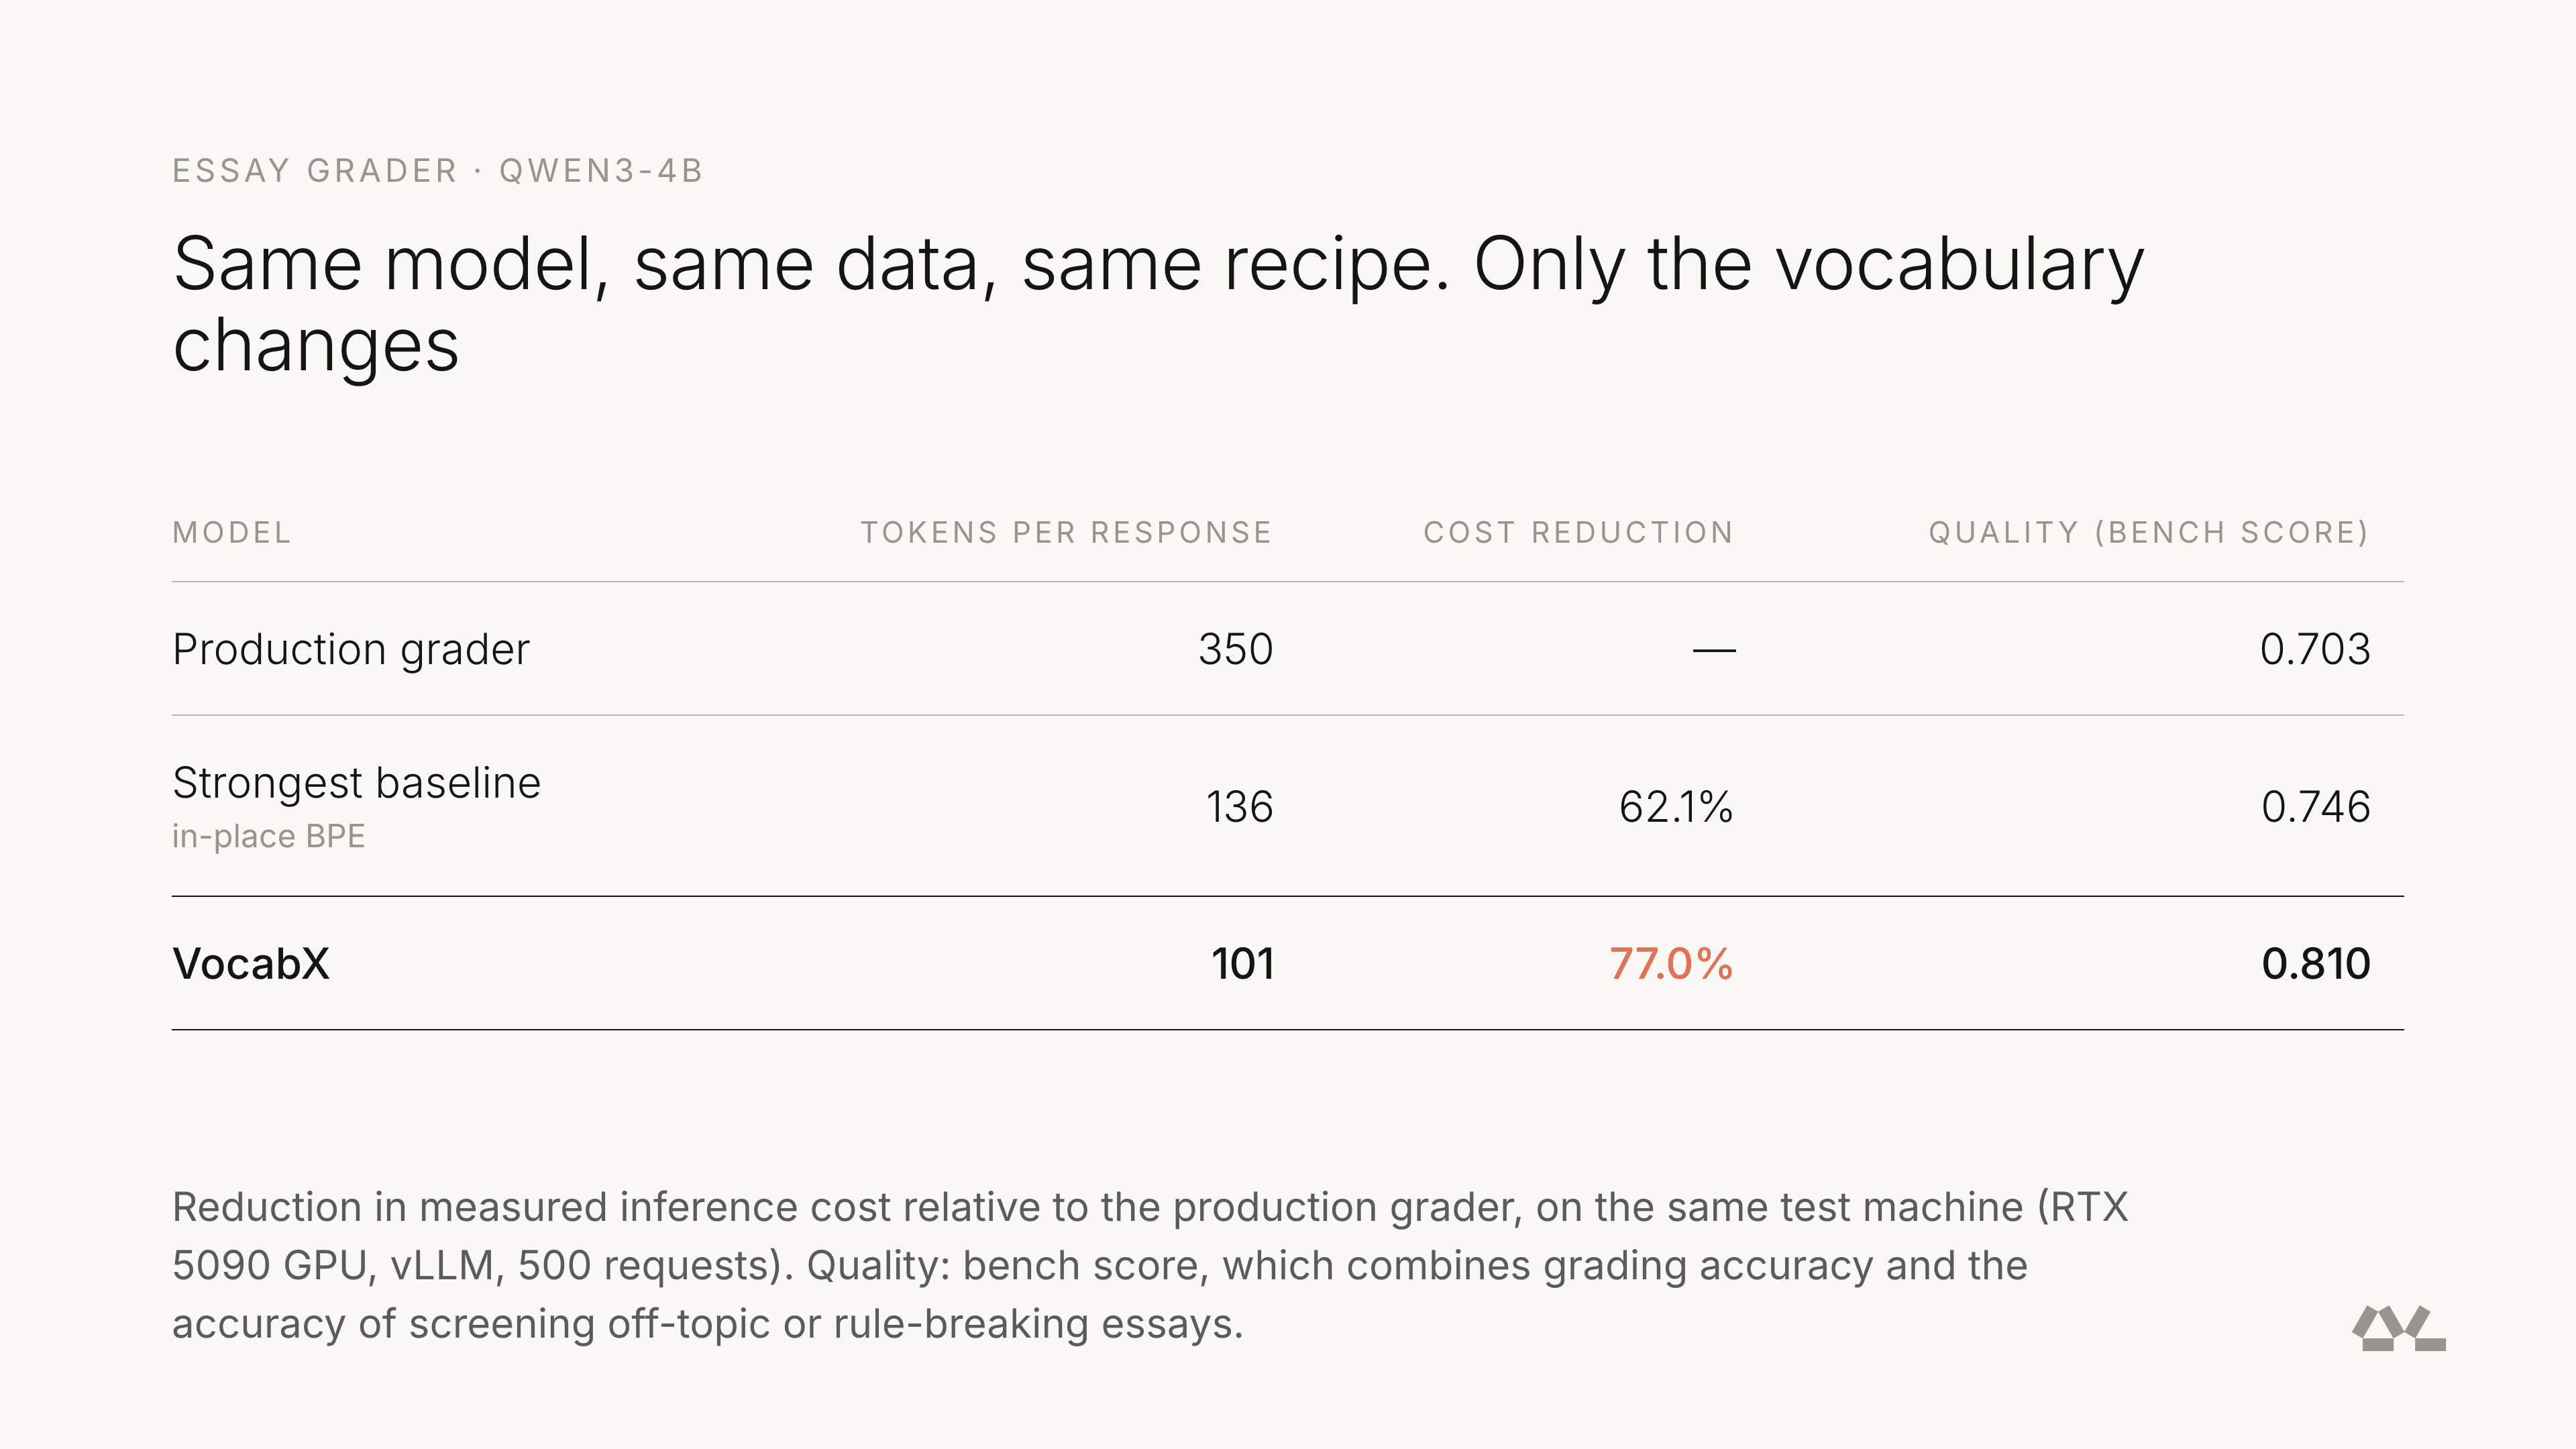
จากการทดสอบด้วย GPU RTX 5090 ระบบที่ใช้ VocabX สามารถลดจำนวน token ในการตอบกลับจาก 350 เหลือ 101 token ช่วยลดต้นทุนลงได้ 77.0% และยังช่วยเพิ่มคุณภาพ (bench score) จาก 0.703 เป็น 0.810 เนื่องจากโมเดลไม่ต้องพยายามจัดการกับการตัดสินใจที่ซับซ้อนเกินไปในหนึ่ง token
จ่ายเฉพาะ token ที่สำคัญ
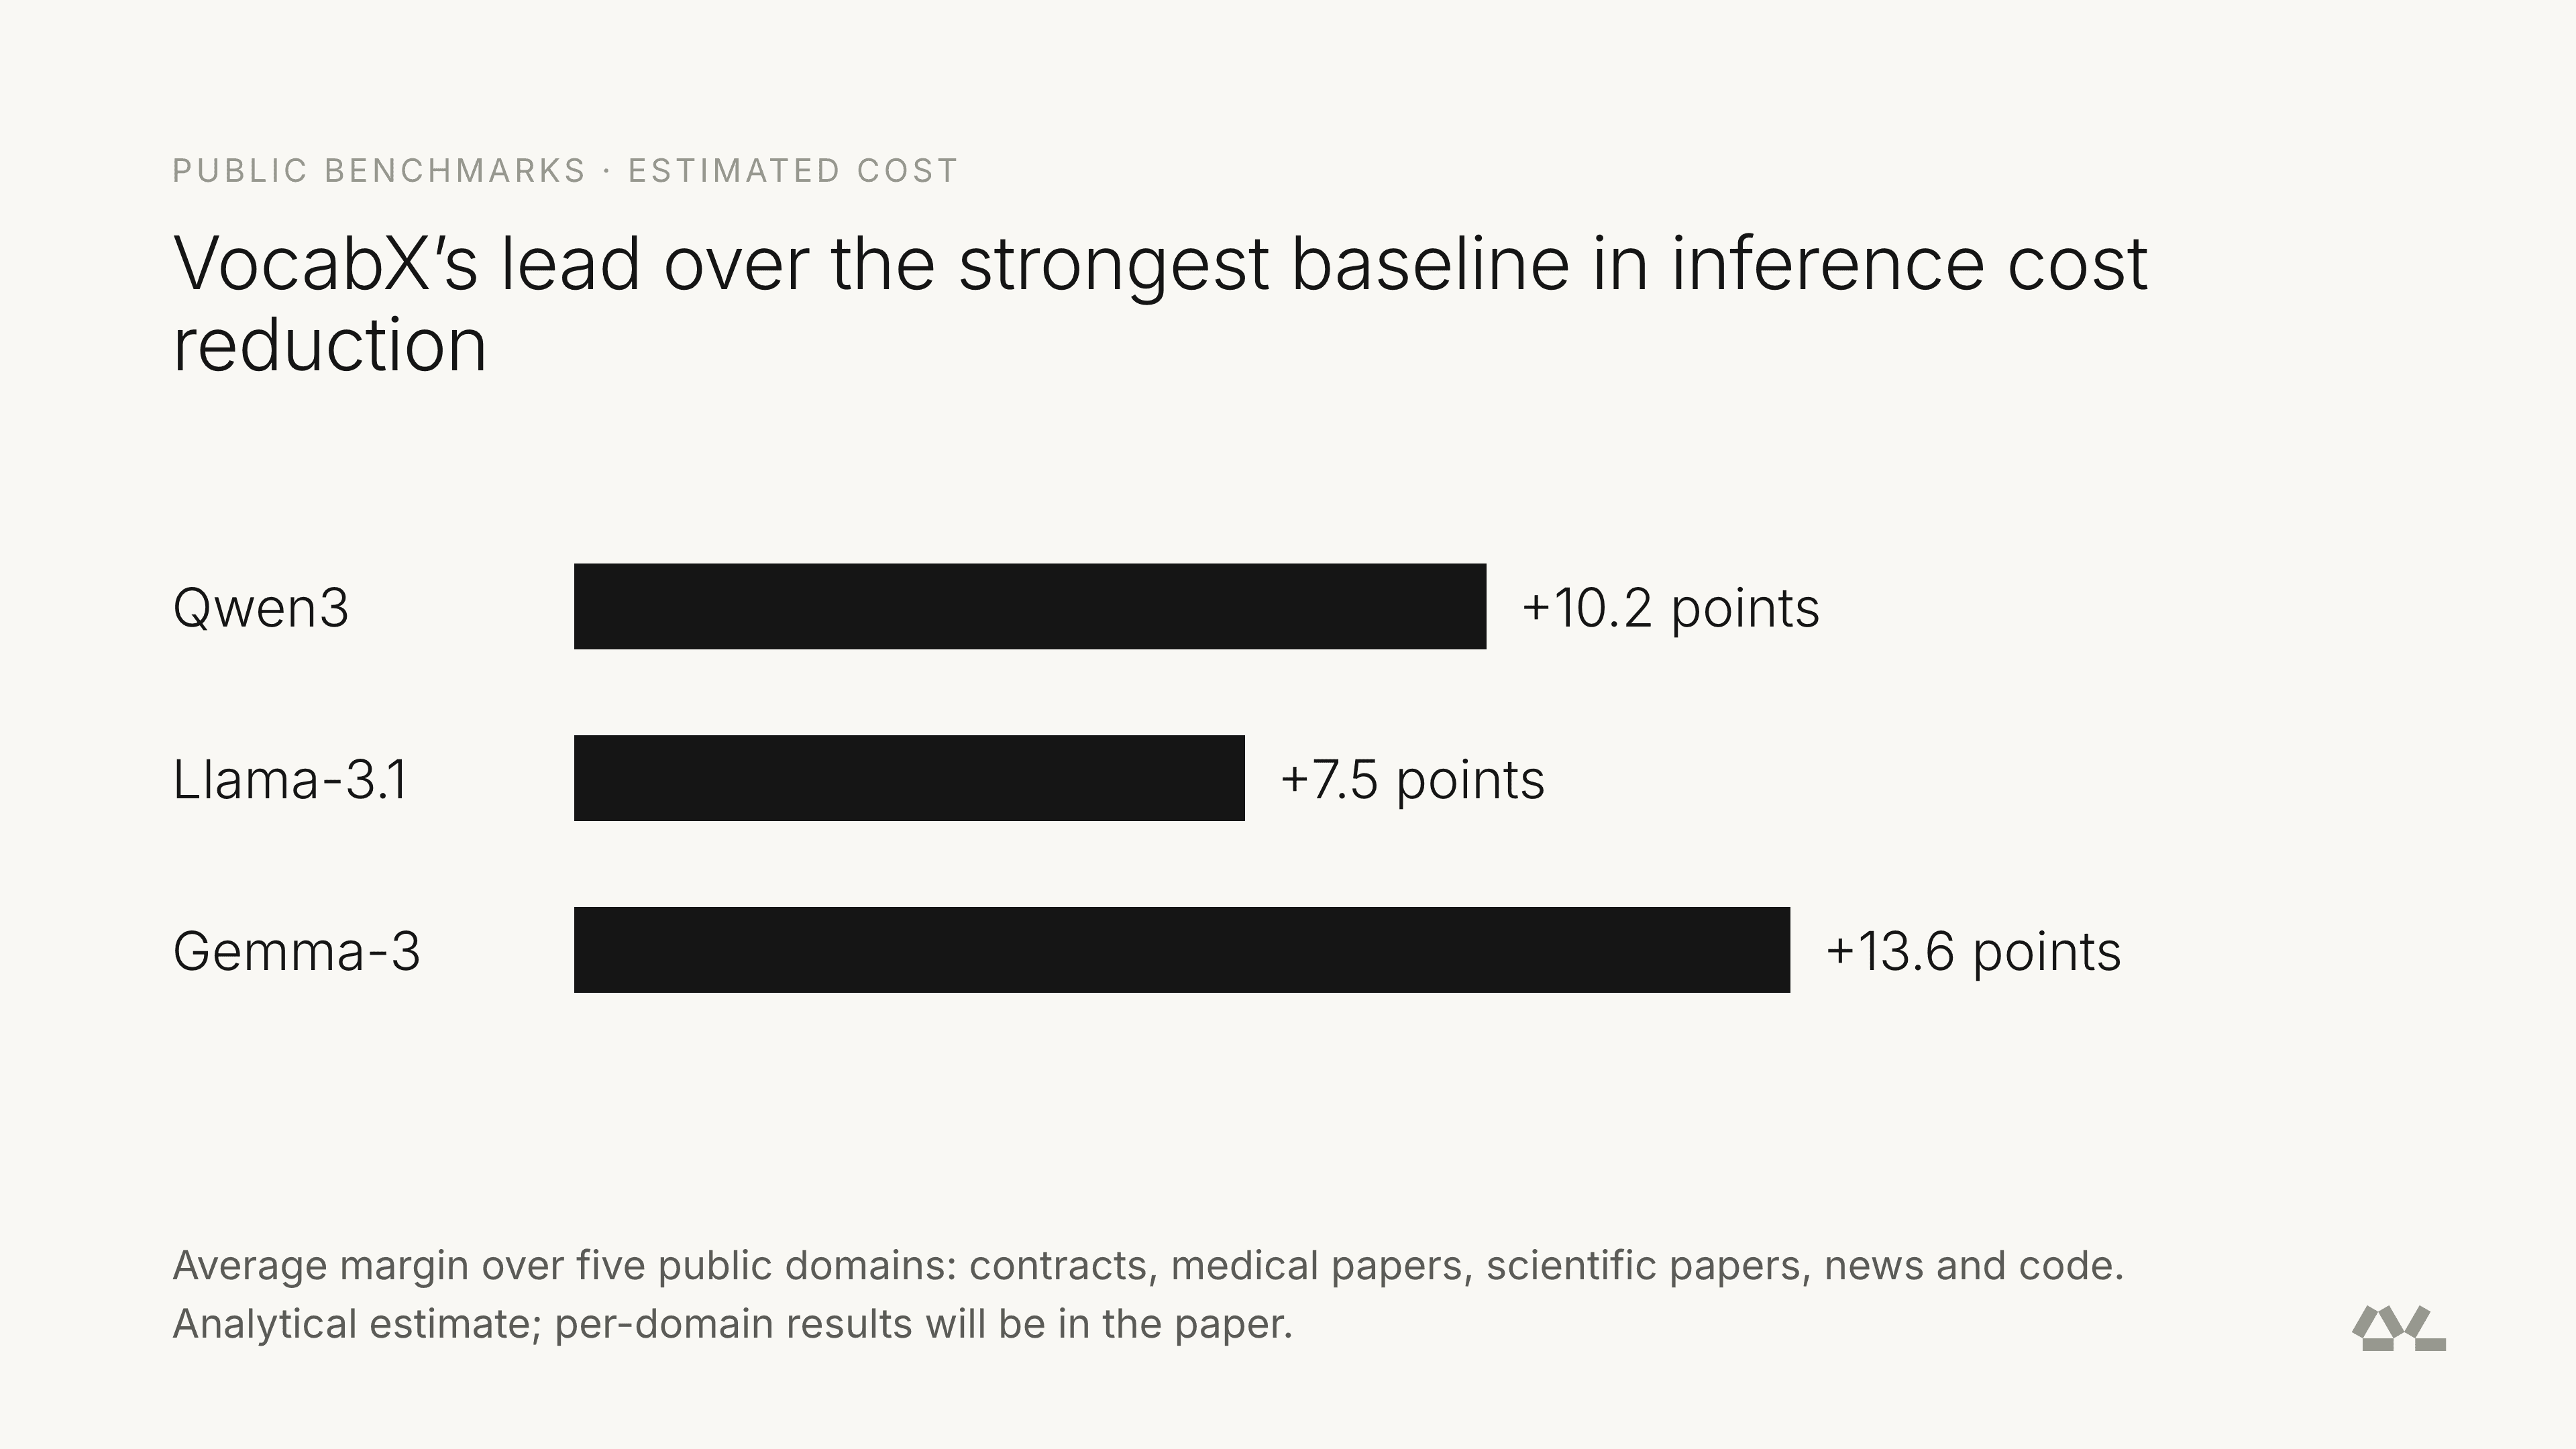
VocabX ไม่ได้เพิ่มความฉลาดให้โมเดลโดยตรง แต่ช่วยให้โมเดลหยุดจ่ายให้กับสิ่งที่ไม่จำเป็น ระบบนี้พิสูจน์แล้วว่ามีประสิทธิภาพเหนือกว่าวิธีเดิมในทุกการทดสอบกับโมเดลตระกูล Qwen3, Llama-3.1 และ Gemma-3 ในหลากหลายโดเมน
แหล่งที่มา
- Dharma-AI. "VocabX: Cost-Weighted Vocabulary Adaptation for Domain-Specific Language Models." In preparation (2026).
- Gee, Leonidas, et al. "Fast vocabulary transfer for language model compression." EMNLP Industry Track (2022).
- Gee, Leonidas, et al. "Multi-word tokenization for sequence compression." EMNLP Industry Track (2023).
- Smith, Jimmy T.H., et al. "In-Place Tokenizer Expansion for Pre-trained LLMs." arXiv:2607.15232 (2026).
อ่านเพิ่มเติม
- Same Cluster, 33 Points More Utilization: What Changed Was the Order
- GPU Management: Why Idle GPUs Are the New Grounded Aircraft
- Why Specialization Is Inevitable
- Specialization Beats Scale: A Strategic Variable Most AI Procurement Decisions Overlook
- Text Degeneration: A Production Failure Mode That Most Benchmarks Do Not Track
สำรวจ Dharma AI บน Hugging Face เพื่อทดลองเดโม ดาวน์โหลด open model ของเรา และดูว่าระบบ AI เฉพาะทางมีประสิทธิภาพเหนือกว่า model อเนกประสงค์ในการใช้งานจริงในองค์กรได้อย่างไร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร