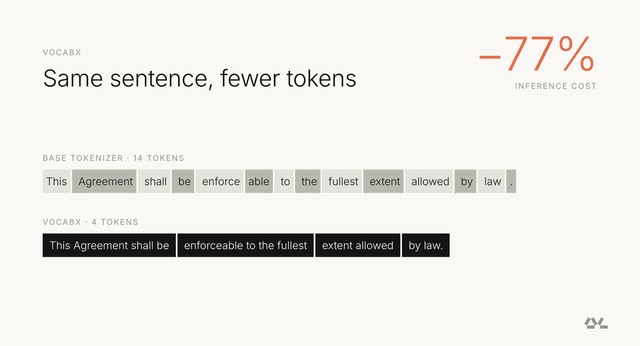
VocabX ลดต้นทุน Inference ในระบบจริงได้ 77% ด้วยการปรับแต่ง Vocabularytag: Dharma AI, Inference Cost, SLM, Tokenizer, VocabXOct 22, 2026 · By: SirilukPสรุปข่าว 1:15ผลวิจัย VocabX เผยวิธีลดต้นทุนการประมวลผลโมเดลภาษาขนาดเล็ก (SLM) ด้วยการปรับแต่ง Vocabulary ให้เฉพาะทางตามโดเมน ช่วยประหยัดค่าใช้จ่ายได้สูงสุด 77% โดยไม่ต้องเปลี่ยนโมเดลพื้นฐาน
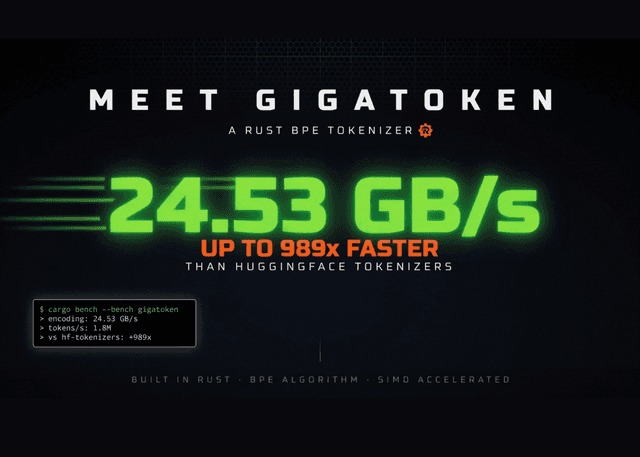
Gigatoken: Rust BPE Tokenizer สุดแรง ทำความเร็วสูงถึง 24.53 GB/s เร็วกว่าเดิมเกือบ 1,000 เท่าtag: Gigatoken, HuggingFace, NLP, OpenAI, Rust, TokenizerJul 24, 2026 · By: AttapolKGigatoken คือโอเพนซอร์สไลบรารี Rust สำหรับเข้ารหัสข้อความ (Tokenizer) ที่ทำความเร็วได้ถึง 24.53 GB/s บนเครื่อง AMD EPYC 9565 ทิ้งห่าง HuggingFace Tokenizers เดิมถึง 989 เท่า