
Jagged Intelligence: ทำไม AI ฉลาดระดับโอลิมปิกแต่ตกม้าตายเรื่องง่ายๆ
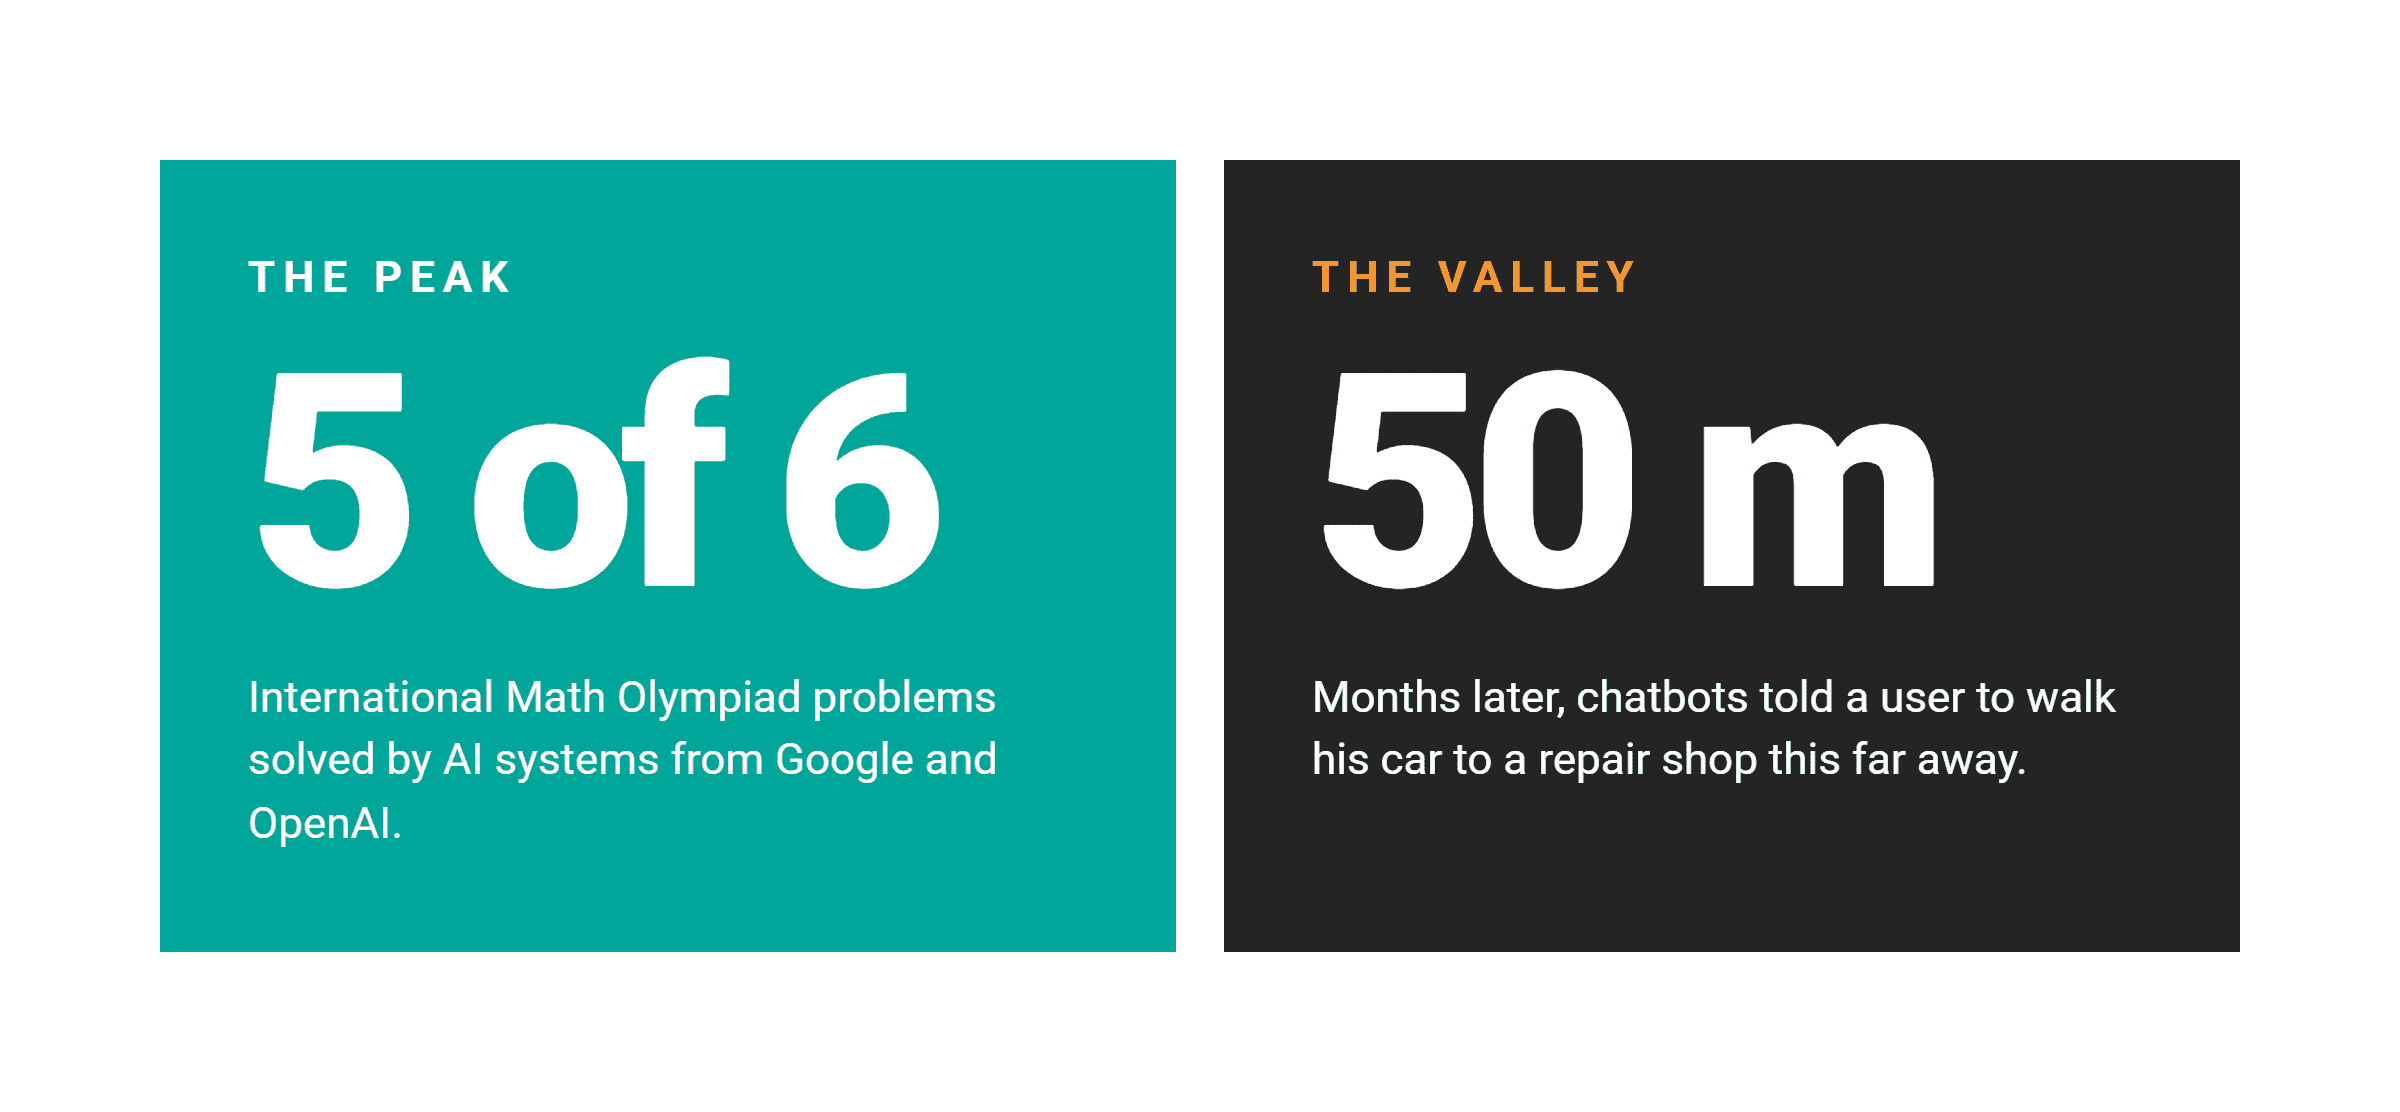
ระบบ AI จาก Google และ OpenAI สามารถ แก้โจทย์ การแข่งขัน คณิตศาสตร์โอลิมปิกระหว่างประเทศ (International Mathematical Olympiad) ได้ถึง 5 จาก 6 ข้อ แต่ในทางกลับกัน chatbot บอกกับผู้ใช้รายหนึ่ง ให้เข็นรถไปยังอู่ซ่อมที่อยู่ห่างออกไป 50 เมตร
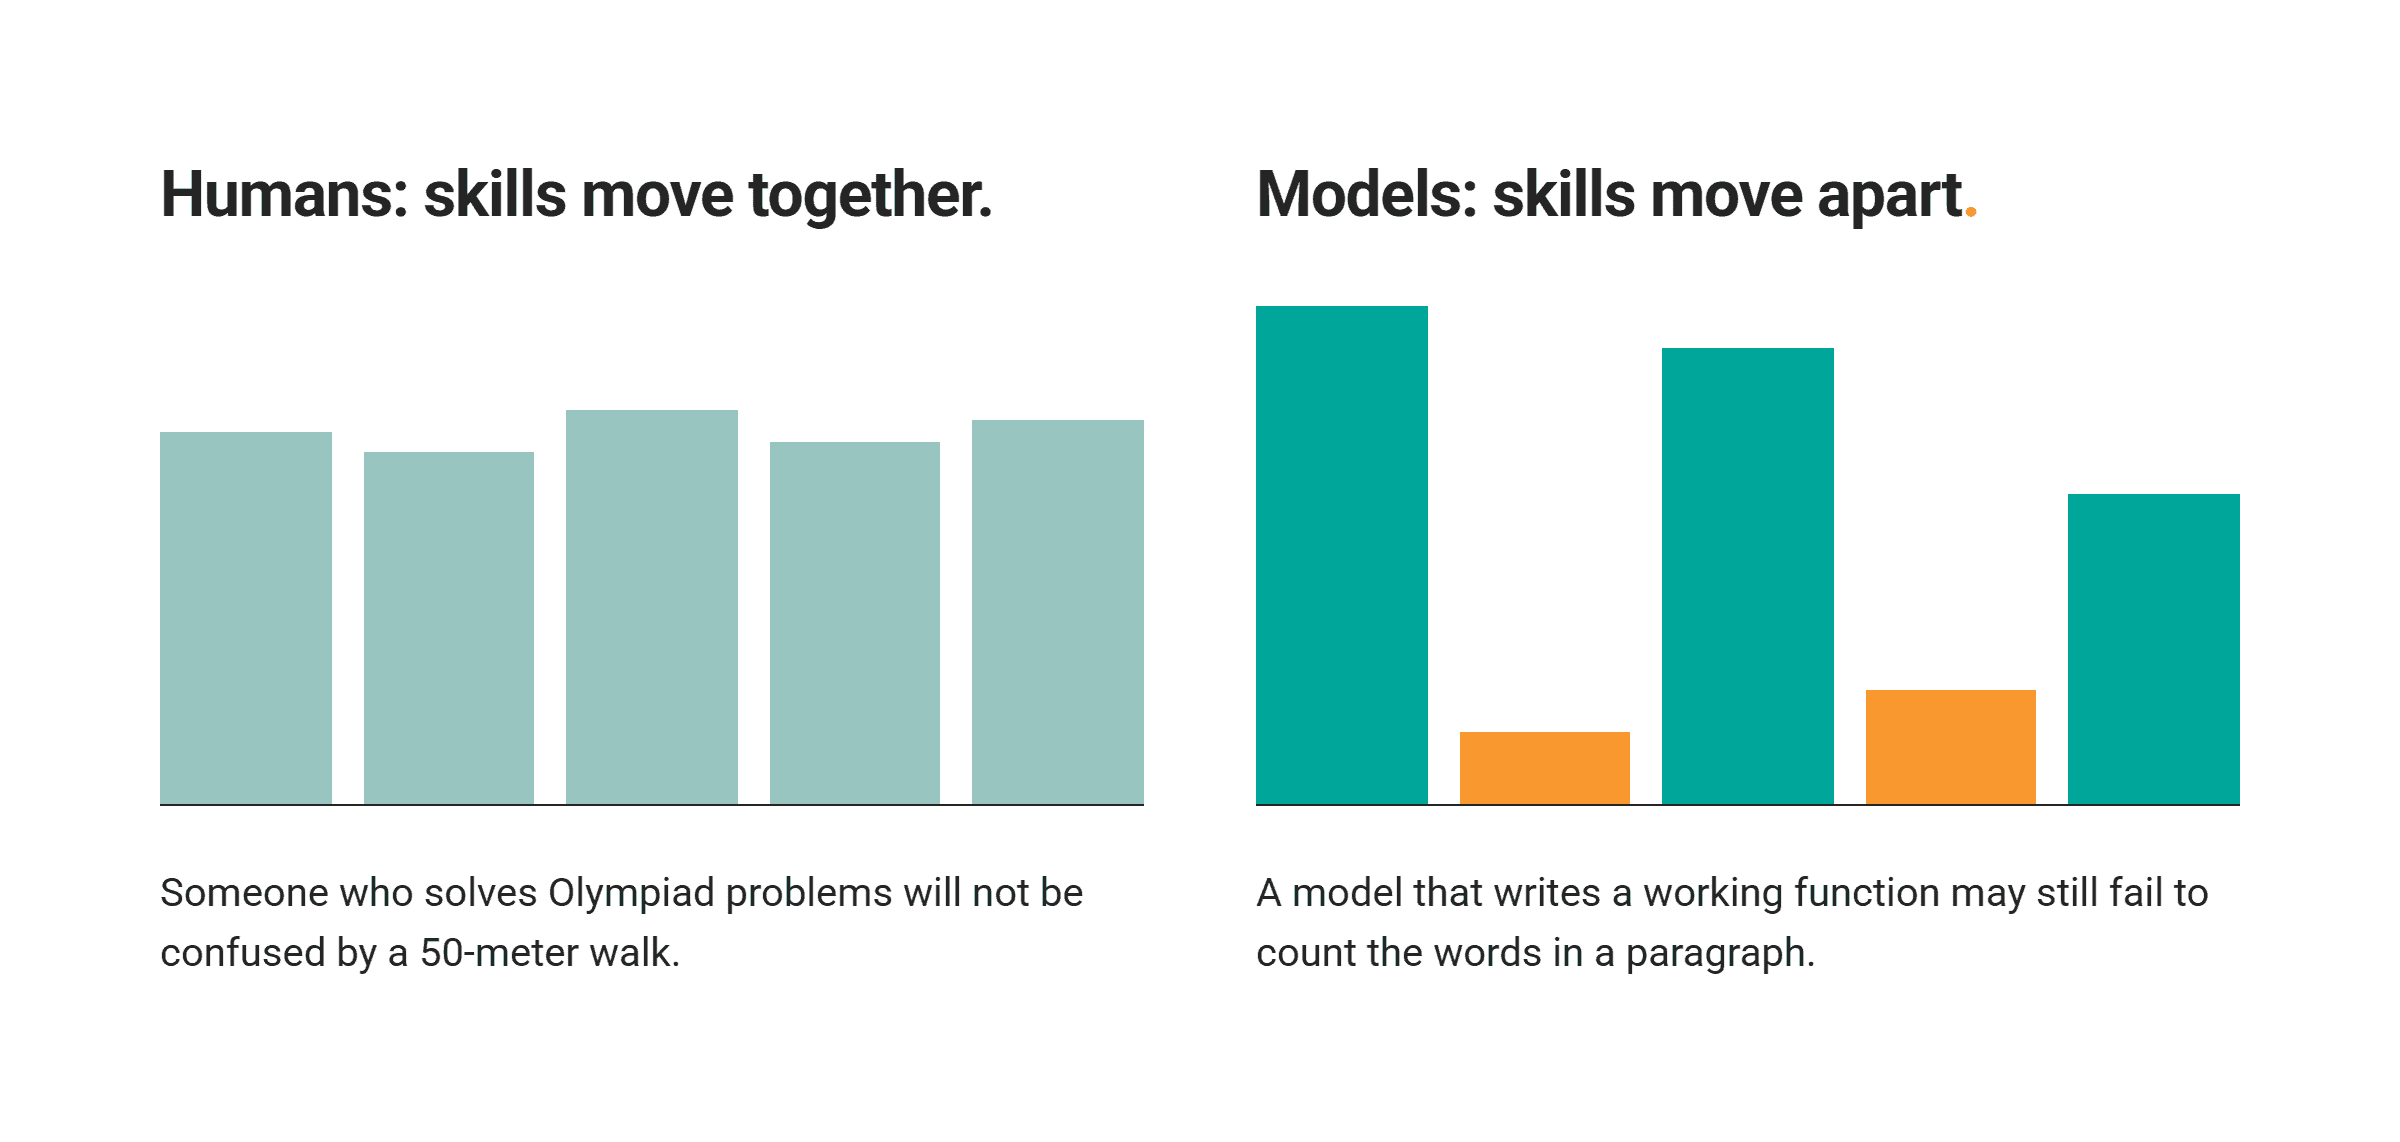
มนุษย์ที่แก้โจทย์ระดับโลกได้ย่อมไม่มีทางพลาดเรื่องระยะทางง่ายๆ เช่นนี้ ช่องว่างที่คาดเดาไม่ได้นี้เองคือนิยามที่นักวิจัยเรียกว่า jagged intelligence ซึ่งเป็นปัจจัยสำคัญสำหรับทุกคนที่ประเมินหรือสร้างฟีเจอร์ AI เพราะคะแนน Benchmark หรือการสาธิตที่น่าทึ่งเพียงครั้งเดียว แทบจะบอกอะไรไม่ได้เลยเกี่ยวกับประสิทธิภาพในงานถัดไป
ความหมายของ Jagged Intelligence
Andrej Karpathy ผู้ร่วมก่อตั้ง OpenAI และอดีตหัวหน้าฝ่าย AI ของ Tesla เป็นผู้บัญญัติคำนี้ในเดือนกรกฎาคม 2024 เพื่อสื่อถึงสภาวะที่โมเดลทำบางอย่างได้ดีเยี่ยมแต่ล้มเหลวอย่างหนักในบางเรื่อง โดยยากที่จะคาดการณ์ล่วงหน้า
ต่างจากมนุษย์ที่ความสามารถมักพัฒนาไปพร้อมกันเป็นระบบ โมเดล AI มักมีทักษะที่แยกส่วนกัน การที่มันเขียนโค้ดที่ซับซ้อนได้ ไม่ได้หมายความว่ามันจะนับจำนวนคำในย่อหน้าได้ถูกต้องเสมอไป การอนุมานทักษะหนึ่งจากอีกทักษะหนึ่งจึงมักใช้ไม่ได้ผลกับ AI นักวิจัยบางส่วนจึงมองว่านี่คือกลุ่มทักษะที่แยกจากกันโดยไม่มีปัญญาประดิษฐ์ทั่วไป (general intelligence) คอยเชื่อมโยง
4 ข้อสันนิษฐานที่เป็นคำอธิบายสำหรับรูปแบบนี้
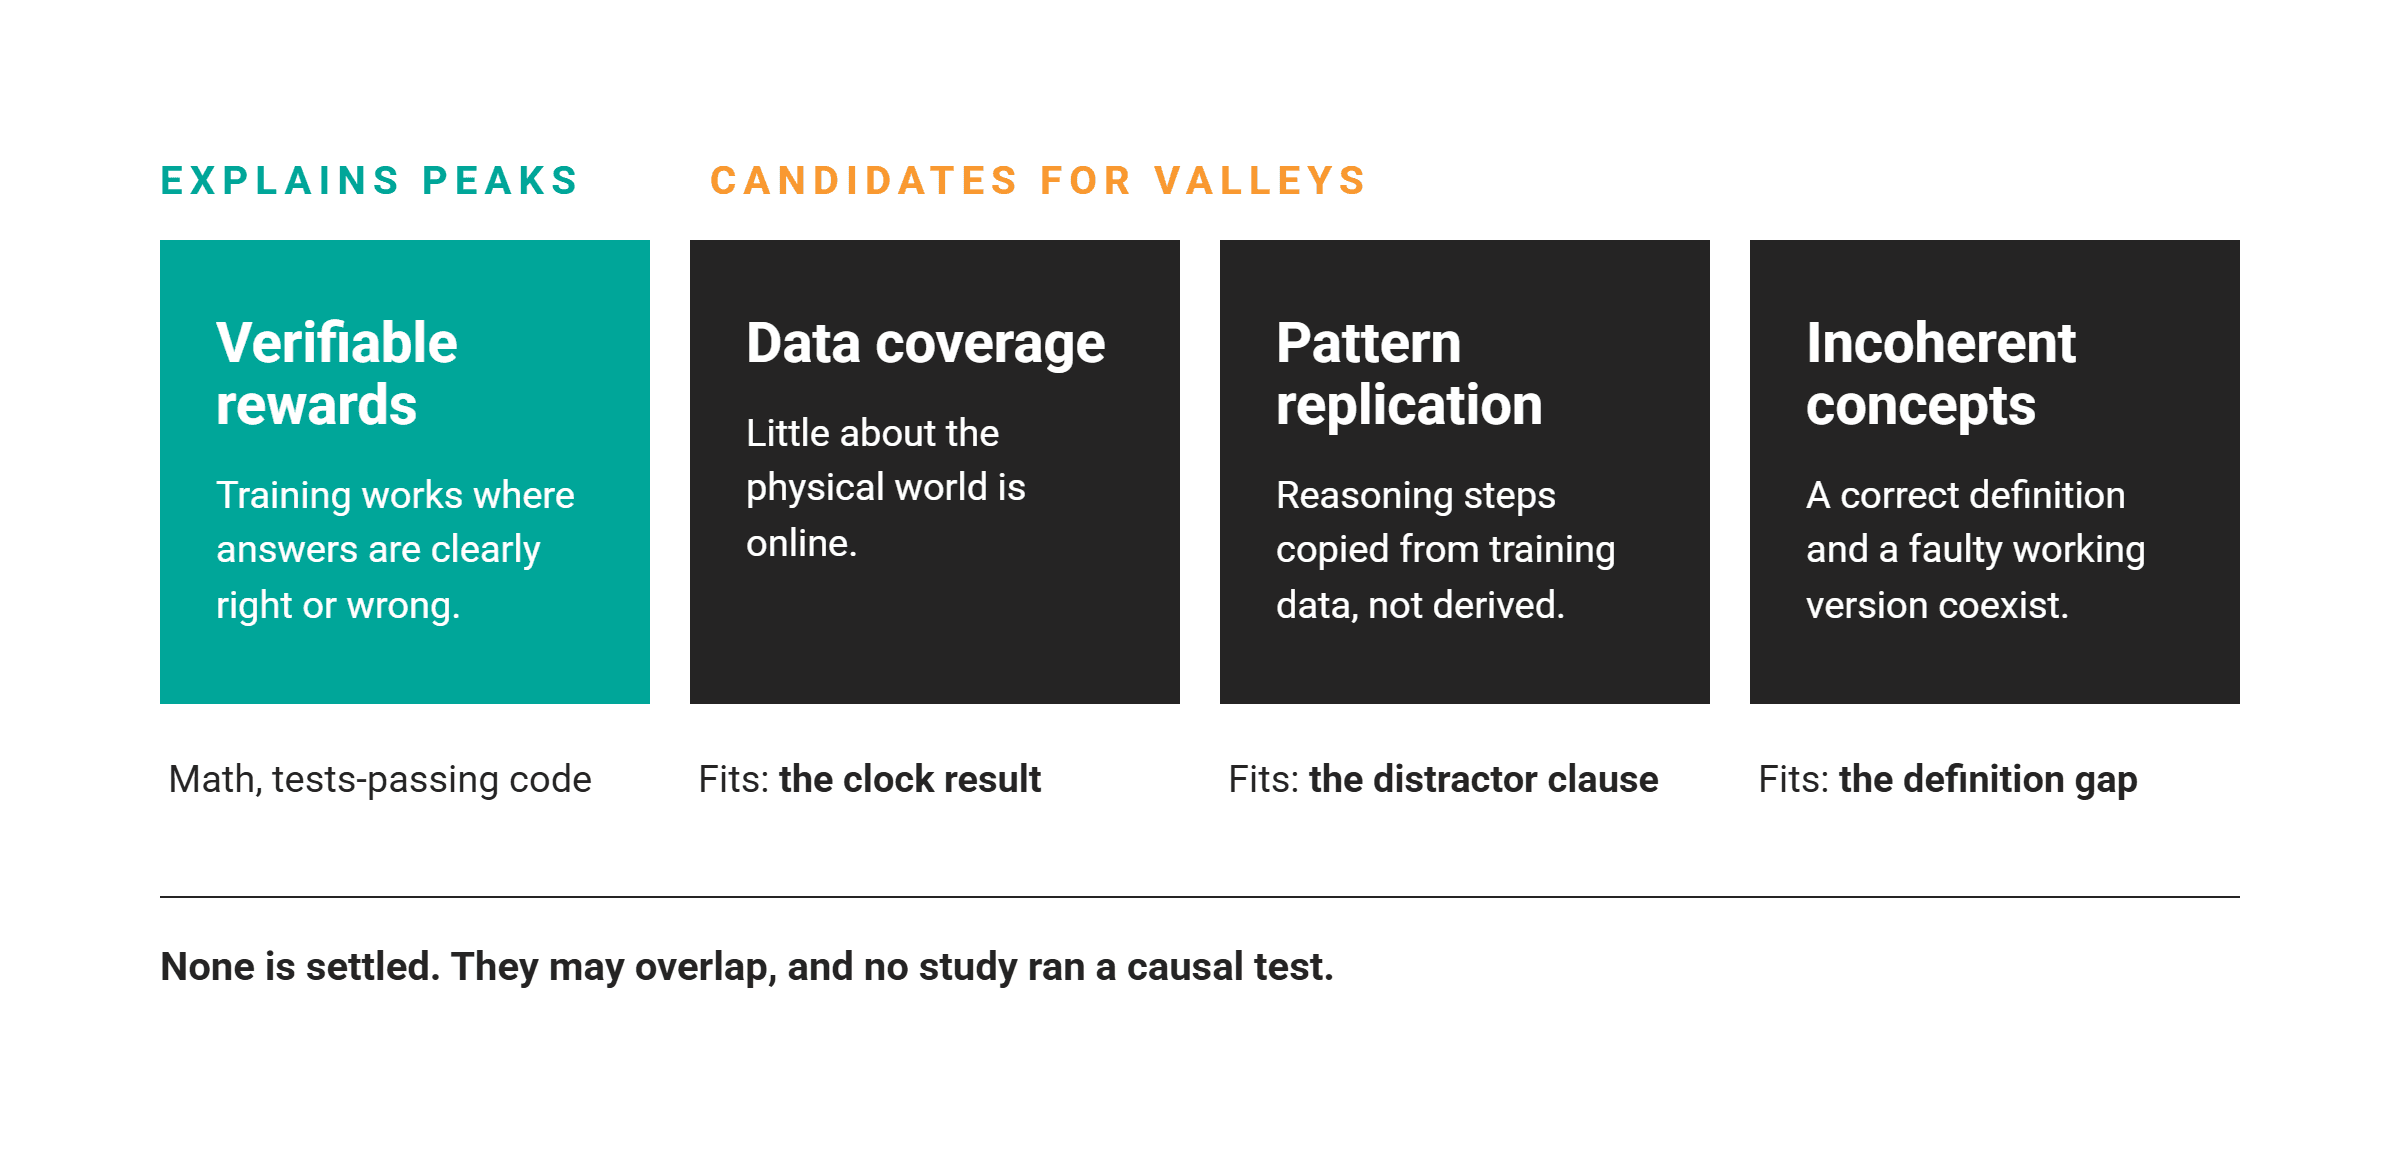
แม้จะยังไม่มีข้อสรุปที่แน่นอน แต่มีทฤษฎีสำคัญที่อาจอธิบายปรากฏการณ์นี้ได้ดังนี้:
Verifiable Rewards
Reinforcement learning with verifiable rewards (RLVR) คือขั้นตอนการฝึกที่สำคัญในปี 2025 ซึ่งได้ผลดีในงานที่มีคำตอบถูก-ผิดชัดเจน เช่น คณิตศาสตร์หรือการเขียนโค้ด Karpathy แย้งว่าโมเดลจะเก่งขึ้นอย่างรวดเร็วในโดเมนที่ตรวจสอบความถูกต้องได้ (verifiable) ในขณะที่งานเขียนเชิงสร้างสรรค์หรือปรัชญาที่ไม่มีเครื่องมือตรวจสอบอัตโนมัติจะพัฒนาก้าวหน้าได้ช้ากว่า
Data Coverage
ข้อมูลในอินเทอร์เน็ตมีเพียงเศษเสี้ยวของความรู้มนุษย์ และขาดข้อมูลเกี่ยวกับโลกทางกายภาพ โมเดลที่ฝึกด้วยข้อมูลดิจิทัลจึงมีปัญหาเรื่องการวางแผนและความคิดสร้างสรรค์ในงานที่ไม่เคยพบเห็นมาก่อน
Pattern Replication
งานวิจัย GSM-Symbolic paper จาก Apple เสนอว่า LLMs ใช้วิธีลอกเลียนขั้นตอนการให้เหตุผลจากข้อมูลฝึกฝนแทนการใช้ตรรกะจริง หากโจทย์ตรงตามแพทเทิร์นที่คุ้นเคยก็จะตอบได้ แต่หากเปลี่ยนรายละเอียดเพียงเล็กน้อย ระบบการให้เหตุผลก็จะพังทลายทันที
Incoherent Concepts
งานวิจัย "Potemkin understanding" พบว่าโมเดลมีการนำเสนอแนวคิดภายในที่ไม่สอดคล้องกัน โดยสามารถจดจำคำนิยามที่ถูกต้องไปพร้อมๆ กับการทำงานที่ผิดพลาดของแนวคิดเดียวกันได้โดยไม่มีกลไกบังคับให้สองสิ่งนี้สอดคล้องกัน
ทฤษฎีเหล่านี้อธิบายว่าทำไม AI ถึงเก่งเฉพาะทางแต่มีจุดอ่อนที่คาดไม่ถึง เช่น การอ่านนาฬิกาเข็มที่ล้มเหลวอาจมาจากช่องว่างของข้อมูลฝึกฝน หรือการที่โมเดลนิยามแนวคิดได้แต่ใช้จริงไม่ได้ ซึ่งแสดงถึงความไม่เข้าใจในเชิงลึก
6 ความล้มเหลวที่บันทึกโดยชุมชนวิทยาศาสตร์
คำว่า "jagged" ครอบคลุมถึงความไม่สม่ำเสมอในหลายมิติ ทั้งในระดับงาน ความยาก และสภาพแวดล้อมจริง
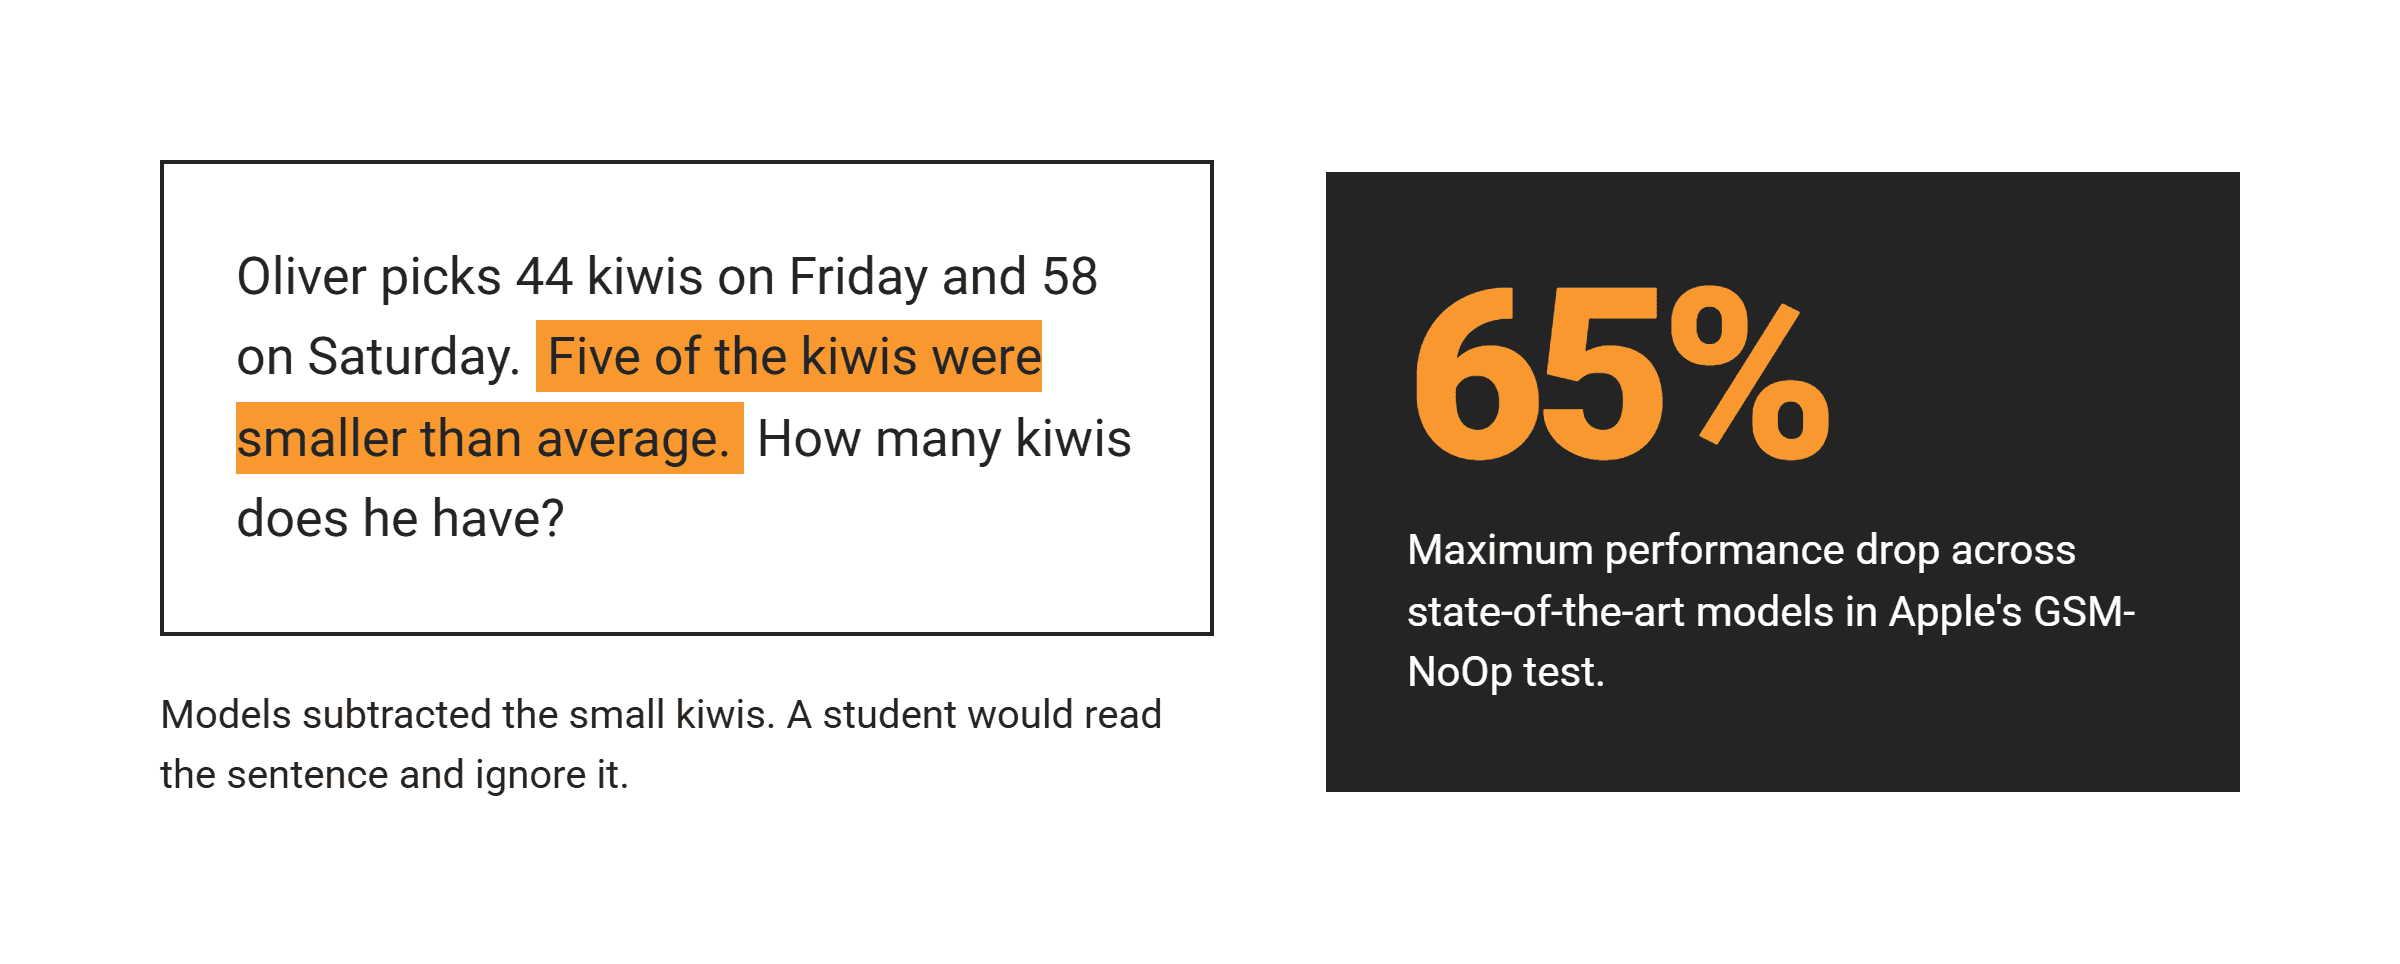
ประโยคหลอกที่ทำลายโจทย์คณิตศาสตร์ระดับประถม
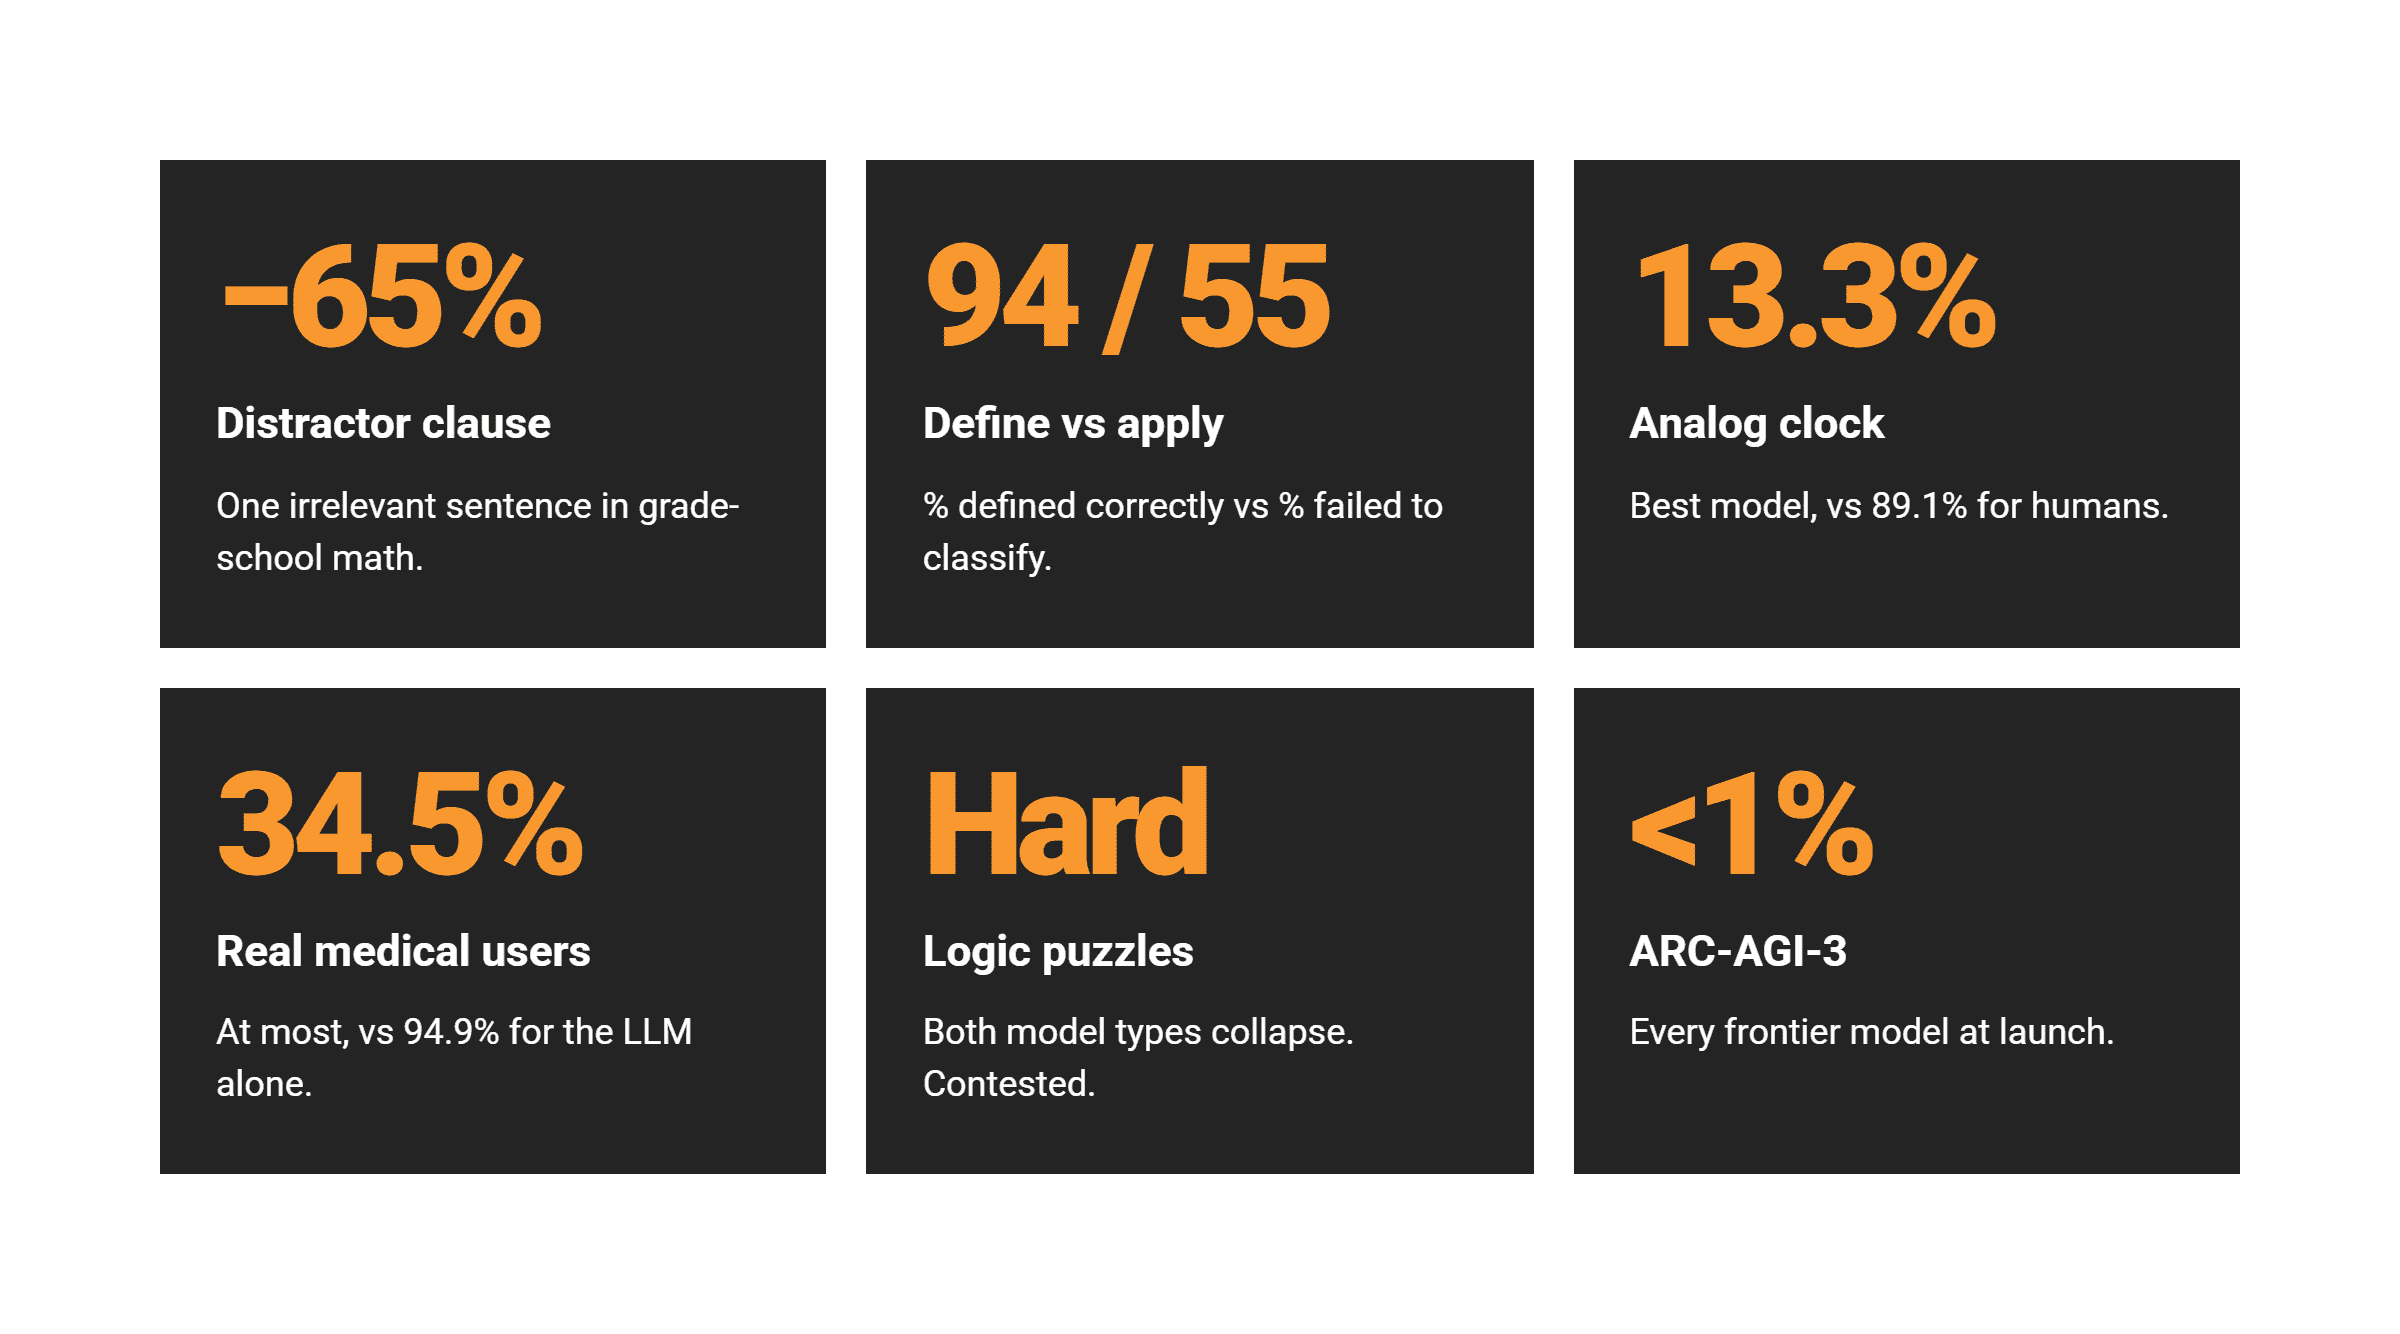
ในการทดสอบ GSM-NoOp ของ Apple นักวิจัยเพิ่มประโยคที่ไม่เกี่ยวข้องลงในโจทย์ เช่น "กีวี่ห้าลูกมีขนาดเล็กกว่าค่าเฉลี่ย" ผลปรากฏว่าประสิทธิภาพของโมเดลระดับท็อปลดลงถึง 65% เพราะพยายามนำตัวเลขนั้นมาคำนวณ ในขณะที่มนุษย์จะเพิกเฉยไปได้
การนิยามแนวคิดกับการนำไปใช้จริง
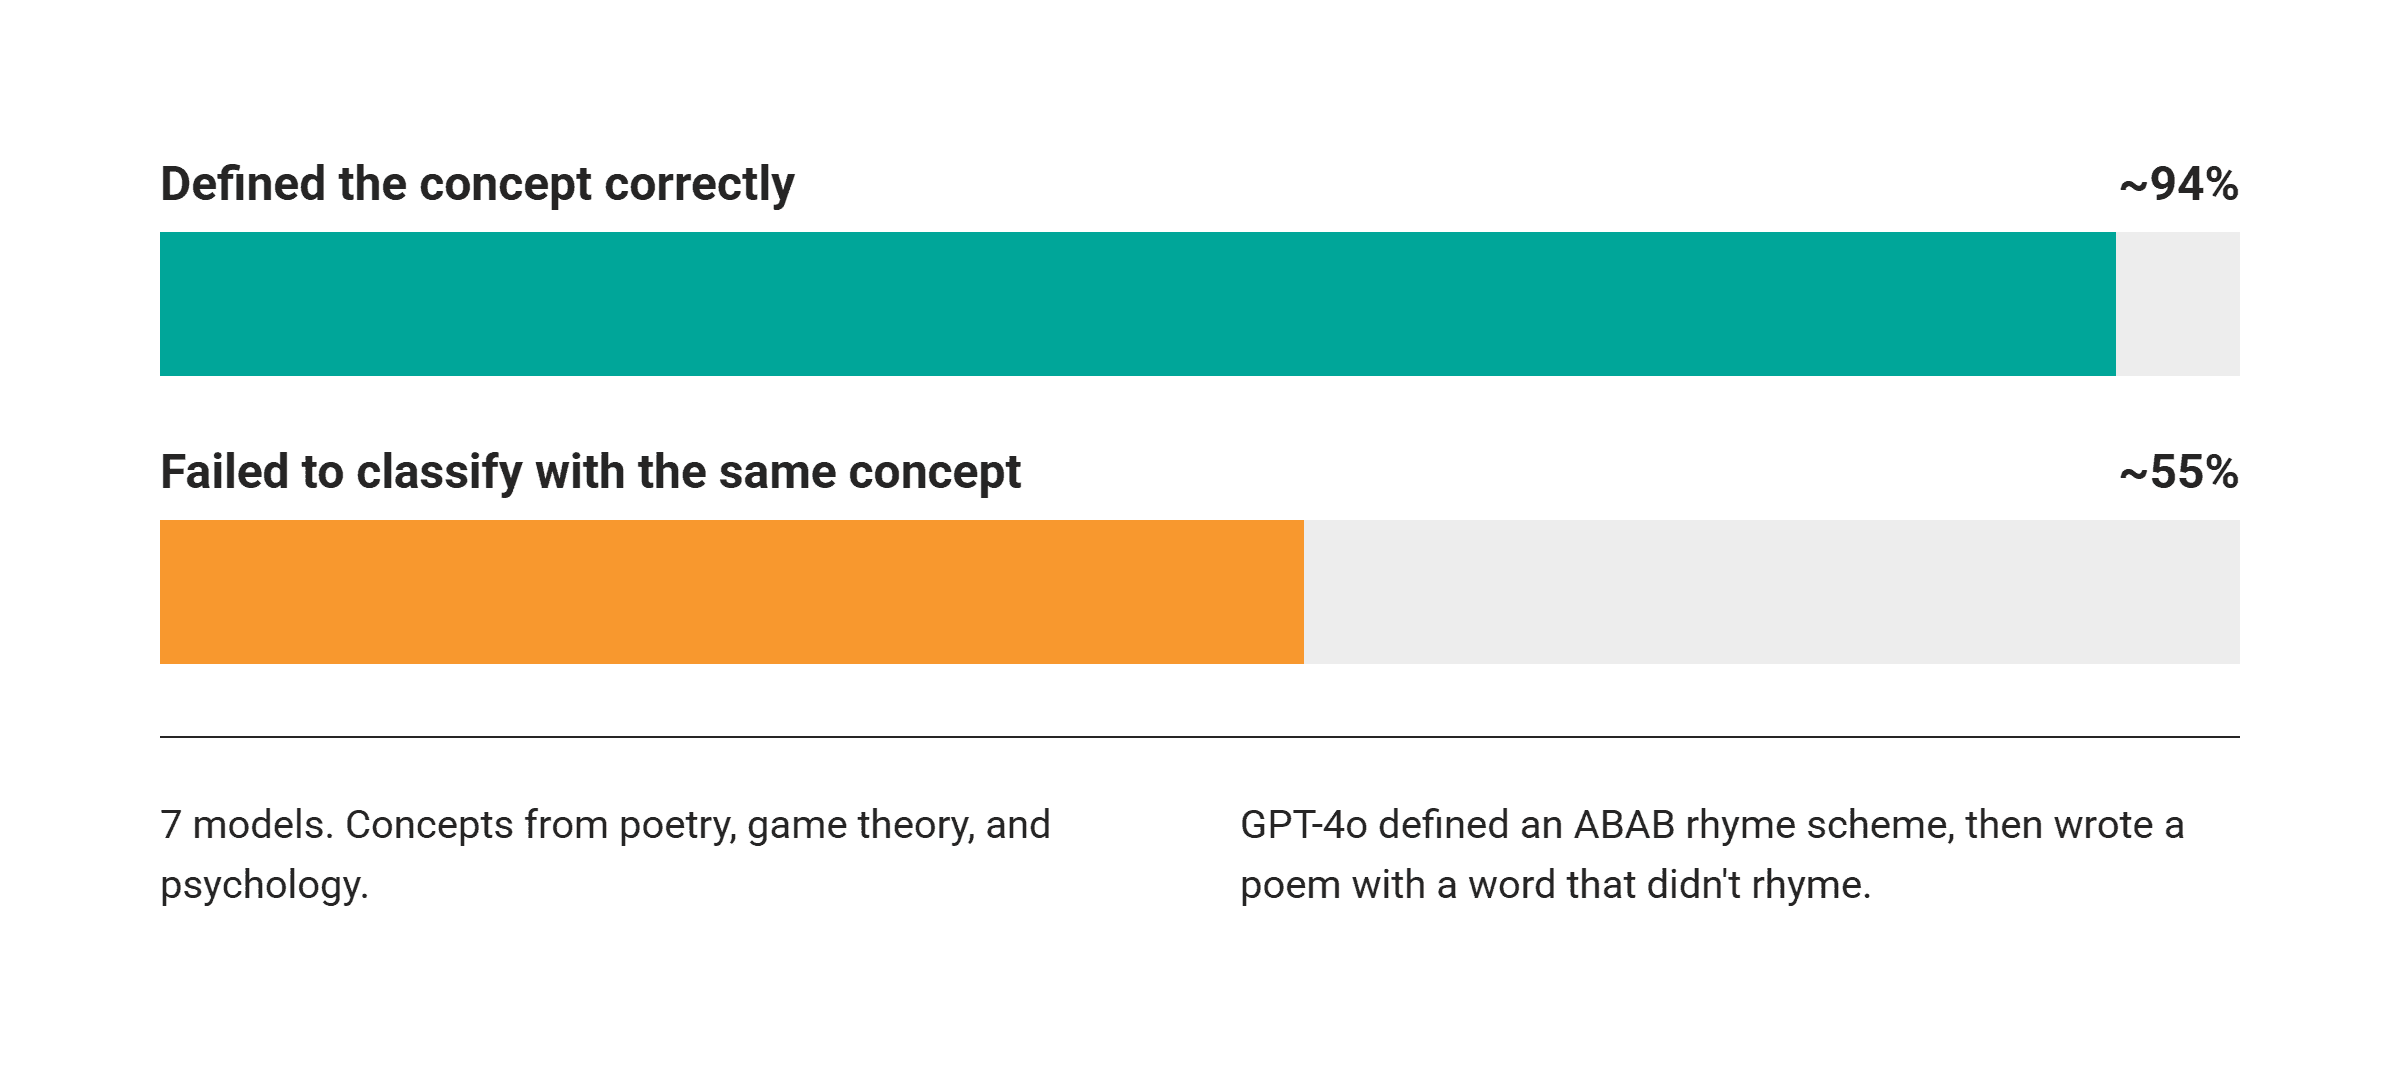
GPT-4o สามารถนิยามการสัมผัสบทกวีแบบ ABAB ได้ถูกต้อง แต่กลับแต่งบทกวีที่ไม่สัมผัสกัน งานวิจัยพบว่าโมเดลนิยามแนวคิดถูกต้องถึง 94% แต่ล้มเหลวในงานจัดประเภท (classification) ของแนวคิดเดียวกันสูงถึง 55% ชี้ให้เห็นว่าการท่องจำนิยามไม่ได้แปลว่ามีความเข้าใจจริง
การอ่านนาฬิกาเข็ม
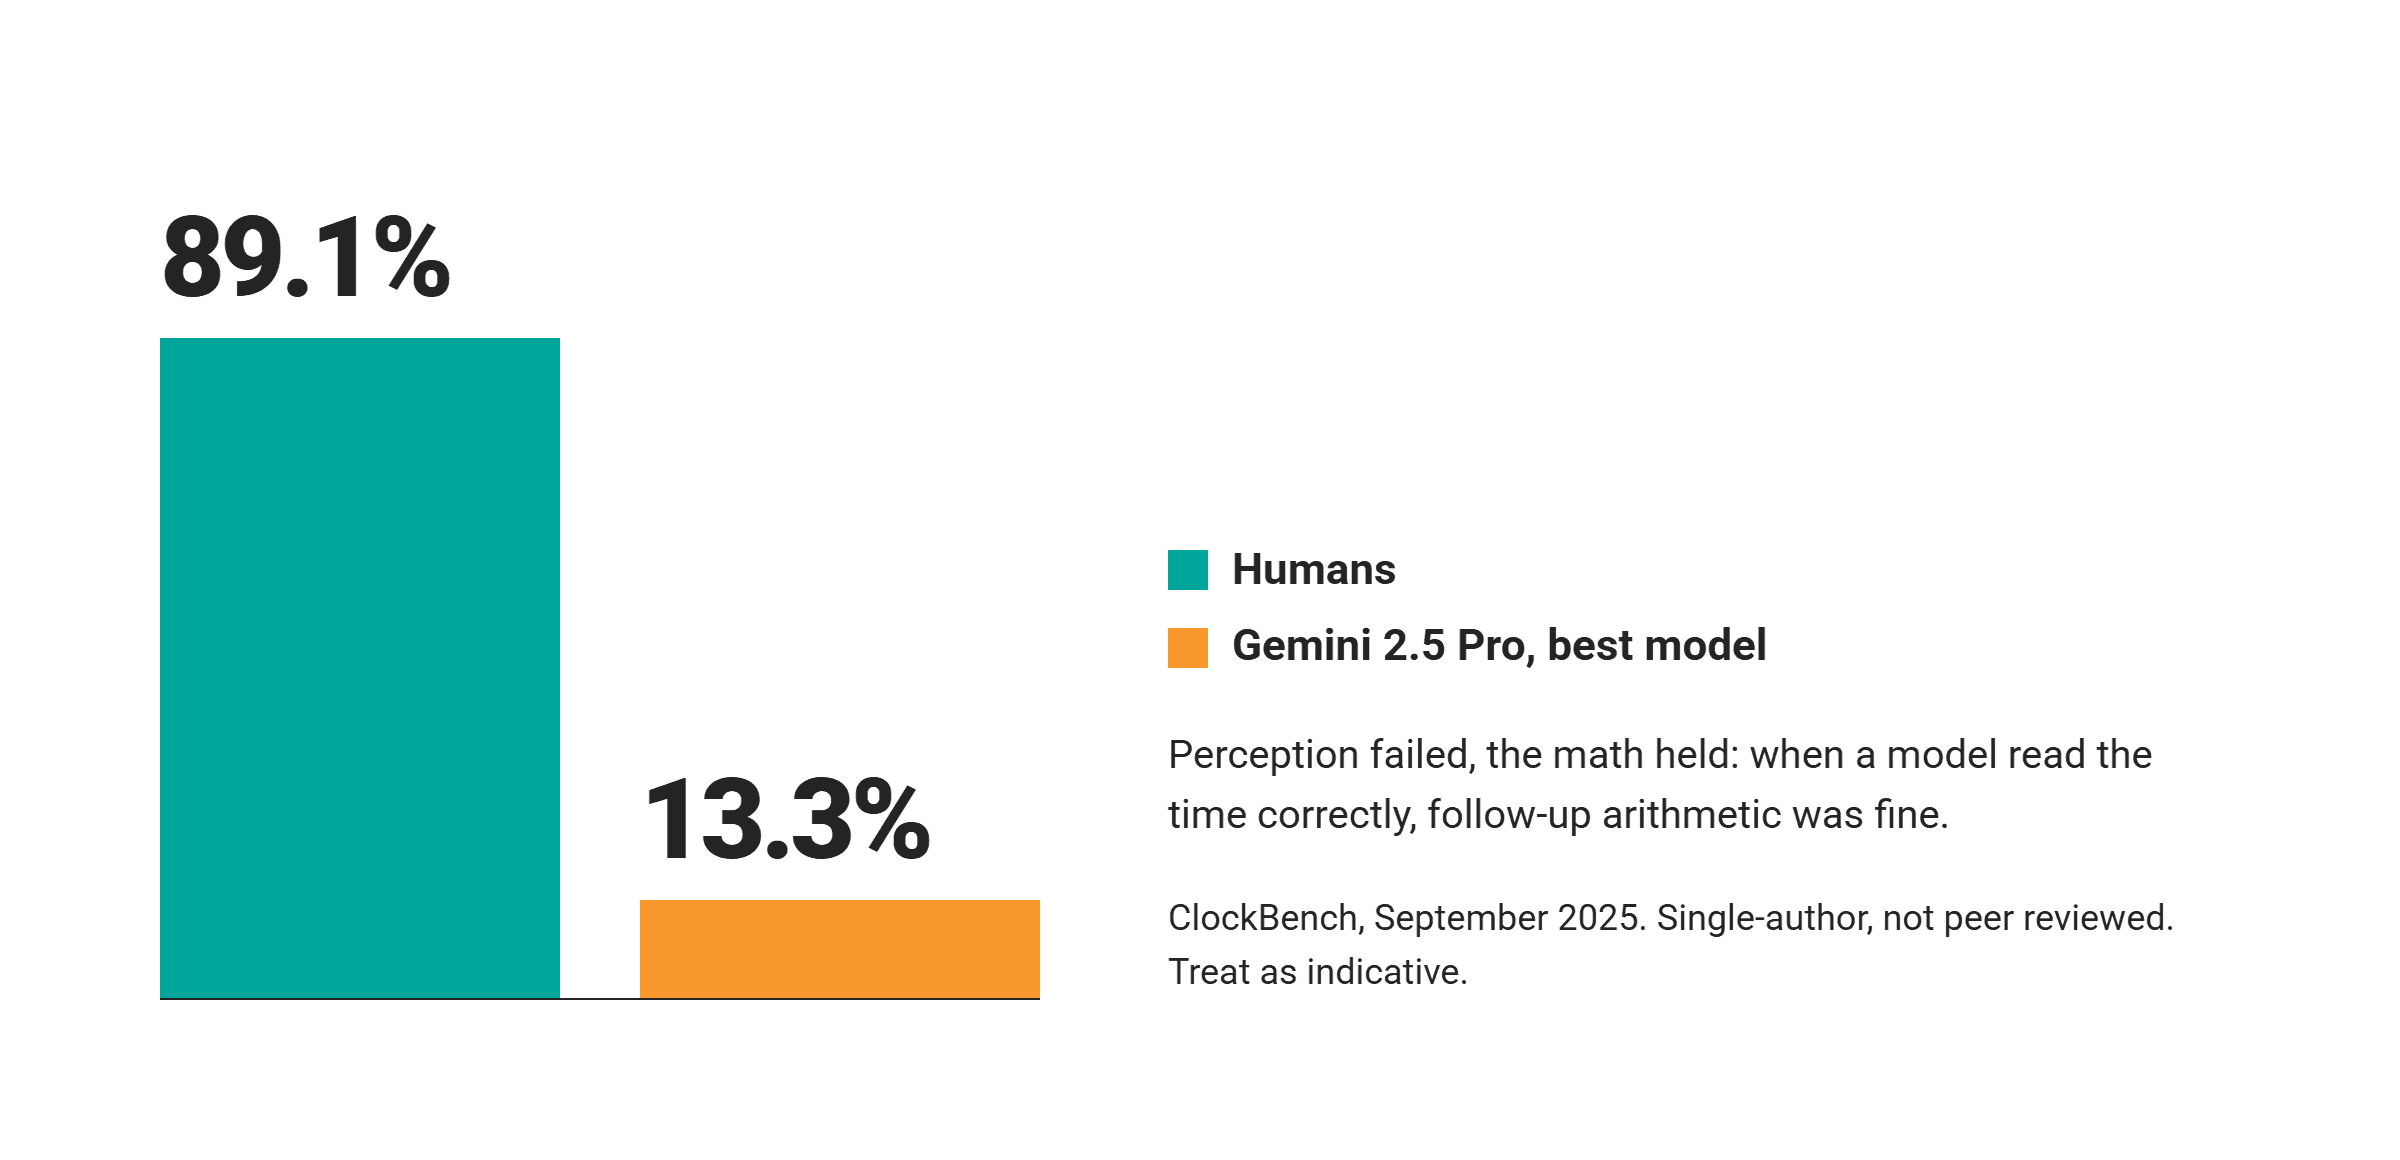
ผลจาก ClockBench (กันยายน 2025) ระบุว่ามนุษย์อ่านนาฬิกาแม่นยำ 89.1% ขณะที่ Gemini 2.5 Pro ทำได้เพียง 13.3% ความล้มเหลวนี้อยู่ที่การรับรู้ (perception) ตำแหน่งเข็มและมุม ไม่ใช่เรื่องการคำนวณ
คะแนนทางการแพทย์ที่สูง แต่ผลลัพธ์ย่ำแย่สำหรับผู้ใช้จริง
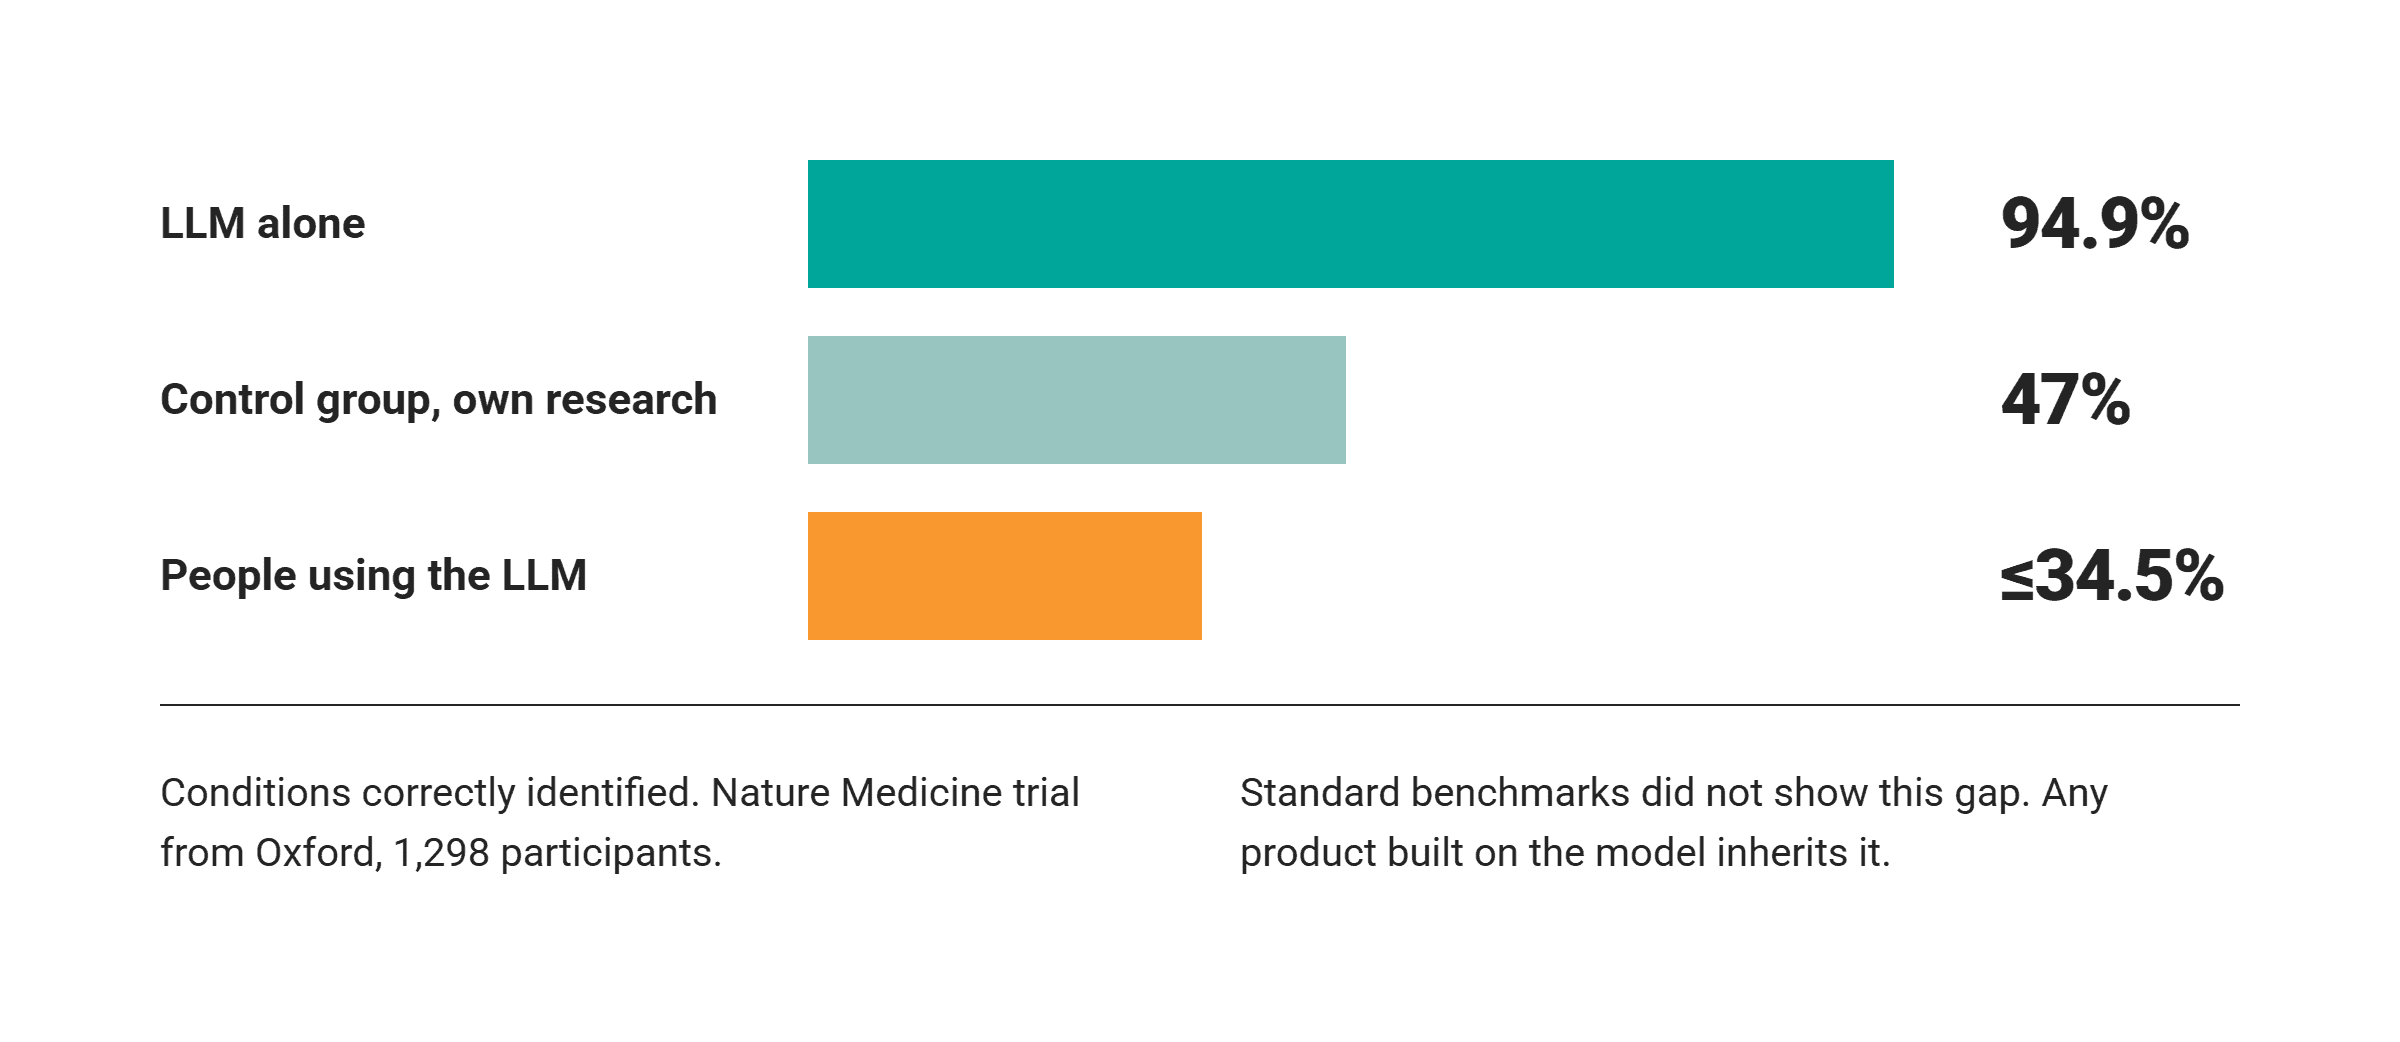
งานวิจัยใน Nature Medicine จาก Oxford พบว่า LLM วินิจฉัยโรคถูกต้อง 94.9% แต่เมื่อให้คนใช้ LLM ช่วยวินิจฉัย ความแม่นยำกลับลดเหลือ 34.5% ซึ่งต่ำกว่ากลุ่มที่ค้นหาข้อมูลเอง สะท้อนว่าคะแนนเดี่ยวของโมเดลกับคุณค่าในการใช้งานจริงอาจแตกต่างกันอย่างสิ้นเชิง
ปริศนาตรรกะและผลลัพธ์ที่ยังเป็นข้อถกเถียง
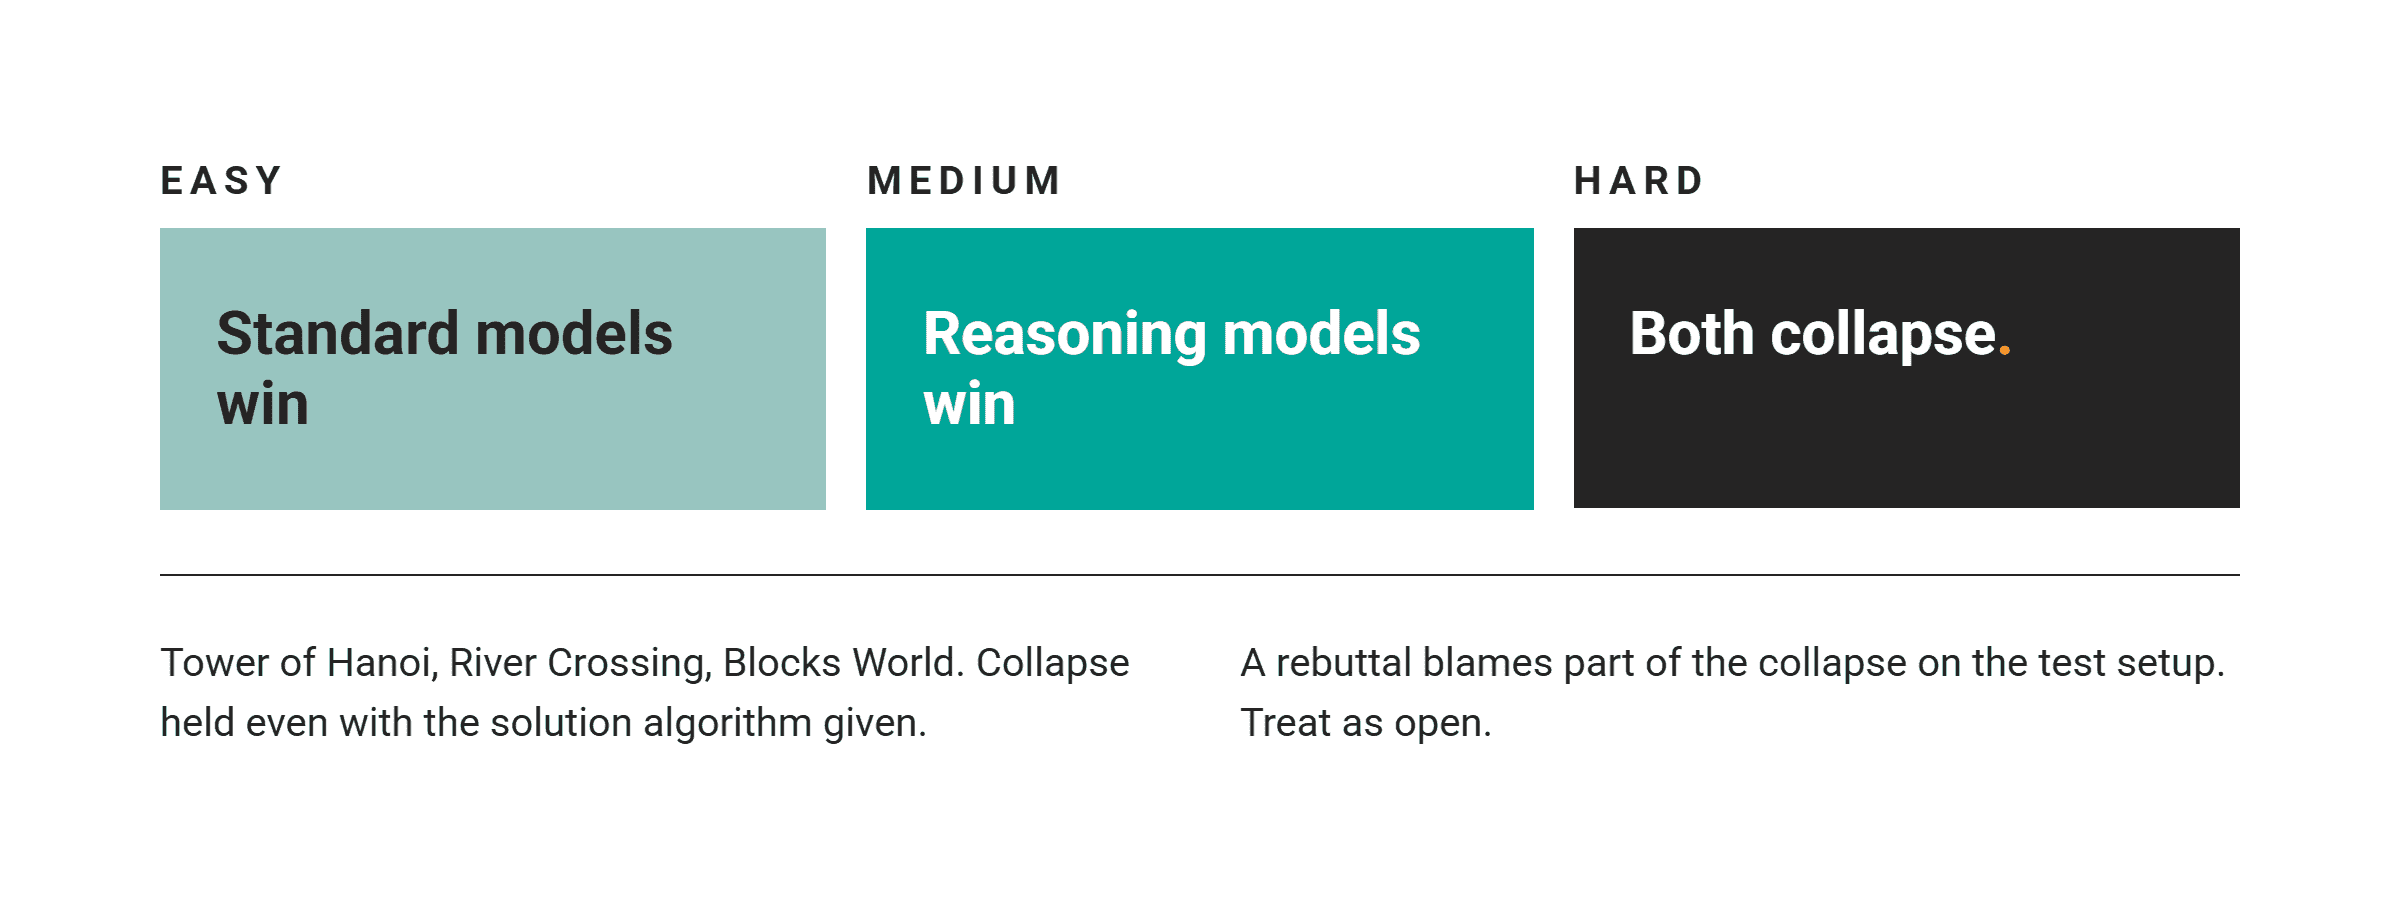
การศึกษา Illusion of Thinking ของ Apple พบว่าโมเดลแต่ละประเภทเก่งในระดับความยากที่ต่างกัน และทั้งโมเดลทั่วไปและโมเดลสายเหตุผลต่างพังทลายเมื่อเจอโจทย์ระดับยาก แม้จะมีอัลกอริทึมช่วยก็ตาม
Benchmark เวอร์ชันใหม่ทำคะแนนร่วงลงต่ำกว่า 1%
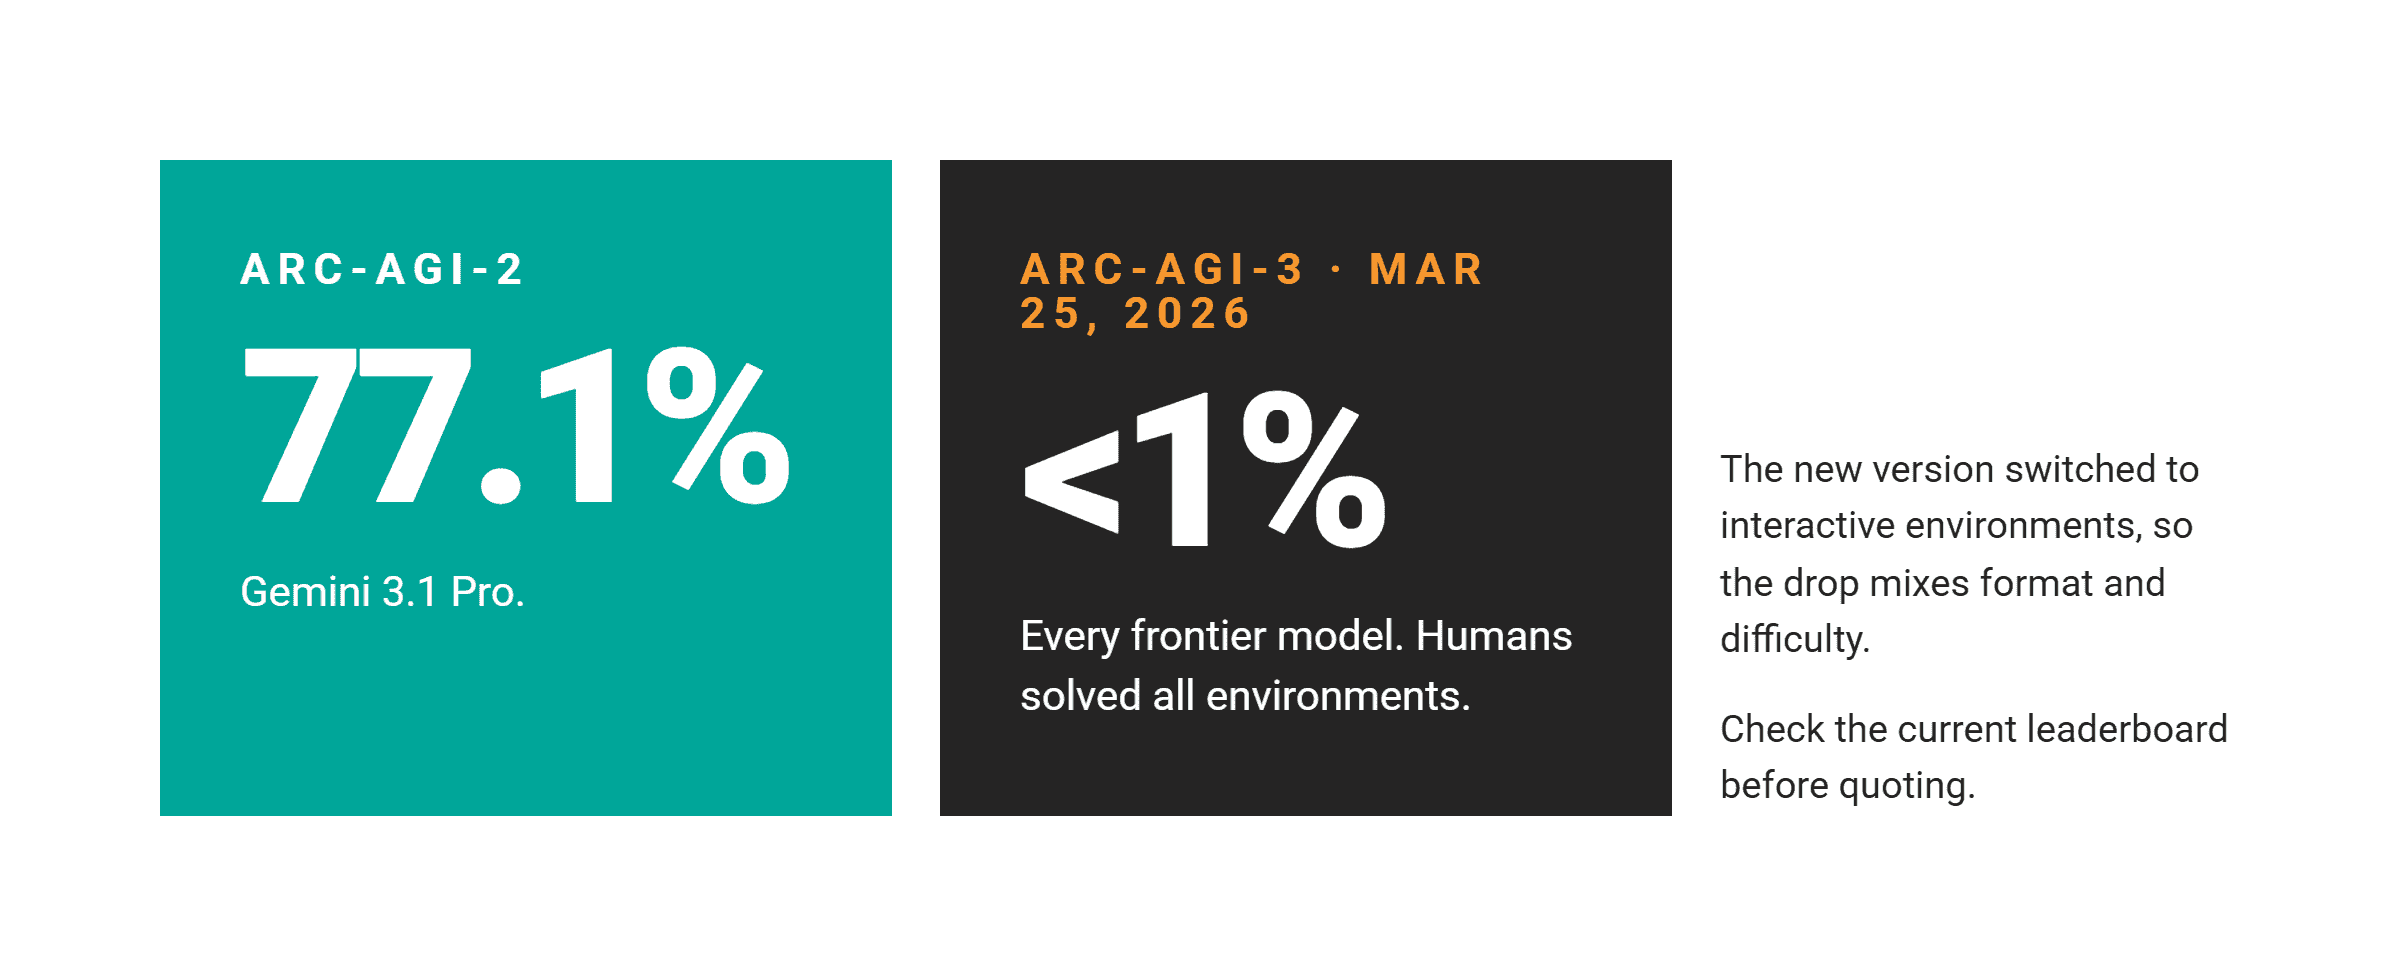
ARC-AGI-3 ที่เน้นการปรับตัวในสถานการณ์ใหม่ ทำเอาโมเดลชั้นนำทำคะแนนได้ไม่ถึง 1% ทั้งที่เวอร์ชันก่อนหน้าเคยทำได้สูงถึง 77.1% แสดงให้เห็นว่าคะแนนที่สูงในเวอร์ชันหนึ่งไม่ได้การันตีความสามารถในสถานการณ์ที่เปลี่ยนไป
ทำไมคะแนน Benchmark หนึ่งๆ ถึงทำให้เข้าใจผิด
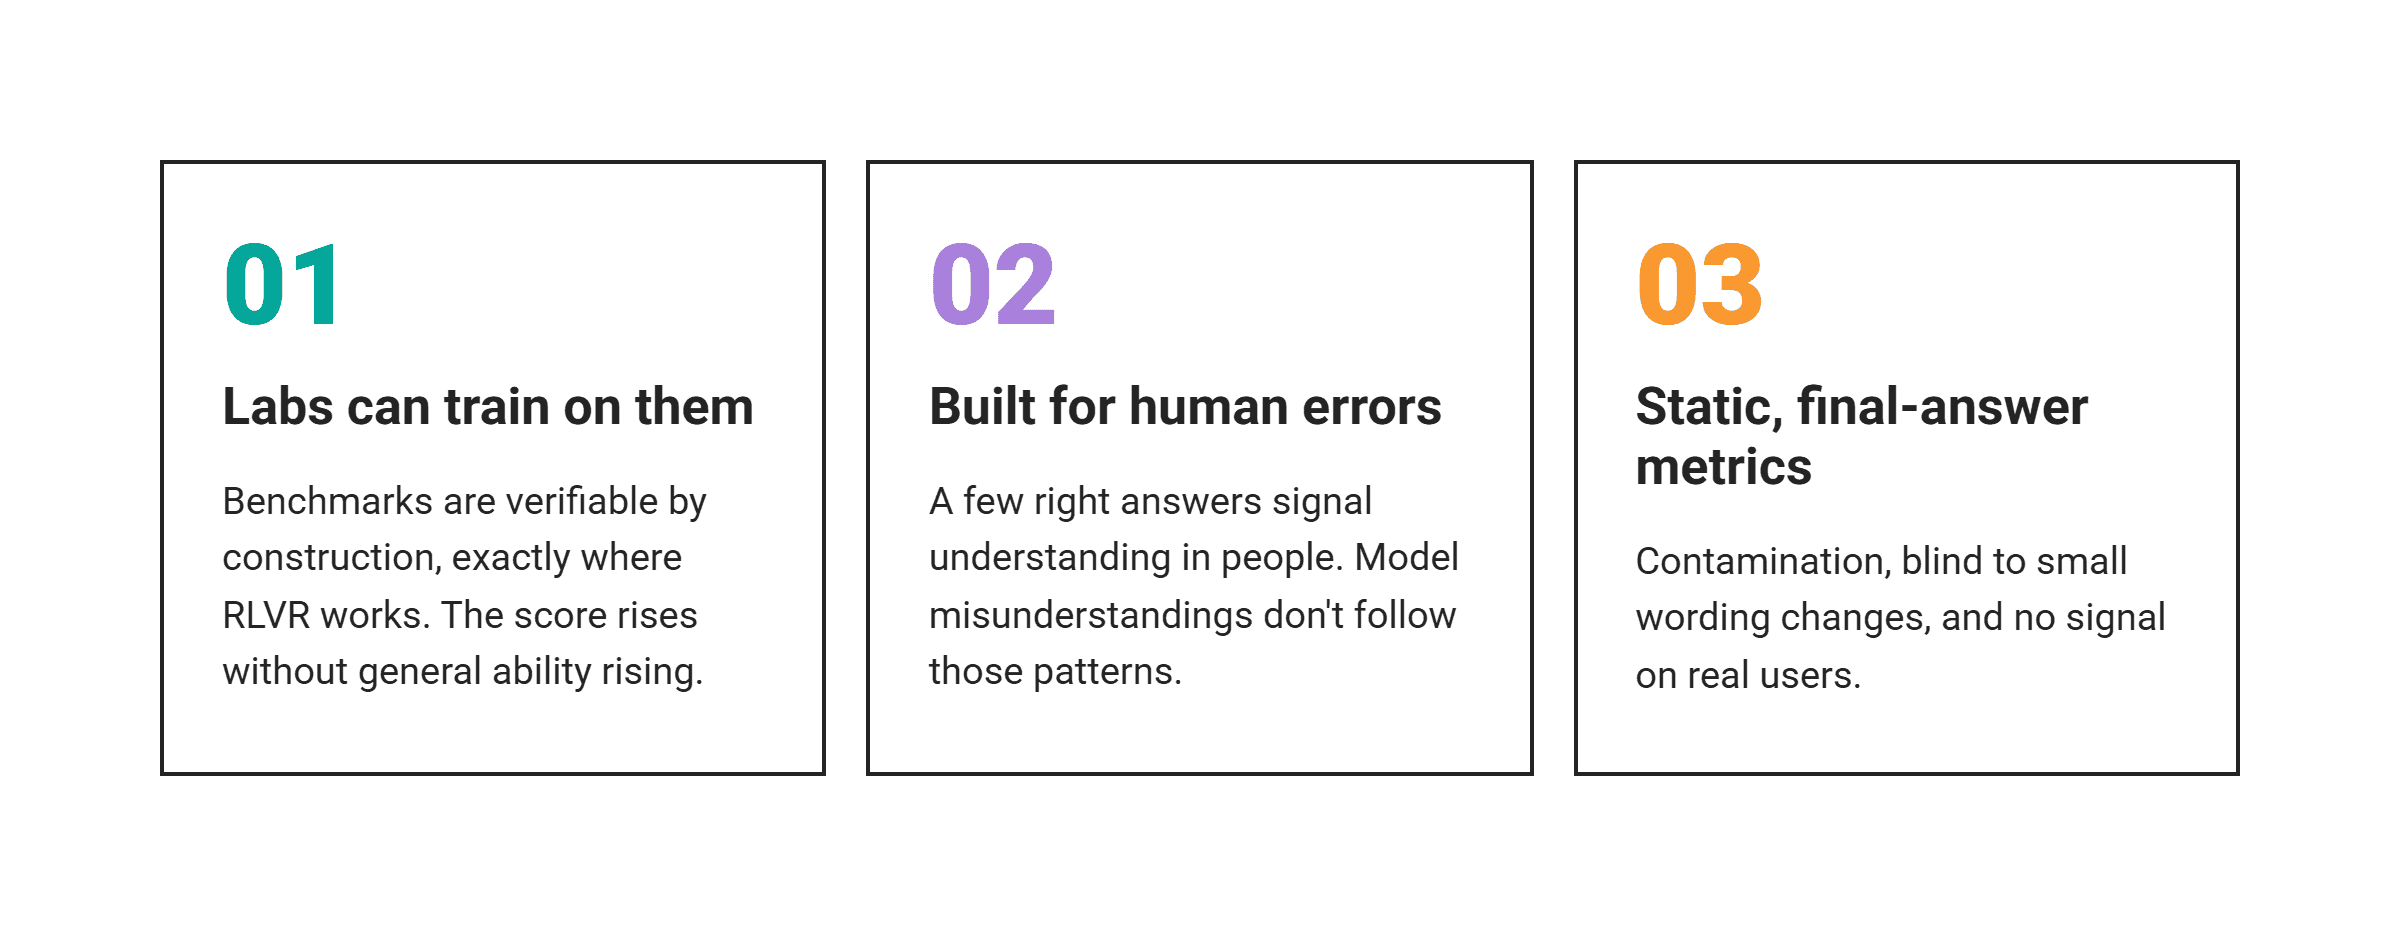
Karpathy ระบุว่าเขาสูญเสียความเชื่อถือใน benchmarks เพราะมันเป็นสภาพแวดล้อมที่ตรวจสอบได้ ซึ่งเอื้อต่อการฝึกแบบ RLVR ทำให้คะแนนสูงขึ้นได้โดยที่ความสามารถทั่วไปไม่ได้พัฒนาจริง นอกจากนี้ Benchmark ยังสมมติว่าถ้า AI ตอบถูกคือเข้าใจ ซึ่งงานวิจัยชี้ว่า AI อาจผ่านการทดสอบได้โดยไม่ต้องเข้าใจแนวจริง
Benchmarks อย่าง GSM8K ยังเสี่ยงต่อการปนเปื้อนข้อมูลและการเปลี่ยนคำเพียงเล็กน้อยก็ส่งผลต่อผลลัพธ์ ดังนั้นการทดสอบกับผู้ใช้จริงจึงมีความสำคัญกว่าคะแนนในกระดาษ
คำถามสัมภาษณ์งาน: กำไร 3% ที่ซ่อนความถดถอยไว้
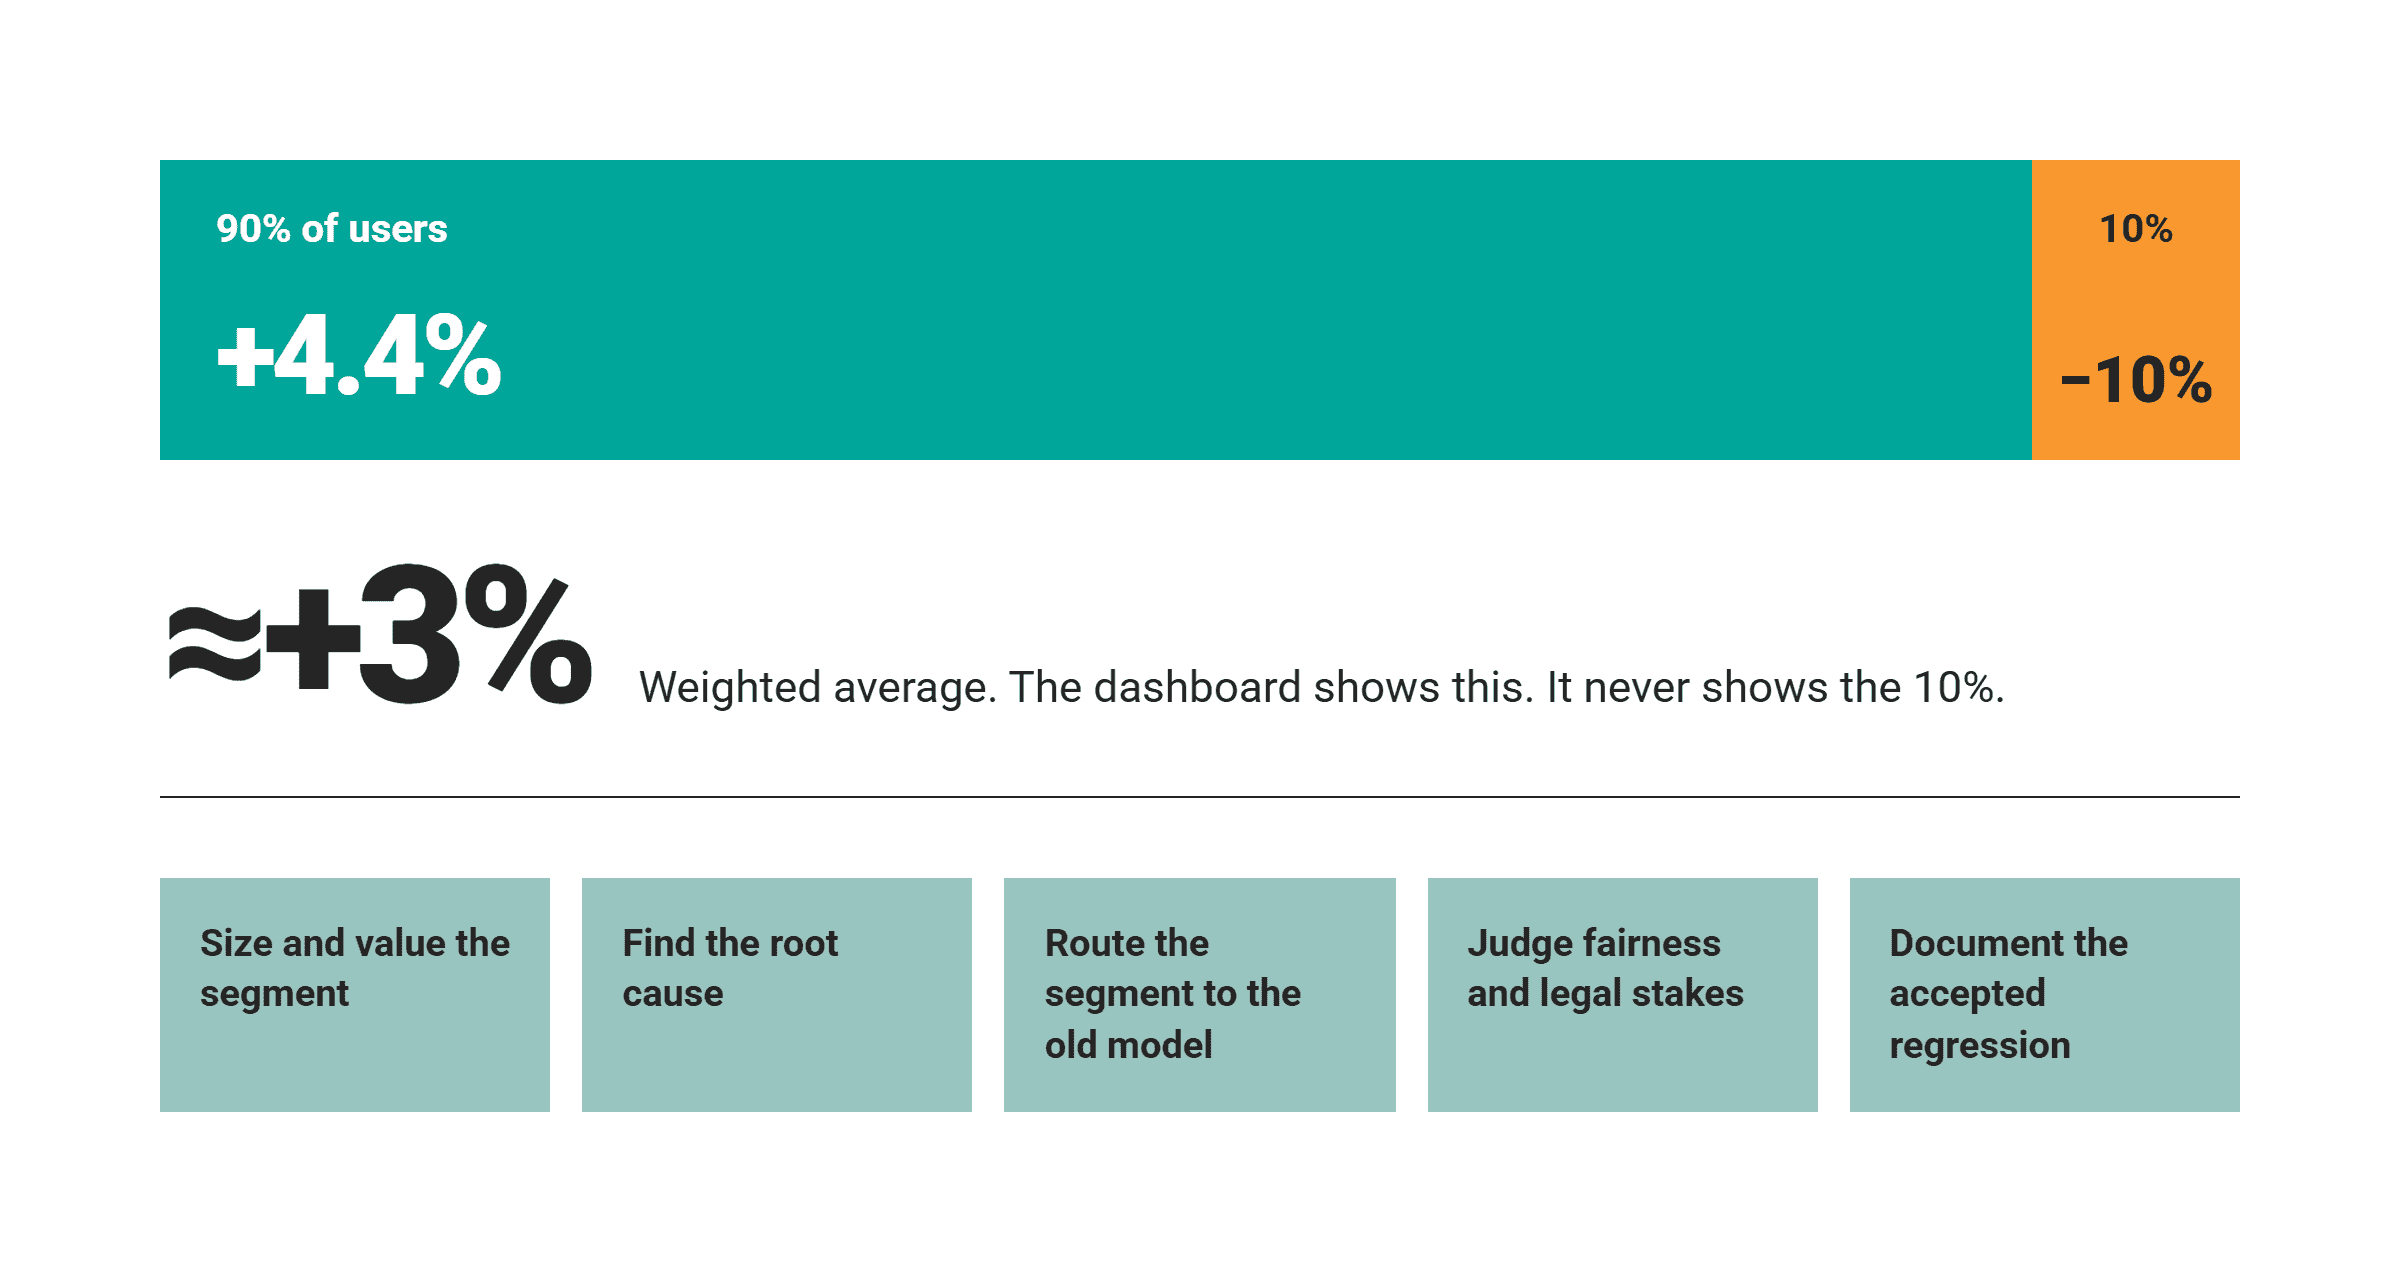
คำถามจาก OpenAI สะท้อนปัญหา jaggedness ในเชิงผลิตภัณฑ์: หากโมเดลใหม่ดีขึ้น 3% ในภาพรวม แต่แย่ลงในกลุ่มผู้ใช้เฉพาะเจาะจง คุณจะปล่อยใช้งานหรือไม่?
คำตอบที่เหมาะสมคือต้องประเมินเซกเมนต์ที่ได้รับผลกระทบ ค้นหาต้นตอ พิจารณาระบบสำรอง (fallback) และบันทึกความถดถอยที่ยอมรับได้ เพราะตัวเลขรวมเพียงอย่างเดียวอาจหลอกตาเราได้
การใช้ AI อย่างเชื่อถือได้ในแอปพลิเคชันจริง
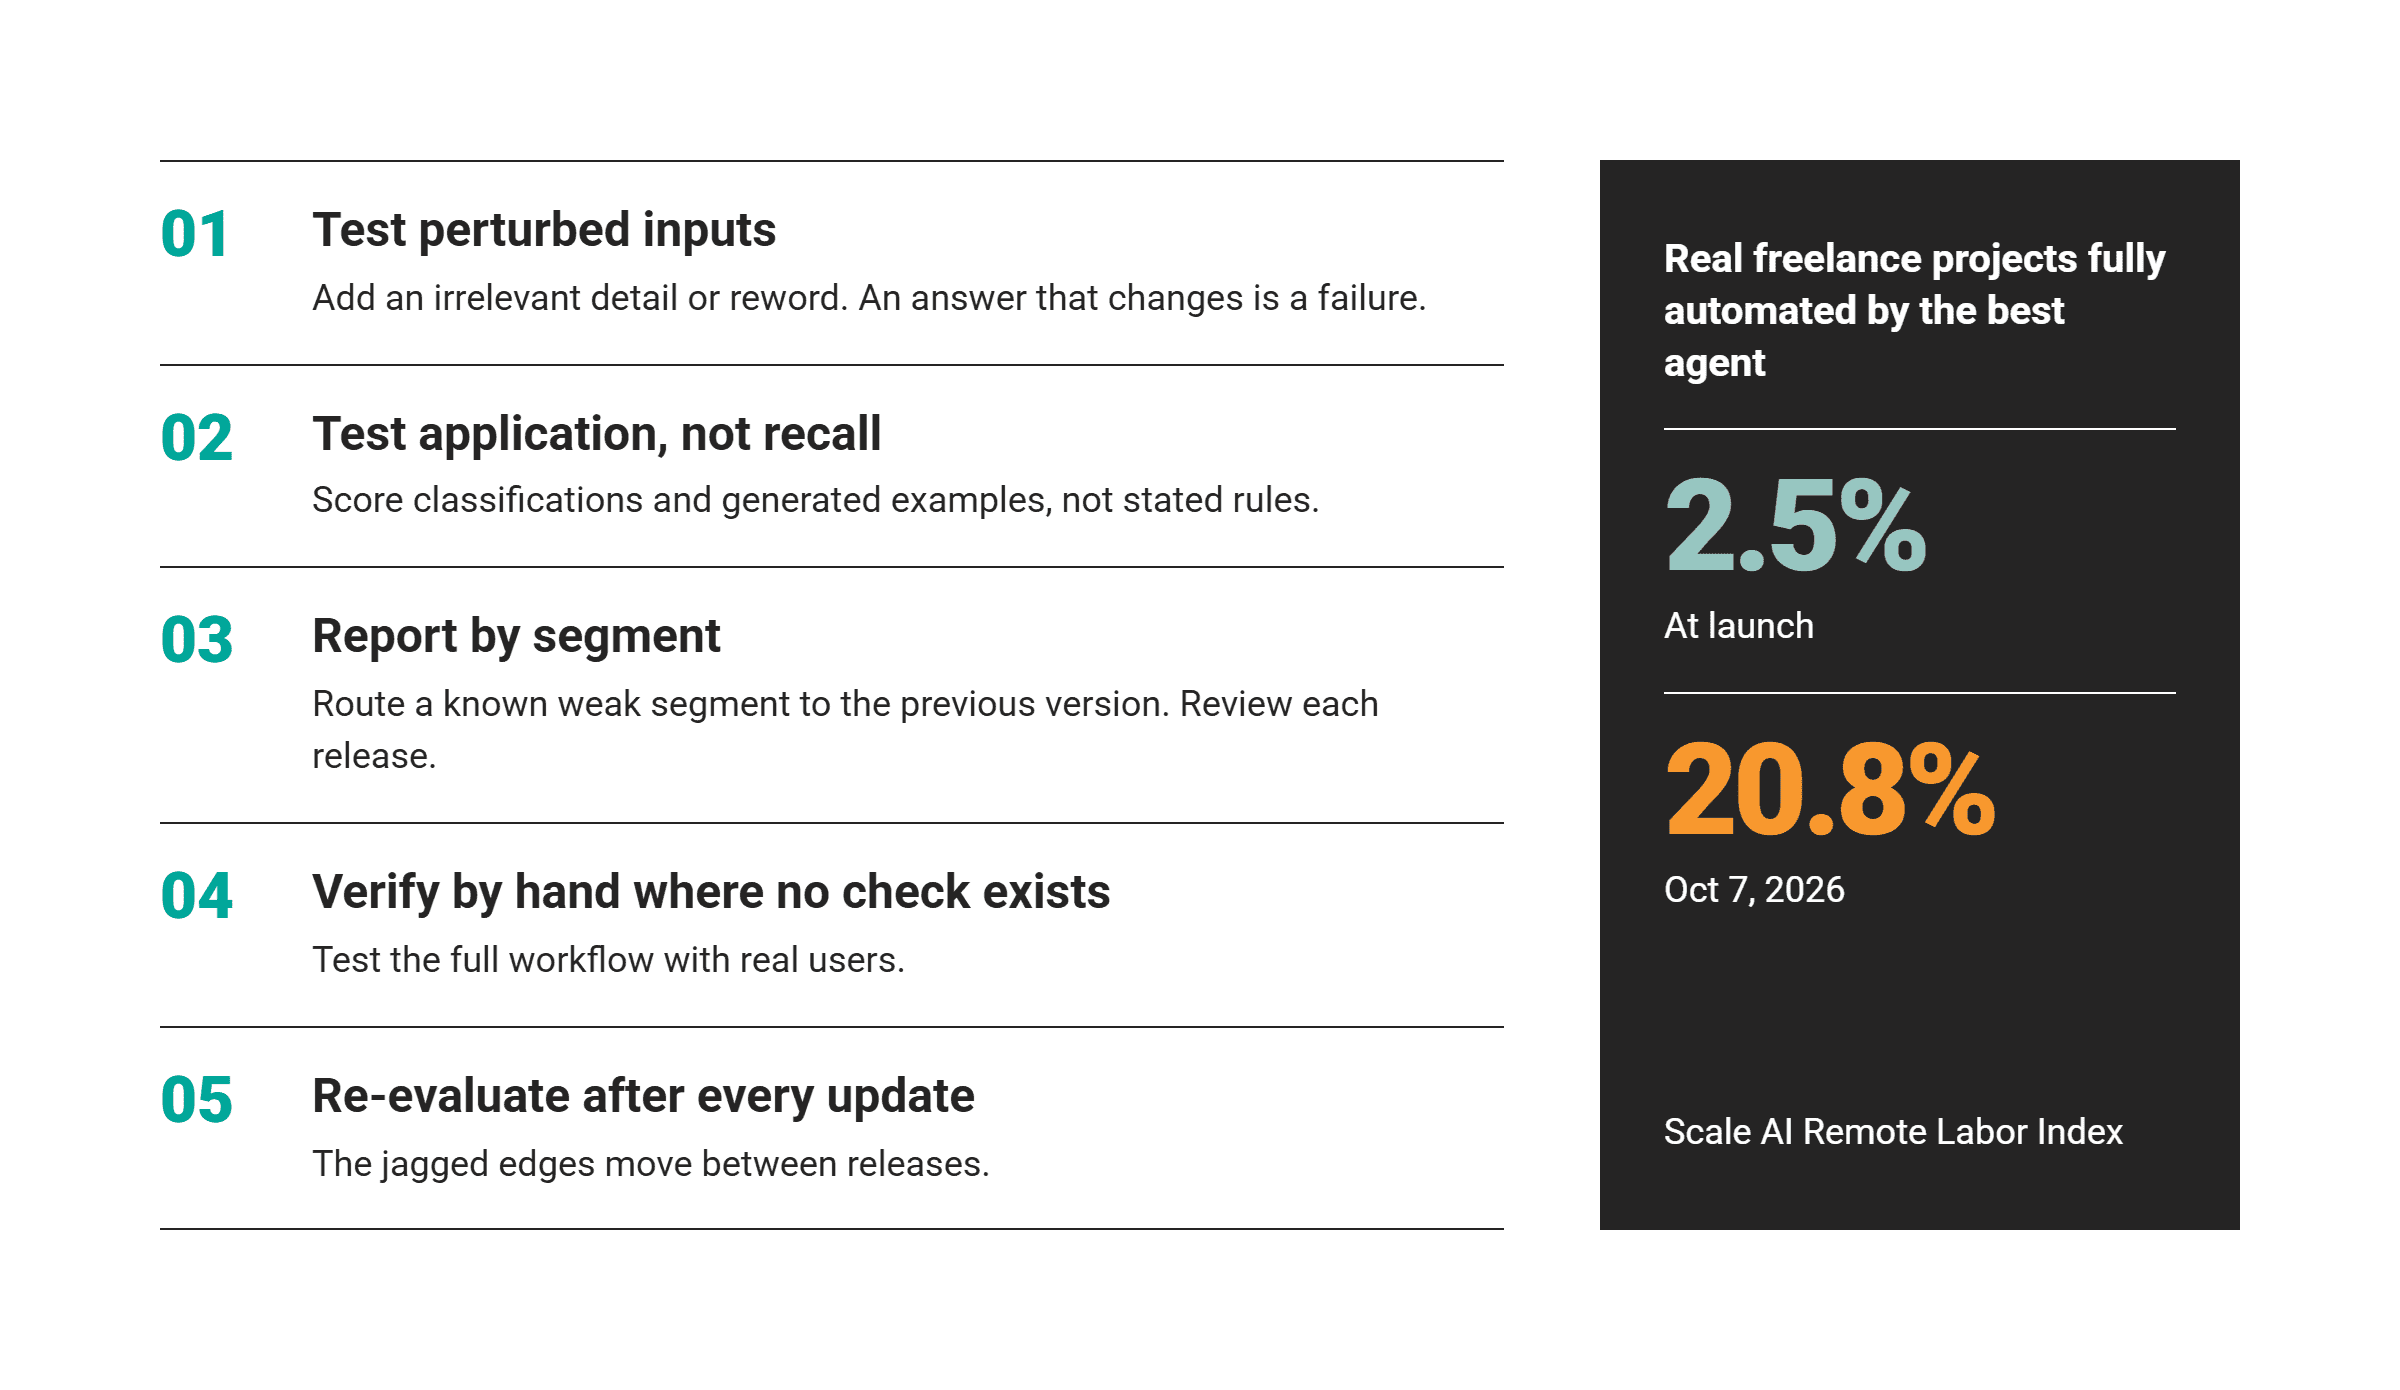
การใช้งาน AI ควรโฟกัสเป็นรายเวิร์กโฟลว์ Remote Labor Index ของ Scale AI แสดงให้เห็นว่าโมเดลระดับท็อปสามารถทำงานแทนคนได้เต็มรูปแบบเพิ่มขึ้นอย่างต่อเนื่อง โดยมีแนวทางปฏิบัติที่แนะนำดังนี้:
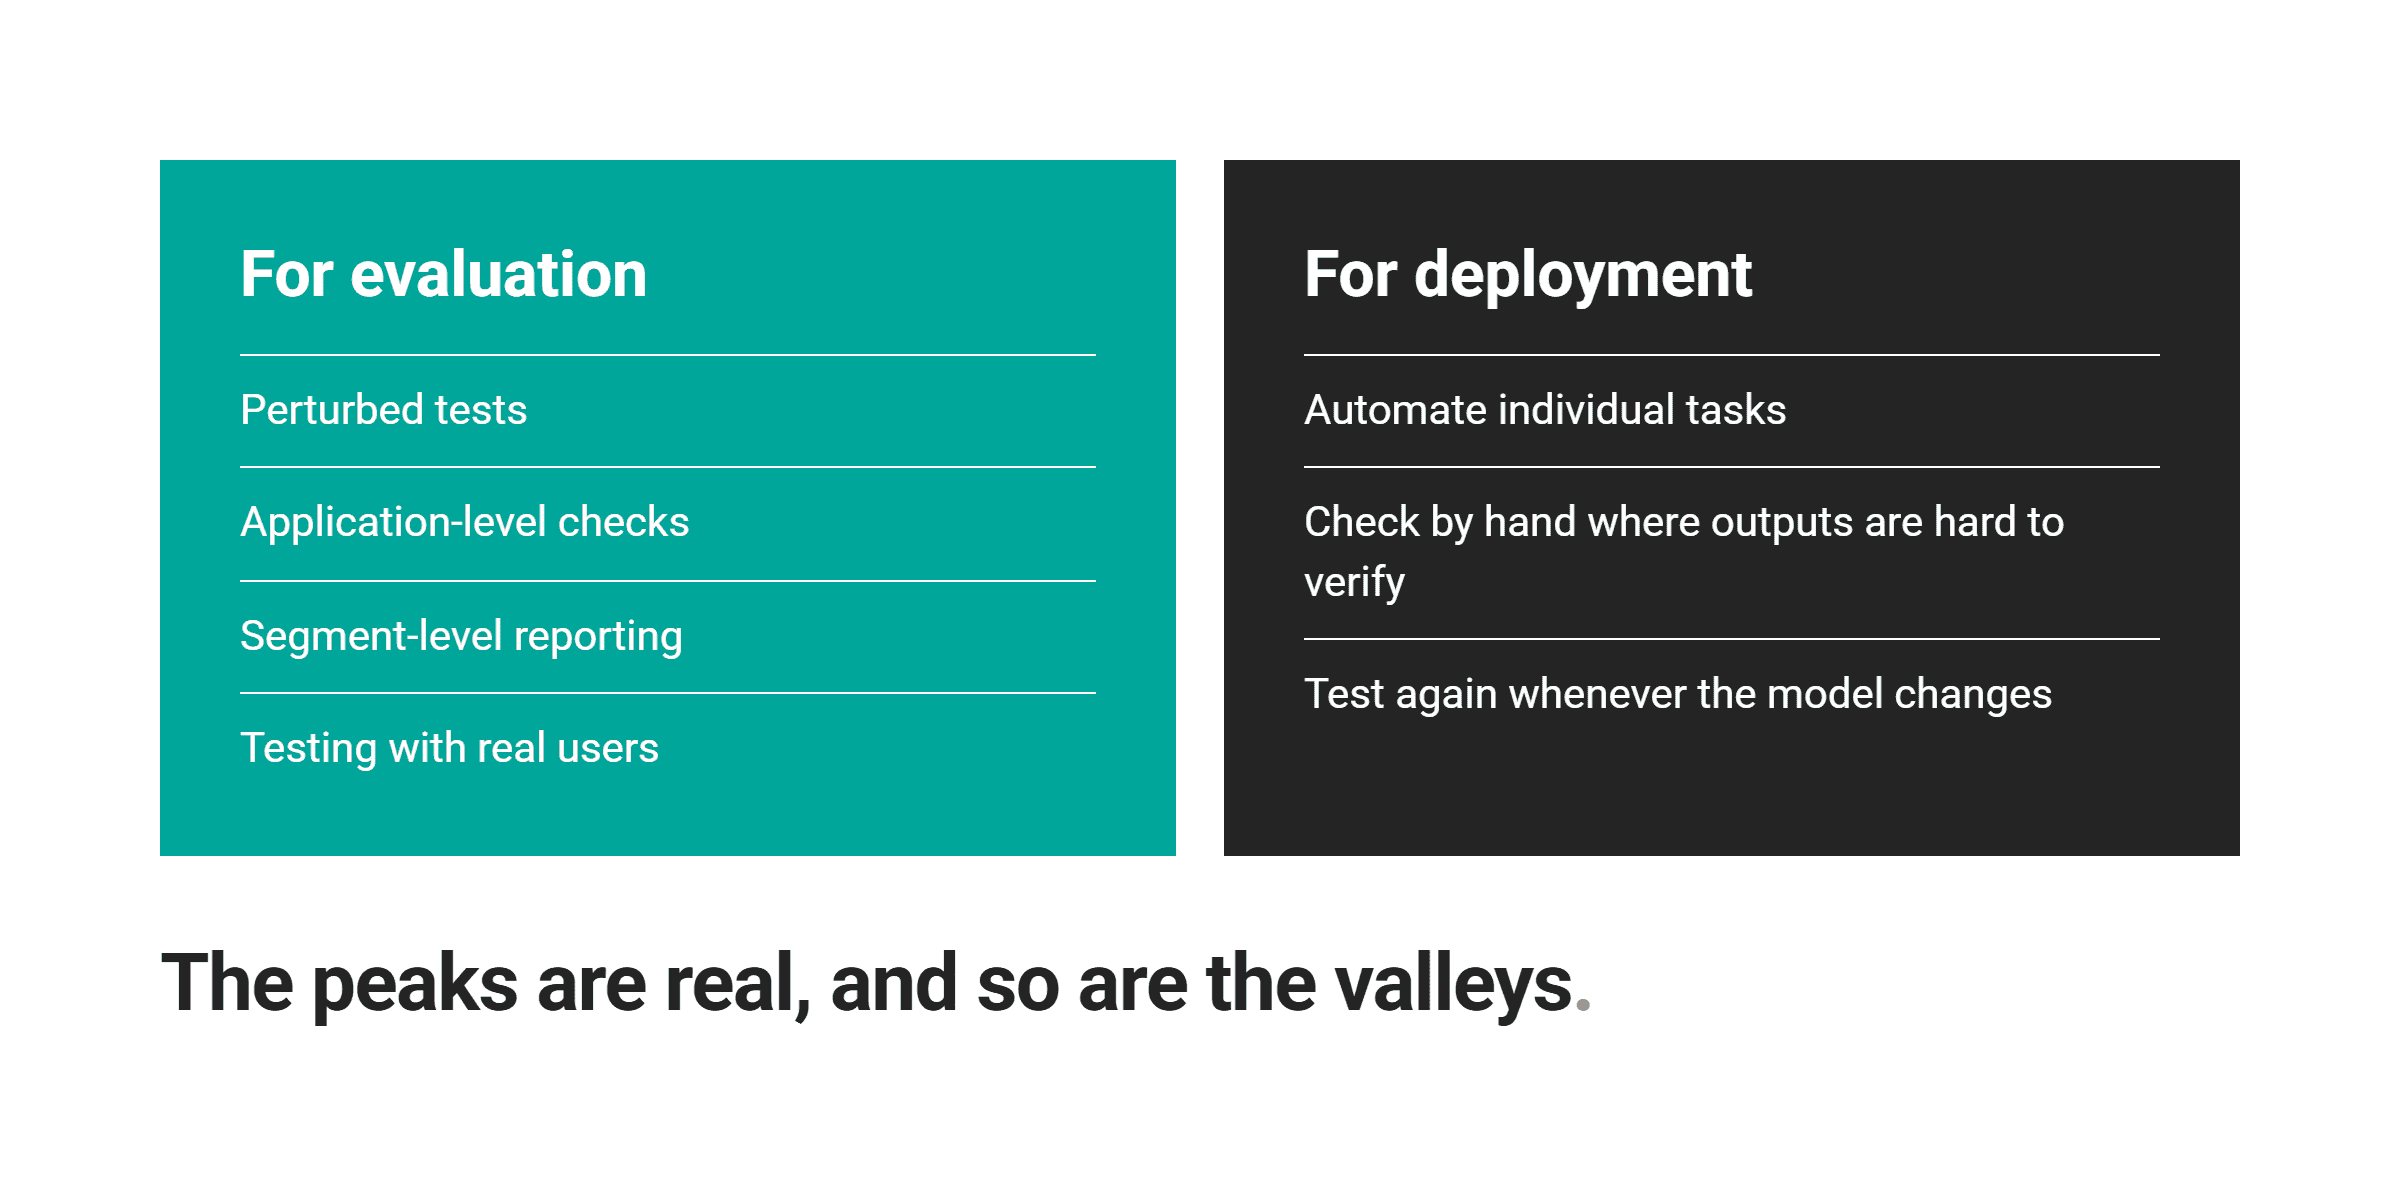
- การทดสอบแบบ Perturbed และ Adversarial: ลองเปลี่ยนคำหรือเพิ่มข้อมูลที่ไม่เกี่ยวข้องในชุดข้อมูลจริงเพื่อเช็คความเสถียร
- ทดสอบการนำไปใช้จริง: อย่าแค่ให้ท่องจำกฎ แต่ต้องให้จัดประเภทหรือสร้างตัวอย่างใหม่
- รายงานผลแยกตามเซกเมนต์: เพื่อป้องกันไม่ให้ความอ่อนแอในบางจุดถูกกลบด้วยค่าเฉลี่ย
- ตรวจสอบด้วยมือ: ในโดเมนที่ RLVR เข้าไม่ถึง ต้องใช้มนุษย์ช่วยยืนยันความถูกต้อง
- ประเมินซ้ำทุกการอัปเดต: ขอบที่หยักจะเปลี่ยนไปตามรุ่นของโมเดล ผลทดสอบเดิมจึงใช้ไม่ได้ตลอดไป
ท้ายที่สุด Jagged intelligence ย้ำเตือนว่าในขณะที่ AI ขึ้นสู่ยอดเขาในบางทักษะ มันก็อาจตกลงไปในเหวของทักษะพื้นฐานได้เสมอ การทดสอบด้วยกรณีการใช้งานของคุณเองเท่านั้นที่จะบอกได้ว่า AI นั้นไว้ใจได้แค่ไหน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร