
เผยสาเหตุ LLM เขียนติดสำนวน AI: ชี้การวางระบบความปลอดภัยทำขอบเขตภาษาแคบลงจนตรวจจับง่าย
ในทางทฤษฎีแล้ว LLM สามารถเขียนได้หลากหลายเทียบเท่ากับมนุษย์ แต่ในความเป็นจริงกลับมีข้อจำกัดอย่างเห็นได้ชัด Bradley Emi ซึ่งดำรงตำแหน่ง CTO ของ Pangram ผู้พัฒนาเครื่องมือตรวจจับข้อความ AI ให้ทัศนะผ่าน blog post ว่าการวางระบบป้องกันและความปลอดภัยหลังการฝึกฝน (Post-training safety filters) คือสาเหตุหลักที่ทำให้ข้อความจาก AI ถูกตรวจจับได้ง่าย
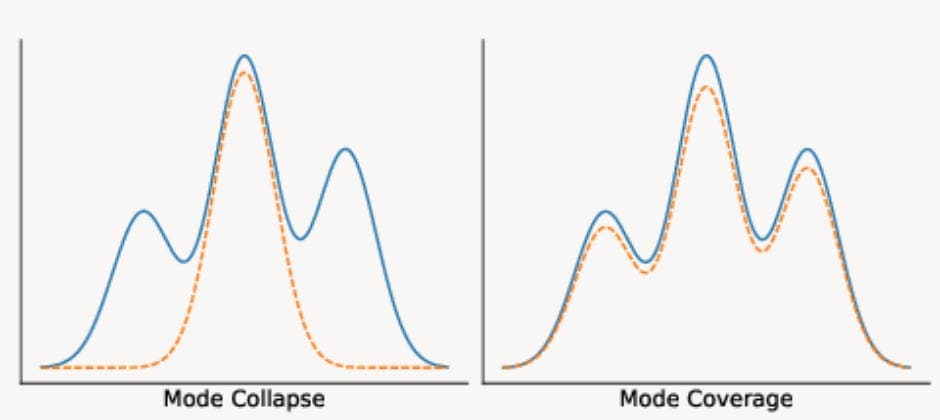
ระบบยอดนิยมอย่าง ChatGPT, Claude หรือ Gemini ต่างถูกสอนให้เรียนรู้กฎพฤติกรรมเพื่อหลีกเลี่ยงผลลัพธ์ที่เป็นอันตราย หรือเพื่อเซ็นเซอร์เนื้อหาทางการเมืองบางประเด็น กระบวนการนี้ส่งผลให้ขอบเขตการแสดงออกของภาษาแคบลงอย่างรวดเร็ว ซึ่งเป็นปรากฏการณ์ทางเทคนิคที่เรียกว่า "mode collapse"
Emi อธิบายเพิ่มเติมว่า "Base model" หรือโมเดลดิบที่ยังไม่ผ่านการปรับแต่งหลังการฝึกฝน จะมีรูปแบบการเขียนที่มีความหลากหลายสูงกว่ามาก ส่งผลให้เครื่องมือตรวจจับของ Pangram ไม่ระบุว่าข้อความเหล่านั้นเป็น AI เช่นเดียวกัน กับการทำ fine-tune เฉพาะทางที่ฝึกให้เลียนแบบงานเขียนของ Hemingway หรือข้อความจาก subreddit บางแห่ง รวมถึงผลลัพธ์ที่ผิดพลาดอย่างข้อความที่อ่านไม่รู้เรื่อง
อย่างไรก็ตาม ข้อสังเกตนี้ใช้ได้เฉพาะกับข้อความ AI ที่ไม่มีการฝังลายน้ำ (watermark) เท่านั้น ซึ่ง ลายน้ำน่าจะยังคงใช้งานได้เสมอ แม้ว่าตัวโมเดลพื้นฐานจะมีความหลากหลายในการนำเสนอเนื้อหามากเพียงใดก็ตาม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร