
รู้จัก ‘Code-as-World’ เปลี่ยนวิดีโอโลกจริงให้เป็นโปรแกรมฟิสิกส์ MuJoCo ที่แก้ไขและรันได้
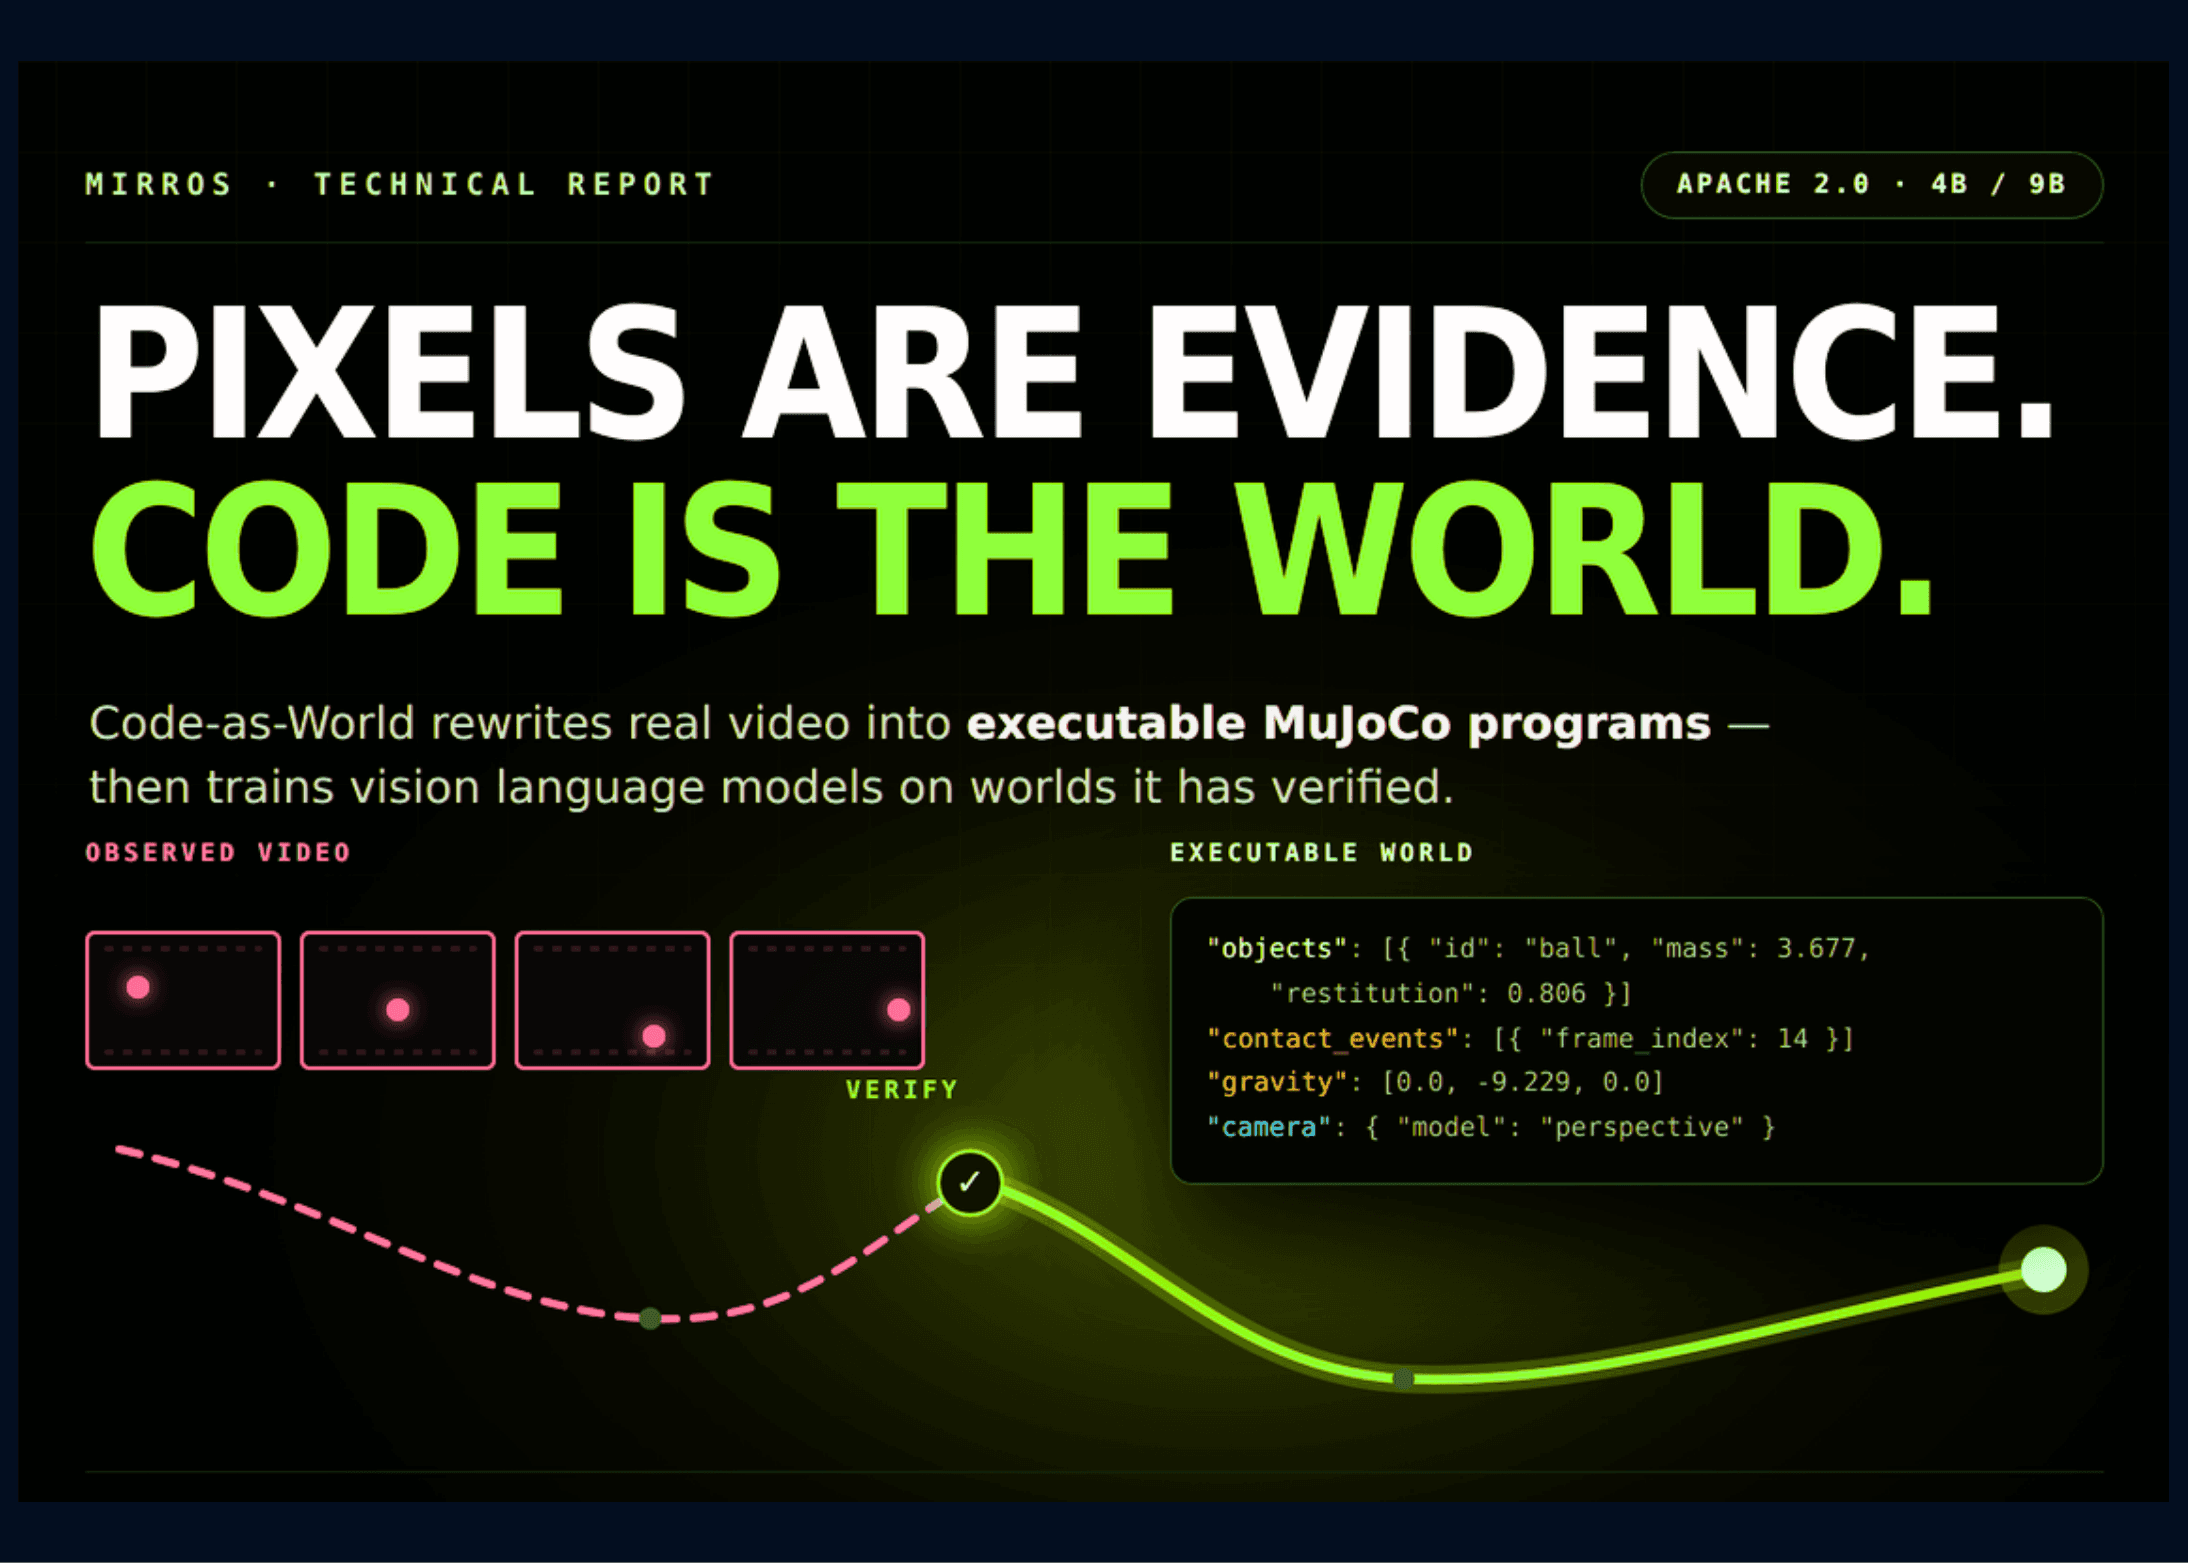
MirroS ได้เปิดตัว Code-as-World กระบวนทัศน์ที่นำเสนอโลกทางกายภาพผ่านการเป็นตัวแทนโลกที่สามารถประมวลผลได้ (executable world representations) โดยมีแนวคิดสำคัญคือ พิกเซลเป็นเพียงหลักฐานของฉากทางกายภาพ ไม่ใช่ตัวตนที่แท้จริง เนื่องจากโมเดลวิดีโอทั่วไปอาจทำนายเฟรมที่ดูสมจริงได้ แต่กลับขาดความเข้าใจเรื่องมวล การสัมผัส หรือแรงโน้มถ่วง
Code-as-World จึงนำเสนอฉากในรูปแบบ โค้ดที่รันได้ หรือไฟล์ scene.json ที่ MuJoCo สามารถประมวลผลได้ ทำให้ Agent สามารถตรวจสอบเปรียบเทียบกับวิดีโอต้นฉบับ รวมถึงแก้ไขและจำลองฉากใหม่ได้ทันที โดยระบบ Agentic Loop จะทำหน้าที่กู้คืนโปรแกรมเหล่านี้จากฟุตเทจจริงผ่านรอบการทำงานสูงสุด 5 รอบ เพื่อสร้างข้อมูลฝึกฝนที่มีลาเบลทางกายภาพแม่นยำ ซึ่งหาไม่ได้จากวิดีโอทั่วไป
จากการทดสอบด้วยการกำกับดูแลดังกล่าว Code-as-World-VL-9B สามารถทำคะแนนได้ถึง 55.4 MRA บน QuantiPhy-validation ซึ่งสูงกว่า Gemini-3.1 Flash ที่ทำได้ 54.8 และทิ้งห่างจากโมเดล Open-weight ระดับแนวหน้าตัวอื่นๆ ถึงประมาณ 15 จุด
ความพร้อมในการใช้งานจริง
ปัจจุบัน MirroS ได้เปิดให้ใช้งานในระดับการวิจัยและโปรโตไทป์แล้ว โดยมีการปล่อย GitHub repo และ Checkpoint สองรุ่น ได้แก่ Code-as-World-VL-4B และ Code-as-World-VL-9B ภายใต้ลิขสิทธิ์ Apache 2.0
โมเดลทั้งสองถูก Fine-tuned มาจาก Qwen3.5-4B และ Qwen3.5-9B ในรูปแบบ BF16 safetensors ซึ่งรองรับการใช้งานผ่าน vLLM บน endpoint /v1 ที่เข้ากันได้กับ OpenAI โดยกำหนดค่าตัวอย่างเฟรมที่ 16 เฟรมต่อวิดีโอ และใช้ --max-model-len 4608 เพื่อประสิทธิภาพสูงสุดในการประมวลผล
แนวคิด: พิกเซลคือหลักฐาน ไม่ใช่ตัวตน
รายงานทางเทคนิคของ MirroS ระบุว่าแม้โมเดลวิดีโอหรือการสร้าง 3D จะจำลองฉากได้ดีเพียงใด แต่ก็ยังไม่สามารถกู้คืน กลไก เบื้องหลังได้ Code-as-World จึงนำเสนอแนวคิด Executable World Representation (EWR) ในรูปแบบชุดสามส่วน p = (C, E, A) ได้แก่:
- Composition: ข้อมูลวัตถุ เรขาคณิต มวล แรงเสียดทาน และแรงโน้มถ่วง เพื่อให้เกิดการชนและรองรับทางกายภาพที่สมบูรณ์
- Evolution: สถานะเริ่มต้น แรง การสัมผัส และเงื่อนไขการสิ้นสุด ซึ่งการรันโค้ดจะทำให้เห็นเส้นทางการเคลื่อนที่ทั้งหมด
- Appearance: ส่วนประกอบด้านภาพ เช่น กล้อง แสง และวัสดุ ซึ่งหากเปลี่ยนส่วนนี้จะไม่ส่งผลต่อระบบฟิสิกส์เบื้องหลัง
ในการปรับใช้จริง ข้อมูลเหล่านี้จะถูกคอมไพล์เป็น scene.json เพื่อรันใน MuJoCo โดยมีเอนจินสองระบบที่สลับการใช้งานได้คือ เอนจินแอนิเมชันสำหรับจลนศาสตร์ และเอนจินฟิสิกส์สำหรับการคำนวณแรงและการสัมผัส
การค้นพบแบบ Agentic แทนการทำนายครั้งเดียว
การกู้คืน EWR จากวิดีโอถือเป็นปัญหาผกผันที่ซับซ้อน ทีมวิจัยจึงใช้แนวทาง Abductive Search ให้ Agent ทำงานในวงจร เสนอ → สร้างอินสแตนซ์ → รัน → เรนเดอร์ → ตรวจสอบ ต่อเนื่องสูงสุด 5 รอบ โดยผสานพลังกับเครื่องมือหลายตัว เช่น SAM 3 สำหรับติดตามระนาบภาพ, VGGT-Omega เพื่อประมาณค่าความลึก และ SAM 3D ในการสร้าง Mesh วัตถุ
ผลลัพธ์ที่ได้จะถูกนำมาเปรียบเทียบกับวิดีโอต้นฉบับในด้าน RGB, ความลึก, และวิถีการเคลื่อนที่ หากพบความต่างในระดับเฟรม ระบบจะส่งฟีดแบ็ก Δ เพื่อแก้ไขในรอบถัดไป ซึ่งวิธีการวนรอบแบบนี้ให้ความแม่นยำสูงกว่าการสุ่มแบบ Best-of-5 ทั่วไปอย่างเห็นได้ชัด โดยข้อมูลวิดีโอที่ใช้มาจากชุดข้อมูล WISA-80K และใช้ Wan2.2-VACE ในการเรนเดอร์ใหม่แบบ Sim-to-Real
โลกที่ผ่านการตรวจสอบเพื่อใช้ฝึกฝน AI
ในระยะแรกมีการทำ Supervised Fine-tuning บนคู่คำถาม-คำตอบเชิงภาพกว่า 73,335 คู่ ครอบคลุมข้อมูลความเร็วและความเร่งในพิกเซลดิบ จากนั้นในระยะที่สองได้ใช้เทคนิค GRPO กับชุดข้อมูล VQA จากโลกที่รันได้จริงทั้งแบบที่ขับเคลื่อนด้วยข้อความและวิดีโอ โดยใช้การประเมินจากความแม่นยำทางตัวเลขและหน่วยวัดฟิสิกส์ ซึ่งการฝึกฝนนี้ใช้ GPU NVIDIA H100 จำนวน 8 ตัว
ผลลัพธ์บน QuantiPhy แสดงให้เห็นว่าโมเดลรุ่น 9B มีประสิทธิภาพโดดเด่นกว่าทั้ง Gemini-3.1 Flash และ ChatGPT-5.1 โดยเฉพาะเมื่อเพิ่มแหล่งข้อมูลพื้นที่โลกเข้าไปจะช่วยยกระดับคะแนนได้อย่างมีนัยสำคัญ นอกจากนี้ยังพัฒนาเรื่องการระบุตำแหน่งระดับพิกเซล (Pixel-level grounding) บนชุดข้อมูล RefCOCO และ GOT-10K ได้ดีขึ้นหลังการทำ World-space RL
ประเด็นสำคัญที่น่าสนใจ
- Code-as-World เปลี่ยนวิดีโอเป็น
scene.jsonที่แก้ไขได้และทำงานบน MuJoCo - กระบวนการเสนอและตรวจสอบ 5 รอบ ให้ผลลัพธ์เหนือกว่าการสุ่มในงบประมาณคำนวณที่เท่ากัน
- สร้างลาเบลทางกายภาพที่แม่นยำจากโลกจำลอง ซึ่งไม่มีอยู่ในวิดีโอจริงทั่วไป
- โมเดลรุ่น 9B มีประสิทธิภาพสูงกว่า Gemini-3.1 Flash และปล่อยให้ใช้งานแบบ Open-source
- ปัจจุบันยังรองรับเฉพาะวัตถุแข็ง (Rigid-body) และโมเดลยังไม่สามารถเรียนรู้วงจรการค้นพบได้ด้วยตนเอง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร