
Kyutai เปิดตัว REKI โมเดล VLA ขนาด 2.4B พร้อมหน่วยความจำประสิทธิภาพสูง
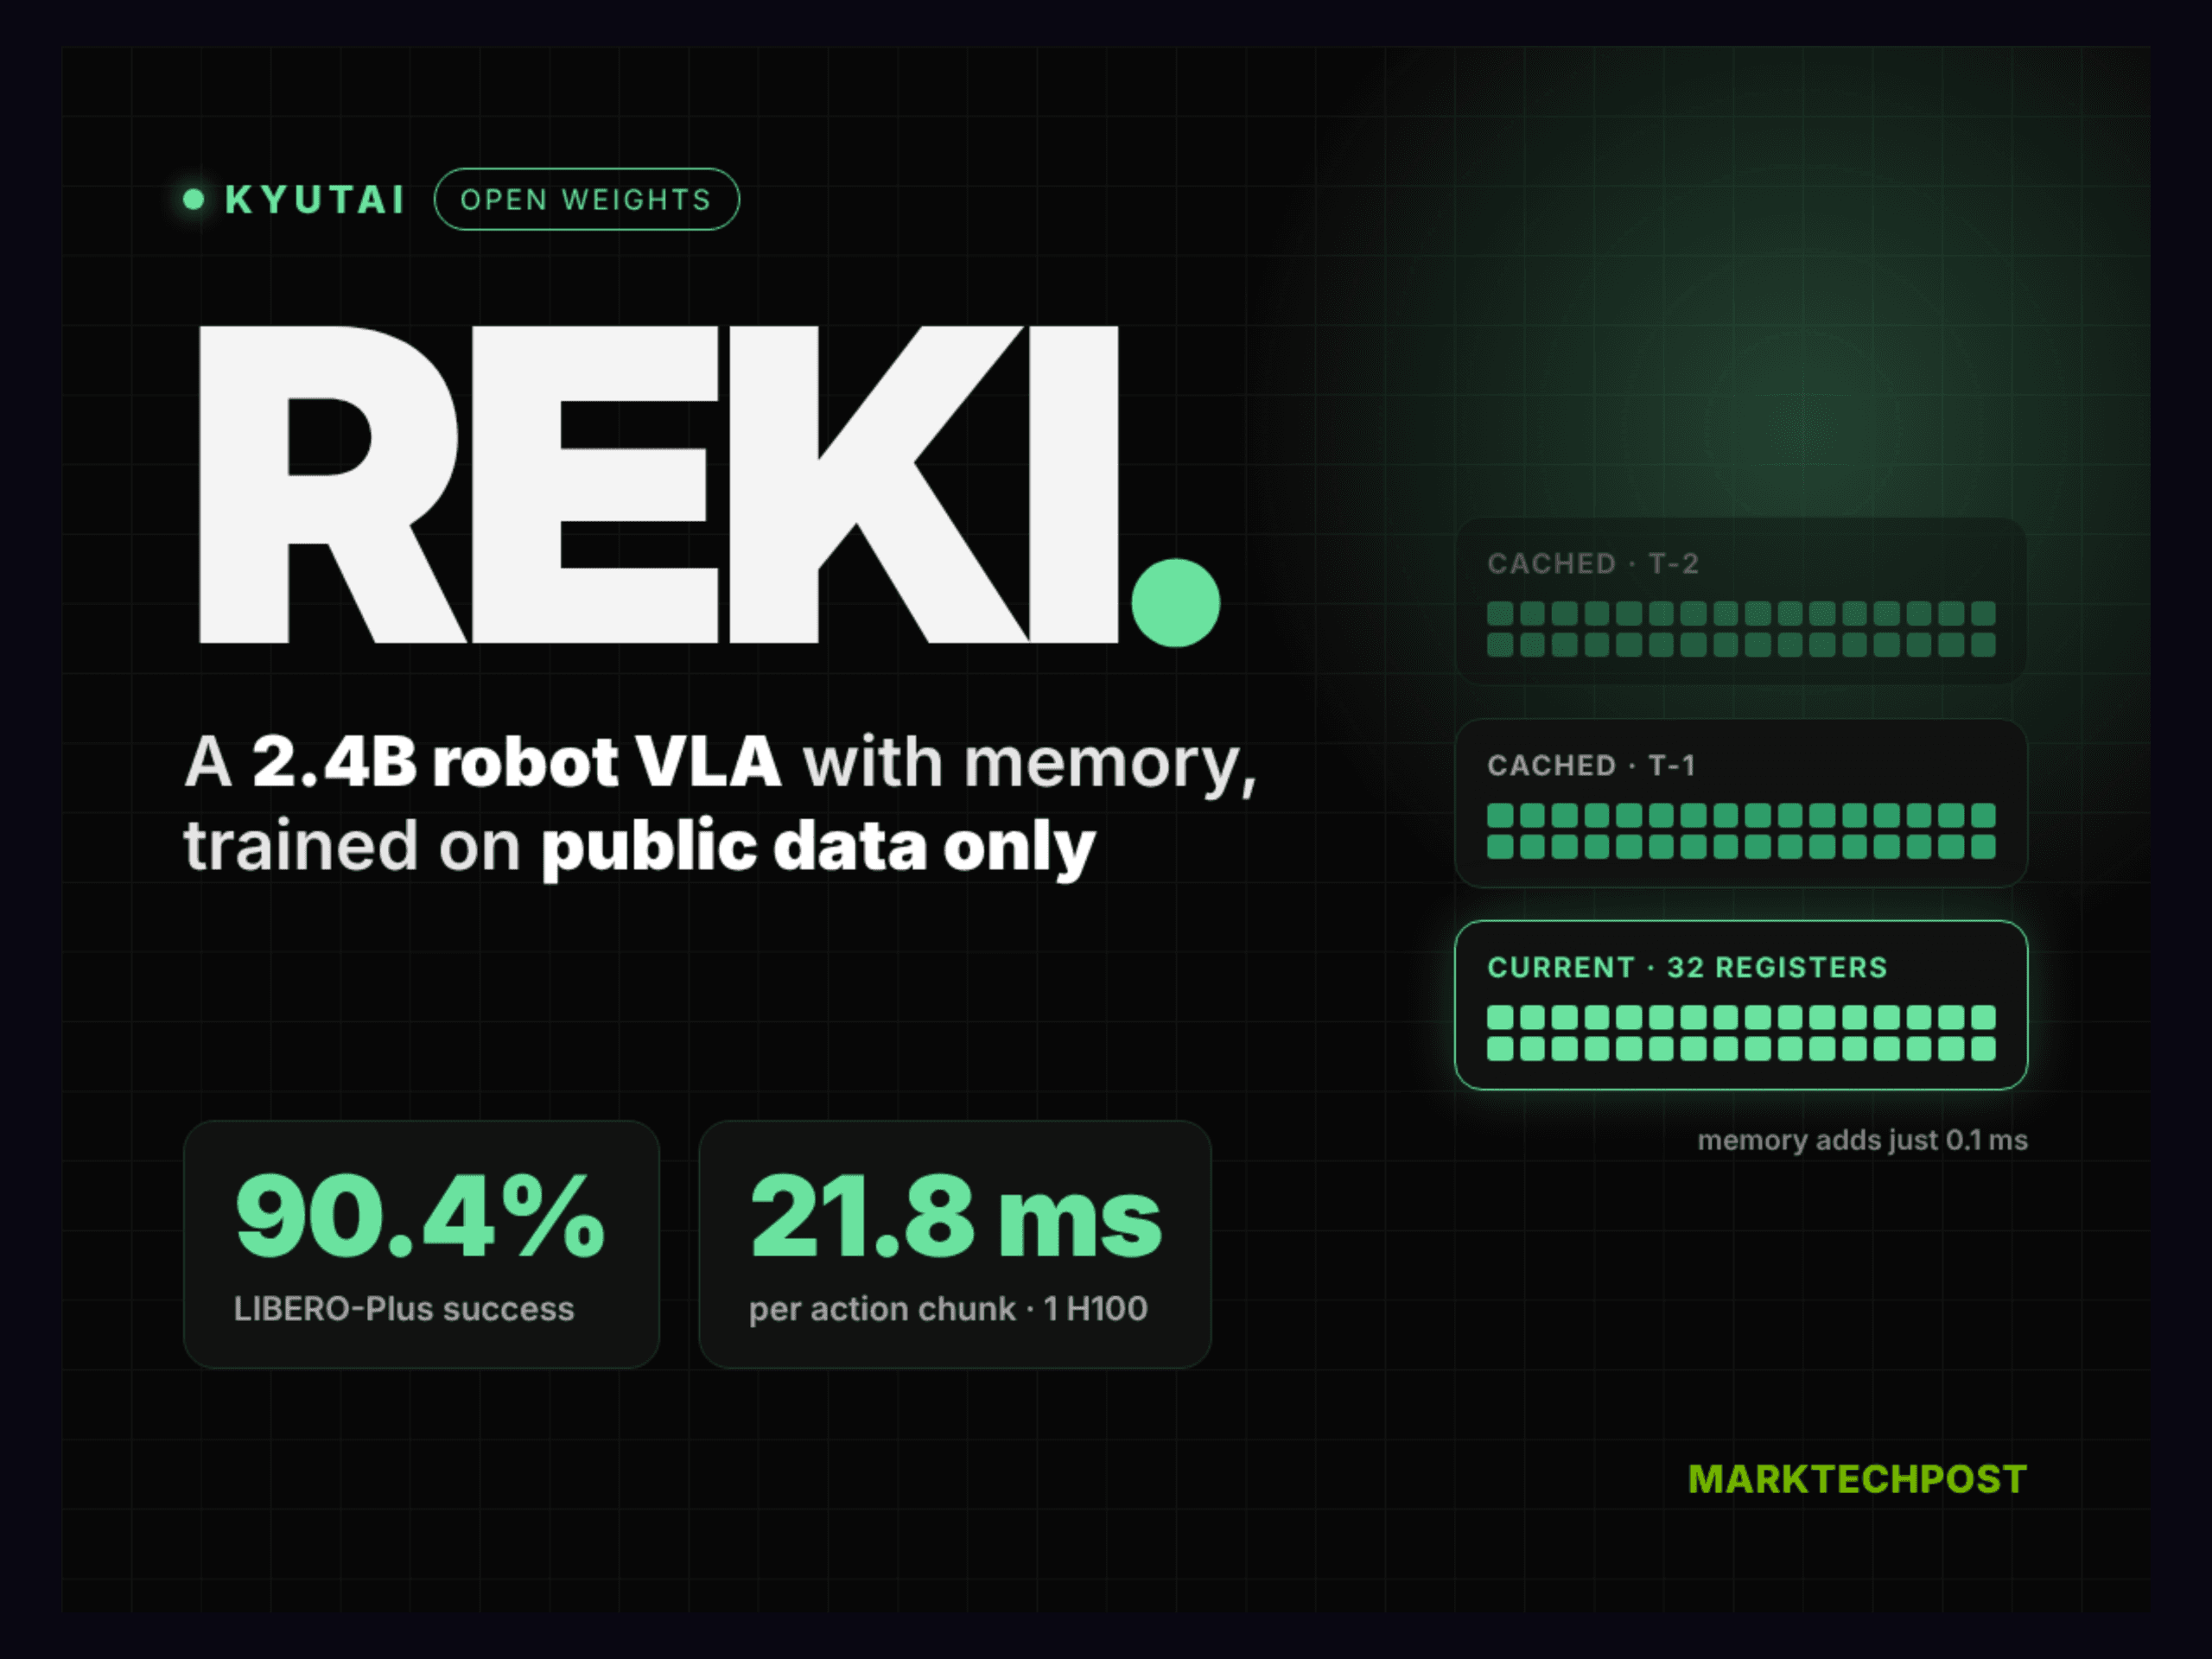
Kyutai ร่วมกับ Inria และ École des Ponts ได้เปิดตัว REKI ซึ่งเป็นโมเดล vision-language-action model (VLA) ขนาด 2.4B สำหรับการควบคุมหุ่นยนต์โดยเฉพาะ โดยโมเดลนี้ได้รับการเทรนล่วงหน้า (pretrained) บนข้อมูลสาธารณะเท่านั้น
จุดเด่นของ REKI คือการมาพร้อมหน่วยความจำราคาประหยัดสำหรับจัดเก็บข้อมูลย้อนหลังที่เพิ่งเกิดขึ้น จากผลการทดสอบบน out-of-distribution benchmark 3 รายการ พบว่ามีเพียงโมเดลที่มีขนาดใหญ่กว่าประมาณสองเท่าเท่านั้นที่ทำคะแนนได้ดีกว่า โดยปัจจุบันค่าน้ำหนัก (weights) ทั้งหมดเปิดให้ใช้งานแล้ว บน Hugging Face
TL;DR
- ขนาด: พารามิเตอร์รวม 2.4B (ประกอบด้วย Qwen3.5-2B VLM 2.2B และ flow-matching action expert 0.2B) โดยหน่วยความจำครอบคลุมข้อมูล 3 เฟรมล่าสุด ห่างกันเฟรมละ 1 วินาที
- การทำงาน: ทดสอบบน NVIDIA H100 หนึ่งตัว ใช้เวลาเพียง 21.8 ms ต่อ action chunk เมื่อประมวลผลจากกล้อง 2 ตัวที่ความละเอียด 256×256 โดยค่าน้ำหนักอยู่ในรูปแบบ BF16
- ประสิทธิภาพ: ครองตำแหน่งดีที่สุดในกลุ่ม VLA ที่เทรนบนข้อมูลสาธารณะสำหรับ LIBERO-Plus และ RoboTwin Clean2Rand
- คะแนนสูงสุด: ทำได้ 90.4% บน LIBERO-Plus ซึ่งเป็นตัวเลขสูงสุดในการเปรียบเทียบของ Kyutai
- คะแนนต่ำสุด: ทำได้ 38.4% บน RoboCasa365 ซึ่งยังตามหลัง Xiaomi-Robotics-1 (57.4%) อยู่พอสมควร
REKI คืออะไร?
REKI คือโมเดล VLA จาก Kyutai ที่ทำหน้าที่แปลงภาพจากกล้องและคำสั่งภาษาให้เป็นการกระทำของหุ่นยนต์ โดยใช้โครงสร้างหลัก (backbone) จาก Qwen3.5-2B ประสานงานกับ action expert ขนาด 200 ล้านพารามิเตอร์
ตัวโมดูล expert จะสร้าง action chunks ผ่านกระบวนการ flow matching ที่รวมเข้าด้วยกันใน 10 Euler steps ส่วนสถานะของหุ่นยนต์และ flow time จะถูกป้อนผ่าน adaptive RMSNorm โดยเลย์เอาต์สถานะหุ่นยนต์แต่ละรูปแบบจะมี state MLP ขนาดเล็กแยกเป็นของตัวเองเพื่อความแม่นยำ
หน่วยความจำของ REKI ทำงานอย่างไร? โดยปกติแล้ว VLA ส่วนใหญ่มักสั่งการจากเฟรมปัจจุบันเพียงอย่างเดียว ซึ่งวิธีการจัดการหน่วยความจำในอดีตมักจะมีต้นทุนสูง ไม่ว่าจะเป็นการส่งเฟรมย้อนหลังเข้าไปใน VLM หรือการเพิ่มโมดูลเสริม
REKI แก้ปัญหานี้ด้วยการวางหน่วยความจำไว้ภายใน action expert แทน โดยใช้ register tokens ที่เรียนรู้มาจำนวน 32 ตัว วางไว้หน้า action tokens ของแต่ละเฟรม โทเค็นเหล่านี้จะทำ cross-attend กับ prompt และภาพในเฟรมนั้น พร้อมทั้งทำ self-attend กับข้อมูลจากเฟรมก่อนหน้า
ระบบนี้ถูกออกแบบให้ Registers ไม่อ่าน action tokens ทำให้พวกมันขึ้นอยู่กับสิ่งที่สังเกตเห็น (observations) เท่านั้น ข้อมูลจะถูกคำนวณหนึ่งครั้งต่อเฟรมและเก็บไว้ในหน่วยความจำแคชแบบ rolling window ซึ่งมีต้นทุนการทำงานต่ำมาก ดังนี้:
- การอ่านแคชเพิ่มเวลาประมวลผลเพียง 0.1 ms จากเดิม 21.8 ms
- ใช้หน่วยความจำ GPU เพียงประมาณ 2 MiB ต่อเฟรมย้อนหลัง
- การเทรนสามารถบรรจุหน้าต่าง 3 เฟรมลงในการประมวลผลแบบ batch ครั้งเดียวได้ทันที
นอกจากนี้ หน่วยความจำยังช่วยแก้ปัญหาการแกว่ง (oscillate) ของแขนหุ่นยนต์ระหว่าง 2 ท่าทางใน RoboTwin โดยลดอัตราการเกิดลงจาก 18.6% เหลือเพียง 4.1% ซึ่ง Kyutai เชื่อว่าช่วยลดปัญหา perceptual aliasing ได้อย่างดี
ประสิทธิภาพของ REKI บน benchmark
REKI ผ่านการเทรนล่วงหน้าหนึ่งครั้งและนำมาปรับจูน (finetuned) แยกตามแต่ละ benchmark โดยมีผลคะแนนที่น่าสนใจดังนี้:
- LIBERO-Plus: 90.4% สูงกว่า Qwen-RobotManip (89.0%) และ π0.5 (85.7%)
- RoboTwin Clean2Rand: 65.8% ตามหลัง Qwen-RobotManip (68.5%) เล็กน้อย
- RoboCasa365: 38.4% นำหน้า RLDX-1 (36.0%) และ Qwen-RobotManip (35.9%)
- LIBERO (4 suites): ทำคะแนนได้สูงถึง 97.6%
การเทรนล่วงหน้ามีผลอย่างมากในกรณี out of distribution โดยช่วยเพิ่มคะแนนถึง 13.8 จุดบน Clean2Rand และ 30.3 จุดในสภาพแวดล้อมที่รกรุงรัง ขณะที่หน่วยความจำช่วยเพิ่มความแม่นยำบน LIBERO-Plus และ RoboCasa365 อย่างเห็นได้ชัด
การเปรียบเทียบกับโมเดล VLA อื่นๆ
| คุณสมบัติ | REKI (Kyutai) | Qwen-RobotManip (Qwen) | π0.5 (Physical Intelligence) | ABot-M0 (AMAP) |
|---|---|---|---|---|
| ขนาดรวม | 2.4B | 4.7B | 3.3B | 4.6B |
| โครงสร้าง VLM | Qwen3.5-2B | Qwen3.5-4B | อิงตาม Gemma | ไม่เปิดเผย |
| ข้อมูลเทรนล่วงหน้า | สาธารณะเท่านั้น | Open-source + วิดีโอมนุษย์ | ข้อมูลหุ่นยนต์เฉพาะตัว | Open-source (UniACT) |
| หน่วยความจำ | 32 registers, 3 เฟรม | รุ่นย่อย In-context | ไม่มี | ไม่มี |
| LIBERO-Plus | 90.4 | 89.0 | 85.7 | 80.5 |
| RoboTwin Clean2Rand | 65.8 | 68.5 | 63.8 | 55.7 |
| ความหน่วง (H100) | 21.8 ms | ไม่เปิดเผย | 33.8 ms | 46.1 ms |
| ค่าน้ำหนัก | เปิด (CC BY-NC-SA 4.0) | ไม่ปล่อย | เปิด (Apache-2.0) | เปิด (Apache-2.0) |
ข้อมูลที่ใช้ในการฝึกฝน
ชุดข้อมูลที่ใช้ประกอบด้วยเฟรมภาพรวม 1.0 พันล้านเฟรม พร้อมตัวอย่าง vision-language 12.2 ล้านชุด ข้อมูลหลักมาจากการควบคุมหุ่นยนต์จริง 639.8 ล้านเฟรม การจำลอง 193.9 ล้านเฟรม และวิดีโอมนุษย์มุมมองบุคคลที่หนึ่ง 170.9 ล้านเฟรม จากแหล่งข้อมูลระดับโลก เช่น DROID, BridgeData V2 และ EgoVerse โดย Kyutai เลือกคงรูปแบบการควบคุมดั้งเดิมไว้ทั้งหมด
การติดตั้งใช้งาน
ผู้ใช้งานสามารถเข้าถึง checkpoint ทั้ง 6 รายการ ซึ่งครอบคลุมทั้งรุ่นฐานและรุ่นที่ปรับจูนเฉพาะทาง การใช้งานกับหุ่นยนต์จริงจะใช้โปรโตคอล gRPC ของ LeRobot async-inference ตัวอย่างเช่น แขนหุ่นยนต์ UR5 สามารถปรับจูนได้โดยใช้การสาธิตเพียง 50 ครั้งต่อภารกิจ
from reki import RekiPolicy
policy = RekiPolicy.from_pretrained("kyutai/reki-2b-libero", device="cuda")
policy.reset()  # ล้างแคชของ register เมื่อเริ่มตอนใหม่
actions = policy.predict(images={"camera_top": img0, "camera_wrist_left": img1},
                         state=proprio, task="put the bowl on the plate")
ประเด็นสำคัญ
- REKI เป็นโมเดล VLA ขนาด 2.4B ที่เน้นการใช้ข้อมูลสาธารณะในการเทรน
- ครองแชมป์คะแนนสูงสุด 90.4% บน LIBERO-Plus ในกลุ่มการทดสอบเดียวกัน
- ระบบ Register tokens ช่วยสร้างหน่วยความจำโดยเพิ่มความหน่วงเพียง 0.1 ms
- ช่วยลดปัญหาการเคลื่อนที่แกว่งไปมาของหุ่นยนต์ได้อย่างมีประสิทธิภาพ
- ค่าน้ำหนักเปิดให้ใช้งานฟรีสำหรับการวิจัย แต่ไม่อนุญาตให้ใช้ในเชิงพาณิชย์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร