
เทคนิค Netflix AI: แก้ปัญหา Read Latency ใน Cassandra จากหลักวินาทีสู่มิลลิวินาทีด้วย Dynamic Partitioning
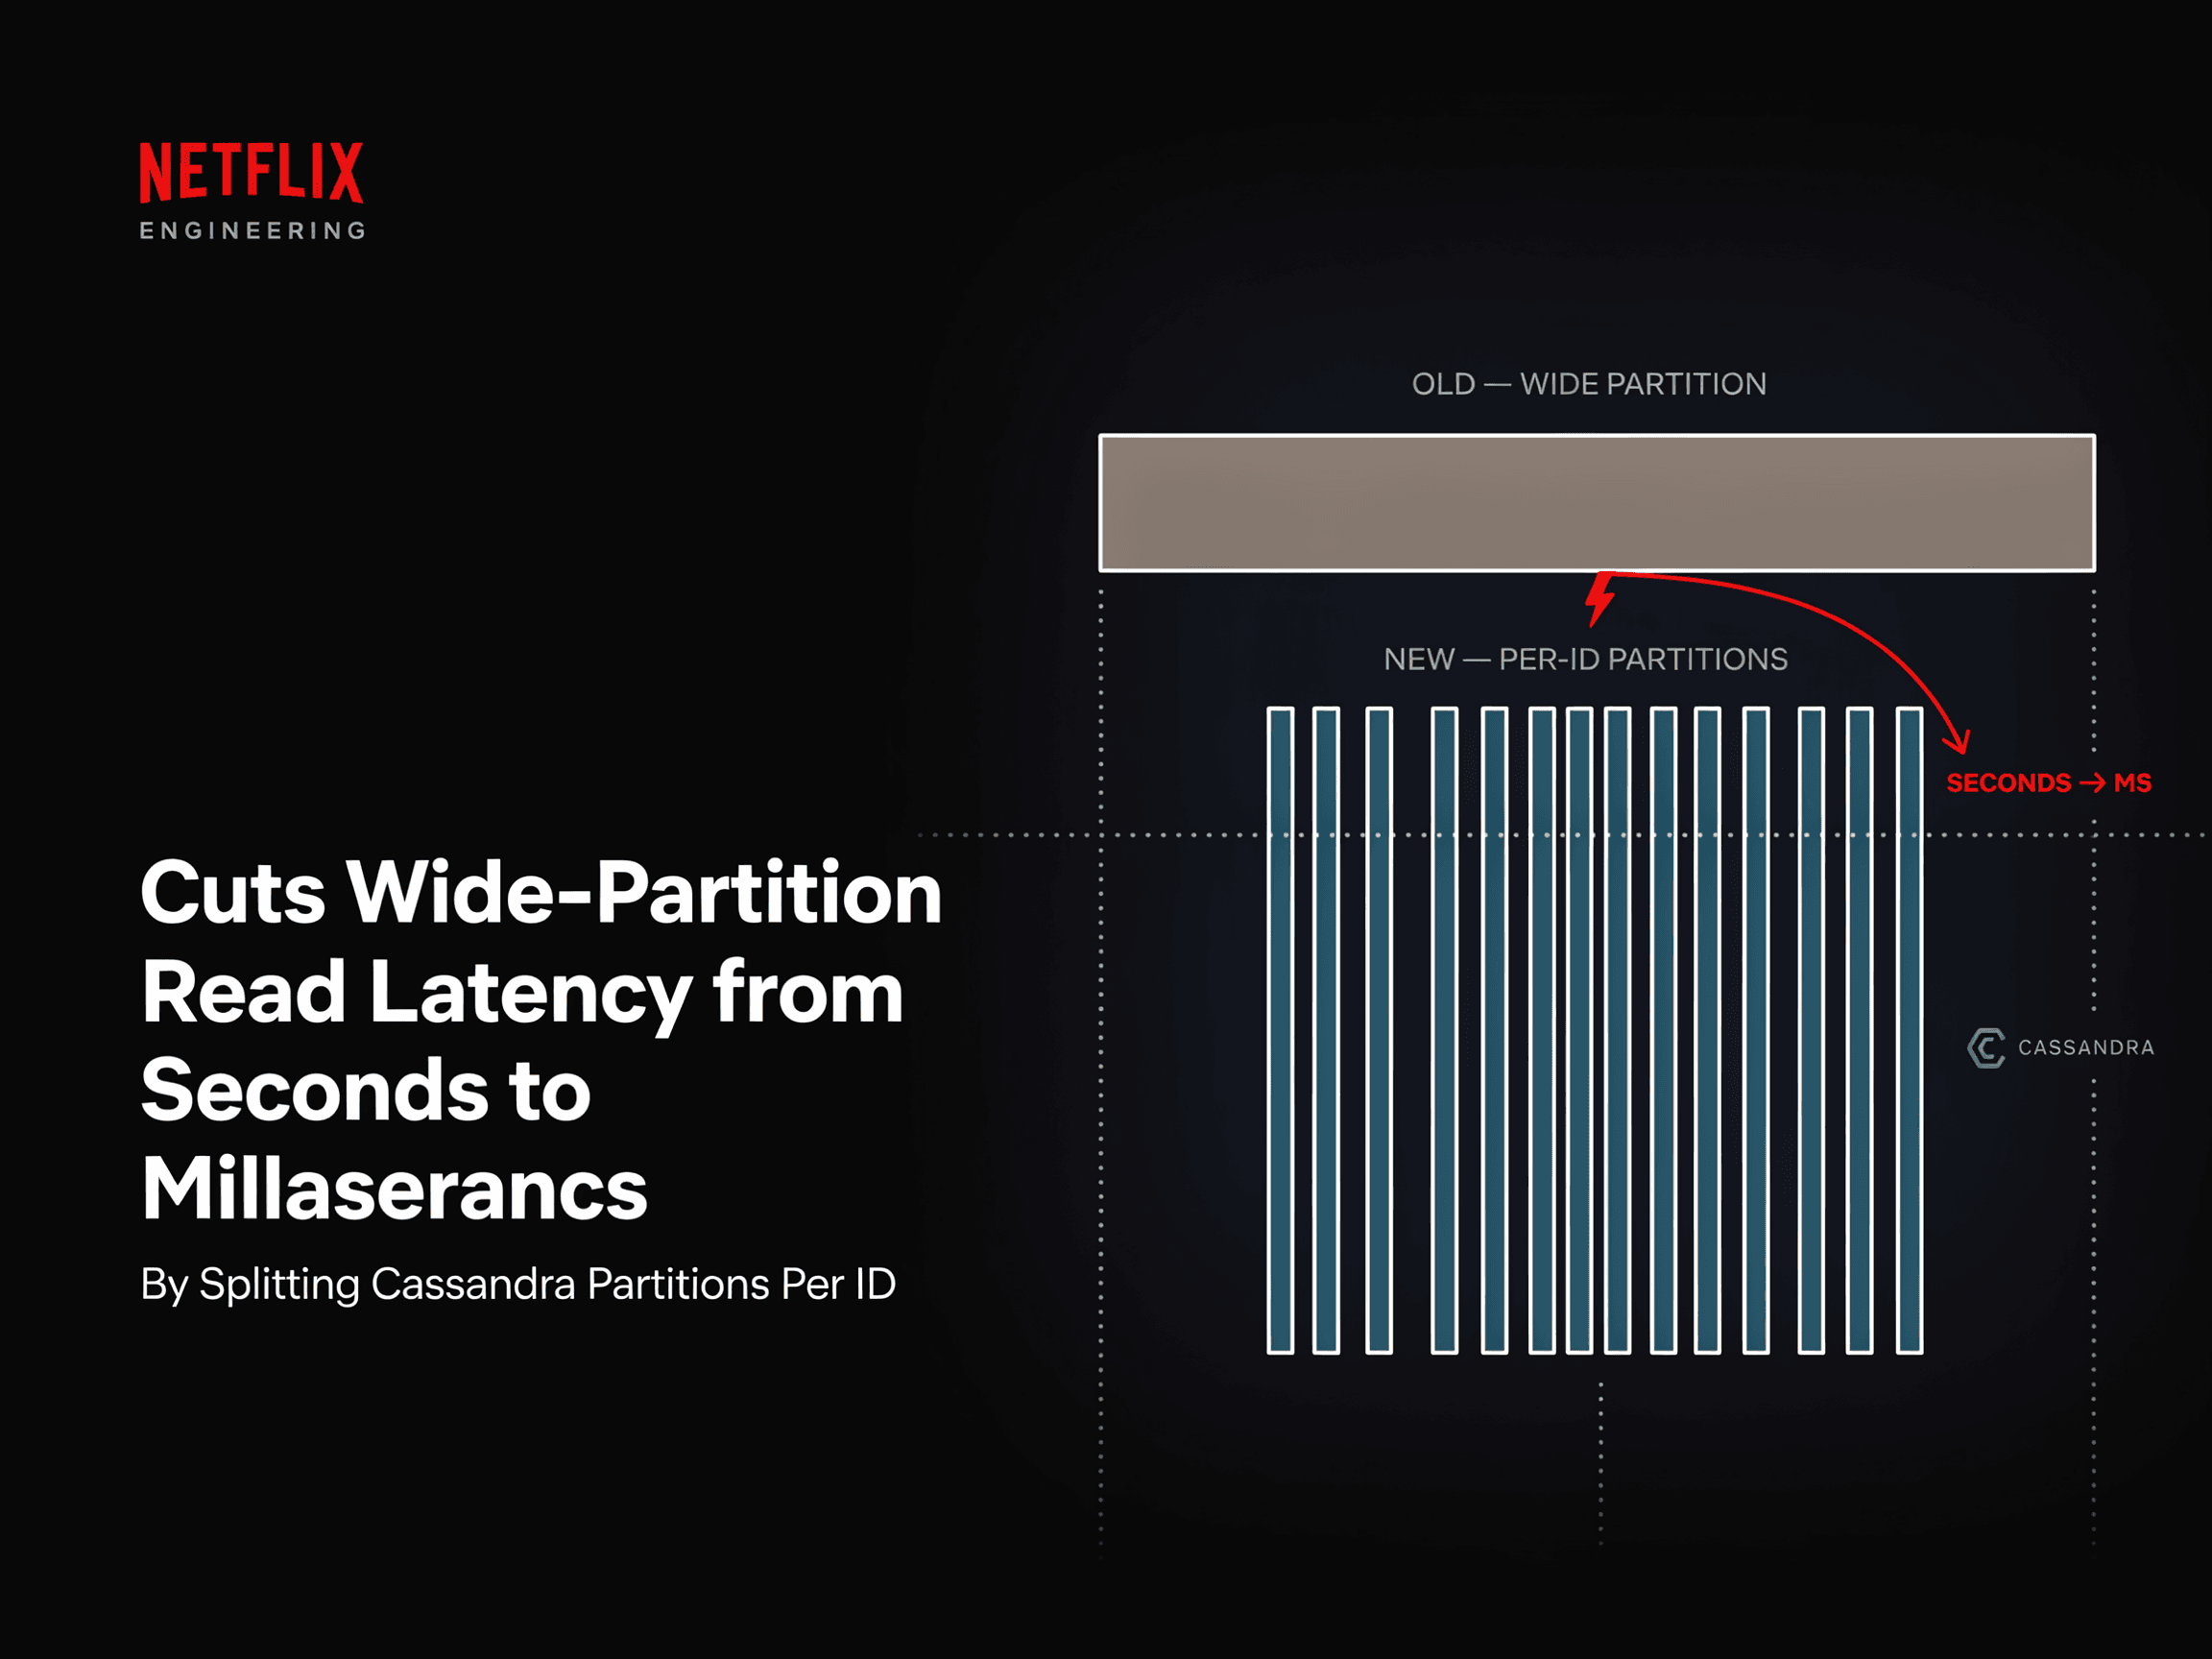
ทีมวิศวกรของ Netflix ได้เผยแพร่ a method for handling wide partitions in Apache Cassandra ซึ่งมุ่งเป้าไปที่การจัดการชุดข้อมูลเหตุการณ์เชิงเวลา (Time-series data) ขนาดใหญ่บนแพลตฟอร์ม
TL;DR
- Dynamic partitioning จะแบ่ง Cassandra partition ที่มีขนาดใหญ่เกินไป (Wide Partition) ตามราย TimeSeries ID แบบอะซิงโครนัส โดยไม่ต้องแก้ไขโค้ดแอปพลิเคชัน
- ระบบตรวจจับ ทำงานระหว่างขั้นตอนการอ่านข้อมูลผ่านการนับไบต์และเหตุการณ์ Kafka โดยเริ่มจัดการจาก Partition ที่ไม่มีการเขียนเพิ่มแล้ว (Immutable) เป็นอันดับแรก
- การใช้งาน ใช้ Bloom filters (ทำงานในระดับไมโครวินาที) ร่วมกับ Metadata
wide_rowที่แคชไว้ เพื่อส่งคำสั่งอ่านไปยัง Child Partition ที่เล็กลง - ความถูกต้อง มั่นใจได้ด้วยการใช้ Checksum, การเก็บข้อมูลเดิมไว้สำรอง, การตรวจสอบผ่าน Spark และการรันโหมด Shadow เพื่อเปรียบเทียบผลลัพธ์
- ประสิทธิภาพ ความเร็วการอ่านดีขึ้นอย่างก้าวกระโดดจากระดับวินาทีเหลือเพียงเลขสองหลักในหน่วยมิลลิวินาที และจัดการ Partition ขนาดใหญ่กว่า 500MB ได้อย่างไร้รอยต่อ
Dynamic Repartitioning คืออะไร?
ระบบ TimeSeries Abstraction ของ Netflix จัดเก็บข้อมูลเหตุการณ์เชิงเวลาขนาดหลายเพตาไบต์ โดยมี Apache Cassandra 4.x เป็นฐานข้อมูลหลัก เนื่องจากเด่นด้าน Throughput และ Latency ที่คุ้มค่าต่อต้นทุน โดยปกติข้อมูลจะถูกจัดกลุ่มเป็น Partition ตามรหัสระบุ (ID) และช่วงเวลา แต่เมื่อข้อมูลสะสมมากขึ้น Partition จะ "กว้าง" ขึ้นจนส่งผลเสีย Dynamic repartitioning จึงเข้ามาช่วยแบ่ง Partition ยักษ์เหล่านี้ให้เป็นส่วนย่อยที่เล็กลงแบบเบื้องหลัง ในขณะที่แอปพลิเคชันยังคงเรียกข้อมูลผ่าน Logical Partition เดิมได้ตามปกติแบบโปร่งใส
ทำไม Wide Partitions ถึงส่งผลเสียต่อการอ่าน
แม้ Latency เฉลี่ยจะอยู่ที่เลขหลักเดียวในหน่วยมิลลิวินาที แต่หากเจอ Wide Partition ค่า Tail latency อาจพุ่งสูงเป็นวินาที จนเกิด Read timeouts นำไปสู่ปัญหา Garbage Collection pauses, CPU พุ่งสูง และเกิด Thread queueing ในคลัสเตอร์ ซึ่งกระทบต่อเสถียรภาพโดยรวมของระบบ
กลยุทธ์การจัด Partition เบื้องหลัง TimeSeries
Netflix ย่อยข้อมูลเป็น Time Slices และ buckets ต่างๆ เพื่อให้ง่ายต่อการดึงข้อมูลและลบข้อมูลที่หมดอายุ โดยมีการใช้การจำลองแบบ Monte Carlo เพื่อเลือกโครงสร้าง Partition ที่เหมาะสม อย่างไรก็ตาม แนวทางนี้อาจล้มเหลวหากปริมาณงานเปลี่ยนไปจากที่คาดการณ์ หรือมีข้อมูลที่ผิดปกติ (Outliers) เช่น ID บางตัวได้รับข้อมูลมากกว่าปกติอย่างมาก ซึ่งทีมงานได้เสนอ 2 ทางออกหลัก
Solution 1: Time Slice Re-Partitioning
ใช้ API ของ Cassandra เช่น nodetool tablehistograms เพื่อตรวจสอบขนาด Partition ผ่านตารางเสมือน หากขนาดไม่ตรงตามเป้าหมาย (2–10 MiB) ระบบจะอัปเดตค่าความหนาแน่นสำหรับการจัดโซนข้อมูลใน อนาคต (Future Time Slices)
DynamicTimeSliceConfigWorker:
namespace: my_dataset_1
Observed: TimeSlices have p99 partitions below configured target of 10MB.
Proposed: time_bucket interval: 60s -> 604800s
วิธีนี้ช่วยลด Read amplification ได้ดีในระดับตาราง แต่ไม่สามารถช่วยกรณีที่มีเฉพาะบาง ID (Outliers) ที่มีขนาดใหญ่ผิดปกติได้
Solution 2: Dynamic Partitioning per ID
เป็นขั้นตอนที่ทำงานเจาะจงระดับ TimeSeries ID ประกอบด้วย 3 ส่วน:
- การตรวจจับ (Detection): ระหว่างการอ่านข้อมูล ระบบจะนับไบต์ หากเกินเกณฑ์จะส่งสัญญาณผ่าน Kafka
{
  "time_slice": "data_20260328",
  "time_series_id": "profileId:123",
  "time_bucket": 7,
  "event_bucket": 2,
  "immutable": true,
  "version": "0"
}-
การวางแผนและแบ่ง (Planning & Splitting): ระบบจะอ่านข้อมูลเดิมเพื่อสร้างแผนการแบ่งที่แม่นยำ พร้อมเก็บ metadata ลงในตาราง
wide_rowโดยมีการกระจายข้อมูลไปยัง Cassandra replicas อื่นๆ เพื่อช่วยแชร์โหลด -
การตรวจสอบ (Validating): ใช้ Checksum เปรียบเทียบก่อนและหลังแบ่ง ถ้าตรงกันจะทำเครื่องหมาย
COMPLETEDเพื่อเริ่มใช้งานจริง
ขั้นตอนการอ่าน: Bloom Filters และ Metadata Routing
เซิร์ฟเวอร์จะโหลด Partition-keys ที่แบ่งแล้วลงใน Bloom filters ในหน่วยความจำเพื่อให้ตรวจสอบได้รวดเร็วระดับไมโครวินาที หากพบข้อมูล (Hit) ระบบจะดึงแผนผังจาก metadata เพื่อส่งคำสั่งอ่านไปยัง Child Partition ที่เล็กลงทันที
{
  "pre_split_data": {
    "time_slice": "data_20260328",
    "time_series_id": "6313825",
    "time_bucket": 0,
    "event_bucket": 2
  },
  "post_split_data": {
    "time_slice": "wide_data_20260328_0",
    "event_bucket_partition_strategy": {
      "target_event_buckets": 2,
      "start_event_bucket": 32
    }
  }
}
การจัดเก็บต้นฉบับไว้เป็นตัวสำรอง (Fallback) ช่วยให้มั่นใจว่าระบบจะยังทำงานได้แม้เกิดปัญหาความสอดคล้องของข้อมูลในตอนแรก
Solution 1 vs Solution 2: การเปรียบเทียบ
| มิติการเปรียบเทียบ | Time Slice Re-Partitioning (Solution 1) | Dynamic Partitioning per ID (Solution 2) |
|---|---|---|
| ความละเอียด | ระดับตาราง / Time Slice | ระดับ Individual TimeSeries ID |
| ตัวจุดชนวน | ตรวจสอบจาก histogram อัตโนมัติ | จำนวนไบต์ที่อ่านเกินขีดจำกัด |
| ขอบเขตผลกระทบ | มีผลกับข้อมูลใหม่ในอนาคต | Partition เดิมที่กว้างเป็นพิเศษ |
| เหมาะสำหรับ | โครงสร้างพื้นฐานทั้งตารางผิดพลาด | มี ID บางส่วนที่เป็น Outliers |
| การเคลื่อนย้ายข้อมูล | ไม่มี; ปรับวิธีเขียนใหม่ | แบ่งข้อมูลเดิมแบบอะซิงโครนัส |
ผลลัพธ์จากการใช้งานจริง
Netflix พบว่า Latency เฉลี่ยลดจากหลักวินาทีเหลือเพียงเลขสองหลักในหน่วยมิลลิวินาที ส่วน Tail latency ลดลงเหลือเพียง 200 มิลลิวินาที ทำให้ระบบมีเสถียรภาพมากขึ้น ลดภาระ CPU และแก้ปัญหา Read timeouts ได้อย่างยั่งยืน
ตัวอย่างกรณีการดึงข้อมูลแบบ Page ที่เคยใช้เวลานานและล้มเหลวบ่อยครั้ง:
{
  "next_page_token": "...",
  "records": [ { "...": "..." } ],
  "response_context": [
    {
      "namespace": "...",
      "time_taken": "41.072410142s"
    }
  ]
}
ทีมงานเน้นย้ำว่าการค่อยๆ ปรับใช้อย่างเป็นลำดับ (Incremental) และการลงทุนในระบบตรวจสอบความถูกต้องนั้นคุ้มค่าอย่างยิ่งสำหรับระบบที่มีความซับซ้อนสูงเช่นนี้
ตรวจสอบรายละเอียดทางเทคนิคเพิ่มเติมได้ที่นี่ [Technical details here]
และกดติดตามพวกเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร