
NVIDIA เปิดตัว DGX Spark 64GB ขยายขีดจำกัดการพัฒนา Local AI
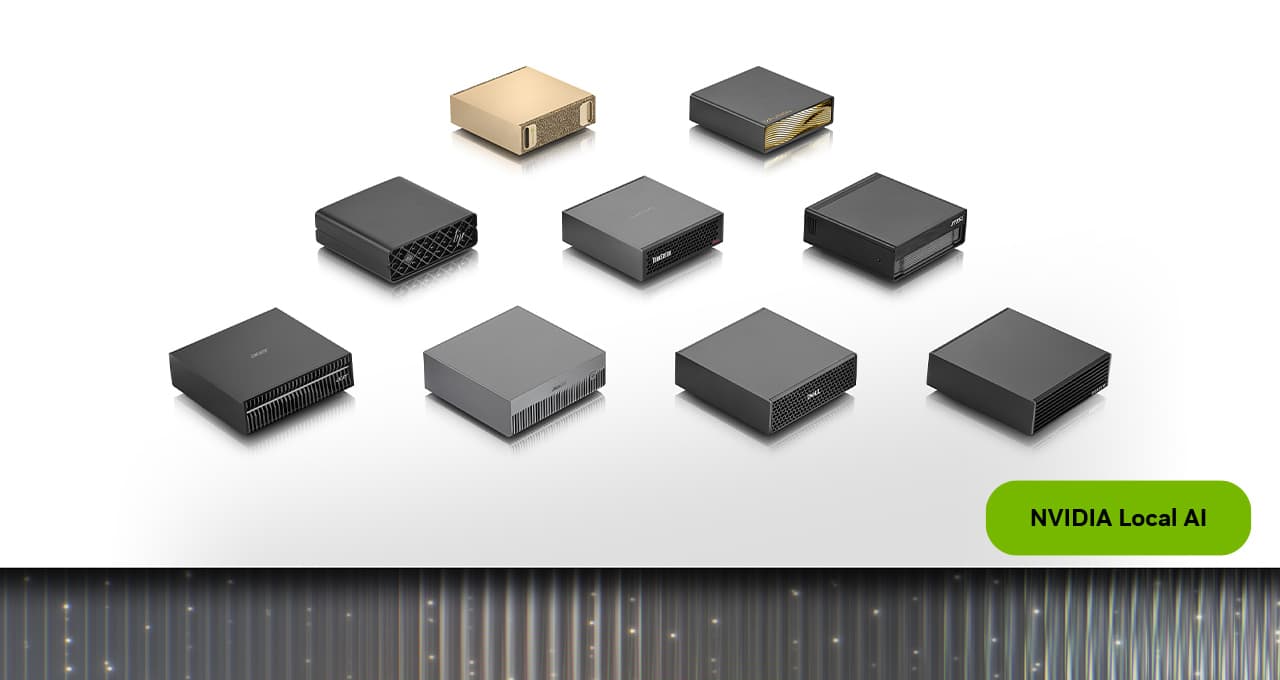
Local AI กำลังทวีความสำคัญมากขึ้นในทุกการประมวลผล (token) เมื่อ AI agents ขยับจากการทดลองไปสู่การพัฒนาที่ใช้งานจริงในชีวิตประจำวัน โมเดลแบบเปิด (Open Models) ที่มีความสามารถสูงขึ้นเรื่อยๆ กำลังถูกปรับขนาดให้เล็กลงเพื่อให้รองรับกับอุปกรณ์ที่หลากหลาย ช่วยให้นักสร้างสรรค์มีทรัพยากรสำหรับรันระบบเฉพาะที่ได้มีประสิทธิภาพยิ่งขึ้น
ภายในเดือนนี้ NVIDIA DGX Spark รุ่นหน่วยความจำแบบรวม (unified memory) ขนาด 64GB จะพร้อมวางจำหน่ายผ่านพันธมิตรผู้ผลิตชั้นนำอย่าง Acer, ASUS, Dell, Gigabyte, HP และ MSI โดยการกำหนดค่าใหม่นี้มาพร้อม DGX OS และชุดซอฟต์แวร์ NVIDIA AI ที่พร้อมใช้งานทันทีสำหรับนักพัฒนา นักวิจัย และผู้ที่ชื่นชอบ AI
SKU ใหม่นี้สามารถรัน AI Agent ประสิทธิภาพสูงบนอุปกรณ์ได้โดยตรงอย่างเป็นส่วนตัว โดยไม่ต้องพึ่งพาคลาวด์ และเมื่อภาระงานเพิ่มขึ้น ผู้ใช้สามารถนำเครื่องสองเครื่องมาเชื่อมต่อกันเป็นคลัสเตอร์ผ่าน NVIDIA Sync Cluster Assistant ได้อย่างง่ายดายโดยไม่ต้องตั้งค่าเพิ่มเติมใดๆ
จุดเริ่มต้นใหม่สำหรับ Personal AI Supercomputing
DGX Spark รวมการประมวลผล NVIDIA Grace Blackwell, หน่วยความจำแบบรวม, ระบบเครือข่าย NVIDIA ConnectX-7 และชุดซอฟต์แวร์ AI ที่เร่งความเร็วด้วย NVIDIA CUDA ไว้ในระบบเดียว เป็นแพลตฟอร์ม Local AI ที่สมบูรณ์แบบสำหรับการสร้างเอเจนต์, การอนุมาน (inference), การปรับจูน (fine-tuning) รวมถึงงานวิทยาศาสตร์ข้อมูล และการพัฒนาที่ขอบเครือข่าย (edge development)
ซูเปอร์คอมพิวเตอร์ AI ส่วนบุคคลขนาดกะทัดรัดนี้มอบพื้นที่ให้การทดลองกับโมเดลและข้อมูลส่วนตัวเป็นเรื่องง่าย โดยนักพัฒนาไม่จำเป็นต้องพึ่งพาอินสแตนซ์บนคลาวด์สำหรับทุกภาระงาน
การกำหนดค่า 64GB ใหม่ที่มีวางจำหน่ายผ่านพันธมิตร ช่วยให้แพลตฟอร์มอยู่ในระดับราคาที่เข้าถึงได้ง่ายขึ้น ในขณะที่ยังคงใช้ Superchip รุ่น GB10 Grace Blackwell และชุดซอฟต์แวร์ NVIDIA AI แบบเต็มรูปแบบเช่นเดียวกับรุ่น 128GB โดยรองรับโมเดลที่มีพารามิเตอร์สูงสุดถึง 1 แสนล้านพารามิเตอร์ รวมถึงแอปพลิเคชันแบบ Agentic ที่ทำงานบนอุปกรณ์ได้โดยตรง
การนำเครื่อง 64GB สองเครื่องมาทำคลัสเตอร์ไม่ได้เพียงแค่เพิ่มหน่วยความจำเท่าตัวเท่านั้น แต่จากการทดสอบ Qwen 3.8 27B ของ NVIDIA พบว่าระบบที่เชื่อมต่อกันให้ประสิทธิภาพสูงขึ้นถึง 1.7 เท่าเมื่อเทียบกับระบบเดียว ช่วยรองรับการขยายขนาดตามความต้องการของภาระงานที่เพิ่มขึ้น
DGX Spark พร้อมสำหรับการพัฒนาเอเจนต์ตั้งแต่วันแรก โดยรองรับ NVIDIA Agent Toolkit, ไลบรารี CUDA-X AI, โมเดลแบบเปิด Nemotron และรันไทม์ยอดนิยมอย่าง Ollama, vLLM และ PyTorch พร้อม CUDA นักพัฒนาจึงเริ่มรันโมเดลได้ภายในเวลาไม่กี่นาทีหลังจากเปิดเครื่อง
Blender เป็นหนึ่งในผู้ให้บริการแอปพลิเคชันสร้างสรรค์รายใหญ่รายแรกๆ ที่รองรับแพลตฟอร์มนี้ โดยจะมีการเปิดตัว ตัวติดตั้งที่สร้างไว้ล่วงหน้าและดาวน์โหลดได้ในเร็วๆ นี้
ขยายขนาดด้วย NVIDIA Sync Cluster Assistant
นักพัฒนาสามารถเริ่มต้นด้วยหน่วยความจำที่เหมาะสมกับโปรเจกต์ในปัจจุบัน และต่อยอดบนแพลตฟอร์มที่ออกแบบมาเพื่อขยายคลัสเตอร์แบบหลายโหนด (multi-node) ได้อย่างราบรื่นเมื่อสายการพัฒนาเติบโตขึ้นและต้องการรองรับภาระงานที่ใหญ่ขึ้น
DGX Spark ทุกเครื่องติดตั้ง NVIDIA ConnectX-7 NIC มาในตัว ซึ่งเครื่องสองเครื่องสามารถเชื่อมต่อโดยตรงด้วยสาย QSFP เพื่อรวมหน่วยความจำเป็น 128GB ช่วยขยายการรองรับโมเดลได้สูงสุดถึง 2 แสนล้านพารามิเตอร์ พร้อมแบนด์วิดท์หน่วยความจำที่เพิ่มขึ้นสองเท่า
แอป NVIDIA Sync จะทำหน้าที่กำหนดค่าคลัสเตอร์หลายโหนดนี้อย่างไร้รอยต่อ โดยฟีเจอร์ Cluster Assistant จะตรวจจับหน่วยที่เชื่อมต่อ ตรวจสอบการกำหนดค่า และตั้งค่าเครือข่าย ConnectX-7 ให้อัตโนมัติ เพื่อให้นักศึกษามุ่งเน้นไปที่งานวิจัยได้ทันทีโดยไม่ต้องกังวลเรื่องโครงสร้างพื้นฐาน
ในช่วงปลายเดือนนี้ NVIDIA Sync Model Launcher จะทำให้การรัน Local AI ง่ายขึ้นเพียงปลายนิ้วสัมผัส นักพัฒนาสามารถดาวน์โหลดและเริ่มใช้งาน Qwen3.8 27B บน DGX Spark ได้ทันที โดยระบบจะกำหนดค่าโมเดลและทำให้เข้าถึงได้จากแล็ปท็อปของผู้ใช้ พร้อมติดตั้ง OpenCode เพื่อเริ่มเขียนโค้ดผ่านเบราว์เซอร์ได้ทันที
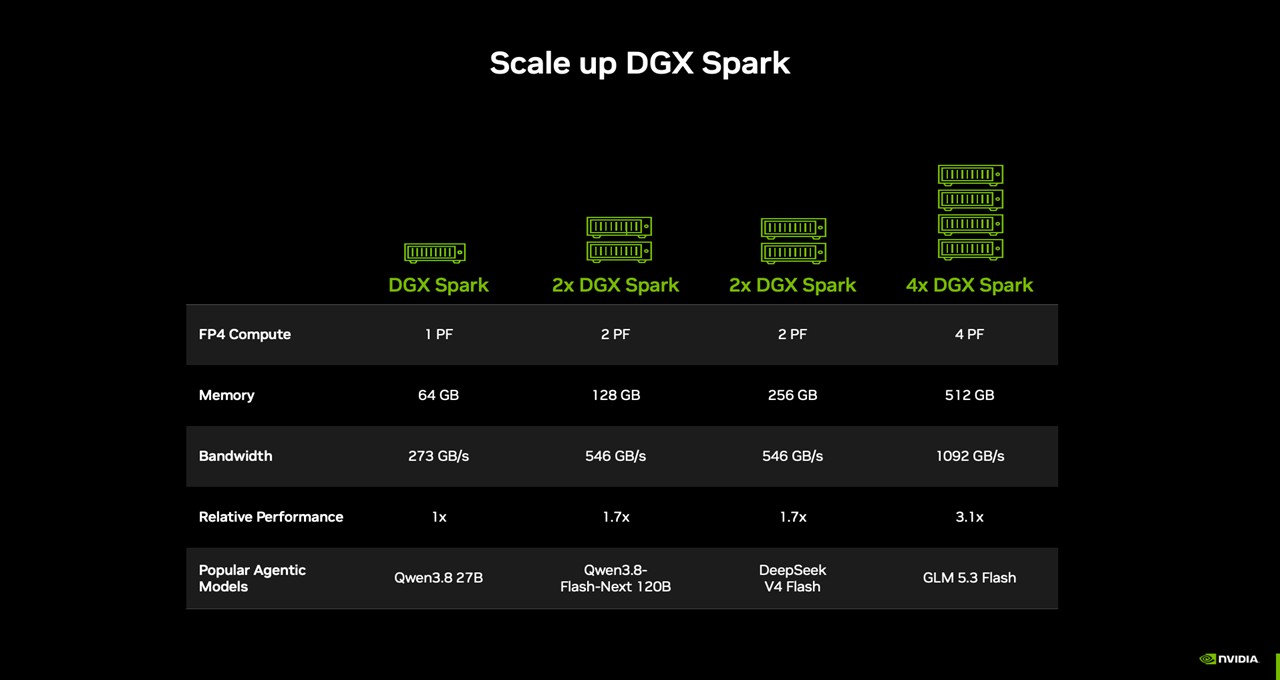
กรณีการใช้งานของนักพัฒนาบน DGX Spark
การกำหนดค่า DGX Spark 64GB ใหม่รองรับงานที่ใช้งานได้จริงตั้งแต่วันแรก ด้วยโมเดลพารามิเตอร์สูงสุด 1 แสนล้านพารามิเตอร์ที่รันบนอุปกรณ์ทั้งหมด โดยมีตัวอย่างเวิร์กโฟลว์ 3 รูปแบบ ดังนี้:
- รัน AI agent ตลอด 24 ชั่วโมง: มอบหมายให้เอเจนต์เขียนโค้ดหรือทำงานวิจัยบน DGX Spark ได้ต่อเนื่อง เพื่อตรวจสอบโค้ดหรือวิเคราะห์เอกสารแบบหลายขั้นตอน โดยคลัสเตอร์จะช่วยรองรับโมเดลขนาดใหญ่ขึ้นและหน้าต่างบริบท (context window) ที่ยาวขึ้นได้
- ขับเคลื่อนแอป AI บน PC ในชีวิตประจำวัน: ใช้ DGX Spark จัดการการอนุมานโมเดลภาษาหรือโมเดลสร้างภาพ ในขณะที่ใช้แล็ปท็อปหรือเดสก์ท็อปทำงานอื่นๆ ได้อย่างลื่นไหล
- ขยายขนาดเมื่อภาระงานเพิ่มขึ้น: หากภาระงานมีขนาดเกินกว่าหนึ่งเครื่อง ระบบ 64GB สองเครื่องที่เชื่อมต่อผ่านแฟบริค 200 GbE จะรวมหน่วยความจำเข้าด้วยกันเป็น 128GB ช่วยให้ย้ายเวิร์กโฟลว์เดิมไปยังระบบที่ใหญ่ขึ้นได้โดยไม่ต้องกำหนดค่าซอฟต์แวร์ใหม่
เริ่มต้นใช้งาน DGX Spark
DGX Spark 64GB พร้อมวางจำหน่ายผ่าน Acer, ASUS, Dell, Gigabyte, HP และ MSI ในวันศุกร์ที่ 23 ตุลาคม นี้ โดยราคาเริ่มต้นที่ 4,999 ดอลลาร์
สำหรับผู้ที่เริ่มต้นใช้งาน:
- ดาวน์โหลดเฟรมเวิร์กการอนุมานที่รองรับ เช่น llama.cpp, Ollama, vLLM หรือ LM Studio
- ดาวน์โหลดโมเดลเฉพาะที่แนะนำสำหรับเวิร์กโฟลว์ของคุณ
- หากต้องการขยายเป็นสองเครื่อง ให้เชื่อมต่อผ่านพอร์ต NVIDIA ConnectX-7 และเปิดใช้งาน NVIDIA Sync Cluster Assistant เพื่อตั้งค่าเครือข่ายโดยอัตโนมัติ
ผู้สนใจสามารถศึกษาคู่มือการใช้งาน (playbooks) สำหรับ Agentic AI ได้ที่หน้า the NemoClaw, OpenClaw, Hermes Agent และ OpenShell บน build.nvidia.com
อัปเดตเพิ่มเติมจาก NVIDIA Local AI
นอกจากคู่มือบน build.nvidia.com/spark แล้ว ยังมีอัปเดตสำหรับอุปกรณ์ 64GB ที่กำลังจะตามมาเร็วๆ นี้ ได้แก่ การให้บริการ LLM ด้วย vLLM, การรัน OpenClaw และการเชื่อมต่อหลายเครื่องสำหรับภาระงานแบบกระจาย (Distributed Workloads)
นอกจากนี้ Windows PC รุ่นใหม่ที่ขับเคลื่อนโดย NVIDIA RTX Spark จะเริ่มทยอยเปิดตัวจากพันธมิตรในเดือนนี้ ผู้สนใจสามารถลงทะเบียนรับ จดหมายข่าว RTX Spark เพื่อติดตามความคืบหน้า
ปิดท้ายด้วย Qwen-Image-2.1 จาก Alibaba ที่รวมการสร้างและแก้ไขภาพไว้ในโมเดลแบบเปิดน้ำหนักเบา โดยรองรับการรันแบบเฉพาะที่บน NVIDIA RTX GPU และ DGX Spark ช่วยให้ครีเอเตอร์ทำงานสร้างสรรค์บนฮาร์ดแวร์ของตนเองได้เต็มที่
ติดตาม NVIDIA RTX Spark ได้ที่ X, Instagram, TikTok และ Facebook * - และรับข้อมูลข่าวสารโดยสมัคร* จดหมายข่าว NVIDIA Local AI* ติดตาม NVIDIA Workstation ได้ที่* LinkedIn และ X*
ดู ประกาศ เกี่ยวกับข้อมูลผลิตภัณฑ์ซอฟต์แวร์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร