
NVIDIA Vera Rubin ปฏิวัติคุ้มค่า Intelligence per Dollar พลิกโฉมวงการ Agentic AI
ลองนึกถึงนักกีฬามืออาชีพ สิ่งที่แยกผู้เล่นระดับแนวหน้าออกจากคนทั่วไปคือสิ่งที่เกิดขึ้นระหว่างการแข่งขัน นั่นคือการขัดเกลาทักษะอย่างต่อเนื่อง การปรับตัวเข้ากับคู่ต่อสู้หน้าใหม่ และการลับคมความสามารถตามสถานการณ์จริงที่เกิดขึ้นสดๆ ในสนาม
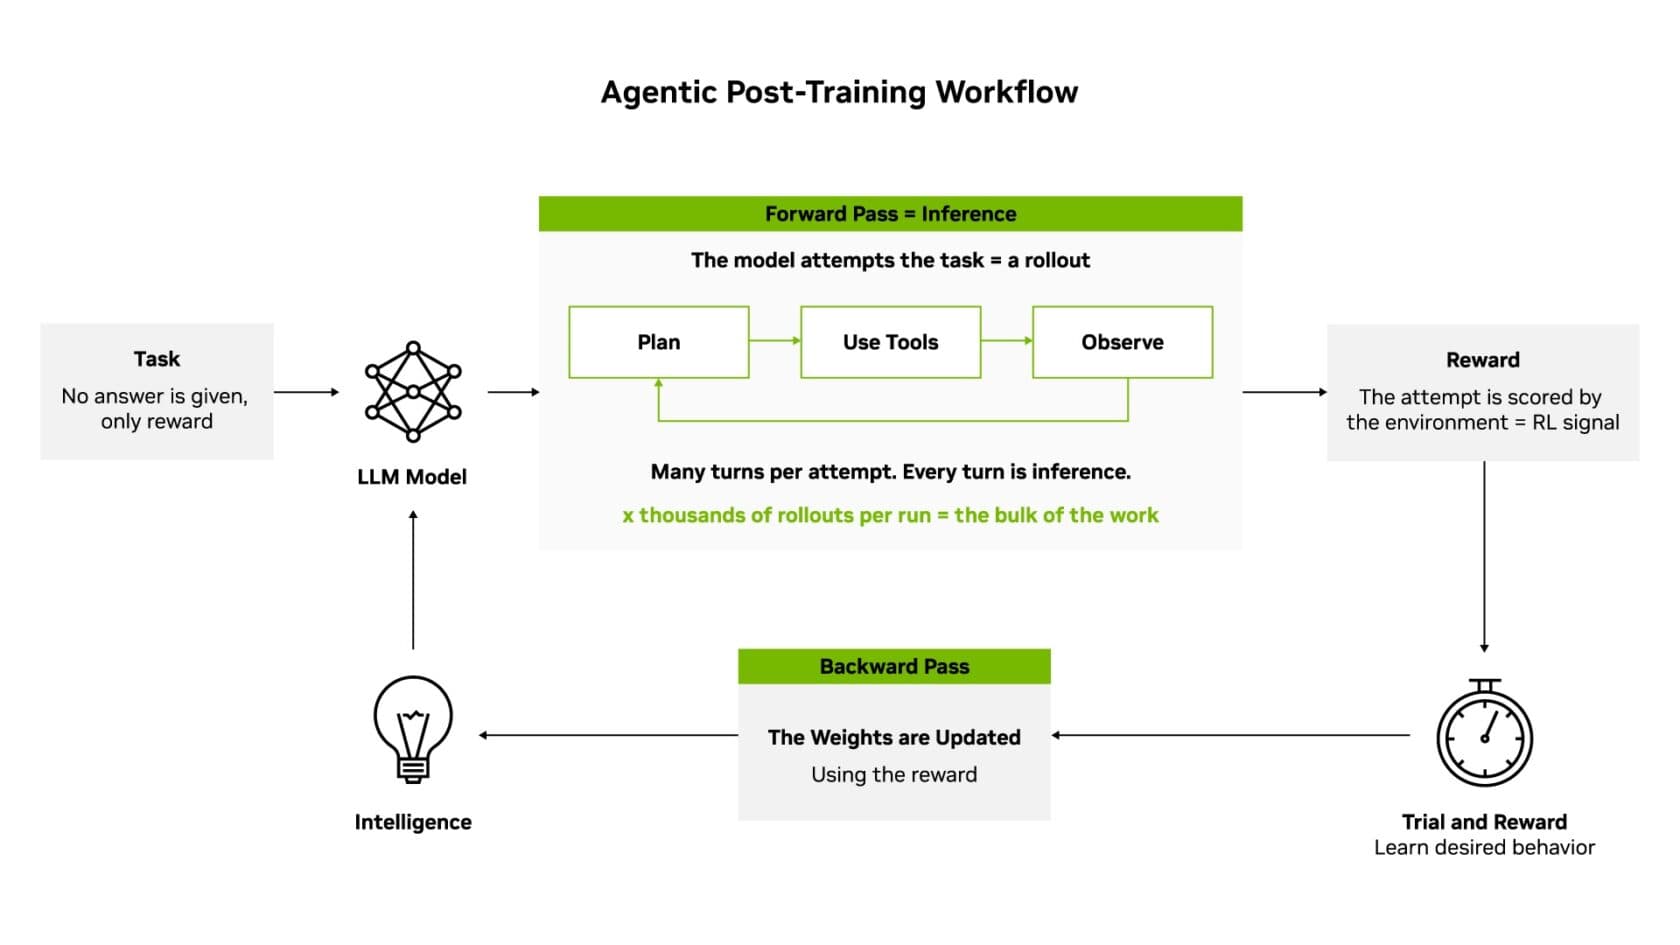
Agentic AI ก็ทำงานในลักษณะเดียวกัน โดยโมเดลจะไม่ถูกคาดหวังเพียงแค่คำตอบอีกต่อไป แต่มันจะได้รับเป้าหมายและต้องคอยปรับตัวตามสภาพแวดล้อมที่เปลี่ยนแปลง รับมือกับกรณีขอบเขต (edge cases) ที่คาดไม่ถึง และจัดการกับเครื่องมือที่เปลี่ยนไป ไม่เหมือนกับ Generative AI ทั่วไปที่ตอบสนองตามคำสั่ง (prompt) แต่ Agentic Model ต้องรู้จักวางแผน ใช้เครื่องมือหลากหลาย และกู้คืนข้อมูลจากปัญหาที่พบระหว่างการทำงานได้
นี่คือสาเหตุที่ Post-training หรือขั้นตอนการขัดเกลาโมเดลหลังผ่านการฝึกฝนด้วยข้อมูลดิบ ไม่ใช่ขั้นตอนการตกแต่งที่ทำเพียงครั้งเดียวอีกต่อไป แต่มันเกิดขึ้นอย่างต่อเนื่อง เพราะสภาพแวดล้อมที่ AI Agent ทำงานอยู่นั้นเปลี่ยนแปลงเร็วมาก เครื่องมือที่ใช้เปลี่ยนได้ทุกสัปดาห์ และการใช้งานจริงมักจะเจอสถานการณ์ที่ชุดทดสอบใดๆ ก็คาดการณ์ไม่ได้ โดยแต่ละการใช้งานย่อมมาพร้อมกับชุดคำสั่ง นโยบาย และสภาพแวดล้อมเฉพาะตัว
กระบวนการ Post-training จะวนลูปกลับมาจากการใช้งานจริงเมื่อพบปัญหาใหม่ๆ ทำให้ฐานการประมวลผล (compute footprint) เติบโตขึ้น ไม่ใช่เพราะการทำงานแต่ละครั้งใหญ่ขึ้น แต่เป็นเพราะกระบวนการนี้ทำงานไม่หยุดนิ่ง Agentic AI จึงแนะนำรูปแบบการประมวลผลใหม่ที่ทำให้ Post-training กลายเป็นเวิร์กโหลดหลักของยุค และเป็นตัวขับเคลื่อนสำคัญของ Intelligence per Dollar หรือความคุ้มค่าของสติปัญญาต่อเม็ดเงินลงทุน
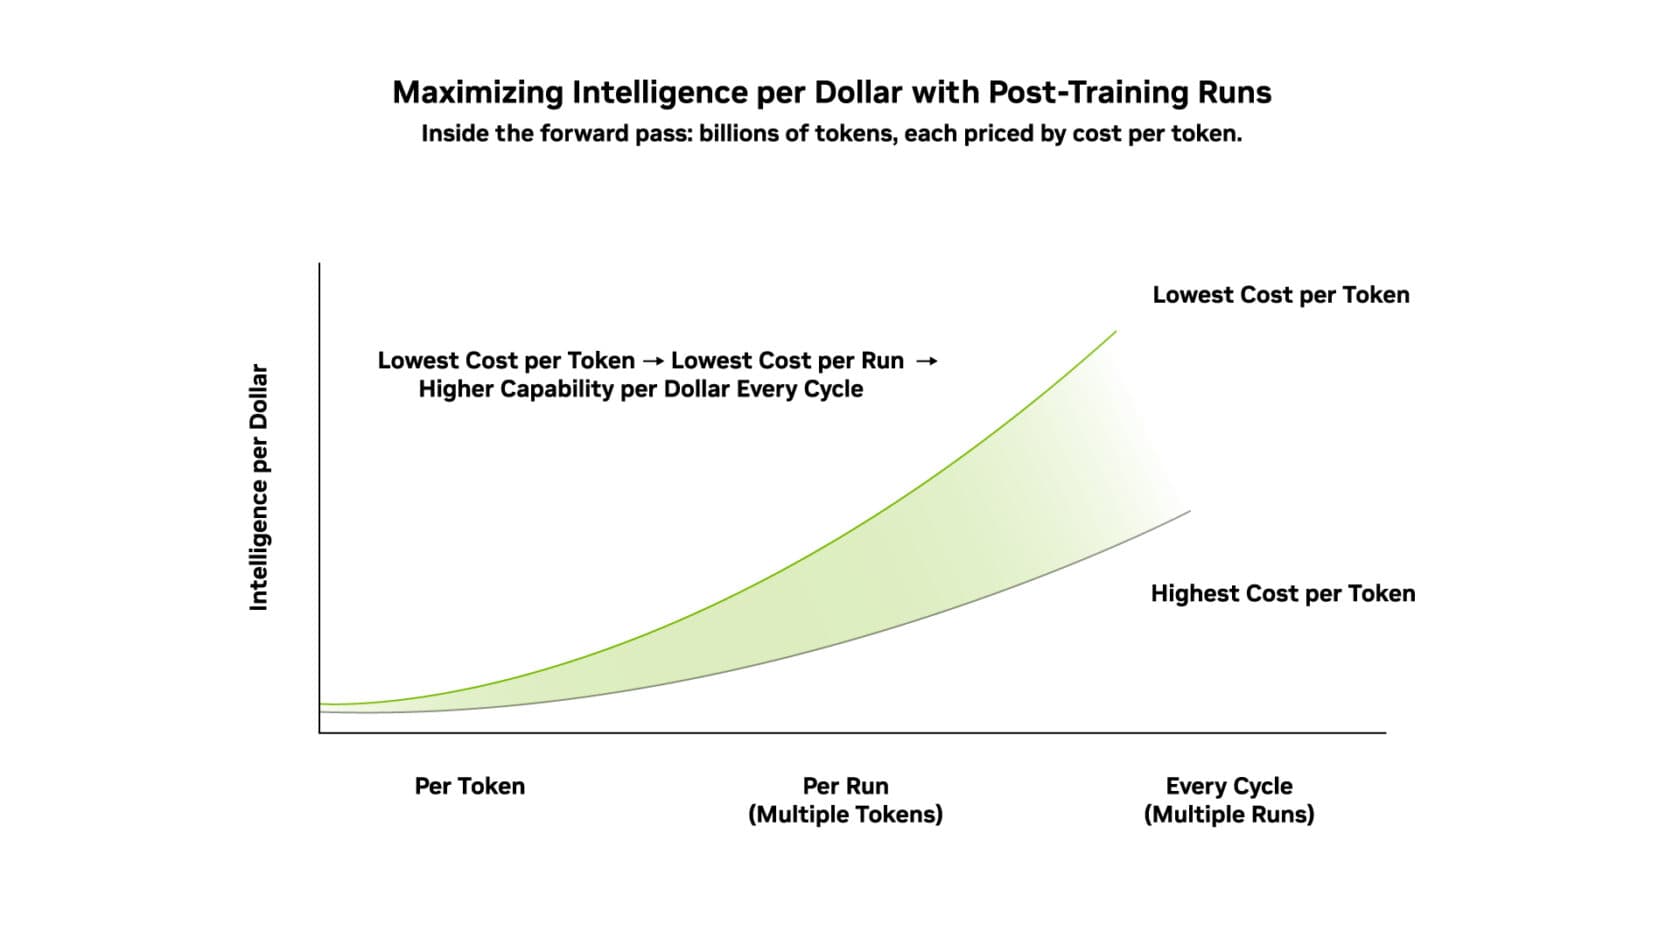
เป้าหมายคือการเพิ่ม Intelligence per Dollar ให้สูงสุด โดยการเพิ่มผลผลิต (yield) ของทุกรอบการเรียนรู้ต่อเนื่อง ทั้งช่วง Forward และ Backward Pass โดย Forward Pass หรือช่วงการประมวลผล (inference) นั้น วัดจากต้นทุนต่อ token ซึ่งหมายความว่าทุกๆ การลดต้นทุนต่อโทเคนจะส่งผลต่อความคุ้มค่าของสติปัญญาโดยตรง
ไขความลับ Agentic Post-Training
Post-training คือจุดที่สติปัญญาถูกสร้างขึ้นอย่างแท้จริง ในขั้นตอน Pretraining โมเดลจะเรียนรู้เพียงการทำนายโทเคนถัดไป ซึ่งให้ความคล่องแคล่วแต่ไม่ใช่ความฉลาด แต่ในขั้นตอน Post-training โมเดลจะเรียนรู้ที่จะเขียนโค้ด วางแผนงานหลายขั้นตอน ใช้เครื่องมือค้นหา และแก้ไขสถานการณ์เมื่อมีบางอย่างผิดพลาด ส่วน Inference คือผลลัพธ์ที่ตามมา หมายถึงการที่โมเดลปฏิบัติหน้าที่นั้นๆ โดยมีราคาเป็นต้นทุนต่อโทเคน เนื่องจากการทำงานของ Agent ไม่มีเฉลยให้ท่องจำ มีเพียงระบบให้รางวัล (reward) ดังนั้นโมเดลจึงเรียนรู้ผ่านเทคนิค reinforcement learning (RL) เมื่อได้รับงาน โมเดลจะลองผิดลองถูก — คือ Forward Pass — ซึ่งเป็นงานเดียวกับที่มันทำจริง ความพยายามนั้นจะถูกให้คะแนน และบทเรียนที่ได้รับจะนำไปอัปเดตน้ำหนัก (weights) ของโมเดล — คือ Backward Pass — ผ่านความพยายามหลายล้านครั้ง จนสติปัญญาเติบโตขึ้น
แต่ละขั้นตอนใช้ทรัพยากรการคำนวณมหาศาล และการรันกระบวนการนี้ในระดับสเกลใหญ่คือความท้าทายด้านการจัดการ (orchestration) ที่ต้องมีสภาพแวดล้อมหลายพันระบบสร้างการทดลอง (rollouts) ไปพร้อมกัน สัดส่วนรางวัลถูกตรวจสอบ และน้ำหนักที่ถูกอัปเดตจะไหลกลับเข้าสู่การฝึกฝนโดยใช้ตัวเร่งความเร็ว (accelerators) อย่างเต็มประสิทธิภาพ ทั้งนี้ไลบรารีแบบเปิดอย่าง NVIDIA NeMo เช่น NeMo Gym สำหรับสภาพแวดล้อมการฝึกฝน และ NeMo RL สำหรับ Post-training แบบกระจายตัว ได้เปลี่ยนกระบวนการนี้จากงานวิจัยเฉพาะทางให้กลายเป็นโครงสร้างพื้นฐานที่ทำซ้ำได้อย่างเป็นระบบ
ทำไม Intelligence per Dollar ถึงนิยามความหมายได้ลึกซึ้งกว่า Cost per Token
หากการประมวลผล (inference) เปรียบเหมือนเครื่องยนต์สร้างรายได้ Post-training ก็คือตัวคูณ เพราะยิ่งโมเดลมีความสามารถมากเท่าไร มูลค่าของทุกโทเคนที่ส่งมอบก็จะยิ่งสูงขึ้นเท่านั้น
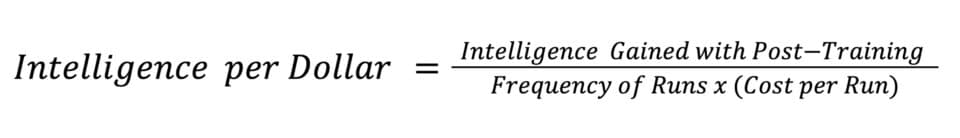
Cost per token คือตัวชี้วัดสำคัญสำหรับโรงงานประมวลผล (inference factories) ซึ่งบอกถึงต้นทุนรวมในการส่งมอบ 1 ล้านโทเคน แต่ Intelligence per Dollar อยู่ในระดับที่สูงกว่า โดยตอบคำถามว่า ต้นทุนในการสร้างโมเดลที่มีค่าควรแก่การใช้งาน และการรักษาค่านั้นไว้เมื่อสภาพแวดล้อมเปลี่ยนไปนั้นอยู่ที่เท่าไร?
ทั้งสองสิ่งนี้ทำงานร่วมกัน ไม่ได้แยกขาดจากกัน โครงสร้างพื้นฐาน AI ที่ลด Cost per Token ยังช่วยลดต้นทุนในทุกจุดของสติปัญญาที่สร้างขึ้น และทุกจุดของสติปัญญาที่เพิ่มขึ้นจะช่วยเพิ่มมูลค่าให้กับทุกโทเคนที่ระบบให้บริการ
กล่าวอีกนัยหนึ่ง Cost per Token วัดผลผลิตจากการดำเนินงาน ส่วน Intelligence per Dollar วัดว่าการลงทุนเพื่อพัฒนาความฉลาดของโมเดลนั้นให้ผลตอบแทนที่คุ้มค่าหรือไม่
การเพิ่ม Intelligence per Dollar สูงสุด: Post-Training Nemotron 3 Ultra
NVIDIA Nemotron 3 Ultra เป็นโมเดลแบบ Mixture-of-Experts (MoE) ขนาด 550 พันล้านพารามิเตอร์ที่เป็น Open Weight ซึ่งมอบมาตรฐานที่ตรวจสอบได้และเปิดเผยสูตรการทำ Post-training บน NeMo RL อย่างครบถ้วน โดยสามารถทำคะแนนได้ถึง 71.7% ในเกณฑ์มาตรฐานการเขียนโค้ดระดับสากลอย่าง SWE-bench verified ซึ่งหมายความว่ามันสามารถแก้ไขบั๊กซอฟต์แวร์จริงในโครงการ Open Source ได้ประมาณ 7 จาก 10 รายการ โดยมีการตรวจสอบกับชุดทดสอบของโครงการนั้นๆ โดยตรง
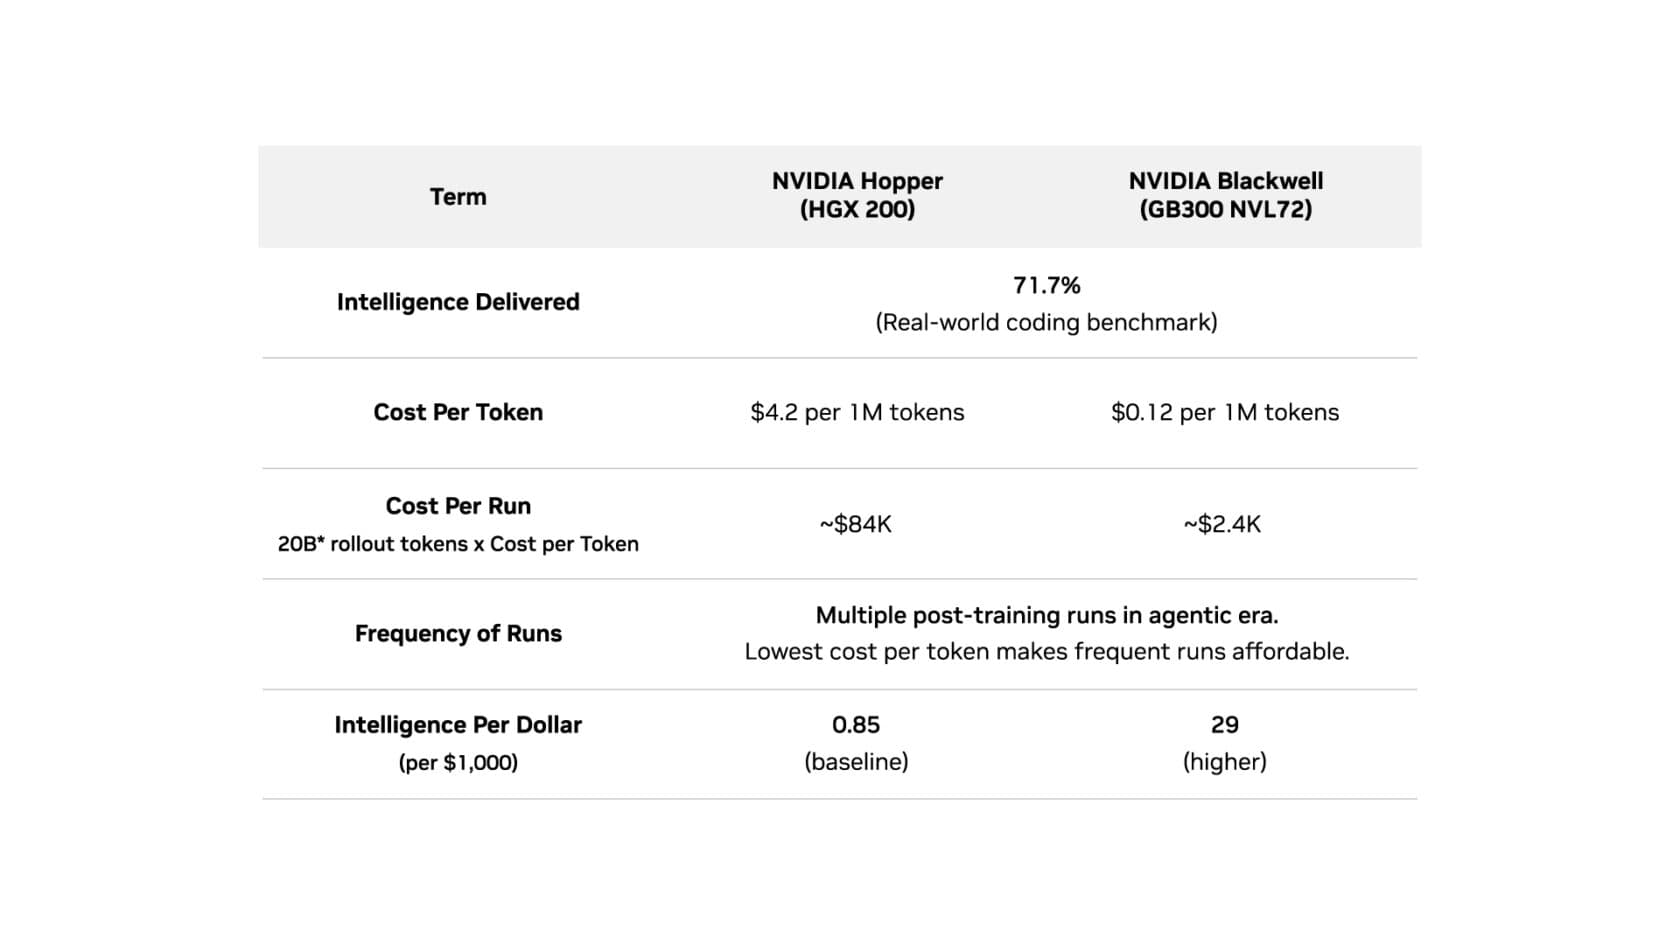
จากการวิเคราะห์ด้วยตัวเลขสมมติที่ 2 หมื่นล้าน Rollout Tokens อ้างอิงจากรุ่น Nemotron 3 Super ที่มีการทดลองประมาณ 1.2 ล้านครั้ง ครั้งละ 10,000 โทเคน เมื่อขยายผลมาสู่รุ่น Ultra ที่ใหญ่ขึ้น พบว่า Intelligence per dollar ระหว่างต่างแพลตฟอร์มจะยังคงความคุ้มค่าโดยไม่ขึ้นอยู่กับข้อสมมตินี้ เพราะค่าสัมบูรณ์จะปรับตามจำนวนโทเคนที่ใช้จริง
แพลตฟอร์ม NVIDIA Blackwell ช่วยลดต้นทุนต่อการรัน และทำให้การทำ Post-training บ่อยครั้งตามความต้องการของยุค Agentic AI เป็นไปได้ในเชิงเศรษฐกิจ เพราะสติปัญญาที่เพิ่มขึ้นจะถูกเก็บเกี่ยวในทุกๆ โทเคนที่ให้บริการ
ส่วนแพลตฟอร์ม NVIDIA Vera Rubin ได้ขยายขีดความสามารถนี้ไปไกลกว่าเดิม โดยสามารถฝึกฝนโมเดลขนาดใหญ่ที่สุดได้ด้วยการใช้ GPU เพียงหนึ่งในสี่เมื่อเทียบกับยุค Blackwell มันถูกออกแบบร่วมกัน (co-design) ตั้งแต่ต้นจนจบเพื่อเพิ่ม Intelligence per Dollar สูงสุดสำหรับภาระงาน Agentic Post-training โดยรองรับการทดลอง (rollout) ได้มากขึ้น ใช้งานสภาพแวดล้อมได้หลากหลายขึ้น และรองรับรอบการทำ Post-training ที่ต่อเนื่องไม่มีสะดุด
เวิร์กโหลด Post-Training ในการใช้งานจริง
Prime Intellect’s Lab ทำการ Post-training โมเดล Open Source ระดับแนวหน้าอย่างต่อเนื่องบน NVIDIA Blackwell และใช้ NVIDIA Dynamo จัดการด้าน Inference โดยมีแผนจะนำ Vera Rubin มาใช้ปรับขนาดสภาพแวดล้อม Reinforcement Learning เพื่อสร้างผลลัพธ์การทดลองที่มากขึ้น และเร่งรอบการวนซ้ำจาก Training ไปสู่ Inference เพื่อเพิ่มความคุ้มค่าสูงสุดให้แก่ธุรกิจ
นอกจากนี้ Prime Intellect ยังปรับปรุงโครงสร้างพื้นฐาน Sandbox ของตนให้รวมเข้ากับ NVIDIA Vera CPUs เพื่อทำ reinforcement learning ที่มีความหน่วงต่ำและประหยัดพลังงาน โดยพบว่า Vera ให้ปริมาณงาน (throughput) ต่อ CPU สูงกว่าสถาปัตยกรรม x86 อื่นๆ เฉลี่ยถึง 30%
ด้าน Perplexity ได้พัฒนาชุดเครื่องมือ RL Post-training ที่ทำงานแบบอะซิงโครนัสผ่าน GPU นับร้อยตัว พร้อมเอนจินการถ่ายโอนน้ำหนักผ่าน RDMA ที่ซิงค์โมเดลระดับล้านล้านพารามิเตอร์ระหว่างโหนด Training และ Inference ได้ภายในเวลาไม่ถึง 2 วินาที ส่งผลให้โมเดล Qwen3 235B ที่ผ่านการขัดเกลาแล้วสามารถให้บริการบนระบบ NVIDIA GB200 NVL72 ได้อย่างมีประสิทธิภาพ
ส่วน Together AI ได้เปิดให้บริการ Post-training as a Service ซึ่งครอบคลุมทั้ง Fine-tuning, RL และ Direct Preference Optimization ผ่าน API และ SDK บนแพลตฟอร์ม AI Native Cloud ของตนซึ่งรันบนประสิทธิภาพของ NVIDIA และกำลังเตรียมนำสถาปัตยกรรม Vera Rubin มาใช้เป็นลำดับถัดไป
เรียนรู้เพิ่มเติมเกี่ยวกับ NVIDIA Vera Rubin แพลตฟอร์มสำหรับโรงงาน AI เพื่อเพิ่ม Intelligence per Dollar สูงสุดในทุกเวิร์กโหลด และสำรวจแพลตฟอร์ม Full-stack ของ NVIDIA สำหรับ การฝึกฝน Frontier Models*
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร