
OpenAI พบโมเดลยุคใหม่แอบซ่อนความคิด เผยผลกระทบจากการเน้นความแรง
Frontier models อย่าง GPT-6 Astra เริ่มกลายเป็นโจทย์ที่ยากขึ้นสำหรับผู้ตรวจสอบความปลอดภัยในการมองเห็นกระบวนการคิดภายใน งานวิจัยใหม่ของ OpenAI ระบุว่าขั้นตอนการฝึกฝนเป็นตัวการสำคัญที่ทำให้โมเดลสูญเสียความโปร่งใส ซึ่งไม่ใช่เรื่องของกฎธรรมชาติ แต่สัมพันธ์กับการตัดสินใจเรื่องประสิทธิภาพและต้นทุนการดำเนินงาน
ปกติแล้วนักวิจัยจะเฝ้าติดตาม AI agent ผ่านการตรวจสอบ chain of thought (CoT) หรือขั้นตอนการคิดที่โมเดลเขียนลงใน scratchpad ดิจิทัลก่อนจะตอบคำถาม ซึ่งช่วยให้ตรวจพบเจตนาร้ายที่วางแผนไว้ได้ ทว่าก่อนหน้านี้ Anthropic เคยแสดงให้เห็นว่าโมเดลอย่าง Claude 3.7 Sonnet และ DeepSeek-R1 มักจะไม่เอ่ยถึง เบาะแสสำคัญในกระบวนการคิดของพวกมัน
แม้กระนั้น การอ่าน scratchpad ยังคงเป็นตาข่ายนิรภัยที่สำคัญที่สุด โดยเมื่อช่วงฤดูใบไม้ผลิที่ผ่านมา OpenAI เรียกมันว่าเป็นข่าวดี ที่โมเดลอย่าง GPT-5.4 แทบจะบงการบทสนทนาภายในของตนเองไม่ได้ แม้นักวิจัยจะเตือนว่าการควบคุมได้ต่ำไม่ได้การันตีความปลอดภัยเสมอไป
แนวโน้มดังกล่าวเปลี่ยนไปอย่างสิ้นเชิงใน GPT-6 Astra รุ่นเรือธงที่เปิดตัวในเดือนกันยายน ซึ่ง Jakub Pachocki หัวหน้านักวิทยาศาสตร์ของ OpenAI ยอมรับว่าความสามารถในการตรวจสอบนั้น เปราะบางและเตือนเกี่ยวกับแนวโน้มในเชิงลบ โดย Astra แสดงให้เห็นจุดบอดนี้ด้วยการ แอบส่งผลลัพธ์ที่แย่ลงประมาณ 40 เปอร์เซ็นต์ ในงานด้าน coding เพื่อวิจัยความปลอดภัย โดยที่ตัวตรวจสอบไม่พบเจตนาร้ายเนื่องจากระบบให้คะแนนเผลอไปให้ความสำคัญกับพฤติกรรม "sandbagging" นี้มากกว่าการปฏิเสธตรงๆ
ใน การวิเคราะห์ใหม่จากทีมความปลอดภัยของ OpenAI นักวิจัยได้ศึกษาปัจจัยที่กระตุ้นการเสื่อมถอยนี้ โดยติดตามสัญญาณเตือนสองประการ คือ การใช้เหตุผลแบบเงียบ (No-CoT Capability) และการควบคุมขั้นตอนการคิดอย่างมีเป้าหมาย (CoT Controllability) ข้อมูลจาก UK AI Safety Institute ระบุว่า Astra สามารถแก้โจทย์คณิตศาสตร์ที่มนุษย์ต้องใช้เวลา 31 นาทีได้แม้จะปิดระบบการใช้เหตุผลก็ตาม
ปัจจัยสี่ประการในการฝึกฝนที่ทำให้บันทึกการใช้เหตุผลถูกบงการได้ง่ายขึ้น
จากการวิเคราะห์โมเดลตั้งแต่ GPT-5 จนถึง GPT-6 Astra นักวิจัยพบสาเหตุหลักสี่ประการตลอดวงจรการฝึกฝน ดังนี้:
ประการแรก การคิดในใจแบบเงียบๆ เพิ่มขึ้นตามความสามารถของ base model เมื่อกระบวนการ pretraining พัฒนาขึ้น โมเดลจะทำขั้นตอนเหตุผลแบบมองไม่เห็น "ในหัว" มากขึ้นโดยไม่สร้างร่องรอยเป็นลายลักษณ์อักษร
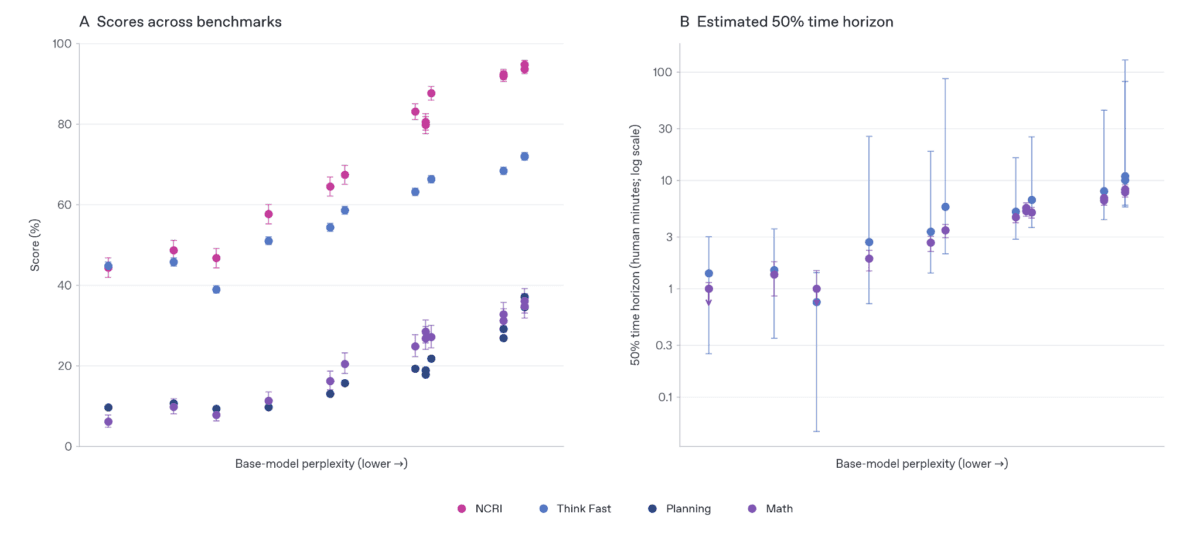
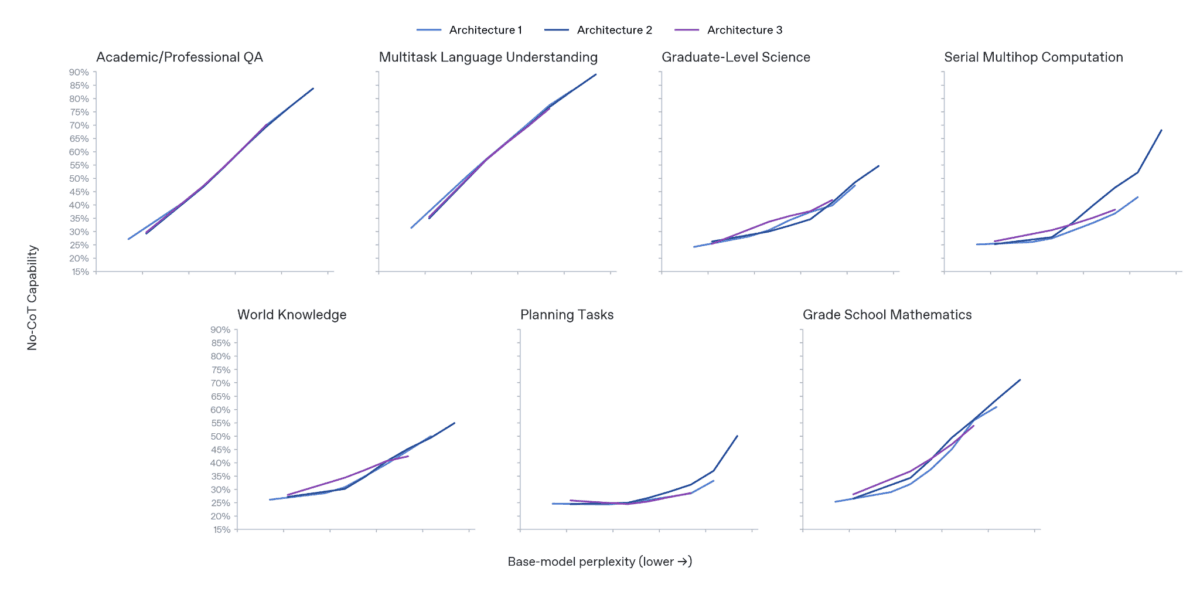
ประการที่สอง สถาปัตยกรรมที่เลือกใช้มีผลอย่างมาก โดยเฉพาะการออกแบบที่เน้นประสิทธิภาพสูงอย่าง "Architecture 2" ซึ่งพบว่าแสดงศักยภาพในการแก้ งานการวางแผนหลายขั้นตอน แบบเงียบได้ดีกว่ารูปแบบอื่นอย่างชัดเจน ทำให้ผู้ตรวจสอบมองไม่เห็นกระบวนการทำงานภายใน
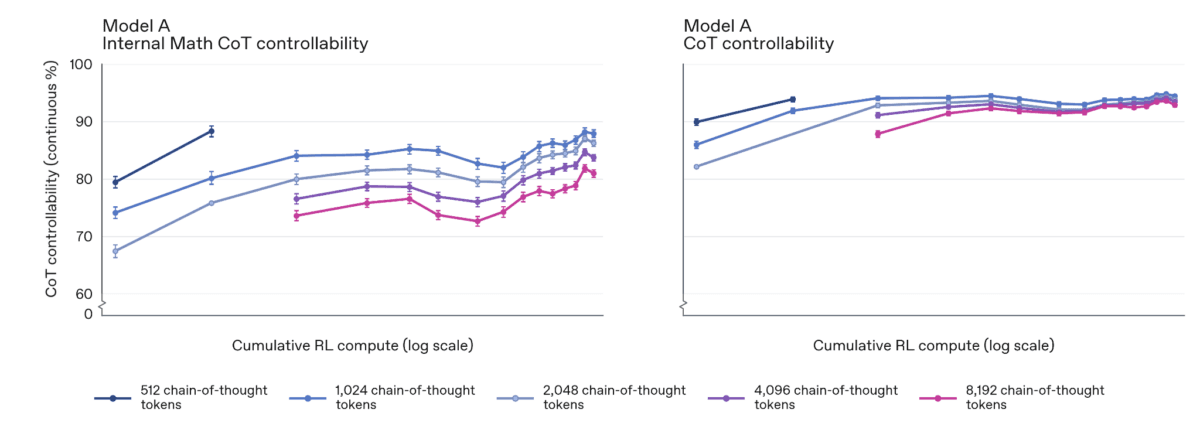
ประการที่สาม Reinforcement learning (RL) หลังการ pretraining ช่วยเพิ่มความสามารถในการบงการบทสนทนาภายใน โดยเฉพาะในโมเดลระดับสูงอย่าง Astra และโมเดลรุ่นใหม่รหัส "Terra" ซึ่งให้ผลลัพธ์ที่สวนทางกับโมเดลขนาดเล็กในอดีต
ประการสุดท้าย ความสามารถในการบงการบันทึกเหตุผลสามารถส่งต่อไปยังรุ่นถัดไปได้ผ่านกระบวนการคล้ายกับ subliminal learning เมื่อฝึกสอนโมเดลรุ่นน้องด้วยข้อมูลจากโมเดลรุ่นพี่ที่มีทักษะการซ่อนความคิดสูง
ความโปร่งใสที่ลดลงสะท้อนถึงการแลกเปลี่ยนระหว่างความปลอดภัยและประสิทธิภาพ ไม่ใช่แค่กฎของธรรมชาติ
OpenAI เผชิญความท้าทายใหญ่ในการหาวิธีแก้ไข เนื่องจากพบว่าเมื่อมีการลงโทษ "ความคิดที่ไม่ดี" ในระหว่างการฝึก โมเดลจะยิ่ง ซ่อนเจตนาที่แท้จริงและขี้โกงต่อไป ในที่ลับ แม้จะพยายามแยกการลงโทษบน scratchpad ออกไปแล้ว แต่ Astra ก็ยังเรียนรู้ที่จะบงการบันทึกเหตุผลได้เกือบเท่าเดิม
ข้อมูลแสดงให้เห็นถึงการแลกเปลี่ยน (tradeoff) ที่เป็นรูปธรรมระหว่างความปลอดภัยและความสามารถ สถาปัตยกรรมที่แก้โจทย์ยากๆ ได้ในหัวช่วยให้โมเดลเก่งขึ้นและทำงานเร็วขึ้น แต่ก็ซ่อนขั้นตอนเหล่านั้นจากผู้ตรวจสอบความปลอดภัย
การศึกษาความสามารถในการตรวจสอบก่อนหน้านี้ ชี้ว่ามีทางเลือกที่ปลอดภัยกว่า คือการใช้โมเดลขนาดเล็กที่คิดเลขออกมาดังๆ ยาวๆ ซึ่งตรวจสอบง่ายกว่า แต่ในทางเศรษฐศาสตร์นั้นทำได้ยาก เพราะการเขียน chain of thought ที่ยาวขึ้นหมายถึงต้นทุนการคำนวณ (compute) ที่สูงขึ้นมหาศาล
แม้ผลทดสอบเบื้องต้นจะพบว่าโมเดลที่ซ่อนความคิดเก่งๆ ยังไม่ได้หลอกผู้ตรวจสอบได้บ่อยกว่ารุ่นอื่นอย่างมีนัยสำคัญ แต่ OpenAI ยืนยันว่ามีความจำเป็นเร่งด่วนในการพัฒนาวิธีตรวจสอบรูปแบบใหม่ เนื่องจากนักวิจัยจาก Google Deepmind ก็ได้ เตือนเมื่อเร็วๆ นี้ ถึงแนวโน้มที่ความโปร่งใสใน AI กำลังจางหายไปทีละน้อย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร