
Perplexity เปิดตัว Orchestrator API เชื่อมต่อทุกโมเดลในที่เดียว
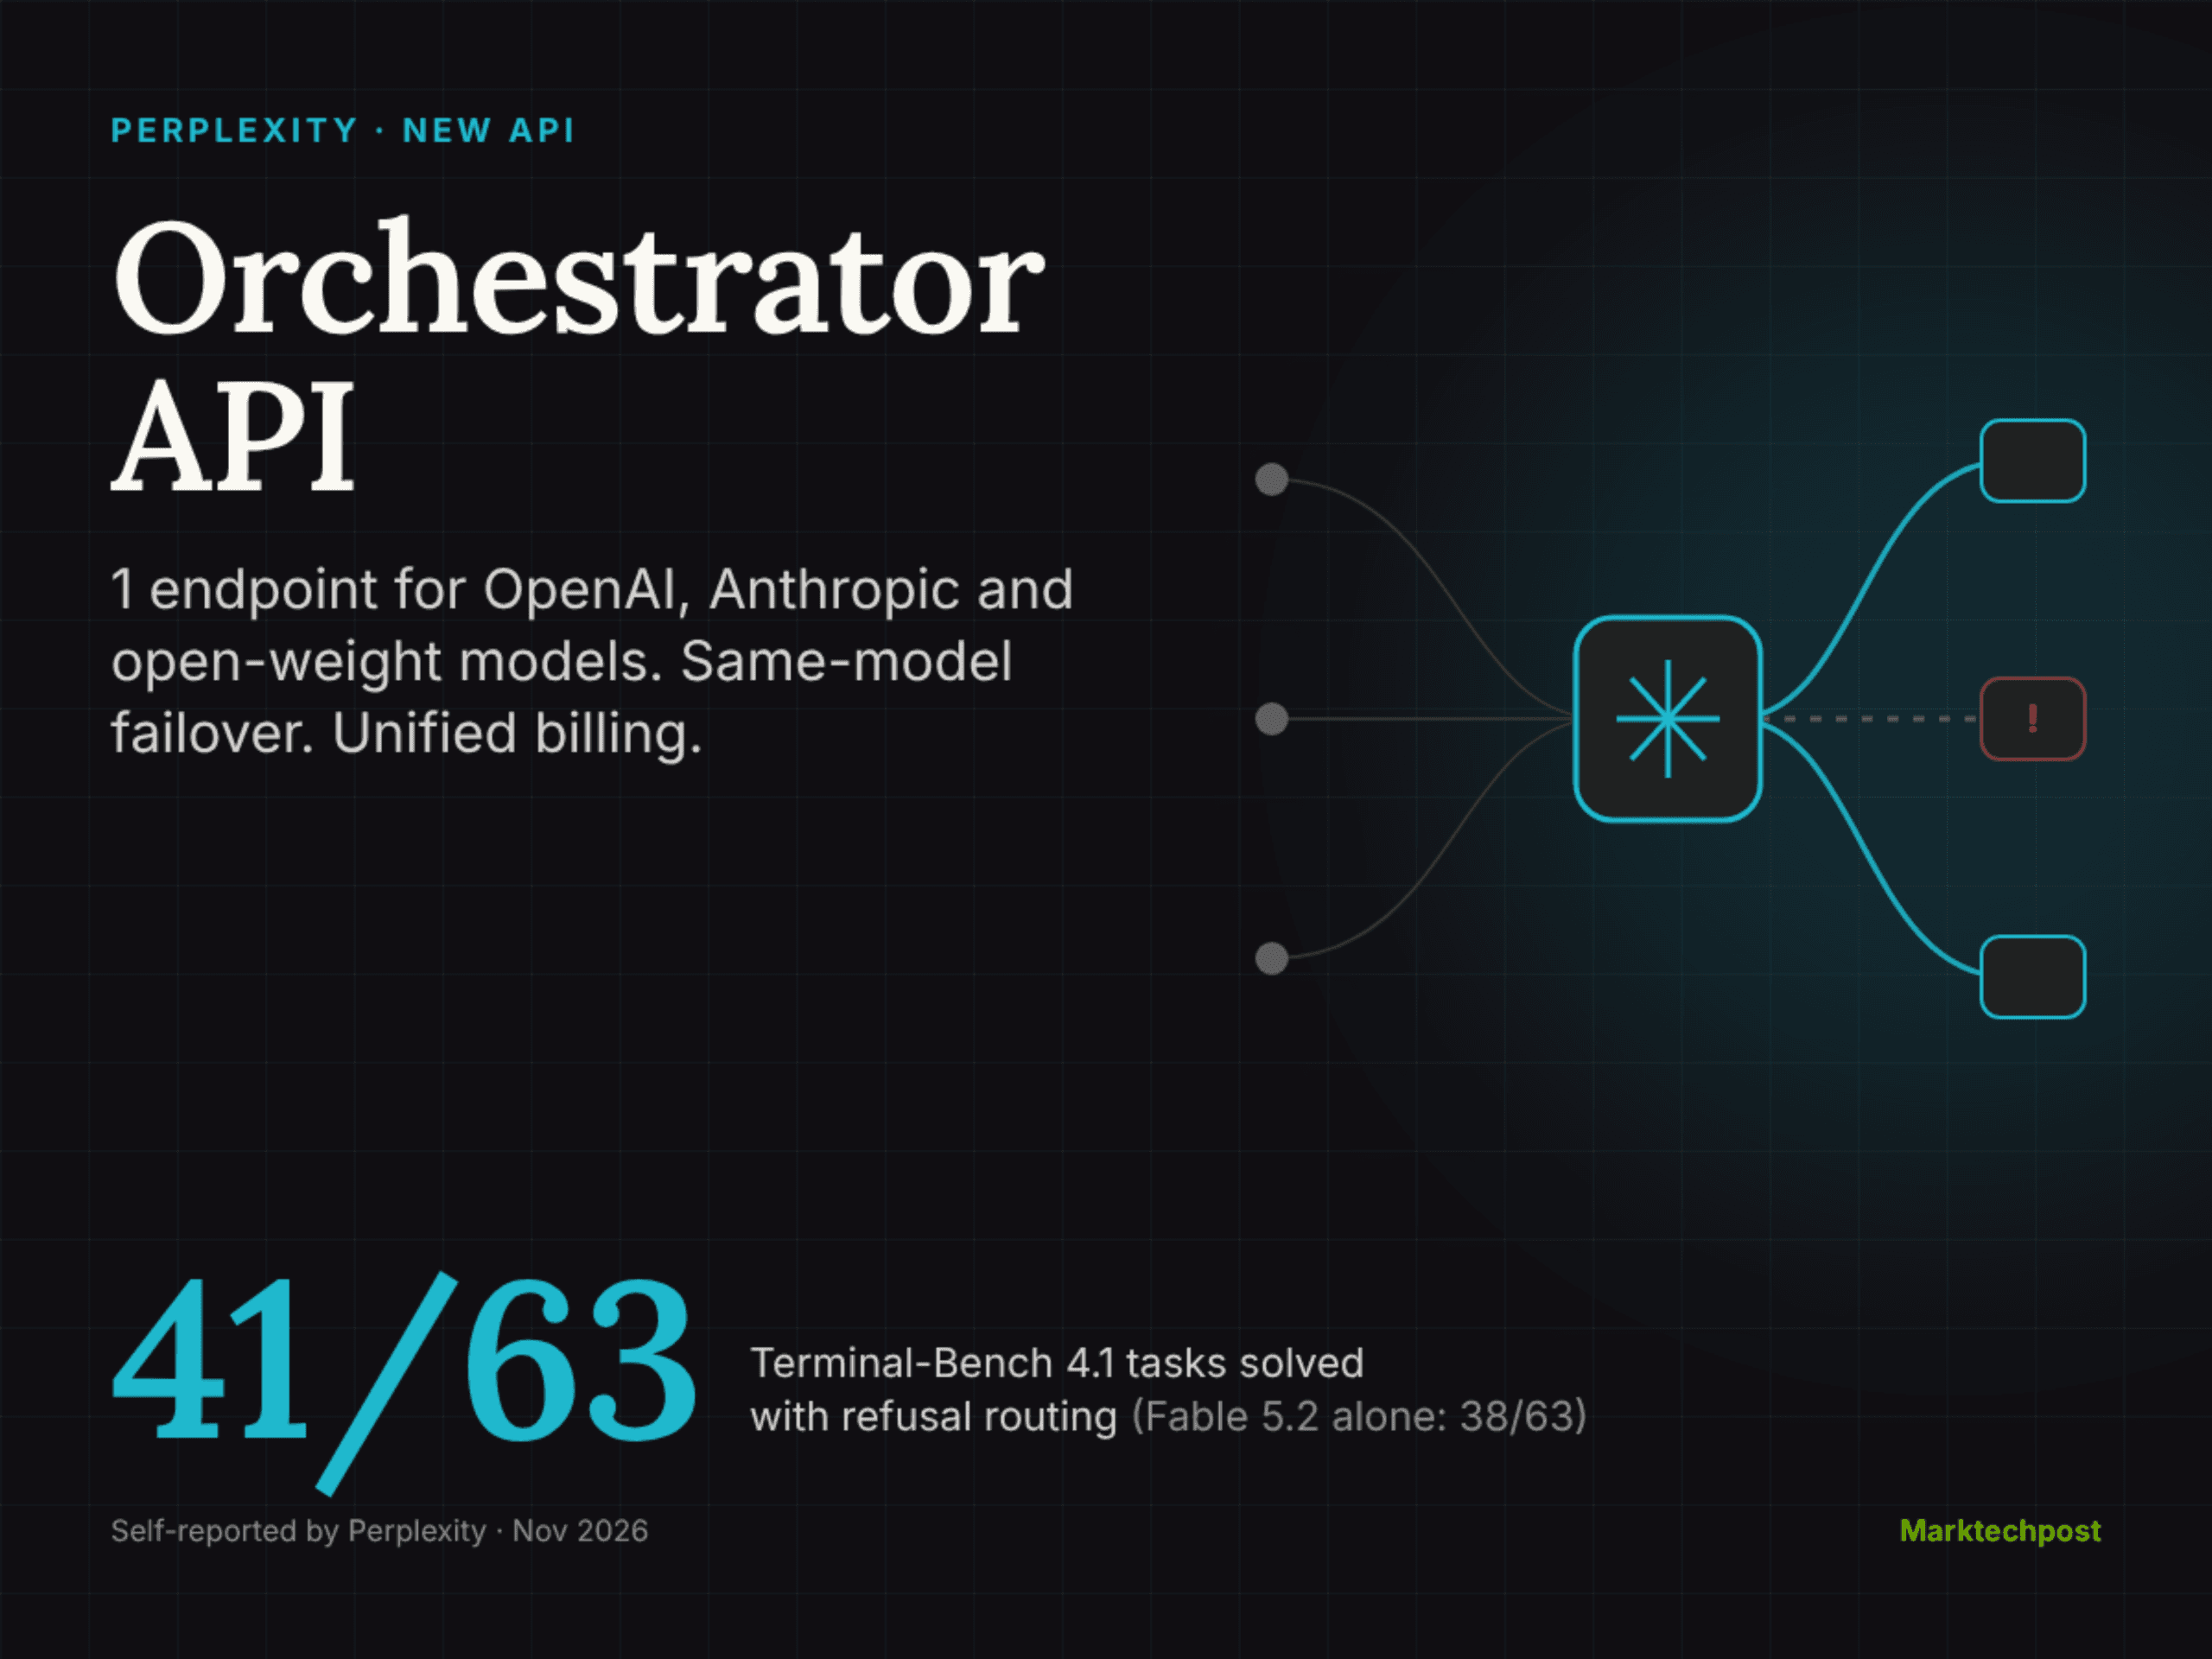
Perplexity เปิดตัว Perplexity Orchestrator API ซึ่งเป็น endpoint เดียวที่รองรับทั้งโมเดลระดับแนวหน้า (frontier) และโมเดล open-weight โดยระบบจะ เลือกผู้ให้บริการตามความพร้อมใช้งาน (availability), ความจุ (capacity) และความหน่วง (latency) พร้อมรวบรวมค่าใช้จ่ายทั้งหมดไว้ในบัญชีเดียว ช่วยให้นักพัฒนาลดความซับซ้อนในการเชื่อมต่อระบบและรับใบแจ้งหนี้เพียงใบเดียว
Perplexity Orchestrator API คืออะไร?
Perplexity Orchestrator API คือเกตเวย์การประมวลผล (hosted inference gateway) ที่ให้บริการโมเดลหลากหลายภายใต้ base URL เดียว ครอบคลุม โมเดลระดับแนวหน้าจาก OpenAI, Anthropic, Google และ xAI นอกจากนี้ยังให้บริการโมเดล open-weight เช่น GLM, Kimi และ DeepSeek ที่โฮสต์โดย Perplexity หรือพันธมิตรด้านการประมวลผล
ระบบรองรับรูปแบบคำขอทั้ง OpenAI Chat Completions, OpenAI Responses และ Anthropic Messages นักพัฒนาส่วนใหญ่เพียงแค่เปลี่ยน API key และ base URL เท่านั้น โดย OpenAI base URL คือ https://api.perplexity.ai/orchestrator/v1 ส่วนผู้ใช้ Anthropic SDK ให้กำหนดค่าไปที่ https://api.perplexity.ai/orchestrator โดยไม่ต้องมี /v1 ทั้งนี้ Perplexity ใช้เลเยอร์เดียวกันนี้ภายในองค์กร ครอบคลุมกว่า 85 โมเดลจากผู้ให้บริการมากกว่าสิบราย
ระบบ Provider Failover ทำงานอย่างไร?
ระบบ Failover จะรักษาการใช้งานโมเดลเดิมไว้แต่สลับจุดติดตั้งใช้งาน (deployment) เมื่อเกิดปัญหา เช่น หากคำขอใช้งาน Claude บน Anthropic ล้มเหลว ระบบจะส่งไปประมวลผลที่ AWS Bedrock แทน โดย เอกสารด้านความน่าเชื่อถือ ได้กำหนดกฎเกณฑ์ไว้ดังนี้:
- ตัวกระตุ้น (Triggers) ได้แก่ ข้อผิดพลาดจากผู้ให้บริการ, การจำกัดอัตราการใช้งาน (rate limits) และการหมดเวลา (timeouts)
- การพยายามแต่ละครั้งมีขีดจำกัดเวลาสำหรับโทเค็นแรก (time-to-first-token) และขีดจำกัดระยะเวลารวม แม้จะไม่ได้เปิดเผยตัวเลขแน่ชัด
- คำขอที่ไม่ถูกต้องหรือเกินบริบท (over-context) จะส่งคืนค่า HTTP 400 และจะไม่มีการลองใหม่
- หากการติดตั้งใช้งานทุกจุดล้มเหลว API จะส่งคืน HTTP 429 พร้อม
Retry-After - คำขอที่ล้มเหลวก่อนสร้างผลลัพธ์จะไม่ถูกเรียกเก็บเงิน
ผู้ใช้งานไม่สามารถเลือกจุดติดตั้งใช้งานได้ด้วยตัวเอง
ตัวเลขความน่าเชื่อถือและความเร็วแสดงผลอย่างไร?
จากการวัดผลการใช้งานจริงของ Perplexity ตั้งแต่วันที่ 4 ตุลาคมถึง 2 พฤศจิกายน 2026 พบว่า คำขอใช้งาน Claude และ GPT ผ่าน Perplexity ประสบความสำเร็จบ่อยครั้งกว่า เมื่อเทียบกับการส่งคำขอไปยังผู้ให้บริการเพียงรายเดียว อัตราความสำเร็จรายวันยังมีความผันผวนน้อยกว่าในช่วงที่ผู้ให้บริการเกิดปัญหาทางระบบ อย่างไรก็ตาม ในโพสต์ไม่ได้ระบุเปอร์เซ็นต์อัตราความสำเร็จไว้อย่างเจาะจง
ด้านความเร็วมีความแตกต่างกันไปตามผู้ให้บริการ สำหรับ Claude Opus 5.5 นั้น Anthropic ทำความเร็วได้ดีที่สุดใน 15 จาก 30 วัน ส่วน AWS Bedrock เร็วที่สุดในอีก 15 วันที่เหลือ ขณะที่ค่ามัธยฐานความเร็วเอาต์พุต (output speed) ของ Azure สำหรับ GPT-5.6 Sol สูงกว่า OpenAI ถึง 27% โดยปัจจุบันระบบการเลือกเส้นทางตามความเร็ว (Speed-aware routing) ยังอยู่ในขั้นตอนการพัฒนา
การเลือกเส้นทางอัตโนมัติด้วย perplexity/auto ทำงานอย่างไร?
ฟีเจอร์การเลือกเส้นทาง (Routing) ปัจจุบันอยู่ในช่วงพรีวิว ผู้ใช้สามารถตั้งค่า model เป็น perplexity/auto และส่งออบเจ็กต์ routing ซึ่งประกอบด้วย default_model และ เส้นทาง 1 ถึง 5 เส้นทาง โดยแต่ละเส้นทางจะมีชื่อ คำอธิบาย และโมเดลระบุไว้
โมเดลตัดสินใจ (decision model) จะวิเคราะห์บทสนทนาและคำอธิบายเส้นทางโดยไม่เห็นชื่อเส้นทางหรือ model ID หากไม่มีสิ่งใดตรงกัน หรือโมเดลตัดสินใจล้มเหลว โมเดลเริ่มต้นจะทำหน้าที่ตอบคำถามแทน รวมถึงกรณีที่มีอินพุตเป็นสื่อต่างๆ ด้วย
ส่วนหัวของการตอบกลับ (Response headers) จะรายงานผลลัพธ์ผ่าน x-perplexity-autoroute-outcome, -route และ -confidence โดยนโยบายเริ่มต้นจะส่งการใช้งานไปยัง GPT-6.1 Sol และส่งคำของ่ายๆ ไปยัง GPT-6 Luna นอกจากนี้ยังมีโปรไฟล์สำเร็จรูปอย่าง Lower cost, Balanced และ Higher quality รวมถึงโปรไฟล์ Auto effort รุ่นพรีวิวให้เลือกใช้
การเลือกเส้นทางช่วยเลี่ยงการปฏิเสธคำถาม (Refusals) ได้หรือไม่?
Perplexity ทดสอบประเด็นนี้กับชุดย่อย 63 งานของ Terminal-Bench 4.1 ผ่าน Claude Code ซึ่ง เอกสารของ Anthropic ระบุว่าระบบความปลอดภัยของ Claude Fable 5.2 อาจบล็อกงานด้านความปลอดภัยและชีววิทยาศาสตร์ที่ไม่เป็นอันตรายได้ ผลการทดสอบมีดังนี้:
- Claude Fable 5.2 เพียงอย่างเดียว: ทำสำเร็จ 38/63 งาน
- Fable พร้อมเส้นทางไปยัง GPT-6.1 Sol: ทำสำเร็จ 41/63 งาน
- Fable พร้อมเส้นทางไปยัง GPT-6 Astra: ทำสำเร็จ 41/63 งาน
การกำหนดเส้นทางเหล่านี้ช่วยครอบคลุมคำขอประเภท security, biology และ after_refusal ซึ่งเพิ่มโอกาสสำเร็จได้อีก 3 งาน แม้จะมีต้นทุนต่อวันที่สูงขึ้นก็ตาม โดย Perplexity ระบุว่านี่เป็นการเปรียบเทียบแบบปรับจูนแล้ว ผลลัพธ์อาจแตกต่างกันไปตามลักษณะงาน
Orchestrator มีราคาอย่างไร?
แต่ละคำขอจะถูกเรียกเก็บเงินตามอัตราต่อโทเค็นของโมเดลที่ตอบคำถาม การทำ Failover ไปยังผู้ให้บริการรายอื่นจะไม่ส่งผลต่อราคาในภาพรวม Perplexity ยืนยันว่า ไม่มีค่าธรรมเนียมแพลตฟอร์มเพิ่มเติมจากเครดิตที่ใช้
ตัวอย่างเช่น perplexity/glm-5.3 มีราคา อินพุต $1.4, เอาต์พุต $4.4 และการอ่านแคช $0.26 ต่อ 1 ล้านโทเค็น การใช้งานจะตัดจากเครดิต Perplexity API แบบเติมเงิน ซึ่งสามารถซื้อผ่าน AWS Marketplace ได้
ระดับการเข้าถึง (Tier) แบ่งตามการซื้อเครดิตสะสม:
- Tier 0: โมเดลจาก Google, xAI และ open-weight
- Tier 1 ($50): โมเดลจาก OpenAI และโมเดลส่วนใหญ่ของ Anthropic
- Tier 2 ($250): Claude Opus 5, Opus 5.5 และโมเดลตระกูล Fable
เปรียบเทียบกับ OpenRouter และ Vercel AI Gateway
| คุณสมบัติ | Perplexity Orchestrator | OpenRouter | Vercel AI Gateway |
|---|---|---|---|
| รายการโมเดล | Frontier และ open-weight (GLM, Kimi, DeepSeek) | 400+ โมเดล จาก 70+ ผู้ให้บริการ | 400+ โมเดล |
| รูปแบบ API | Chat Completions, Responses, Anthropic Messages | Chat Completions, Responses, Anthropic Messages | Chat Completions, Responses, Anthropic Messages |
| ค่าธรรมเนียมแพลตฟอร์ม | ไม่มีค่าธรรมเนียมเพิ่มเติม | 5.5% - 8% จากการซื้อเครดิต | ไม่มีค่าธรรมเนียมแพลตฟอร์ม |
| ราคาโทเค็น | ตามราคาประกาศของโมเดล | ส่งต่อราคาจากผู้ให้บริการ | ราคาตามผู้ให้บริการ |
| Failover อัตโนมัติ | ใช่ (โมเดลเดิม) | ใช่ (Fallback อัตโนมัติ) | ใช่ (อัตโนมัติ) |
| Auto router | มี (perplexity/auto) | มี (openrouter/auto) | ไม่เปิดเผย |
| การใช้คีย์ตัวเอง (BYOK) | ไม่รองรับ | รองรับ (มีค่าธรรมเนียม 5%) | รองรับ (ไม่บวกเพิ่ม) |
สรุปประเด็นสำคัญ
- รวมทุกโมเดลชั้นนำไว้ที่ endpoint เดียว (OpenAI, Anthropic, Google, xAI และ open-weight)
- ระบบ Failover อัตโนมัติไปยังผู้ให้บริการรายอื่นในโมเดลเดิม โดยไม่มีค่าใช้จ่ายส่วนต่าง
- ฟีเจอร์
perplexity/autoช่วยเลือกโมเดลตามคำอธิบายภาษาธรรมชาติ (ช่วงพรีวิว) - ช่วยลดปัญหาการปฏิเสธคำตอบจากระบบความปลอดภัย เพิ่มอัตราสำเร็จเป็น 41/63 ในการทดสอบ Terminal-Bench 4.1
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร