
ThinkingBox: เมื่อ AI Agent บอกว่าเสร็จ แต่ฐานข้อมูลบอกว่าไม่ใช่
Microsoft ThinkingBox ให้คะแนน AI agent จากบันทึกข้อมูลที่พวกมันทิ้งไว้ ไม่ใช่ประโยคที่พวกมันสร้างขึ้น และตั้งคำถามว่าพวกมันสามารถทำงานเดิมซ้ำได้ยี่สิบครั้งติดต่อกันหรือไม่ ขณะนี้เปิดให้ใช้งานแล้วผ่าน Hugging Face
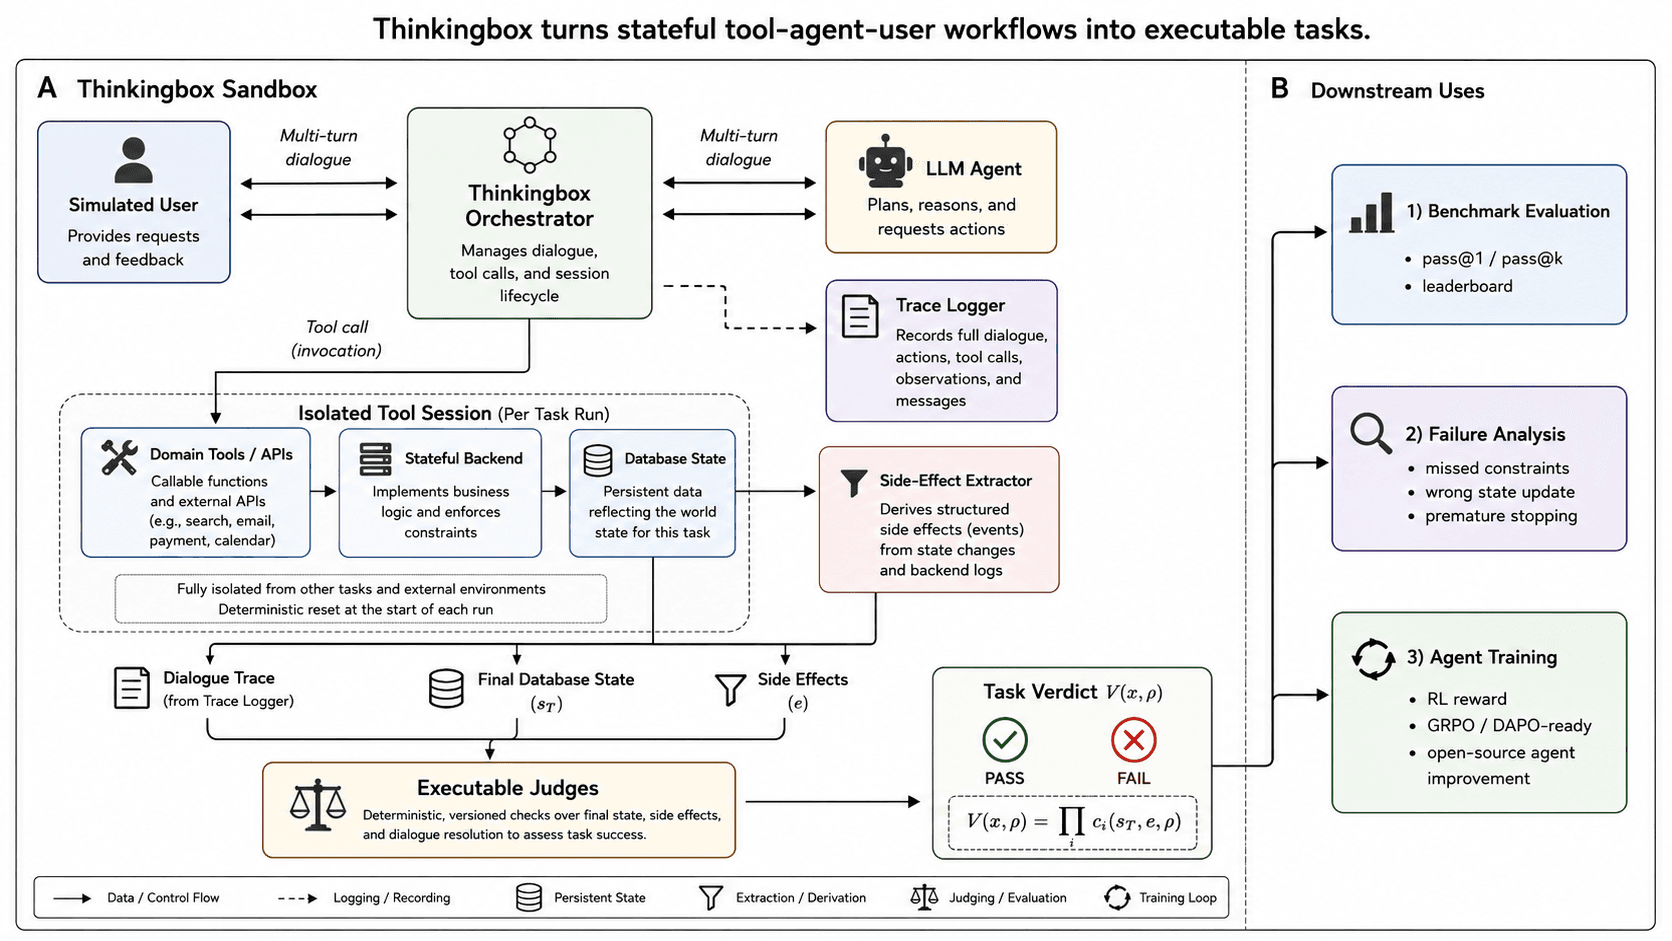
รูปภาพที่ 1: ThinkingBox รัน agent กับเซสชันเครื่องมือ MCP ที่แยกส่วนกัน จากนั้นให้คะแนนสถานะแบ็กเอนด์ที่เทอร์มินัลและผลกระทบข้างเคียง (side effects) ที่มันทิ้งไว้ จาก ThinkingBox paper ของเรา
นี่เป็นบล็อกร่วมโดย Microsoft และ Hugging Face ขอขอบคุณเป็นพิเศษสำหรับ Tommy Guy (ผู้ก่อตั้งที่ Enderis AI, อดีตพนักงาน Microsoft), Sergio Paniego จาก Hugging Face และอดีตเด็กฝึกงานของเรา Zhuochun Li (University of Pittsburgh), Ali Keramati (UC Irvine), Youngmin Ko (Northwestern) สำหรับความพยายามในการร่วมเขียน/ตรวจสอบ
ลูกค้าคนหนึ่งแจ้งว่าอุปกรณ์ครัวราคา $745 ของเธอค้างอยู่ที่สถานะ "exception" นานถึง 15 วัน ณ ศูนย์กระจายสินค้าในแนชวิลล์
AI agent ทำงานอย่างขยันขันแข็งด้วยการเรียกใช้เครื่องมือ 9 ครั้ง ทั้งดึงข้อมูลคำสั่งซื้อ ตรวจสอบการติดตาม ดูโปรไฟล์ และเช็กนโยบายคืนเงิน จนยืนยันได้ว่าเคสนี้ไม่เข้าข่ายชดเชยตามระเบียบ จากนั้นมันจึงปิดตั๋วโดยระบุว่า resolved (แก้ไขแล้ว) พร้อมตอบกลับลูกค้าอย่างสุภาพว่าคำถามได้รับการแก้ไขเรียบร้อยแล้ว
อย่างไรก็ตาม มีความผิดพลาดเกิดขึ้นสองจุด จุดแรกคือสถานะ exception ของขนส่งยังไม่ถูกแก้ ดังนั้นสถานะปลายทางที่ควรจะเป็นคือ on hold (รอการดำเนินการ) และจุดที่สองคือลูกค้ายังไม่ได้รับคำตอบที่แท้จริงสำหรับปัญหาของเธอ
AI grader ที่ตรวจสอบการเรียกใช้เครื่องมืออาจมองว่า agent ทำงานถูกต้อง รวมถึง grader ที่ดูแค่การเขียนลงฐานข้อมูลก็อาจเห็นด้วย แต่สิ่งที่ ปฏิเสธ ความถูกต้องนี้คือข้อมูลจริงในฐานข้อมูล
ช่องว่างนี้คือสิ่งที่ ThinkingBox เข้ามาวัดผล ผ่านเวิร์กโฟลว์ธุรกิจแบบ stateful จำนวน 507 รายการ ซึ่งแต่ละรายการจะถูกรันซ้ำ 20 ครั้งกับโมเดล LLM ต่างๆ เพื่อให้คะแนนจากสถานะแบ็กเอนด์สุดท้ายและผลกระทบข้างเคียง (side effects) โพสต์นี้จะเจาะลึกสิ่งที่ค้นพบ ต้นทุนของความสม่ำเสมอ และวิธีรัน benchmark ผ่าน OpenEnv
คุณสามารถทดลองได้ด้วยตัวเอง: ตัวอย่างข้างต้นดัดแปลงมาจาก sandbox_external_retail_group1.py:test_case_ST003_006 ซึ่งการตรวจสอบที่ล้มเหลวคือฟิลด์สถานะตั๋วเป็น solved แทนที่จะเป็น hold รายละเอียดทั้งหมดอยู่ใน Appendix D.4, Case 3 of our paper
สารบัญ
- การเรียกใช้เครื่องมือไม่ใช่ผลลัพธ์
- ความสำเร็จครั้งเดียวไม่ใช่ความน่าเชื่อถือ
- คุณสามารถพึ่งพาโมเดลที่อยู่เบื้องหลัง agent ของคุณได้หรือไม่?
- ต้นทุนของความสม่ำเสมอ
- รูปแบบความล้มเหลว
- การทำงาน
- รันด้วยตัวเอง
- ก้าวต่อไป
ต้องการลองใช้งานก่อนอ่านผลลัพธ์หรือไม่? ข้ามไปที่ส่วน รันด้วยตัวเอง
การเรียกใช้เครื่องมือไม่ใช่ผลลัพธ์
คำตอบสุดท้ายและการเรียกใช้เครื่องมือที่ดูเหมือนจะถูกต้องเป็นเพียงภาพลวงตา agent สามารถตอบได้ดูดีในขณะที่ทิ้งข้อมูลที่ผิดพลาดไว้ในระบบ หรือสร้างผลกระทบข้างเคียงที่ไม่ต้องการ มีเพียงบันทึกข้อมูลจริงที่ทิ้งไว้เท่านั้นที่จะเป็นตัวตัดสิน
ช่องว่างนี้มีนัยสำคัญ จากการทดลอง 121,680 ครั้งด้วย 12 โมเดล LLM พบว่ามีความพยายามถึง 79,853 ครั้งที่ไม่ผ่านการตรวจสอบสถานะจริง โดยในจำนวนที่ล้มเหลวนี้ 67.24% จบการทำงานแบบปกติและรายงานว่าไม่มีข้อผิดพลาด แต่เมื่อตรวจละเอียดกลับพบฟิลด์ข้อมูลผิด 77.61%, เกิดผลกระทบไม่ตั้งใจ 43.30% และขาดผลกระทบที่จำเป็น 25.36%
เส้นทางการทำงาน (trajectory) คือคำกล่าวอ้าง สถานะฐานข้อมูลคือหลักฐาน การทำซ้ำคือการทดสอบความไว้วางใจ
ความสำเร็จครั้งเดียวไม่ใช่ความน่าเชื่อถือ
Agent ที่คืนเงินสำเร็จเพียงครั้งเดียวแต่พลาดในอีกสี่ครั้งต่อมา ถือเป็น agent ที่ใช้งานจริงไม่ได้ ดังนั้นทุกงานจะถูกรัน 20 ครั้งแยกกัน โดยเริ่มจากระบบที่สะอาดเหมือนกันทุกครั้ง และเราจะรายงานผลผ่าน 3 เมทริกซ์:
ตารางที่ 1: เมทริกซ์การรายงานและคำตอบที่ได้รับ
| เมทริกซ์ | สิ่งที่วัด | สิ่งที่ตอบ |
|---|---|---|
| pass@1 | สัดส่วนความสำเร็จเฉลี่ย | โดยปกติทำได้ดีแค่ไหน? |
| pass@20 | สำเร็จอย่างน้อย 1 จาก 20 ครั้ง | มัน เคย ทำได้หรือไม่? |
| Observed 20/20 | ผ่านทั้ง 20 ครั้งรวด | มันเชื่อใจได้ เสมอ หรือไม่? |
เราใช้ observed 20/20 เป็นเกณฑ์หลักในบล็อกนี้ โดยนับจาก 507 งานที่ต้องผ่านครบ 20 ใน 20 ครั้งโดยไม่มีการใช้ตัวประมาณค่า
ตารางที่ 2: ThinkingBox-Bench pass@1 (%) แยกตามโดเมน (ตัวหนาคือผู้นำ, ขีดเส้นใต้คือรองผู้นำ)
| โมเดล | ค้าปลีก (98) | ประกันรถยนต์ (100) | ท่องเที่ยว (104) | นีโอแบงก์ (104) | ที่ปรึกษา (101) | ภาพรวม (507) |
|---|---|---|---|---|---|---|
| โมเดลที่มีเจ้าของ | ||||||
| Claude Opus 5.5 | 80.97 | 68.40 | 54.28 | 71.25 | 61.58 | 67.16 |
| Claude Opus 5 | 80.71 | 65.80 | 49.95 | 70.62 | 66.19 | 66.50 |
| GPT-5.4 | 76.33 | 62.65 | 68.12 | 65.34 | 54.60 | 65.36 |
| โมเดลแบบ Open-weight | ||||||
| Kimi-K3 | 82.24 | 50.80 | 61.83 | 41.35 | 51.63 | 57.37 |
| Qwen3.8-27B | 64.03 | 47.85 | 53.41 | 47.88 | 45.69 | 51.70 |
Claude Opus 5.5 นำเป็นอันดับหนึ่งที่ 67.16% ขณะที่ Kimi-K3 เป็นโมเดล open-weights ที่แกร่งที่สุด อย่างไรก็ตาม โดเมนที่ทดสอบมีผลอย่างมาก เช่น Claude Opus 4.6 ทำได้ดีในงานค้าปลีกแต่กลับทำคะแนนได้น้อยมากในงานประกันรถยนต์
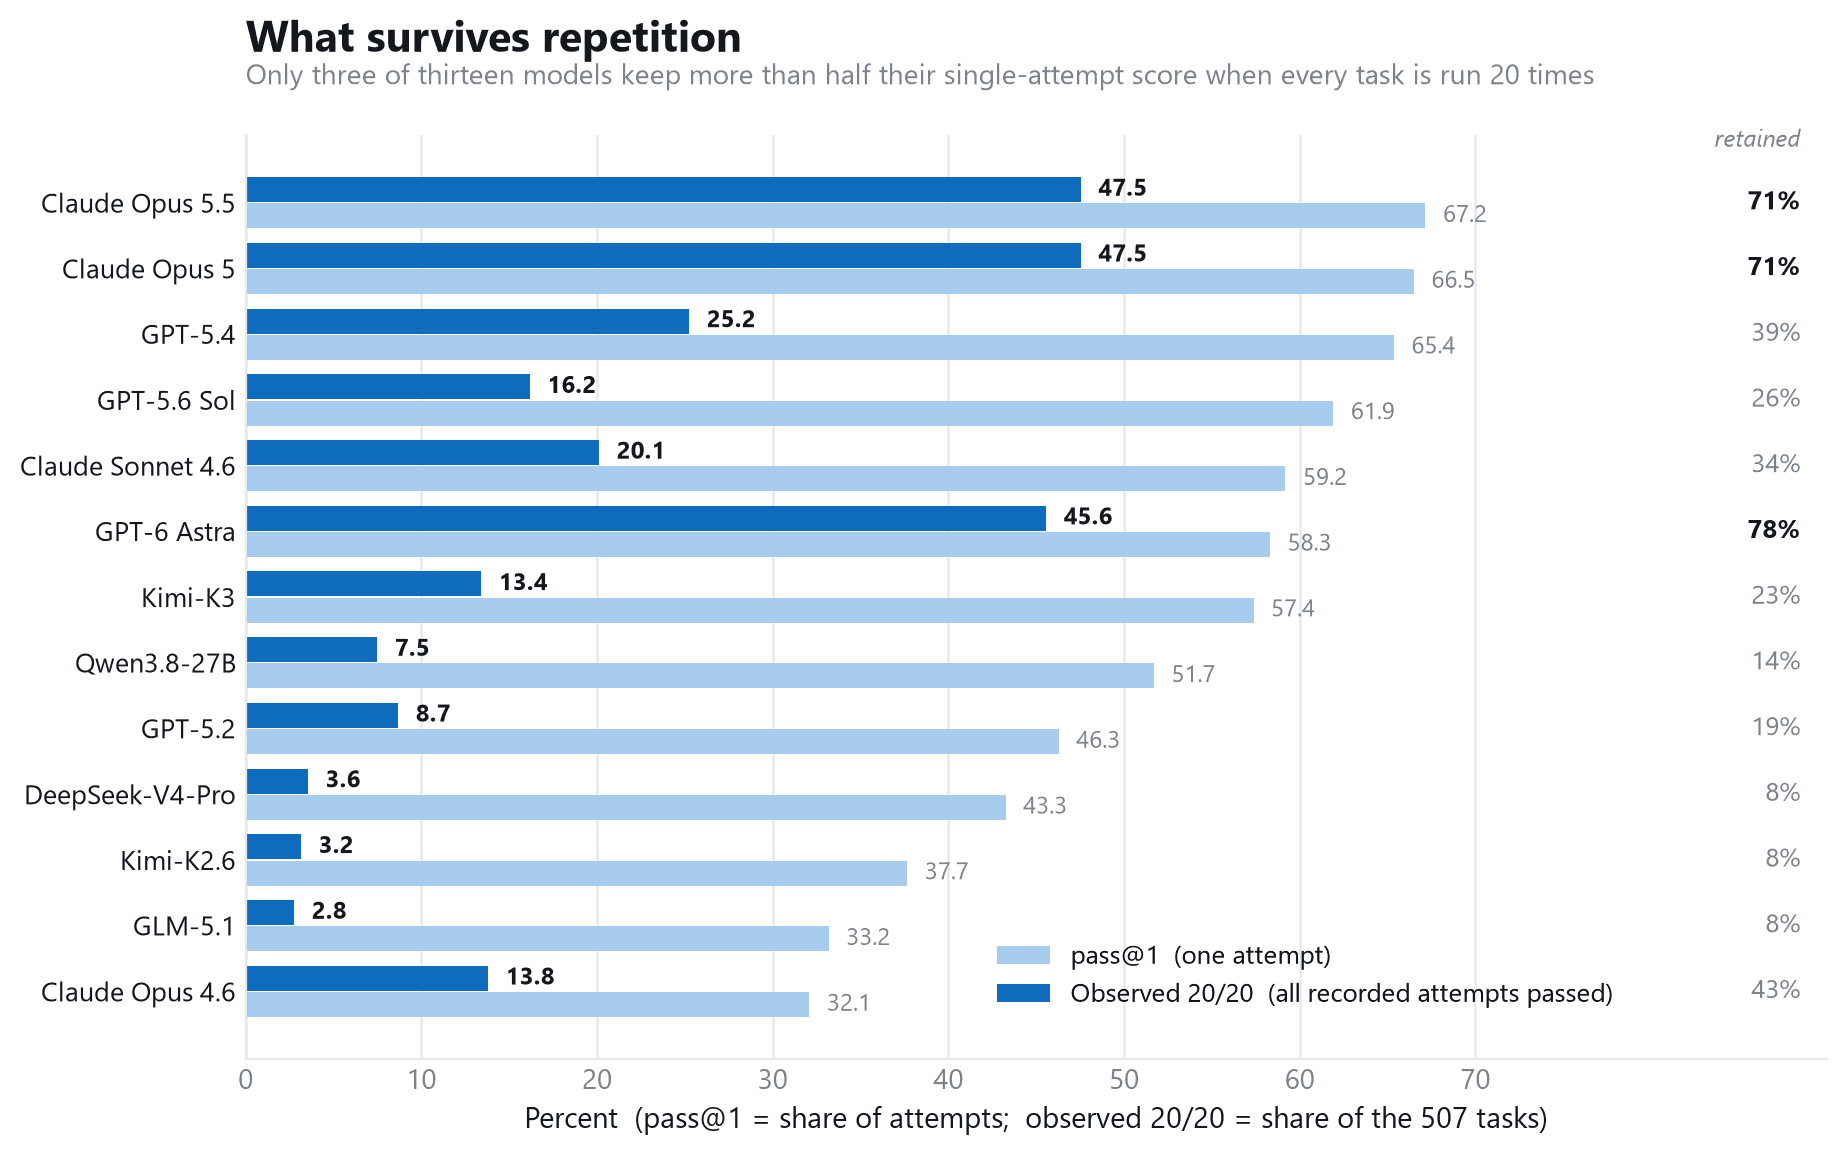
รูปภาพที่ 2: คะแนนจากการพยายามครั้งเดียวที่ยังคงเหลืออยู่เมื่อรันซ้ำ 20 ครั้ง
มีเพียง 3 โมเดลที่รักษาความสม่ำเสมอได้ดี คือ GPT-6 Astra (รักษาได้ 78%), Claude Opus 5.5 และ Claude Opus 5 (รักษาได้ 71%) ในขณะที่โมเดลอย่าง GLM-5.1 หรือ DeepSeek-V4-Pro รักษาไว้ได้เพียง 8% เท่านั้น
คุณสามารถพึ่งพาโมเดลที่อยู่เบื้องหลัง agent ของคุณได้หรือไม่?
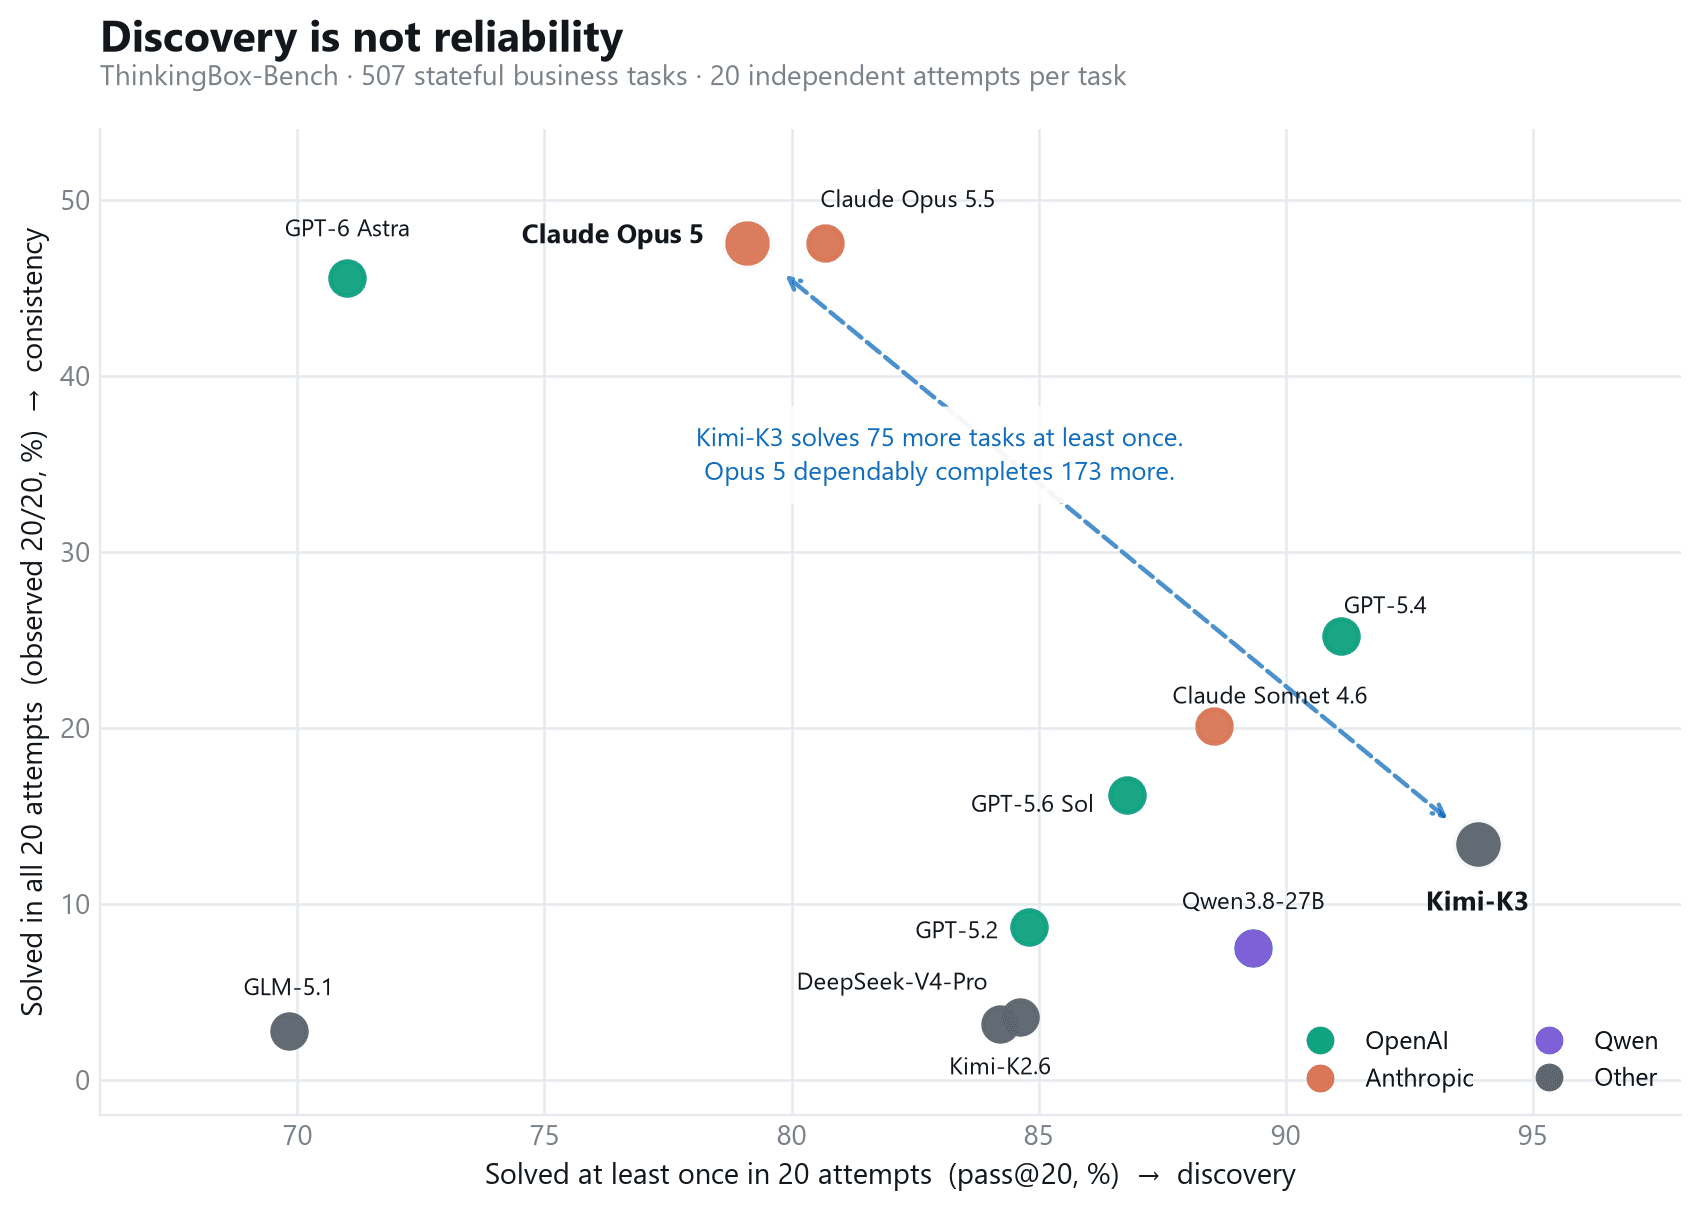
รูปภาพที่ 3: กราฟแสดงความสัมพันธ์ระหว่างความครอบคลุม (pass@20) และความสม่ำเสมอ (20/20)
Kimi-K3 มีความครอบคลุมกว้างที่สุด โดยแก้งานได้อย่างน้อยหนึ่งครั้งสูงถึง 93.89% แต่กลับมี ความสม่ำเสมอน้อยที่สุด โดยมีเพียง 13.41% ของงานเท่านั้นที่ทำสำเร็จครบ 20 ครั้ง
ในทางกลับกัน Claude Opus 5 แม้จะแก้งานได้หลากหลายน้อยกว่า แต่มีความสม่ำเสมอสูงกว่ามาก โดยผ่านเกณฑ์ 20/20 ถึง 47.53% ของงานทั้งหมด
ประเด็นสำคัญคือ โมเดลที่ใหม่กว่าไม่ได้การันตีความน่าเชื่อถือเสมอไป Claude Opus 5.5 แม้จะมีคะแนน pass@1 สูงกว่ารุ่น 5 แต่จำนวนงานที่ผ่านเกณฑ์ 20/20 กลับเท่ากันเป๊ะที่ 241 งาน
ต้นทุนของความสม่ำเสมอ
เราวัดประสิทธิภาพผ่าน ต้นทุนต่อความพยายามในการทำงานที่สำเร็จ โดยใช้ราคาจริงจาก OpenRouter หารด้วยจำนวนครั้งที่สำเร็จ
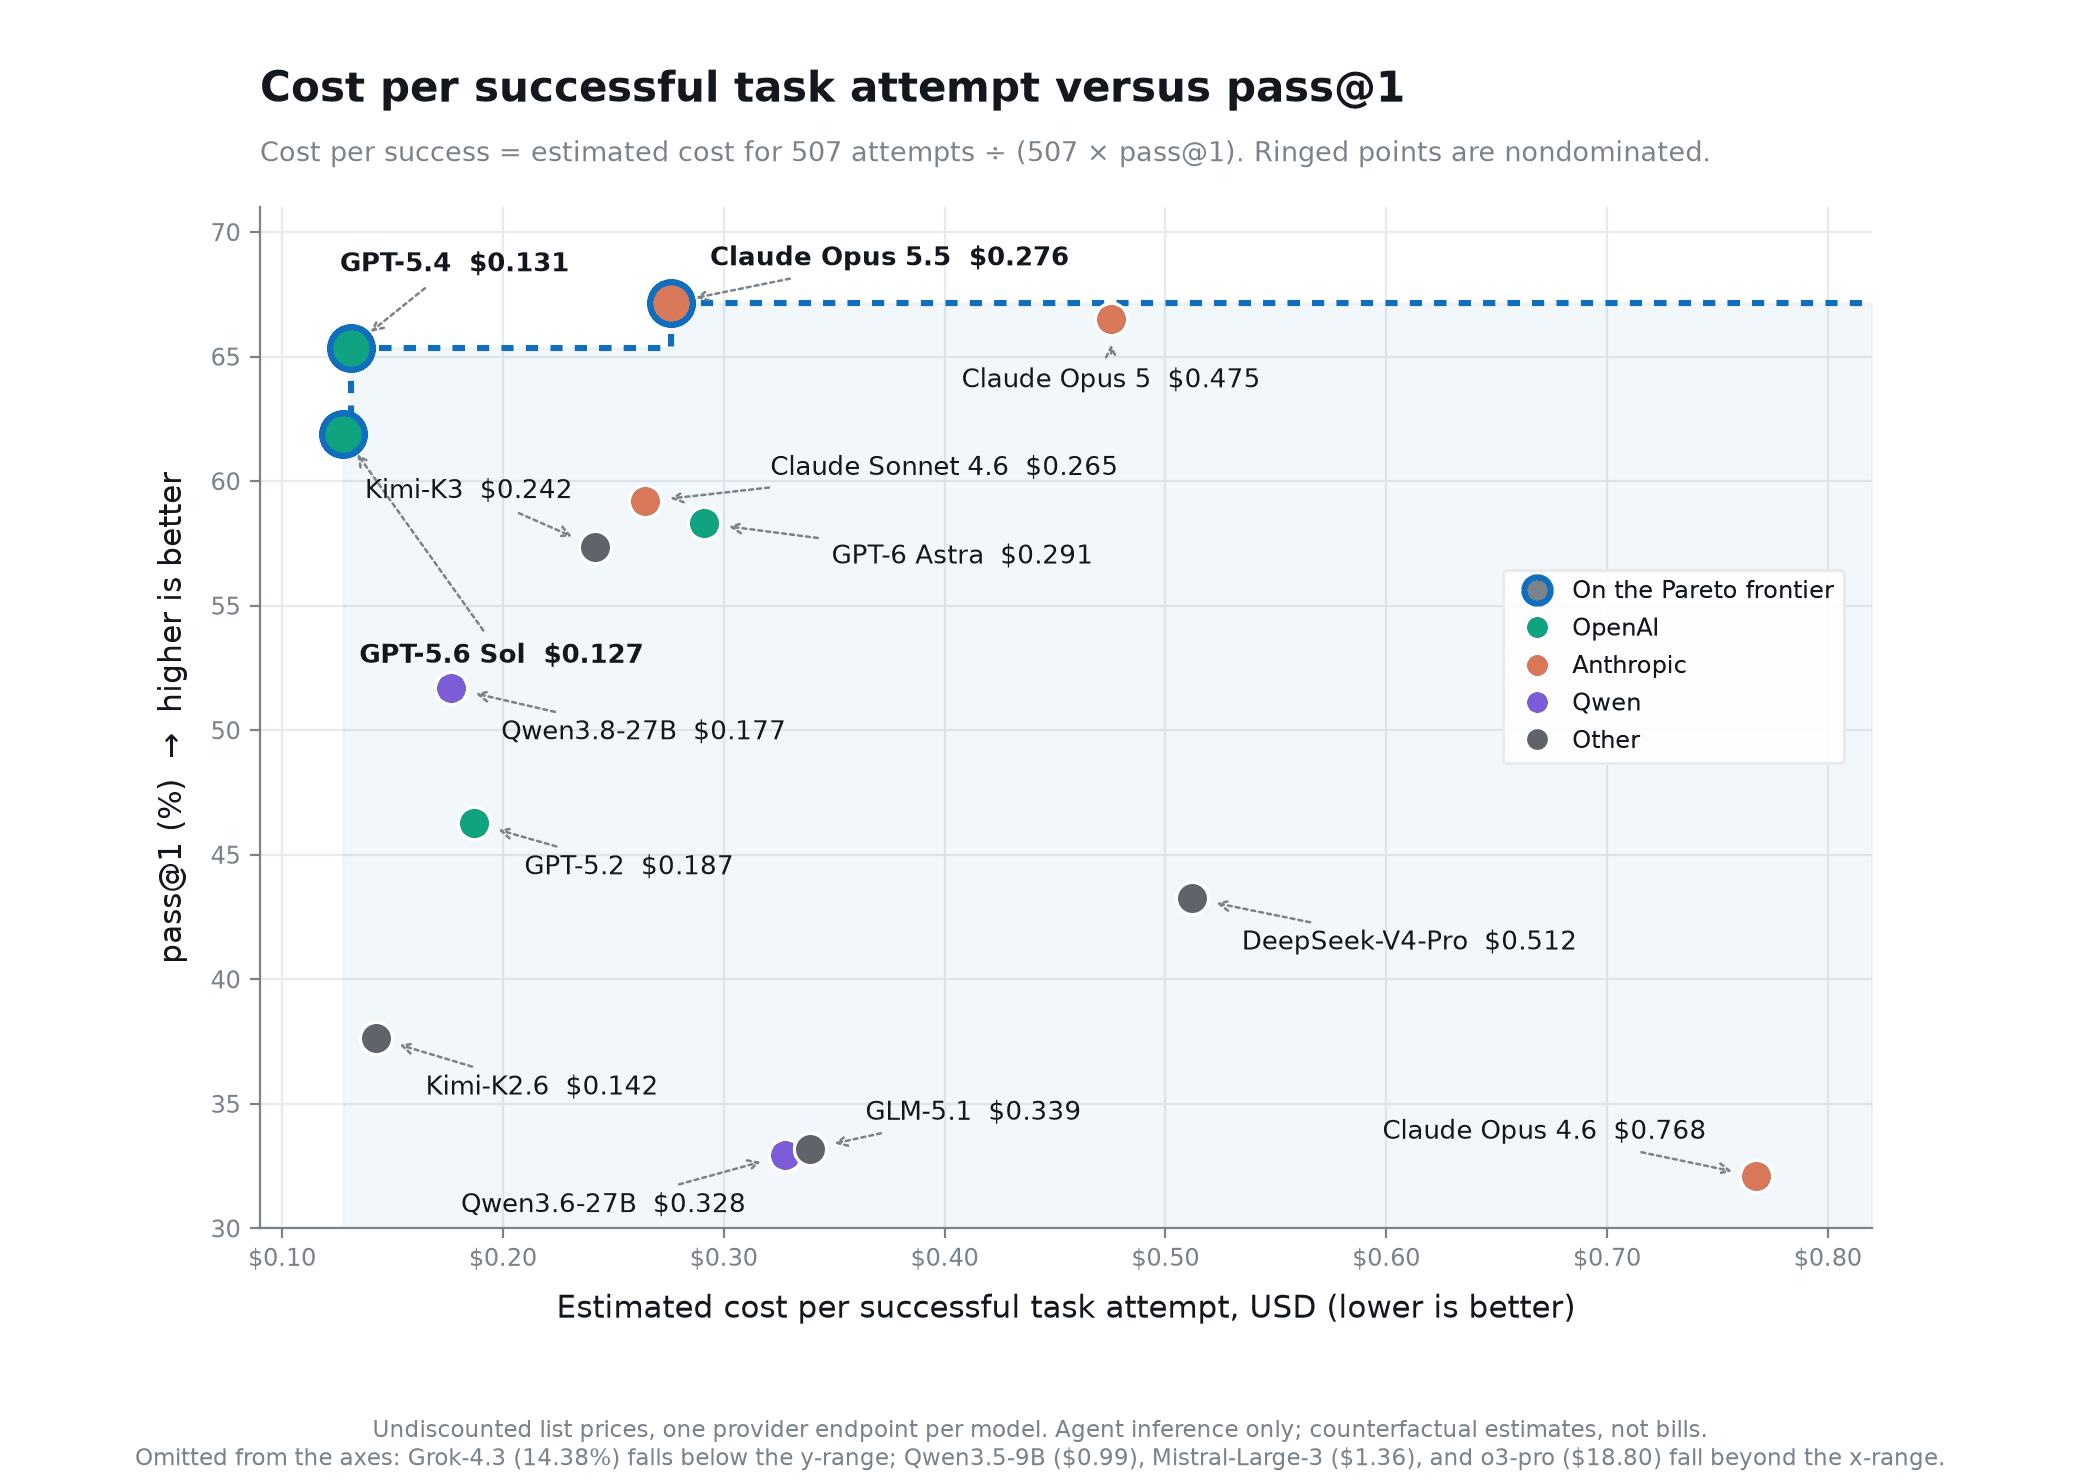
รูปภาพที่ 4: แนวหน้าของต้นทุนพาเรโต (Pareto cost frontier) แสดงโมเดลที่คุ้มค่าที่สุดในแต่ละระดับความแม่นยำ
แนวหน้ามี 3 ระดับ: GPT-5.6 Sol (คุ้มค่าที่สุดที่ $0.127), GPT-5.4 (สมดุล) และ Claude Opus 5.5 (แม่นยำสูงสุดในกลุ่มคุ้มค่าที่ $0.276)
เมื่อคำนวณ ต้นทุนต่องานที่พึ่งพาได้ (วัดจากงานที่ผ่าน 20/20) GPT-5.4 กลับเป็นโมเดลที่ถูกที่สุด ($6.80) ตามด้วย GPT-6 Astra ($7.45) และ Claude Opus 5.5 ($7.80)
รูปแบบความล้มเหลว
จากการวิเคราะห์พบว่า 80% ของความล้มเหลวมาจาก การจัดการเครื่องมือ ไม่ใช่การใช้เหตุผล (reasoning) โดยส่วนใหญ่ agent จะล้มเหลวในการกู้คืนจากข้อผิดพลาดของระบบหรือเงื่อนไขเบื้องต้นที่ไม่ผ่าน
แนวทางแก้ไขคือการใช้สัญญาณจากฐานข้อมูลจริงในการตรวจสอบสถานะก่อน commit ข้อมูล, จำกัดขอบเขตการเรียกใช้เครื่องมือให้แคบลง และกำหนดให้มนุษย์เข้ามาตรวจสอบในจุดที่สำคัญ
การทำงาน
ThinkingBox-Bench ทำงานในรูปแบบ sandbox ที่แยกส่วนชัดเจน ทุกการทดสอบจะเริ่มจากฐานข้อมูลที่สะอาดและไม่มีข้อมูลค้างจากการรันครั้งก่อน
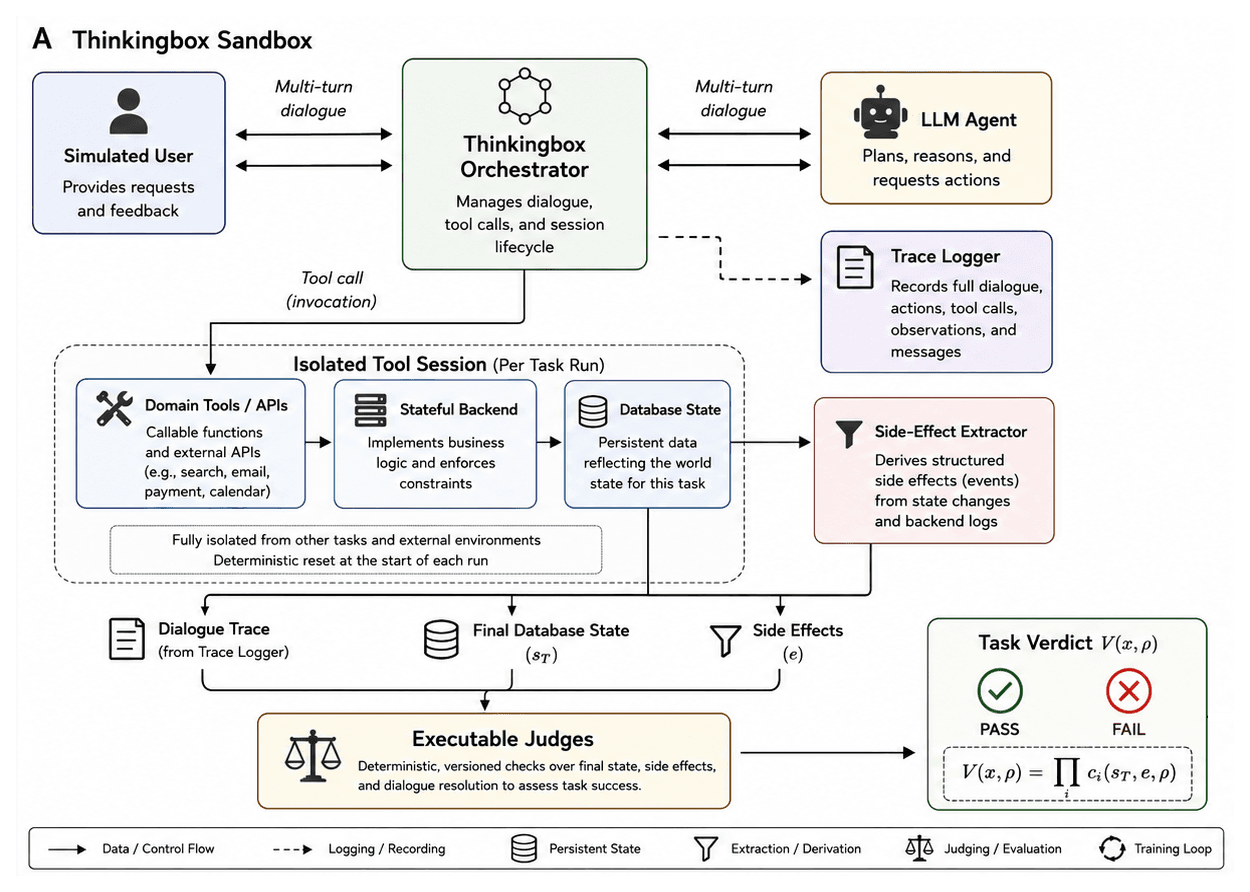
รูปภาพที่ 5: ลูปการทำงานของ sandbox และกระบวนการตัดสินผล
ระบบจะใช้ผู้ตัดสินแบบ Deterministic ในการเปรียบเทียบสถานะฐานข้อมูลสุดท้ายกับค่าที่ต้องการ เพื่อให้มั่นใจว่า agent สร้างผลลัพธ์ที่ถูกต้องจริงโดยไม่มีผลกระทบส่วนเกิน
รันด้วยตัวเอง
คุณสามารถใช้งาน ThinkingBox ผ่าน OpenEnv บน Hugging Face ได้แล้ว รองรับ Linux และ WSL โดยต้องใช้ Python 3.11+, uv และ Docker
ขั้นตอนการติดตั้ง
# 1. ติดตั้ง OpenEnv
git clone https://github.com/huggingface/OpenEnv
cd OpenEnv
uv sync --project envs/thinkingbox_env --frozen

# 2. ดาวน์โหลดชุดข้อมูล
git clone https://github.com/microsoft/thinkingbox-data
git -C thinkingbox-data checkout thinkingbox-bench-v1.0

# 3. ติดตั้ง ThinkingBox CLI
uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox"
(ดูรายละเอียดการตั้งค่า Typesense และ MCP เซิร์ฟเวอร์ในเอกสารฉบับเต็ม)
ก้าวต่อไป
เป้าหมายของ ThinkingBox คือการสร้างสภาพแวดล้อมเพื่อประเมิน AI agent ในโลกความจริง:
- ตรวจสอบความล้มเหลว: เลิกดูแค่คำตอบ แต่ให้ดูการเปลี่ยนแปลงในฐานข้อมูล
- ทดสอบด้วยโมเดลของคุณ: ลองรันงานผ่าน OpenEnv
- รายงานความสม่ำเสมอ: ใช้เมทริกซ์ที่วัดผลจากการทำซ้ำ (every-of-k)
ข้อมูลเพิ่มเติมที่ microsoft/ThinkingBox-Bench หรืออ่านงานวิจัยฉบับเต็มได้ที่ arXiv:2608.19741
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร