
Google เปิดตัว AQuA เครื่องมือโอเพนซอร์สช่วยวินิจฉัย AI Agent ในการใช้งานจริง
8 ต.ค. 2026
บ่อยครั้งที่ AI Agent ของคุณส่งคืนค่า HTTP 200 ทำงานได้รวดเร็วตามกำหนด และไม่มีเครื่องมือใดแจ้งข้อผิดพลาด แต่กลับทำงานผิดพลาดในระดับตรรกะ เช่น บันทึกการยืนยันที่นั่ง 3A โดยไม่ตรวจสอบว่าว่างหรือไม่ หรือแนะนำร้านสเต็กให้กับผู้ใช้ที่เป็นมังสวิรัติ
ทีมพัฒนาที่ใช้งาน Agent ในระดับ Production มักต้องเผชิญกับคำถามสำคัญ 3 ข้อ ได้แก่ Agent ทำงานเป็นอย่างไร? รูปแบบความล้มเหลวซ้ำๆ คืออะไร? และจะปรับปรุงคุณภาพให้ดีขึ้นอย่างต่อเนื่องโดยไม่ให้เกิดการถดถอย (Regression) ได้อย่างไร?
การพัฒนา Agent ให้ผ่านการทดสอบ 80% แรกในสถานการณ์ที่คาดการณ์ได้นั้นทำได้รวดเร็วผ่านวงจรการรัน (run), ให้คะแนน (grade) และแก้ไข (fix) แต่ความท้าทายที่แท้จริงคือ 20% ที่เหลือหลังการเปิดตัว ซึ่งพฤติกรรมผู้ใช้เริ่มเปลี่ยนไป และระบบเบื้องหลังมีการอัปเกรดอยู่เสมอ ทำให้คุณภาพการสนทนาอาจลดลงโดยที่ระบบ Health Check ปกติไม่แจ้งเตือน
รูปที่ 1. คุณภาพของ Agent พุ่งสูงขึ้นอย่างรวดเร็วก่อนเปิดตัว จากนั้นจึงเกิดความผันผวนในการใช้งานจริง
รูปที่ 2. ทุกการตรวจสอบโครงสร้างพื้นฐาน (infrastructure health check) ยังคงเป็นสีเขียว ความล้มเหลวนั้นเกิดขึ้นอย่างเงียบเชียบภายในบทสนทนา
เมื่อเกิดข้อผิดพลาด การหาสาเหตุนั้นทำได้ยากเพราะต้องแยกแยะหลายเลเยอร์ ไม่ว่าจะเป็น model ที่เกิด Hallucination, orchestration harness ที่ส่งงานผิดตัว, tool contract ที่ข้อมูลไม่ตรง Schema หรือแม้แต่ instructions ที่ขาดกฎเกณฑ์สำคัญ
การระบุสาเหตุต้องอาศัยการอ่านบันทึกการทำงาน (trajectory) ควบคู่กับรหัส Source Code เวอร์ชันที่ใช้งานขณะนั้น ซึ่งในปริมาณการใช้งานจริงที่มหาศาล ไม่มีใครสามารถตรวจสอบทุกบทสนทนาด้วยมือได้
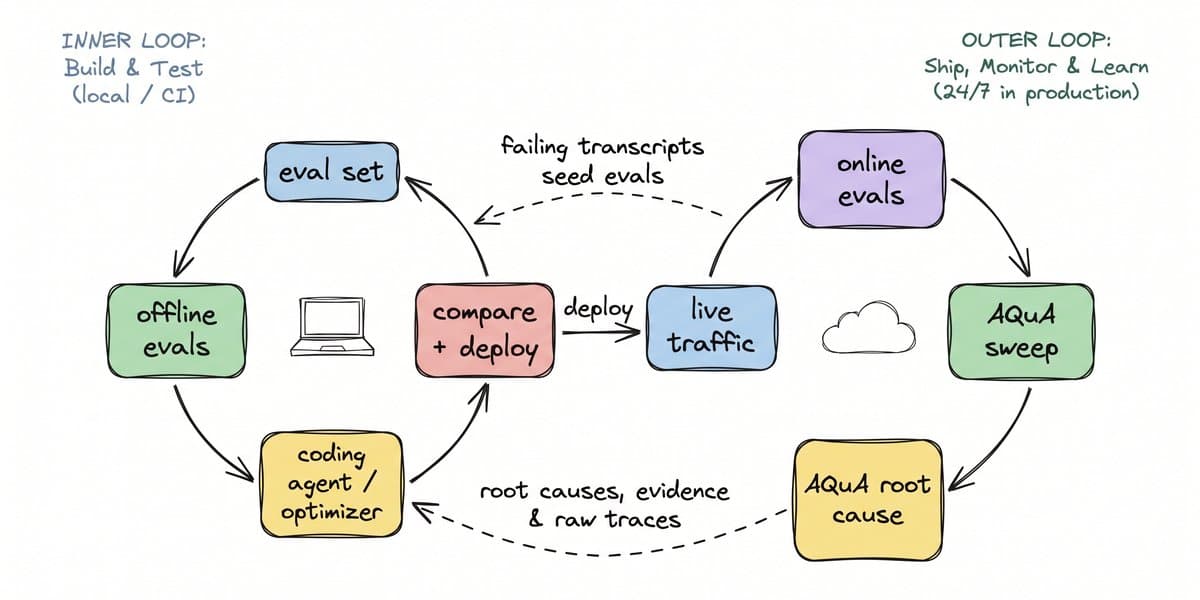
รูปที่ 3. AQuA ทำงานใน outer loop ของ production และส่งสิ่งที่พบกลับไปยัง inner loop ของคุณ
Google จึงได้เปิดตัว AQuA (Ambient Quality Agent) เป็นเครื่องมือโอเพนซอร์สในรูปแบบ building blocks ที่ประกอบกันได้ เพื่อช่วยดูแลคุณภาพของ Agent อย่างต่อเนื่องบน Google Cloud โดยรวบรวมข้อมูลจาก Cloud Trace, Cloud Logging หรือ BigQuery นอกเส้นทาง Request Path ปกติ
รูปที่ 4. AQuA รันควบคู่ไปกับ agent ของคุณในโปรเจกต์ Google Cloud โดยอ่าน trajectories และ source snapshots ตอน deploy นอกเส้นทาง request path
การทำงานของ AQuA แบ่งออกเป็น 5 ขั้นตอนหลัก ได้แก่:
รูปที่ 5. pipeline การกวาดข้อมูลห้าขั้นตอนจะเปลี่ยน production sessions ดิบๆ ให้เป็นข้อมูลเชิงลึกที่ได้รับการตรวจสอบแล้ว พร้อมการวินิจฉัยสาเหตุหลัก (root-cause) ที่รันตามความต้องการเทียบกับ source snapshot ที่ถูก deploy ไว้
- Sample: ดึงตัวอย่างสูงสุด 1,000 sessions ล่าสุด
- Review: ให้คะแนนแต่ละ session ตามรายการตรวจสอบ 9 ข้อ หากล้มเหลวจะสร้างความต่างระหว่าง
actual / expectedแบบโครงสร้าง - Cluster: จัดกลุ่มปัญหาที่มีกลไกความล้มเหลวคล้ายกัน
- Verify: ใช้โมเดลแยกต่างหากตรวจสอบเพื่อตัดรายการที่เป็น False Positive
- Track: ติดตามสถานะปัญหาใน BigQuery ว่าเป็นปัญหาใหม่ (NEW), เกิดซ้ำ (RECURRING) หรือแก้ไขแล้ว (RESOLVED)
เปรียบเสมือนมี วิศวกรคุณภาพระดับจูเนียร์ คอยคัดกรองปัญหาและเตรียมหลักฐานให้ทีมที่ดูแล ระบบนี้รองรับการเขียน developer goal (goal.md) เพื่อกำหนดทิศทาง และการใช้ custom metrics ด้วย Python เพื่อวัดผลตามความต้องการของธุรกิจ
เมื่อพบประเด็นสำคัญ คุณสามารถเริ่มการวิเคราะห์สาเหตุหลัก (Root-cause analysis) ได้ทันที โดย AQuA จะเปรียบเทียบข้อมูลที่ล้มเหลวกับ Source Snapshot ของเวอร์ชันที่ Deploy ไว้ และเสนอจุดแก้ไขโดยระบุบรรทัดโค้ดอย่างแม่นยำ
จากการทดสอบกับระบบ travel-concierge ซึ่งมี Agent ย่อยหลายตัว AQuA สามารถตรวจพบปัญหาสำคัญ เช่น การข้ามขั้นตอนตรวจสอบที่นั่ง หรือการทำข้อมูลข้อจำกัดด้านอาหารของผู้ใช้หล่นหายขณะส่งต่องานระหว่าง Agent ช่วยให้ทีมพัฒนาแก้ไขโค้ดและเพิ่มอัตราความสำเร็จของงานได้มากกว่าสองเท่าในการ Deploy เวอร์ชันถัดไป
รูปที่ 6. ข้อมูลเชิงลึกที่ได้รับการตรวจสอบแล้วจากการกวาดข้อมูล travel-concierge เรียงตามจำนวน session ที่ได้รับผลกระทบ
รูปที่ 7. มุมมองรายละเอียดข้อมูลเชิงลึกในแดชบอร์ด แสดงสรุปความล้มเหลวและ session traces ทั้ง 15 รายการที่เชื่อมโยงกัน
รูปที่ 8. การวินิจฉัยสาเหตุหลักในแชทบนแดชบอร์ด โดยยึดการเสนอแก้ไขคำสั่ง (instruction) เข้ากับ source snapshot ที่ deploy ไว้
หัวใจสำคัญของ AQuA คือความโปร่งใส ทุกข้อค้นพบจะถูกลิงก์ไปยัง Session ID ใน Cloud Trace และระบุบรรทัดโค้ดที่อ้างอิงได้จริง โดยมีการควบคุมค่าใช้จ่ายที่คาดการณ์ได้ เช่น การตรวจสอบ 32 sessions ในระบบที่ซับซ้อนมีค่าใช้จ่ายรวมเพียงประมาณ $3.76 เท่านั้น
Google เปิดให้ใช้งาน AQuA แบบโอเพนซอร์สแล้ว เพื่อร่วมมือกับนักพัฒนาในการกำหนดทิศทางวิศวกรรมคุณภาพของ AI Agent ในอนาคต ไม่ว่าจะเป็นการกรองสัญญาณความล้มเหลวที่เงียบเชียบ หรือการเปลี่ยนกลุ่มปัญหาให้เป็น Test Case ใน Sandbox สำหรับการเรียนรู้ด้วยตนเองของ Agent
ผู้ที่สนใจสามารถทดลองใช้งานผ่านชุดคำสั่ง:
git clone https://github.com/google/adk-recipes.git
cd adk-recipes/core/python/ambient-quality-agent
make demo # รันแดชบอร์ดในเครื่องด้วยข้อมูลจำลอง
หรือศึกษาเพิ่มเติมได้ที่ Ambient Quality Agent repository และบทความเกี่ยวกับการขับเคลื่อนคุณภาพ Agent จาก Google Developers Blog
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร