
TinyFish เปิดตัวค้นหาฟรี: เจาะลึกต้นทุนแฝงของ AI Agent บนเว็บ
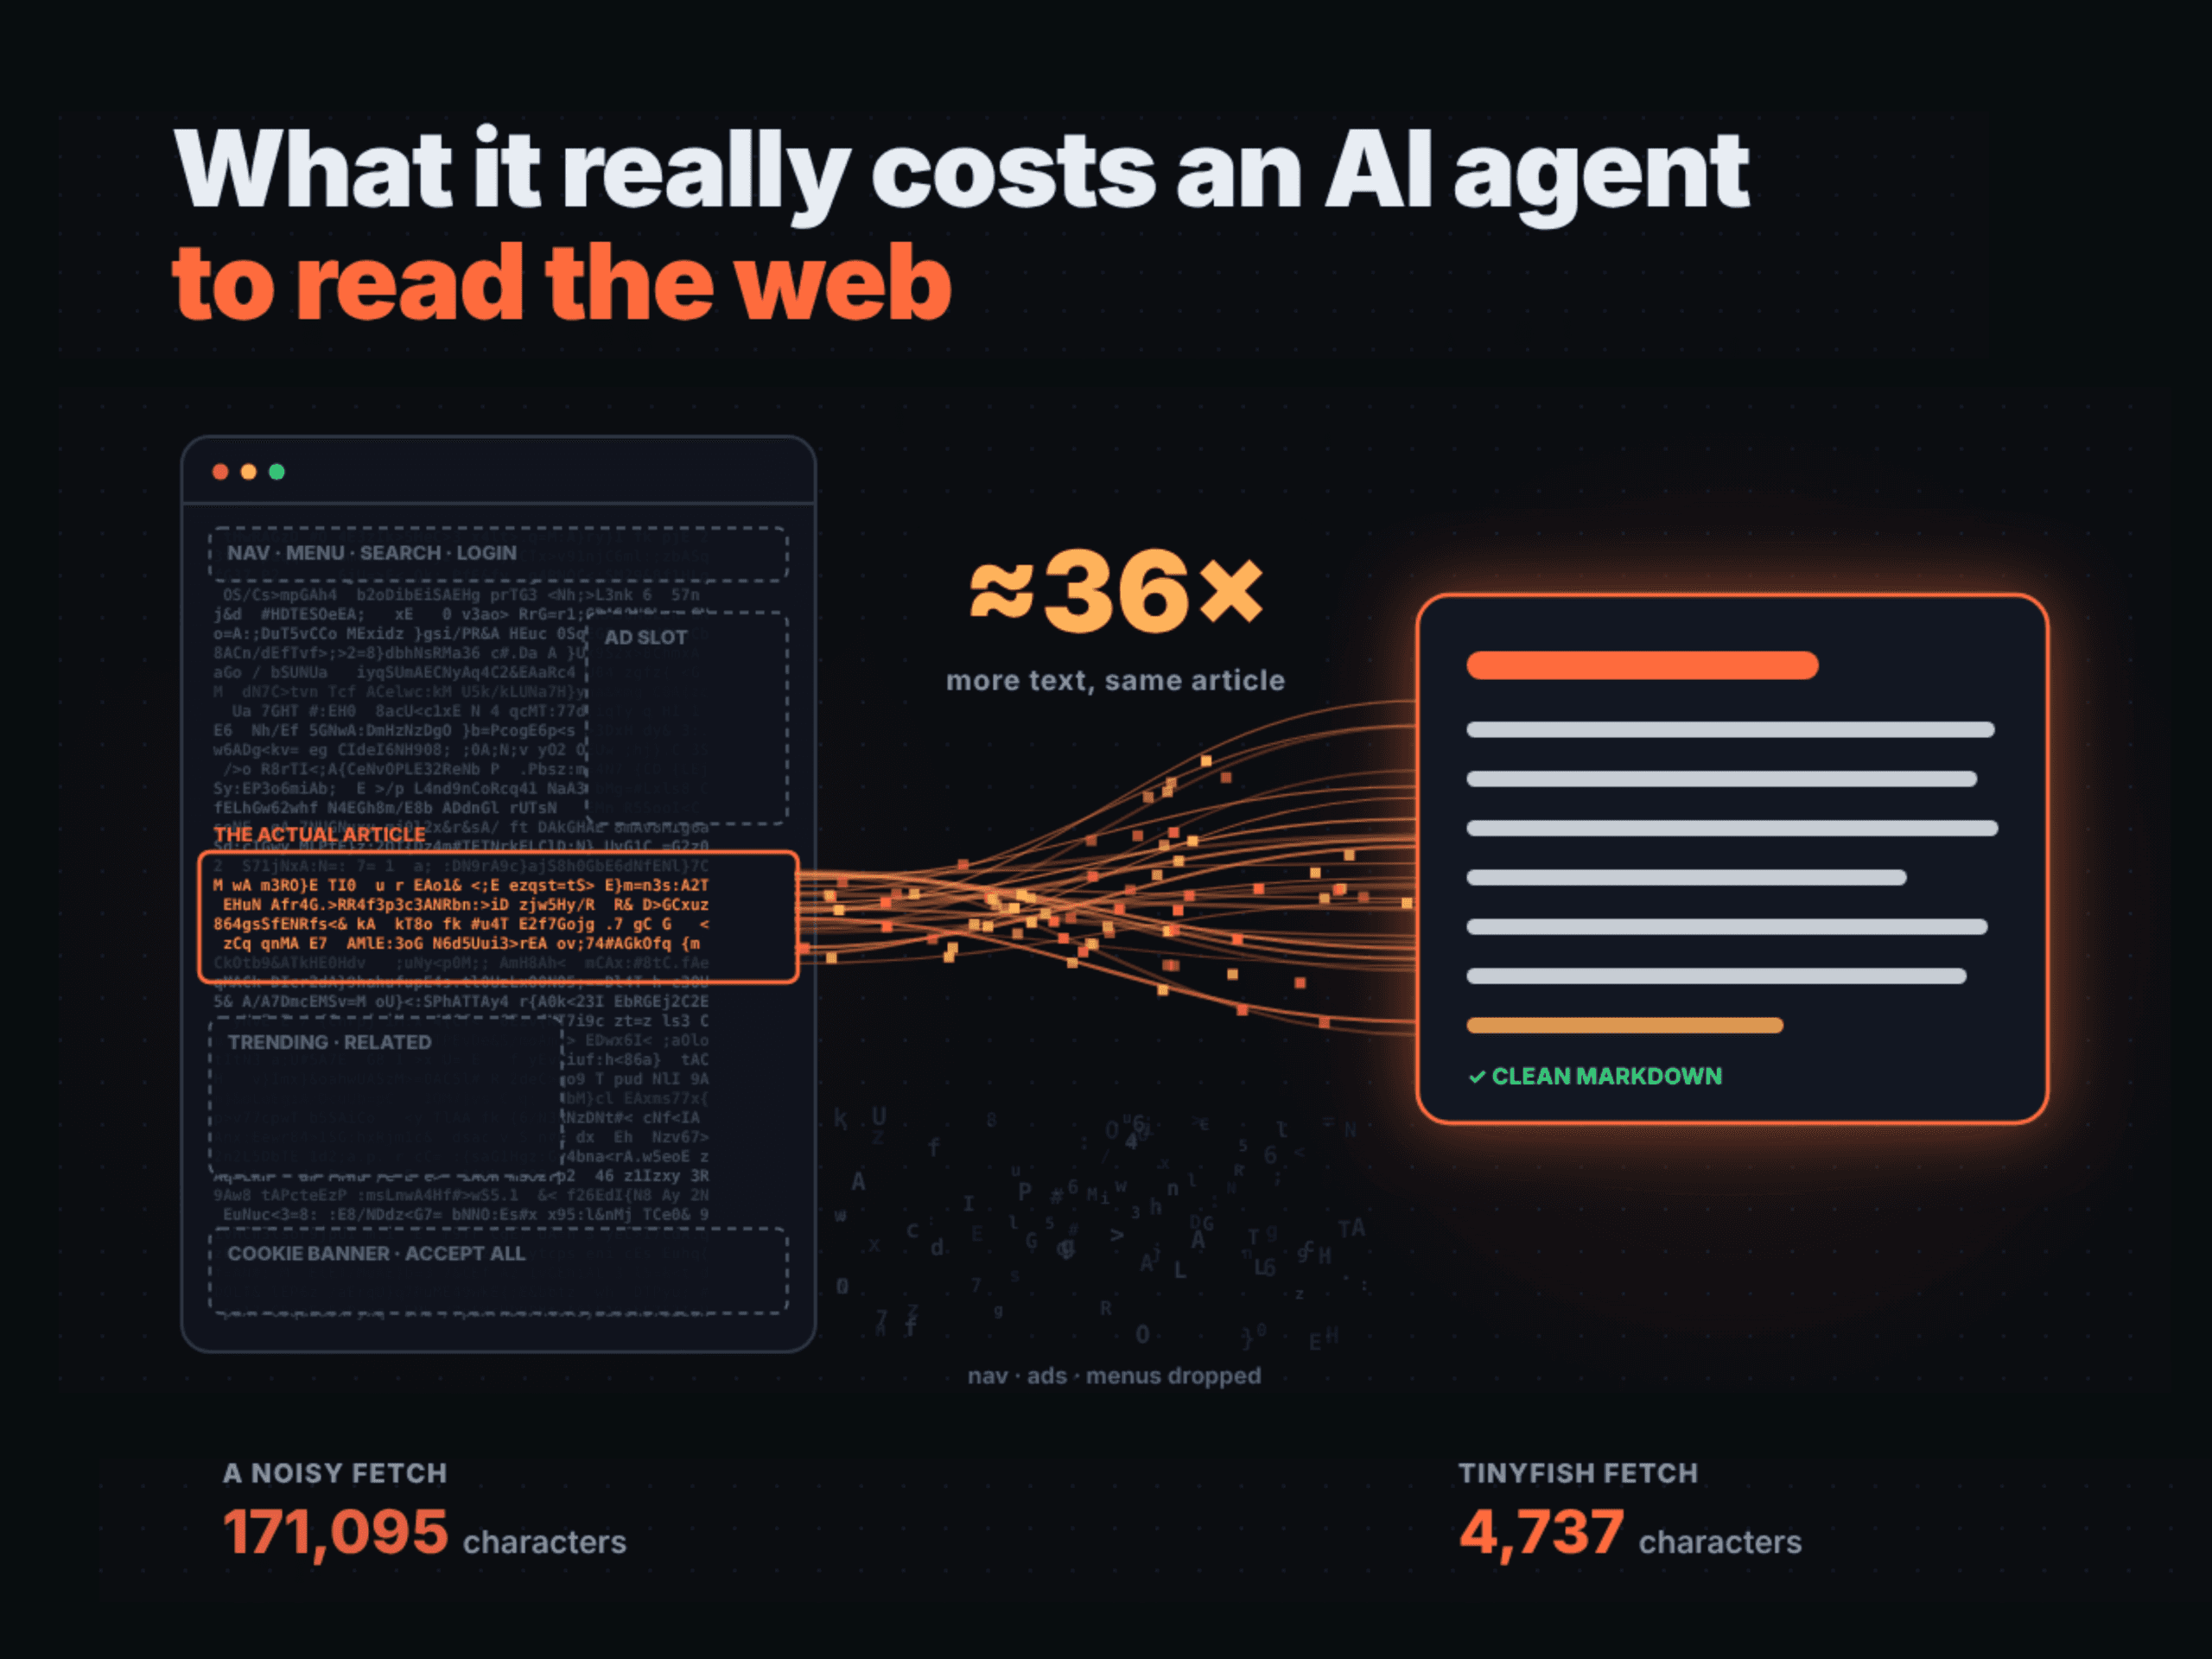
AI agent ที่อ่านข้อมูลบนเว็บต้องเผชิญกับต้นทุน 2 ประเภทหลัก ประเภทแรกคือค่าบริการดึงข้อมูล (retrieval charge) ซึ่งเรียกเก็บโดย search หรือ fetch API ต่อการส่งคำขอ (request) ส่วนประเภทที่สองคือค่าประมวลผลของโมเดล โดยเนื้อหาจากหน้าเว็บที่ดึงมาจะถูกนับเป็น input tokens ขณะที่การให้เหตุผลและการสร้างคำตอบจะเพิ่มต้นทุนในส่วน output ต่อไปอีก
TinyFish บริษัทโครงสร้างพื้นฐานเว็บสำหรับ AI agents ตั้งข้อสังเกตว่า ทีมพัฒนามักให้ความสำคัญกับงบประมาณด้านโมเดล แต่กลับประเมินผลกระทบของต้นทุนจากเนื้อหาที่ดึงมาต่ำเกินไป บทความนี้จะพาไปวิเคราะห์การคำนวณ token ผลกระทบต่อ context-window และข้อมูลจาก Artificial Analysis Search API leaderboard
TL;DR
- ระบบการทำงาน: TinyFish ใช้ web-native AI model ที่ออกแบบมาเพื่อการค้นหาและโต้ตอบกับเว็บไซต์โดยเฉพาะ ทำงานบนโครงสร้างพื้นฐานที่จัดการโดย TinyFish และใช้ browser บน cloud ในการเรนเดอร์หน้าเว็บ ไม่ต้องใช้ GPU ภายในเครื่อง รองรับ REST, Python, TypeScript SDKs, CLI และ MCP
- ประสิทธิภาพ: จากข้อมูล snapshot ของ Artificial Analysis เมื่อวันที่ 28 กันยายน 2026 TinyFish Search (web) ทำได้ 71 คะแนน ที่ราคา $9.30 ต่อ 1,000 benchmark tasks โดยใช้เวลาเฉลี่ย 59.0 วินาทีต่อ task
- จุดเด่น: ค่าดึงข้อมูล $0 ภายใต้เงื่อนไขที่กำหนด (Search: 30 requests/นาที, Fetch: 150 URLs/นาที) ถือเป็นระบบที่มีต้นทุนรวมต่ำที่สุดในบรรดา 12 การตั้งค่าบน leaderboard
- ข้อแลกเปลี่ยน: ใช้เวลาประมวลผลต่อ task นานที่สุดเป็นอันดับสอง และไม่สามารถสลับโมเดลที่ติดตั้งมาในตัวได้
- คะแนน: คะแนนสูงสุดคือ Perplexity Search (medium) ที่ 80 ส่วนคะแนนต่ำสุดคือ TinyFish Search (web) ที่ 71 ขณะที่เกณฑ์มาตรฐานแบบไม่มีการค้นหา (no-search baseline) อยู่ที่ 33
ค่าบริการดึงข้อมูล vs ต้นทุนการประมวลผลของโมเดล โดยปกติ Search และ fetch API จะเก็บเงินต่อ request ซึ่งข้อมูลที่ส่งกลับมาจะกลายเป็น input tokens ใน context ของโมเดลและถูกคิดเงินตามจริง ส่วนการให้เหตุผล (reasoning) และ output จะถูกคิดแยกต่างหาก
ปัจจุบันองค์กรต่างๆ มีแนวโน้มเลือกใช้โมเดลที่ราคาถูกที่สุดเพื่อลดต้นทุน ดังจะเห็นได้จากการที่ Stripe ตกลงเข้าซื้อกิจการ OpenRouter ซึ่งเป็น gateway รวมโมเดลกว่า 400 แบบ การเลือกเส้นทางโมเดล (routing) อาจช่วยลดราคาต่อ token ได้ แต่ไม่ได้ช่วยลดปริมาณ token ที่เกิดจากหน้าเว็บที่ดึงมา
แม้บริการฟรีของ TinyFish จะช่วยกำจัดค่าบริการดึงข้อมูลออกไปได้ แต่โมเดลปลายทางยังคงมีต้นทุนการอนุมาน (inference costs) อยู่เสมอ ดังนั้นขนาดของหน้าเว็บที่ส่งกลับมาจึงมีผลอย่างมากต่อค่าใช้จ่ายรวม
หนึ่งหน้าเว็บมีขนาดกี่ tokens?
จากการ ประเมินคุณภาพการดึงข้อมูล เมื่อวันที่ 2 มิถุนายน 2026 โดยทดสอบกับ 45 URLs พบว่าในบทความ Daily Mail หนึ่งชุดที่มีความยาวประมาณ 4,300 ตัวอักษร ผู้ให้บริการแต่ละรายส่งกลับข้อมูลในขนาดที่ต่างกันมาก:
| ผู้ให้บริการ | ตัวอักษรที่ส่งกลับมา | ประมาณการ tokens* | ต้นทุน Input ที่ $1 / 1M tokens* |
|---|---|---|---|
| TinyFish Fetch | 4,737 | ~1,184 | ~$0.00118 |
| Exa Contents | 65,793 | ~16,448 | ~$0.01645 |
| Firecrawl Scrape | 171,095 | ~42,774 | ~$0.04277 |
| Tavily Extract | 46,433 | ~11,608 | ~$0.01161 |
| Parallel Extract | 600 (ข้อความตัดตอน) | ~150 | ~$0.00015 |
การคำนวณโดย Marktechpost: อ้างอิงประมาณ 4 ตัวอักษรต่อ token และราคา input สมมติที่ $1 ต่อ 1M tokens ข้อมูลจริงอาจแตกต่างกันตาม tokenizer และเงื่อนไขของแต่ละบริการ
จากตัวอย่างนี้ Firecrawl ส่งข้อมูลกลับมามากกว่า TinyFish ถึง 36 เท่า ขณะที่ Parallel ส่งเพียงข้อความตัดตอนซึ่งไม่สามารถเปรียบเทียบคุณภาพกับการดึงข้อมูลเต็มหน้าได้โดยตรง ขนาดของข้อมูลที่ส่งกลับมาจึงส่งผลต่อการบริโภค token อย่างมีนัยสำคัญ
ขีดจำกัด Context และการเรียกซ้ำ
หากดึงข้อมูลหน้าเว็บขนาด 42,774 tokens เข้าสู่โมเดลโดยตรง จะกินพื้นที่ไปถึงหนึ่งในสามของ context window ขนาด 128K-token การดึงข้อมูลเพียง 3 หน้าอาจทำให้พื้นที่เต็มทันที จนไม่เหลือพื้นที่สำหรับ system instructions หรือประวัติการสนทนา
นอกจากนี้ ลูปการทำงานของ Agent มักมีการส่ง context ซ้ำในแต่ละรอบ แม้การทำ caching จะช่วยลดต้นทุนในการอ่านหน้าเว็บที่มีข้อมูลรบกวน (noisy page) ได้บ้าง แต่ข้อมูลเหล่านั้นยังคงกินพื้นที่ใน window อยู่ดี
ในการทดสอบภายใน TinyFish พบว่าอัตราการครอบคลุมข้อมูล (coverage) ของตนเองอยู่ที่ 93% สูงกว่าคู่แข่งอย่าง Tavily (80%) หรือ Exa (73%) โดย TinyFish มีค่ามัธยฐานของ signal อยู่ที่ 90.5% ซึ่งถือว่าสูงมากในกลุ่มข้อมูลประเภทหน้าข่าว
ทำไม TinyFish ถึงให้การดึงข้อมูลฟรี
TinyFish มองว่าการค้นหาควรเป็นส่วนประกอบพื้นฐานของระบบเหมือนกับ DNS หรือ storage โดยให้ความสำคัญกับความสำเร็จของงาน (execution) เป็นหลัก ซึ่งโครงสร้างพื้นฐานที่ทำให้บริการนี้ฟรีได้ประกอบด้วย:
- โครงสร้างพื้นฐานร่วม: การสร้างระบบ browser และ stealth systems ไว้รองรับงานหลายรูปแบบ ทำให้ต้นทุนส่วนเพิ่ม (marginal cost) ของการค้นหาลดลง
- โมเดลเฉพาะทาง: web-native AI model ถูกออกแบบมาเพื่อลดการพึ่งพาโมเดลทั่วไป (general-purpose models) ในขั้นตอนกลางของการทำงานบนเว็บ
- ไม่เน้นการทำ Index: TinyFish มุ่งเน้นไปที่การเรียนรู้วิธีทำงานให้สำเร็จมากกว่าการแข่งขันเป็นบริษัททำ indexing ขนาดใหญ่
อย่างไรก็ตาม TinyFish ยังคงคิดค่าบริการในส่วนอื่น เช่น Agent ราคา $0.016 ต่อ step และ Browser ราคา $0.002 ต่อนาที ขณะที่ Search และ Fetch ฟรีภายใต้ขีดจำกัดที่ หน้าต้นทุน (pricing page) กำหนดไว้
สิ่งที่เกณฑ์มาตรฐานแสดง และสิ่งที่ไม่ได้แสดง
การทดสอบโดย Artificial Analysis ซึ่งกำหนดให้ใช้โมเดลคำตอบเดียวกัน (GPT-5.6 Luna) แสดงให้เห็นว่า TinyFish มีต้นทุนรวมต่อ 1,000 tasks ต่ำที่สุดที่ $9.30 (ค่าค้นหา $0 + ค่าโมเดล) เมื่อเทียบกับคู่แข่งรายอื่นที่มีต้นทุนระหว่าง $8.04 ถึง $21.65
อย่างไรก็ตาม คะแนน Search Index ของ TinyFish อยู่ที่ 71 ซึ่งต่ำที่สุดในกลุ่มที่นำมาแสดง และมีความเร็วเฉลี่ย 59 วินาทีต่อ task ซึ่งรวมเวลาค้นหาและการประมวลผลของโมเดลเข้าด้วยกันแล้ว
การเปรียบเทียบ TinyFish กับคู่แข่ง
| คุณสมบัติ | TinyFish | Exa | Firecrawl | Parallel |
|---|---|---|---|---|
| ราคา Search | ฟรี (ตามโควตา) | เริ่มต้น $4 / 1k req. | 2 credits / 10 ผลลัพธ์ | $1-$5 / 1k req. |
| การดึงข้อมูล | ฟรี (ตามโควตา) | $1 / 1k หน้า | 1 credit / หน้า | $1 / 1k |
| โควตาฟรี | Search/Fetch ฟรี | $10 credits/เดือน | 1,000 credits/เดือน | $5 credits/เดือน |
| AA Search Index | 71 | 74 | 73 | 75 |
| ต้นทุนรวม/1k task | $9.30 | $83.30 | $42.57 | $59.22 |
ข้อมูล ณ วันที่ 7 ตุลาคม 2026 ราคาและความสามารถอาจมีการเปลี่ยนแปลงตามนโยบายของผู้ให้บริการ
ประเด็นสำคัญ
- AI Agent ต้องรับภาระทั้งค่าดึงข้อมูลและค่าประมวลผล Token ในทุกครั้งที่ทำงาน
- ปริมาณ Token จากหน้าเว็บเดียวกันอาจต่างกันได้หลายเท่าตัวขึ้นอยู่กับผู้ให้บริการ
- การดึงข้อมูลหน้าเว็บขนาดใหญ่เพียงไม่กี่หน้าอาจทำให้ Context Window เต็มได้
- บริการฟรีของ TinyFish ช่วยลดค่าดึงข้อมูล แต่ผู้ใช้ยังต้องแบกรับต้นทุนของโมเดลอยู่ดี
- TinyFish เป็นตัวเลือกที่ประหยัดที่สุดในขณะนี้ แต่ยังมีข้อจำกัดเรื่องคะแนนความแม่นยำและเวลาในการทำงาน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร