
แนะนำ 7 Python Libraries ยอดเยี่ยมเพื่อการวิเคราะห์ Time Series
Introduction
Time series analysis มีระบบนิเวศของ library ใน Python ที่หลากหลายและเฉพาะทางที่สุดอย่างหนึ่ง การเลือกเครื่องมือจึงขึ้นอยู่กับเป้าหมายของคุณ ไม่ว่าจะเป็นการพยากรณ์ทางสถิติ, machine learning pipelines, โมเดล deep learning หรือการตรวจจับความผิดปกติ ซึ่งแต่ละตัวจะมี API และข้อกำหนดข้อมูลที่แตกต่างกันไป
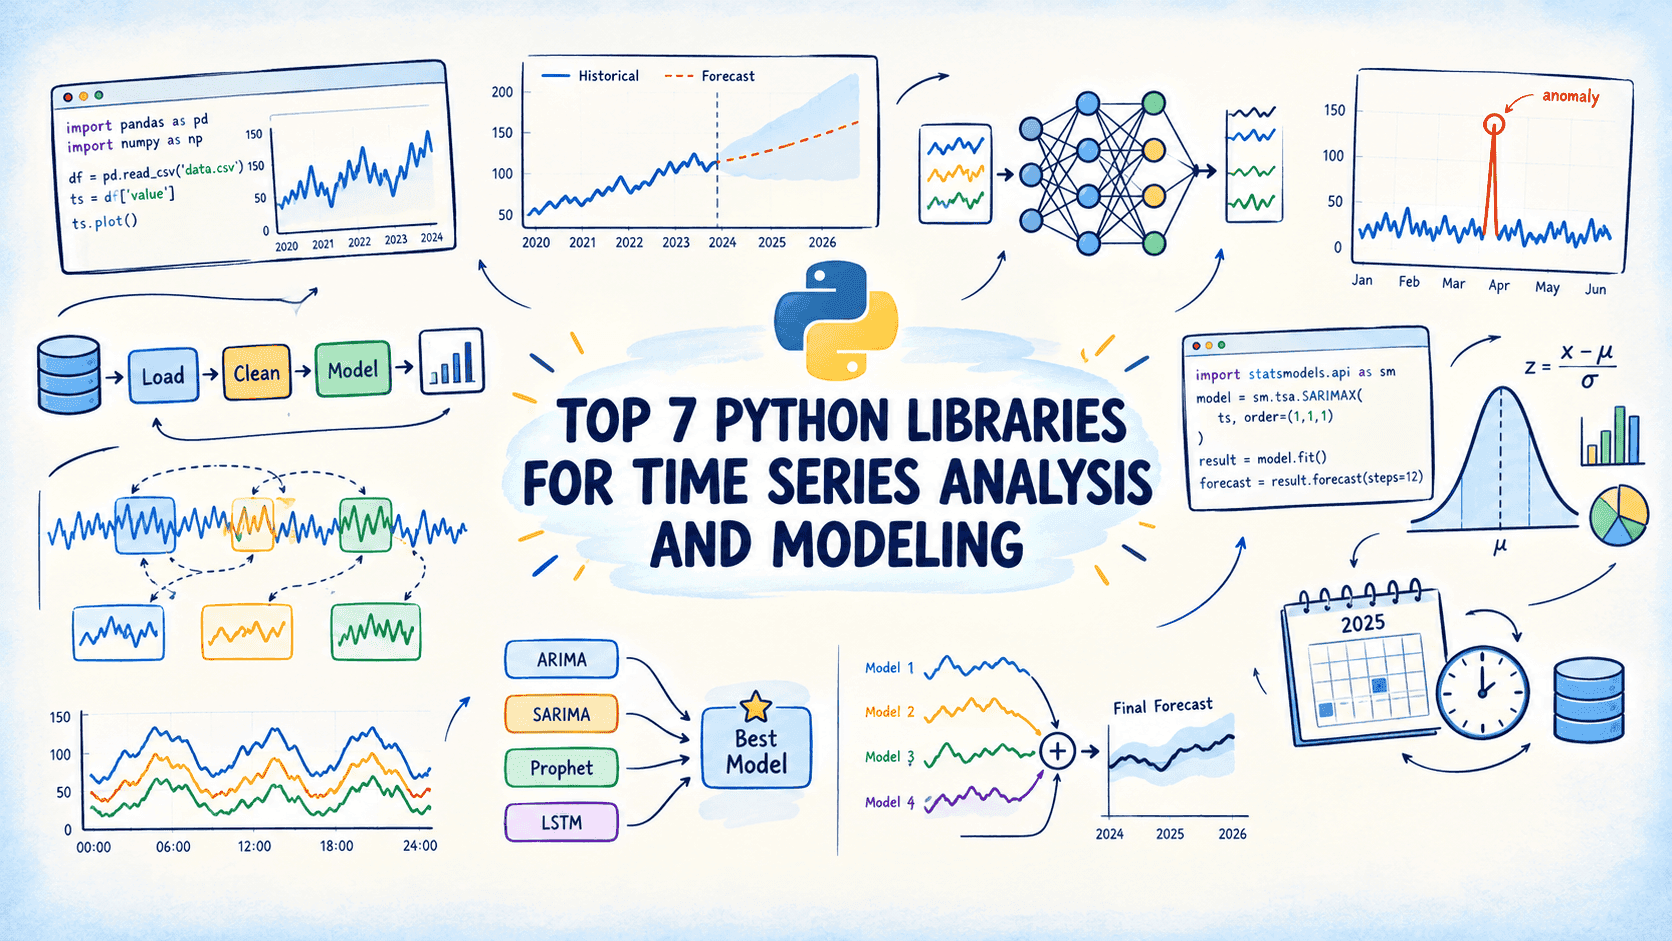
บทความนี้จะพาไปรู้จักกับ Python libraries 7 ตัวที่ช่วยให้งานด้านอนุกรมเวลาครบวงจร ประกอบด้วย:
- การพยากรณ์ทางสถิติแบบดั้งเดิมและระบบอัตโนมัติ
- machine learning pipelines ที่ขยายขนาดได้และการเลือกโมเดล
- การพยากรณ์ด้วย deep learning และโมเดลแบบรวมกลุ่ม (ensemble-based)
- การตรวจจับความผิดปกติ (anomaly detection), การวิเคราะห์ค่าผิดปกติ (outlier) และการค้นหารูปแบบซ้ำ (motif discovery)
1. การสร้างโมเดลพยากรณ์ทางสถิติด้วย statsmodels
หากความสามารถในการอธิบายโมเดล (interpretability) มีความสำคัญพอๆ กับความแม่นยำ statsmodels คือเครื่องมือแรกที่ควรเลือกใช้ มันเป็นรากฐานของการวิเคราะห์อนุกรมเวลาคลาสสิกใน Python ที่ใช้ในงานวิจัยเศรษฐศาสตร์และการเงินมานานหลายทศวรรษ
จุดเด่นของ statsmodels:
- รองรับโมเดลตระกูล ARIMA ทั้งหมด เช่น ARIMA และ SARIMAX สำหรับข้อมูลตามฤดูกาล พร้อมการคำนวณ AIC, BIC และแผนภูมิวินิจฉัยในตัว
- มีโมเดลการปรับเรียบเลขชี้กำลัง (exponential smoothing) ผ่าน ETSModel ครอบคลุมทั้งแนวโน้มและฤดูกาลแบบบวกและคูณ
- รวมชุดทดสอบทางสถิติที่จำเป็น เช่น Augmented Dickey-Fuller test สำหรับตรวจสอบความนิ่ง (stationarity) และ Ljung-Box test สำหรับตรวจสอบอัตสหสัมพันธ์
แหล่งข้อมูล: เอกสารการวิเคราะห์อนุกรมเวลาของ statsmodels และ ตัวอย่าง statsmodels
2. การเลือกโมเดลอัตโนมัติด้วย pmdarima
การหาค่าพารามิเตอร์ (p, d, q) ที่เหมาะสมสำหรับ ARIMA มักเป็นขั้นตอนที่ยุ่งยาก pmdarima จึงเข้ามาแก้ปัญหานี้ด้วยการนำฟังก์ชัน auto.arima จากภาษา R มาสู่ Python เพื่อช่วยเลือกโมเดลให้โดยอัตโนมัติ
คุณสมบัติหลักของ pmdarima:
auto_arimaค้นหาลำดับ ARIMA ที่ดีที่สุดด้วยคะแนน AIC หรือ BIC โดยไม่ต้องตีความแผนภูมิด้วยตนเอง- ใช้งานร่วมกับอินเทอร์เฟซ fit/predict ของ scikit-learn ได้ทันที
- ตรวจสอบความเป็นฤดูกาลก่อนเพิ่มพจน์ SARIMA ช่วยลดความเสี่ยงในการสร้างโครงสร้างฤดูกาลที่ไม่มีอยู่จริง
หมายเหตุ: pmdarima เหมาะสำหรับการทำเกณฑ์มาตรฐานที่รวดเร็ว แต่ปัจจุบันการพัฒนาอาจเริ่มช้าลง ควรตรวจสอบบันทึกการเปลี่ยนแปลงก่อนใช้ในระบบจริง
แหล่งข้อมูล: เอกสาร pmdarima และ คู่มือผู้ใช้ pmdarima
3. สร้าง Machine Learning Pipelines ครบวงจรด้วย sktime
sktime นำเสนออินเทอร์เฟซเดียวที่รวมทุกงานของอนุกรมเวลาไว้ด้วยกัน ไม่ว่าจะเป็นการพยากรณ์, การจำแนกประเภท หรือการจัดกลุ่ม ช่วยแก้ปัญหาความกระจัดกระจายของเครื่องมือต่างๆ ใน Python
เหตุผลที่ควรใช้ sktime:
- ใช้อินเทอร์เฟซที่สอดคล้องกัน ทำให้สลับไปมาระหว่าง ARIMA, gradient boosting หรือ neural network ได้โดยแก้โค้ดเพียงเล็กน้อย
- รองรับการสร้างเวิร์กโฟลว์ที่ทำซ้ำได้ ตั้งแต่การเตรียมข้อมูลไปจนถึงการ tuning และ ensembling
- มีระบบ cross-validation ที่เข้าใจลำดับเวลา เพื่อป้องกันปัญหาข้อมูลรั่วไหล (leakage)
- เชื่อมต่อโดยตรงกับ libraries สำคัญอย่าง scikit-learn, statsmodels, และ tsfresh
แหล่งข้อมูล: เอกสาร sktime และ ตัวอย่าง Notebook ของ sktime
4. การพยากรณ์ระดับสเกลด้วย Darts
Darts เน้นการใช้งานที่กว้างขวาง โดยมีจุดเด่นที่การพยากรณ์เชิงความน่าจะเป็น (probabilistic forecasting) และการจัดการชุดข้อมูลจำนวนมากพร้อมกัน (multi-series)
สิ่งที่ทำให้ Darts โดดเด่น:
- สร้างช่วงการพยากรณ์ (interval) แทนที่จะเป็นแค่ค่าตัวเลขเดียว ทำให้ประเมินความไม่แน่นอนได้ดีขึ้น
- รองรับการฝึกฝนโมเดลระดับโลก (global model) จากหลายชุดข้อมูลพร้อมกัน
- มีเครื่องมือ backtesting ในตัวสำหรับการจำลองการพยากรณ์ย้อนหลัง
- มาพร้อม โมดูลตรวจจับความผิดปกติ ที่ใช้งานง่าย
แหล่งข้อมูล: เอกสาร Darts และ ตัวอย่างและบทช่วยสอนของ Darts
5. ตรวจจับรูปแบบเชิงเวลาด้วย stumpy
ในขณะที่ตัวอื่นเน้นการพยากรณ์ stumpy กลับเน้นไปที่การคำนวณ matrix profile เพื่อค้นหารูปแบบซ่อนเร้น (motif discovery) และจุดที่ผิดปกติ (discord detection) โดยไม่ต้องใช้ข้อมูลที่ติดป้ายกำกับ
ประโยชน์ของ stumpy สำหรับงานวิเคราะห์:
- ระบุลำดับเหตุการณ์ที่เกิดขึ้นซ้ำๆ ได้ดีในข้อมูลเซนเซอร์หรือบันทึกกิจกรรม
- ตรวจจับเหตุการณ์ที่แปลกแยกจากกลุ่มได้โดยใช้พารามิเตอร์น้อย
- รองรับการประมวลผลผ่าน GPU และ CPU แบบขนาน เหมาะสำหรับข้อมูลขนาดใหญ่
แหล่งข้อมูล: เอกสาร stumpy และ GitHub repository ของ stumpy
6. ยกระดับการตรวจจับความผิดปกติด้วย PyOD
PyOD เป็น library ที่ครอบคลุมที่สุดสำหรับการตรวจจับค่าผิดปกติ โดยมีอัลกอริทึมให้เลือกใช้มากกว่า 60 รูปแบบ ครอบคลุมทั้งข้อมูลตาราง, อนุกรมเวลา, ไปจนถึงรูปภาพ
ทำไม PyOD ถึงมีประโยชน์:
- รวมวิธีการตรวจจับทุกรูปแบบไว้ในที่เดียว ทั้งแบบ linear, proximity-based และ deep learning
- ให้คะแนนความผิดปกติแบบต่อเนื่อง ช่วยให้วิเคราะห์ระดับความรุนแรงได้ละเอียดกว่าแบบใช่หรือไม่ใช่
- รองรับการทำงานแบบขนานและเพิ่งเพิ่ม เวิร์กโฟลว์แบบเอเจนต์ (agentic workflows) เพื่ออธิบายผลการตรวจจับด้วยภาษาธรรมชาติ
แหล่งข้อมูล: เอกสาร PyOD และ GitHub repository ของ PyOD
7. พยากรณ์ด้วย Deep Learning ผ่าน NeuralForecast
เมื่อต้องการก้าวข้ามขีดจำกัดของ machine learning ทั่วไป NeuralForecast โดย Nixtla คือตัวเลือกที่รวบรวมสถาปัตยกรรมโครงข่ายประสาทเทียมล้ำสมัยไว้มากที่สุด
คุณสมบัติเด่นของ NeuralForecast:
- รวมโมเดลกว่า 30 แบบ เช่น PatchTST, TimesNet และโมเดลกลุ่ม TimeLLM
- รองรับตัวแปรภายนอกและมีระบบอธิบายการมีส่วนร่วมของแต่ละคุณลักษณะ
- ปรับจูนไฮเปอร์พารามิเตอร์อัตโนมัติและรองรับการพยากรณ์พร้อมกันหลายพันชุดข้อมูล
แหล่งข้อมูล: เอกสาร NeuralForecast และ GitHub repository ของ NeuralForecast
Summary
ทั้ง 7 libraries นี้ครอบคลุมทุกความต้องการในงาน Time Series ตั้งแต่สถิติไปจนถึง AI ขั้นสูง:
| Library | หมวดหมู่ | เหมาะที่สุดสำหรับ |
|---|---|---|
| statsmodels | การสร้างแบบจำลองทางสถิติ | การพยากรณ์ที่เน้นการอธิบายผลได้ชัดเจน |
| pmdarima | การเลือกโมเดลอัตโนมัติ | การทำเกณฑ์มาตรฐานทางสถิติแบบรวดเร็ว |
| sktime | ML Pipelines ครบวงจร | เวิร์กโฟลว์ machine learning ที่เป็นระบบ |
| Darts | การพยากรณ์ต้นน้ำถึงปลายน้ำ | การปรับสเกลพยากรณ์พร้อมประเมินความไม่แน่นอน |
| stumpy | การค้นหารูปแบบ | การหารูปแบบซ้ำหรือจุดผิดปกติโดยไม่มีป้ายกำกับ |
| PyOD | การตรวจจับความผิดปกติ | การตรวจจับค่าผิดปกติในระดับสเกลและหลายมิติ |
| NeuralForecast | Deep Learning | การเพิ่มความแม่นยำในชุดข้อมูลที่ซับซ้อนและขนาดใหญ่ |
การทดลองใช้เครื่องมือเหล่านี้กับชุดข้อมูลจริงจะช่วยให้คุณเข้าใจลักษณะของข้อมูลและเลือกเครื่องมือที่เหมาะสมกับโจทย์ได้ดีที่สุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร