
ไขปริศนาความสร้างสรรค์ของ Diffusion Models ผ่านทฤษฎี Score Smoothing
Diffusion models ในปัจจุบันถือเป็นเครื่องมืออันทรงพลังสำหรับงานสร้างสรรค์ (generative tasks) ที่ต้องการโครงสร้างซับซ้อนและละเอียดแม่นยำ เช่น การสร้างรูปภาพและการค้นพบโมเลกุลใหม่ๆ โมเดลเหล่านี้แสดงความสามารถที่น่าทึ่งในการสรุปองค์ความรู้ (generalize) นอกเหนือจากข้อมูลที่ใช้ฝึกฝน ซึ่งถือเป็นแง่มุมของ "ความคิดสร้างสรรค์" ตัวอย่างเช่น หลังจากฝึกด้วยชุดข้อมูลภาพจริง โมเดลสามารถเปลี่ยนสัญญาณรบกวน (noise) แบบสุ่มให้กลายเป็นภาพใหม่ที่มีคุณภาพสูงได้
แม้ความสามารถนี้จะน่าประทับใจ แต่ก็นำมาซึ่งคำถามสำคัญว่า ความคิดสร้างสรรค์นี้มีที่มาอย่างไร? การทำความเข้าใจคำตอบนี้คือขั้นตอนสำคัญในการไขความลับลักษณะ "กล่องดำ" (black-box) ของ generative AI ที่ใช้พื้นฐานจาก diffusion เพื่อหาคำตอบดังกล่าว บทความวิจัย "On the Interpolation Effect of Score Smoothing in Diffusion Models" ซึ่งนำเสนอในงาน ICLR 2026 ได้เจาะลึกคณิตศาสตร์เบื้องหลัง diffusion models โดยเราพบว่าความคิดสร้างสรรค์ของโมเดลไม่ใช่เรื่องบังเอิญ แต่เป็นผลจากการฝึกฝน neural network ที่ทำให้กระบวนการเปลี่ยนสัญญาณรบกวนกลับเป็นข้อมูลมีความ "เรียบ" (smooth) โดยธรรมชาติในระหว่างการสร้างผลลัพธ์
ทำความเข้าใจเรื่อง denoising
การฝึก diffusion model เริ่มจากการนำตัวอย่างข้อมูลจริง เช่น รูปแมว มาใส่สัญญาณรบกวน (noise) จนไม่เหลือเค้าโครงเดิม จากนั้นโมเดลจะหัดย้อนกระบวนการเพื่อสร้างภาพสมจริงขึ้นใหม่จากสัญญาณรบกวนบริสุทธิ์ ซึ่งเรียกว่ากระบวนการ denoising
หากโมเดลเรียนรู้การทำ denoising ได้สมบูรณ์แบบโดยอิงตามตัวอย่างการฝึกเพียงอย่างเดียว มันจะทำเพียงแค่คัดลอกข้อมูลเดิมออกมาเป๊ะๆ (พฤติกรรมที่เรียกว่า memorization) ซึ่งจะทำให้โมเดลเป็นเพียงเครื่องมือค้นหาข้อมูล (retrieval tool) แทนที่จะเป็นเครื่องยนต์สร้างสรรค์ผลลัพธ์ใหม่
อย่างไรก็ตาม ในทางปฏิบัติ diffusion models มักทำได้มากกว่าแค่การจดจำ แต่สามารถสรุปองค์ความรู้เพื่อสร้างข้อมูลใหม่ได้
ลองจินตนาการว่าสัญญาณรบกวนแบบสุ่มคือกลุ่มอนุภาคก๊าซที่กระจายอยู่ทั่วห้อง โดยมี "สนามพลัง" (force field) คอยดึงอนุภาคให้รวมตัวกันเป็นรูปร่าง ในภาษาของ diffusion model อนุภาคที่เคลื่อนที่คือจุดข้อมูลที่กำลังผ่านกระบวนการ denoising ส่วน "สนามพลัง" คือ score function (SF) ที่เรียนรู้จากข้อมูลฝึกฝนเพื่อกำหนดทิศทางการไหลของข้อมูล
หากโมเดลใช้ score function ที่เรียนรู้มาอย่างสมบูรณ์แบบ สนามพลังจะดึงอนุภาคเข้าสู่ตำแหน่งข้อมูลการฝึกเดิมอย่างแม่นยำจนเกิดการจดจำขึ้น
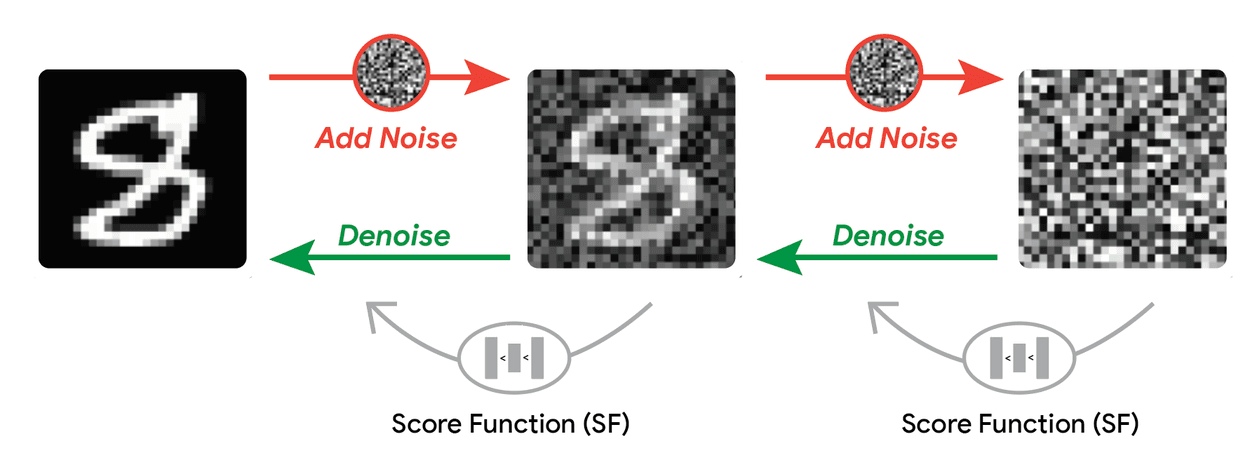
score function ขับเคลื่อนกระบวนการ denoising ซึ่งเปลี่ยนสัญญาณรบกวนบริสุทธิ์ให้กลายเป็นข้อมูลที่มีความหมาย (เช่น รูปภาพ)
ความคิดสร้างสรรค์ของ Diffusion model: ตัวอย่างแบบ 1 มิติ
เราค้นพบว่าความคิดสร้างสรรค์มีต้นกำเนิดมาจากลักษณะการเรียนรู้ของ neural networks ที่มีความไม่สมบูรณ์เนื่องจาก regularization ส่งผลให้เกิดการเบลอของ score function เล็กน้อย เรียกว่ากระบวนการ "score smoothing" (Scarvelis et al., TMLR 2025) สิ่งนี้ทำให้กระบวนการ denoising เกิดการสร้างข้อมูลแบบ interpolates หรือการเติมเต็มพื้นที่ว่างระหว่างจุดข้อมูลที่ใช้ฝึก จนได้ผลลัพธ์ใหม่ที่ยังคงความสมเหตุสมผล
ตัวอย่างในโลก 1 มิติที่มีจุดข้อมูลฝึกเพียงสองจุดคือ +1 และ -1 หากใช้ score function ที่ "สมบูรณ์แบบ" (เส้นสีเทา) ทิศทางจะถูกแบ่งชัดเจนที่จุดกึ่งกลาง 0 ทำให้อุภาคถูกดึงไปที่ -1 หรือ +1 เท่านั้น นำไปสู่การจดจำ (memorization)
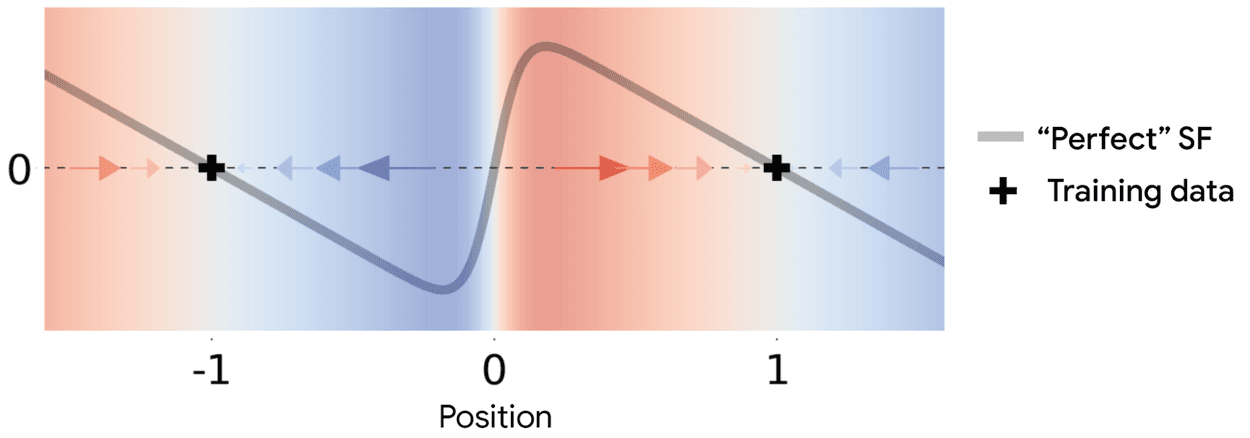
score function ที่ "สมบูรณ์แบบ" ขับเคลื่อนกระบวนการ denoising ให้ยุบตัวลงไปยังข้อมูลการฝึก จึงนำไปสู่การจดจำ (สีพื้นหลังและความโปร่งแสงระบุทิศทางและความแรงของการดึง: สีแดงสำหรับไปทางขวา สีน้ำเงินสำหรับไปทางซ้าย)
แต่ในความเป็นจริง diffusion models จะใช้เวอร์ชันที่เรียนรู้โดย neural network ซึ่งมักจะเรียบกว่า (smooth) เนื่องจากผลของ weight decay เราได้ทดลองฝึก neural networks แบบ ReLU สองชั้นด้วยอัลกอริทึม AdamW algorithm ภายใต้ระดับ weight decay (WD) ที่ต่างกัน
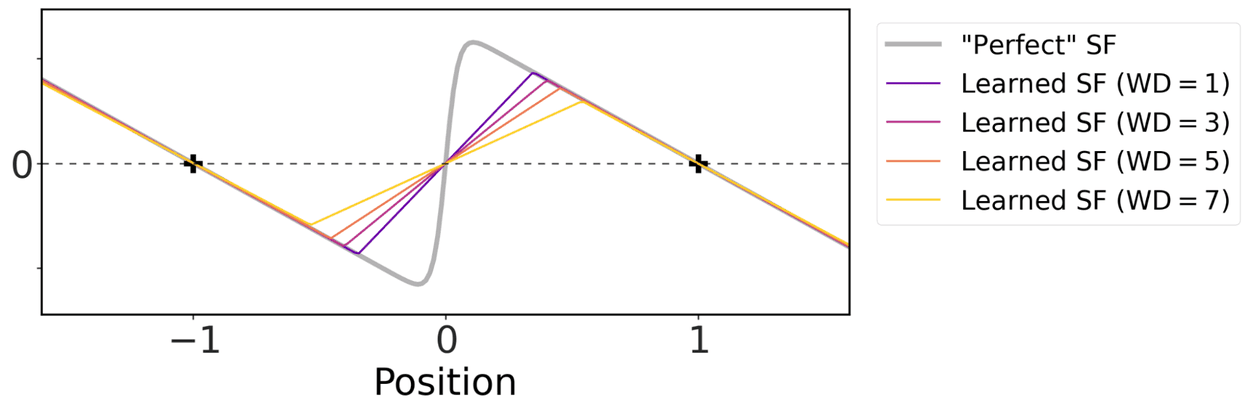
neural networks ที่ได้รับการฝึกภายใต้ regularization จะเรียนรู้เวอร์ชันที่เรียบกว่าของ score function
ยิ่งใช้ weight decay แรง score function จะยิ่งเรียบขึ้นที่บริเวณตรงกลาง ทำให้อนุภาคไหลช้าลงและหยุดนิ่งใน "พื้นที่การประมาณค่าต่อเนื่อง" (interpolation zone) ระหว่างข้อมูลการฝึกทั้งสองจุด
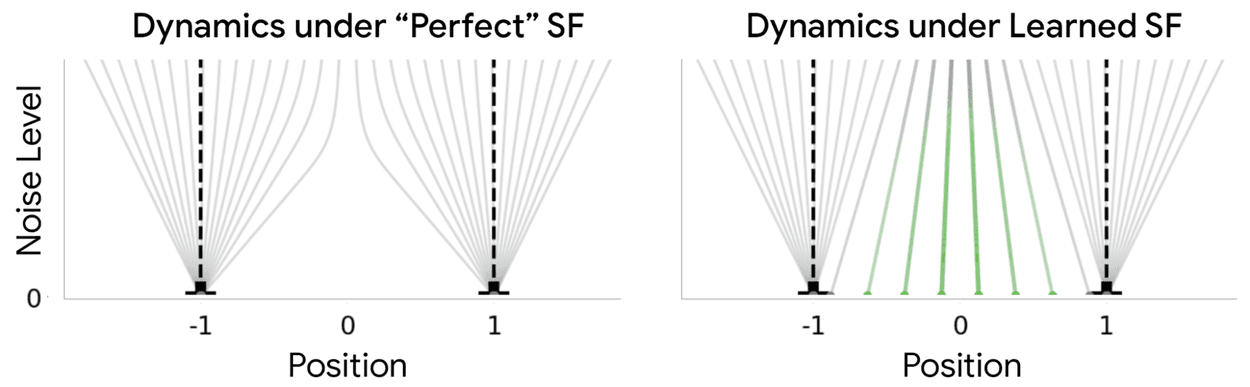
score smoothing สร้าง "interpolation zone" ระหว่างจุดข้อมูลการฝึก
ในงานวิจัยนี้ เรายังพบว่าแม้ไม่มีการตั้งค่า weight decay ที่ชัดเจน แต่ผลของ implicit regularization จากอัลกอริทึมฐาน gradient ก็ส่งผลให้เกิด score smoothing เช่นกัน ซึ่งสอดคล้องกับงานวิจัยอื่นๆ อย่าง Vastola (ICLR 2025), Wang and Pehlevan (NeurIPS 2025) และ Bonnaire et al. (NeurIPS 2025)
Score smoothing ช่วยในการกู้คืน manifold
สำหรับข้อมูลซับซ้อนอย่างภาพความละเอียดสูง ข้อมูลจะอาศัยอยู่ในพื้นที่พิกเซลมิติมหาศาลบนสิ่งที่เรียกว่า data manifold (เปรียบเสมือนแผ่นพับที่ซ่อนอยู่ในพื้นที่ขนาดใหญ่) การสร้างภาพใหม่จึงเปรียบเสมือนงาน manifold recovery ที่โมเดลต้องอนุมานรูปร่างของ manifold จากข้อมูลที่มีจำกัด
ที่น่าสนใจคือในมิติมหาศาล score smoothing จะทำงานแบบเน้นทิศทาง ในทิศทางที่ขนานกับ manifold (tangential) มันจะช่วยชะลอการไหลเพื่อสร้างการประมาณค่าใหม่ๆ แต่ในทิศทางที่พุ่งเข้าหา manifold มันจะไม่ทำให้การลู่เข้า (convergence) ช้าลง ผลลัพธ์ที่ได้จึงมีความสมดุล: ภาพมีความสมจริง (เพราะเข้าถึง manifold) และมีความใหม่ (เพราะตั้งอยู่ในพื้นที่ว่างระหว่างข้อมูลเดิม)
เล่นวิดีโอแบบไม่มีเสียงวนซ้ำ หยุดวิดีโอแบบไม่มีเสียงวนซ้ำ
เปิดเสียงวิดีโอ ปิดเสียงวิดีโอ
ในการตั้งค่าหลายมิติ score smoothing จะทำให้เกิดผลกระทบของการประมาณค่าต่อเนื่อง (interpolation effect) ที่ใกล้เคียงกับการเรียนรู้ manifold
บทสรุป
การค้นพบของเราชี้ให้เห็นว่า "ความคิดสร้างสรรค์" ของ diffusion models แท้จริงแล้วเป็นผลลัพธ์ทางคณิตศาสตร์ที่ทำนายได้ จากการที่ neural networks สร้างสะพานเชื่อมระหว่างข้อมูลที่รู้จัก เช่น การสร้างตัวยาใหม่หรือโมเลกุลที่รวมร่องรอยของข้อมูลสองชุดเข้าด้วยกันอย่างสร้างสรรค์
งานนี้ถือเป็นก้าวแรกในการอธิบายกลไกดังกล่าว โดยยังมีงานวิจัยอื่นๆ ที่ศึกษาในบริบทที่ซับซ้อนขึ้นอย่าง data distribution หรือ neural network architectures และงานด้าน conditional generation เราหวังว่าความคุ้นเคยกับพฤติกรรมนี้จะช่วยให้เราสร้างโมเดลที่เป็นนักประมาณค่า (interpolators) ที่ดียิ่งขึ้นในอนาคต โดยเราได้เผยแพร่ code และบทความวิจัย paper ฉบับเต็มสำหรับผู้ที่สนใจ
กิตติกรรมประกาศ
เราขอขอบคุณ Sreenivas Gollapudi และ Ravi Kumar สำหรับการสนับสนุนโครงการ ตลอดจน Mark Simborg และ Kimberly Schwede สำหรับการเตรียมโพสต์บล็อกนี้ สำหรับรายละเอียดเกี่ยวกับวรรณกรรมงานวิจัยอื่นๆ สามารถอ่านเพิ่มเติมได้ในบทความวิจัยหลักของเรา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร