
ToyBlocks: โลกจำลองควบคุมได้เพื่อยกระดับการเรียนรู้ของหุ่นยนต์
💻 Code | 📊 Data | 🤖 Models | 📖 Documentation
ปัจจุบันหุ่นยนต์กำลังเรียนรู้งานที่ซับซ้อน เช่น การพับผ้า หรือการจัดการวัตถุที่ไม่คุ้นเคย แต่การสาธิตเหล่านั้นมักถูกจำกัดในขอบเขตที่แคบ ทำให้ยากต่อการอธิบายว่าหุ่นยนต์เรียนรู้อะไร หรือทำไมมันถึงล้มเหลวในบางสถานการณ์ เพื่อแก้ปัญหานี้ นักวิทยาศาสตร์ต้องการสภาพแวดล้อมขนาดเล็กที่ควบคุมได้ เช่นเดียวกับจานเพาะเชื้อในห้องแล็บ เพื่อให้สามารถเปลี่ยนเงื่อนไข สังเกตผลกระทบ ทดสอบซ้ำ และสืบหาต้นเหตุของความล้มเหลวได้อย่างแม่นยำ ซึ่งเป็นปัจจัยสำคัญในการพัฒนาระบบหุ่นยนต์ที่มีความซับซ้อนสูง
วันนี้เราจึงเปิดตัว Framework สำหรับสร้างสภาพแวดล้อมเหล่านี้ในชื่อ FoundationWorlds โดยจะจับคู่โลกจำลองที่ควบคุมได้เข้ากับเครื่องมือสร้างงานและชุดข้อมูลสาธิตโดยอัตโนมัติ ช่วยให้ศึกษาได้ว่า Model จะพัฒนาอย่างไรเมื่อมีข้อมูลมากขึ้น และวิธีรวมการให้เหตุผลระดับสูง (high-level reasoning) เข้ากับการควบคุมกายภาพ
FoundationWorld แรกของเราคือ ToyBlocks ซึ่งเป็นระบบจำลองแบบเปิดที่ประกอบด้วยแขนหุ่นยนต์และบล็อกไม้ แม้การตั้งค่าจะดูเรียบง่าย แต่หุ่นยนต์ต้องใช้การให้เหตุผลเพื่อจัดการวัตถุ เช่น การผลัก พลิก และวางซ้อนให้สำเร็จ
ToyBlocks สามารถสร้างข้อมูลการสาธิตได้โดยอัตโนมัติโดยไม่ต้องใช้คนควบคุม (teleoperation) ช่วยประหยัดเวลาอย่างมาก นักวิจัยสามารถปรับเปลี่ยนประสบการณ์การฝึกได้ง่าย เช่น เพิ่มการฝึกผลักหรือพลิกบล็อก แล้วนำไปประเมินผลในภารกิจอื่นๆ ที่หุ่นยนต์ไม่เคยเจอมาก่อน
การทำงานของ ToyBlocks
ToyBlocks ต่อยอดจากโครงการหุ่นยนต์แบบเปิดอย่าง MolmoAct 2, MolmoBot, และ MolmoSpaces โดยเน้นไปที่การศึกษาเชิงลึกในโดเมนที่ถูกจำกัดไว้เพื่อให้สามารถควบคุมปัจจัยต่างๆ ได้ครบถ้วน
ระบบนี้ถูกออกแบบตามข้อกำหนด 4 ประการ คือ ฟิสิกส์และรูปลักษณ์ต้องสมจริง, สร้างงานได้ในระดับ Scale ใหญ่, มีความท้าทายทั้งด้านการวางแผนและความคล่องแคล่ว และครอบคลุมงานทั้งหมดในโดเมนนั้นๆ ซึ่ง ToyBlocks สามารถทำได้ครบถ้วนเนื่องจากขอบเขตที่ชัดเจน
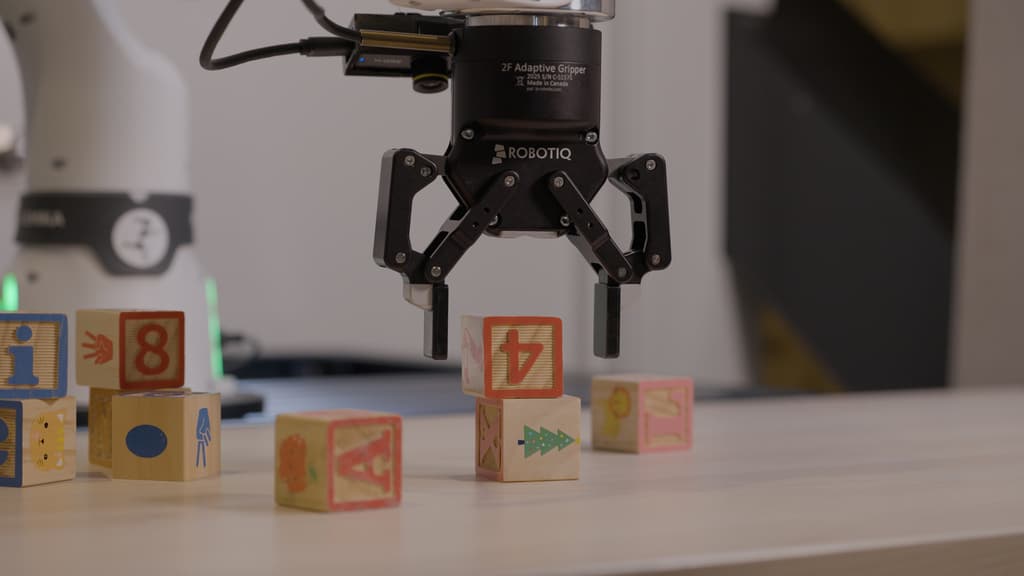
มือจับหุ่นยนต์ทางกายภาพเหนือบล็อกไม้ในการตั้งค่า ToyBlocks
ระบบนี้ไม่ได้มีแค่การหยิบวาง แต่ยังมีรูปภาพและตัวอักษรบนบล็อกเพื่อทดสอบการค้นหาและคัดแยก โดยใช้ Domain randomization เพื่อเปลี่ยนคุณสมบัติทางกายภาพ เช่น ขนาดหรือความสูงโต๊ะ เพื่อทดสอบว่า Model จะปรับตัวเข้ากับสภาพแวดล้อมที่เปลี่ยนไปได้ดีเพียงใด
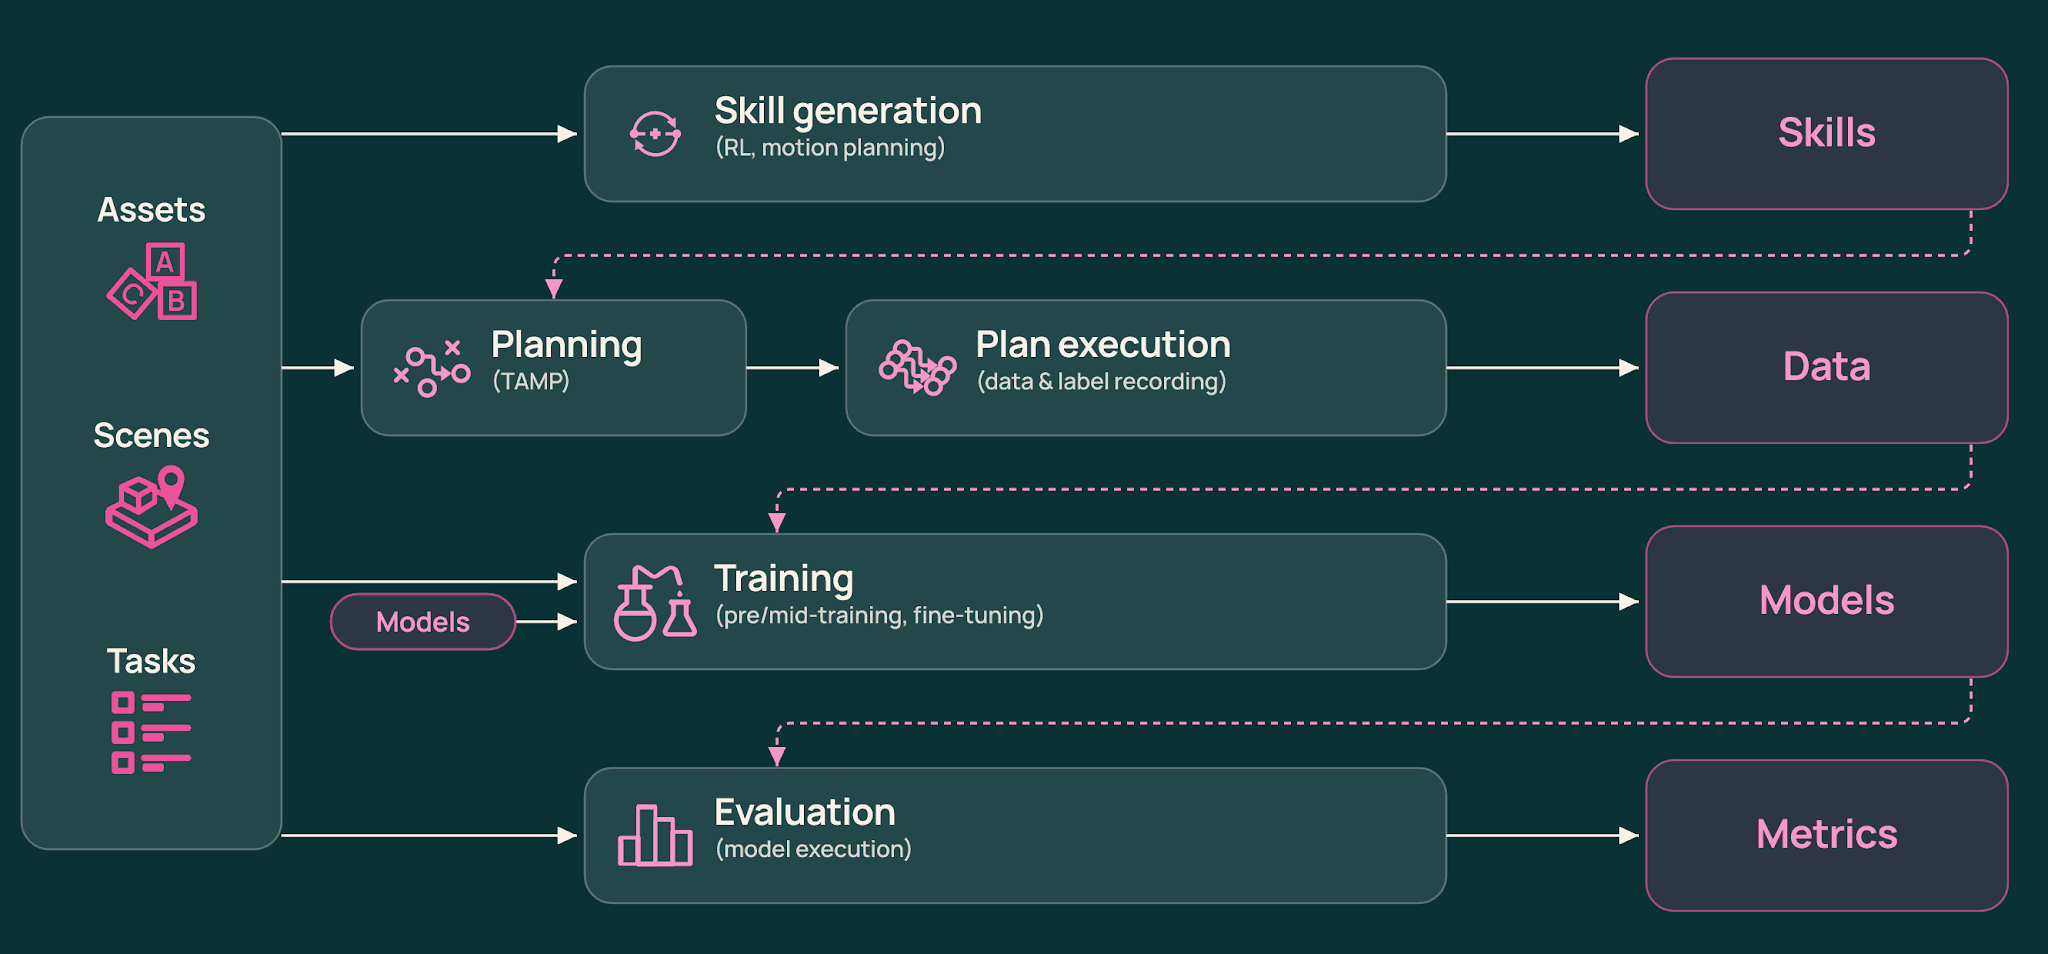
ToyBlocks สร้างทักษะและการสาธิตงานโดยอัตโนมัติ เพื่อนำไปฝึกหรือ Fine-tuning Model โดยมี Model ระดับสูงทำหน้าที่ตัดสินใจ และ Model ระดับต่ำทำหน้าที่ควบคุมการเคลื่อนไหว
ToyBlocks ใช้ Reinforcement Learning (RL) ร่วมกับ Motion Planning เพื่อสร้างทักษะระยะสั้น (short-horizon tasks) เช่น การผลักหรือพลิกบล็อกโดยไม่หยิบ ซึ่งกระบวนการนี้สามารถดึงข้อมูลพิเศษจากระบบจำลองมาใช้เพื่อเร่งการเรียนรู้ได้เร็วกว่าเวลาจริงถึง 24 เท่า
ในการทำงานจริง หุ่นยนต์ต้องเผชิญกับปัญหาการรับรู้ (perception) โดยต้องประมาณค่า Pose หรือตำแหน่งและทิศทางของวัตถุจากเซนเซอร์ ToyBlocks จึงฝึก Model ให้สามารถเปลี่ยนข้อมูลดิบจากเซนเซอร์ไปสู่การกระทำที่แม่นยำได้
การทำงานร่วมกันของ Molmo 2 (ระดับสูง) และ ManiFlow (ระดับต่ำ) โดย Molmo 2 จะเลือกทักษะและระบุบล็อกผ่านการชี้ ขณะที่ ManiFlow จะควบคุมแขนหุ่นยนต์ให้ทำงานตามสั่ง
ระบบนี้ยังรองรับการสั่งงานด้วยภาษาธรรมชาติผ่านหน้าเว็บ interface โดยเชื่อมต่อกับ Claude หรือ Model ชั้นนำอื่นๆ ทำให้ผู้ใช้ทั่วไปสามารถทดลองวางแผนและสั่งงานหุ่นยนต์ได้โดยไม่ต้องมีความเชี่ยวชาญด้านหุ่นยนต์โดยเฉพาะ
งานวิจัยที่ต่อยอดจาก ToyBlocks
เราใช้ ToyBlocks ศึกษาปัจจัยที่มีผลต่อประสิทธิภาพหุ่นยนต์ ทั้งการให้เหตุผลเชิงพื้นที่ (spatial reasoning), การวางแผนหลายขั้นตอน และการถ่ายโอนทักษะไปยังหุ่นยนต์จริง เพื่อดูว่า Model สามารถนำความรู้ไปใช้ในสถานการณ์ใหม่ๆ ได้ดีเพียงใด
Model การกระทำระดับต่ำ: การปรับใช้ความรู้เชิงพื้นที่ของ VLA
เราทดสอบ Vision-Language-Action Models (VLAs) ว่าสามารถปรับตัวเข้ากับพื้นที่ทำงานใหม่ๆ ได้หรือไม่ โดยออกแบบการทดสอบที่เปลี่ยนลำดับทักษะและตำแหน่งวัตถุ เพื่อดูว่า Model จะสามารถคาดการณ์ผลลัพธ์นอกขอบเขตการฝึก (extrapolation) ได้หรือไม่
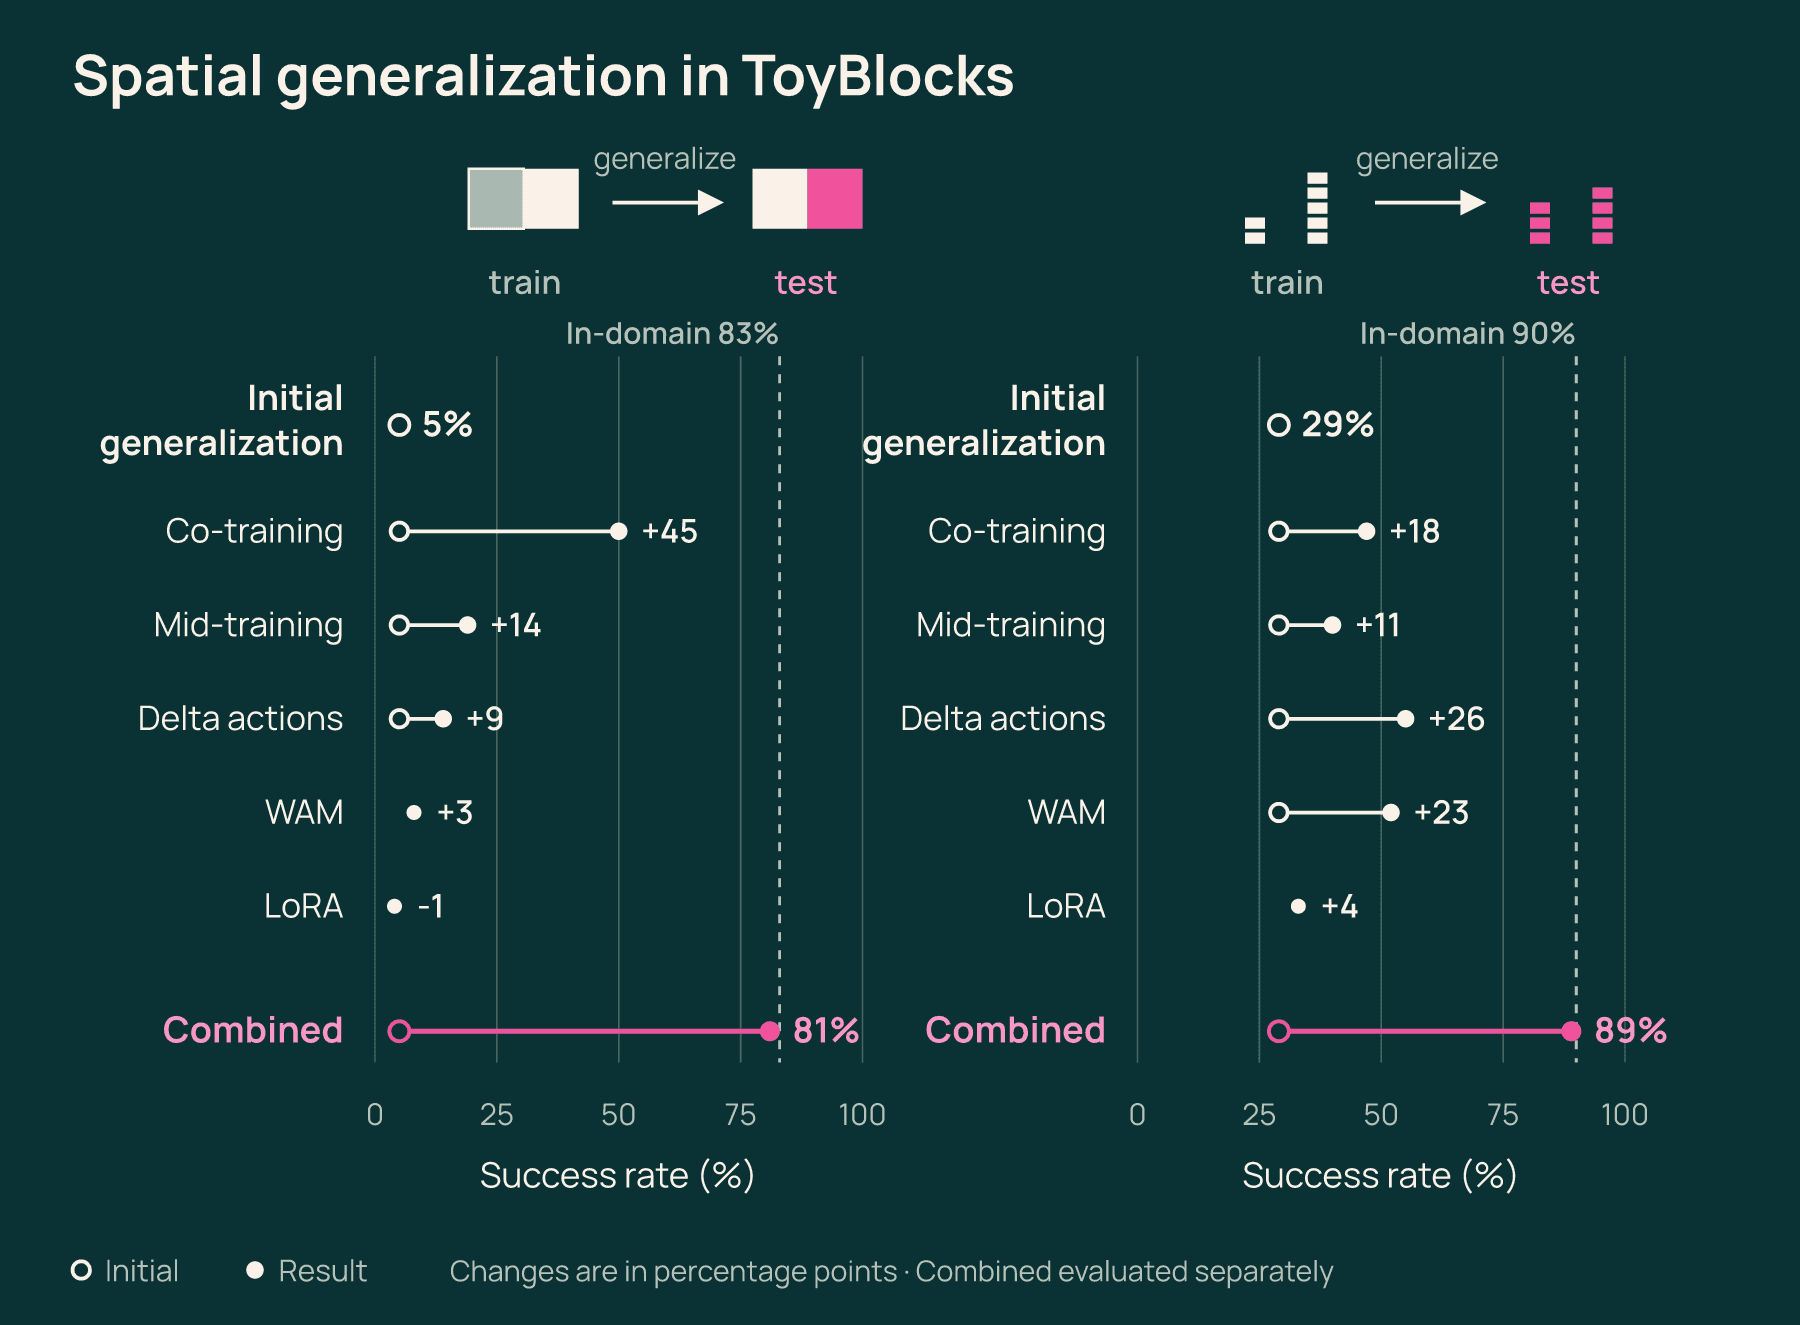
ผลการศึกษาพบว่า Model ยอดนิยมในปัจจุบันยังปรับใช้ความรู้เชิงพื้นที่ได้ไม่ดีนักแม้จะผ่านการฝึกล่วงหน้ามามาก เราจึงใช้เทคนิค LoRA เพื่อช่วยปรับปรุง และพบว่า ToyBlocks เป็นสนามทดสอบที่ดีมากสำหรับการพัฒนาเทคนิคเหล่านี้
การให้เหตุผลระดับสูง: Vision-language models
สำหรับงานระยะยาว (Long-horizon tasks) เช่น การสะกดคำว่า "Ai2" ด้วยการซ้อนบล็อก เราประเมิน Model แบบลำดับชั้น โดยใช้ Molmo 2 เป็นผู้วางแผน และ ManiFlow เป็นผู้ปฏิบัติการ ซึ่งต้องอาศัยทั้งการวางแผนระดับสูงและการจัดการระดับต่ำที่แม่นยำ
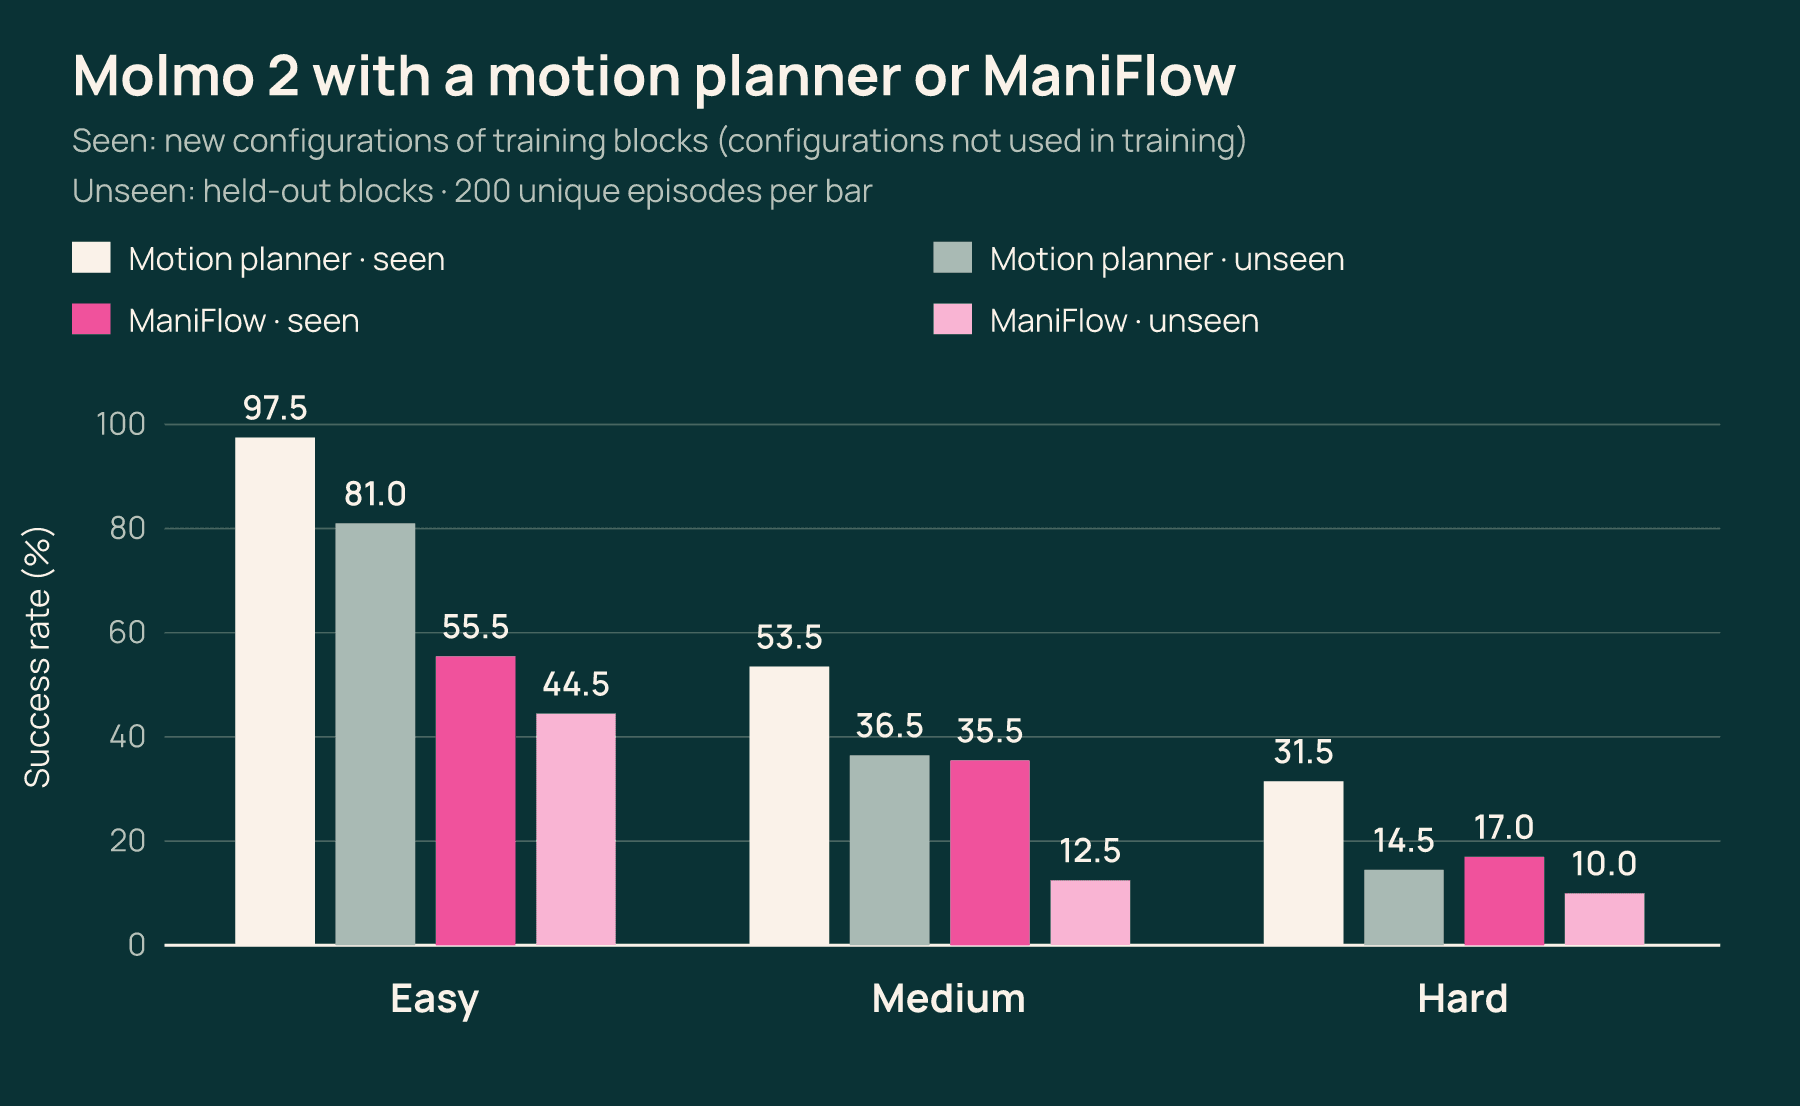
อัตราความสำเร็จในการสะกดคำผ่านระดับความยาก 3 ขั้น แสดงให้เห็นว่าการแยกส่วนการวางแผนและการปฏิบัติการช่วยให้หุ่นยนต์ทำงานที่ซับซ้อนได้ดีขึ้น
การให้เหตุผลระดับสูง: Agentic systems
เราทดลองใช้ Claude Opus 5.5 ผ่าน Model Context Protocol (MCP) เพื่อให้ AI Agent สามารถเรียกใช้เครื่องมือใน ToyBlocks ได้โดยตรง โดย Agent จะมองเห็นฉากผ่านกล้องและตัดสินใจเลือกใช้ทักษะต่างๆ เพื่อแก้ปัญหา
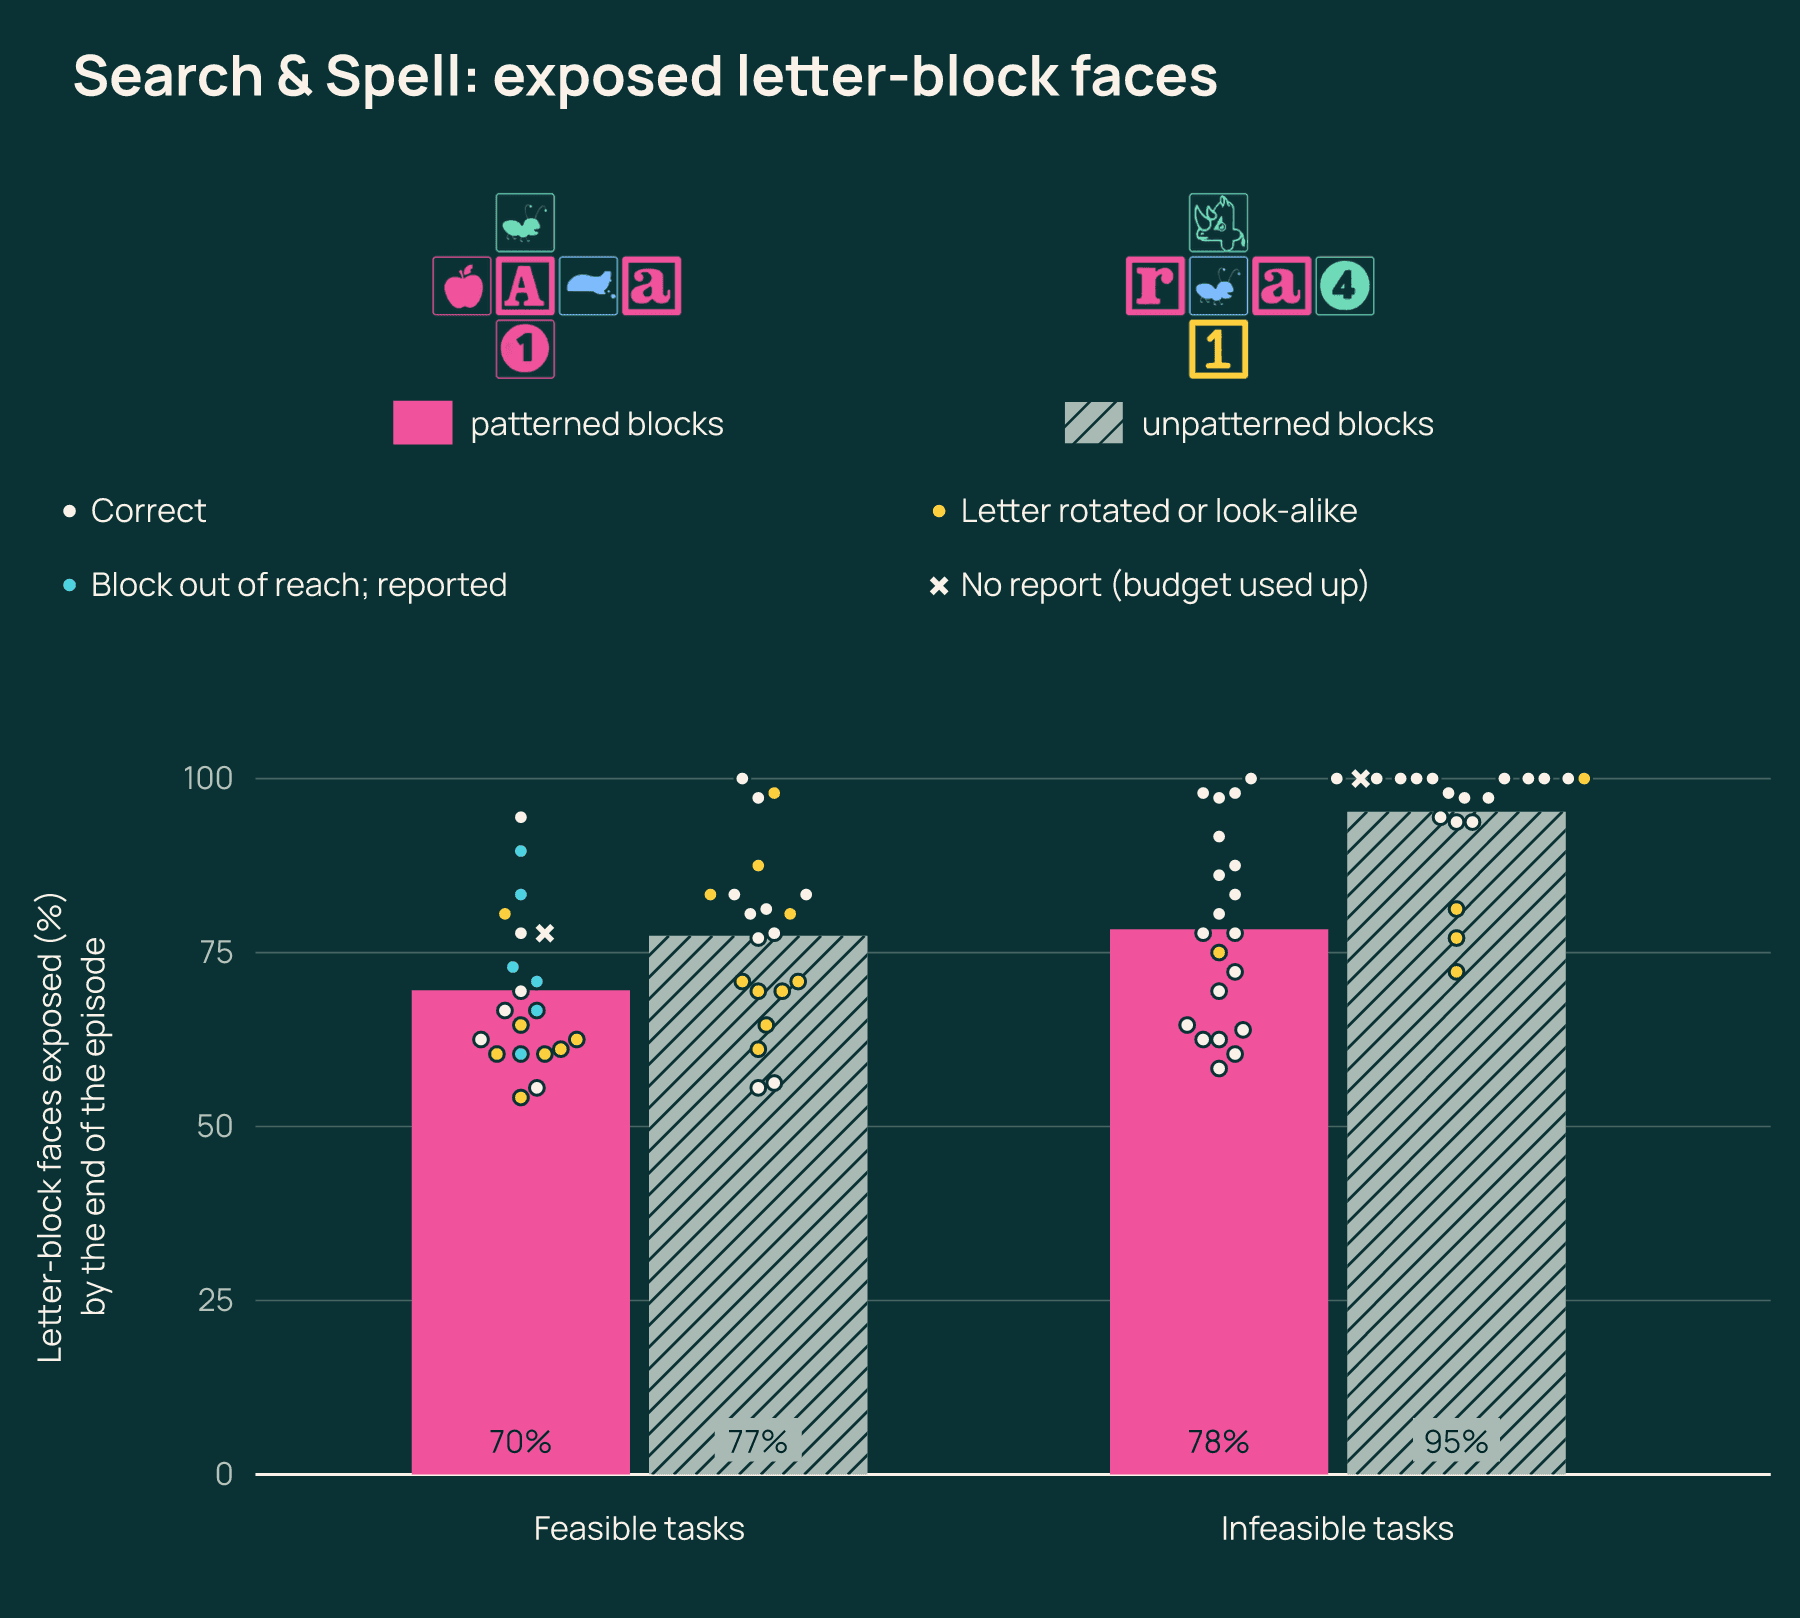
ในการทดสอบสะกดคำที่ยากขึ้น Agent ต้องหาบล็อกที่ถูกต้องจาก 8 บล็อก ซึ่งบางครั้งงานก็เป็นไปไม่ได้ เราพบว่า Agent สามารถวิเคราะห์สถานการณ์ได้ถูกต้องถึง 63% และสามารถเรียนรู้พฤติกรรมของทักษะตนเองผ่านการทดลองจนเพิ่มอัตราความสำเร็จจาก 24% เป็น 63% ซึ่งสูงกว่าคำอธิบายที่เขียนโดยมนุษย์
Action-conditioned world models ในฐานะตัวจำลอง
ToyBlocks ให้ค่าความจริงพื้นฐาน (ground truth) ที่แม่นยำสำหรับการทดสอบ World Models ที่ทำหน้าที่ทำนายการเปลี่ยนแปลงของฉาก เราได้ทดสอบ Model อย่าง Wan 2.2, Astra และ LeWM ในการทำนายผลการเคลื่อนที่ของบล็อก
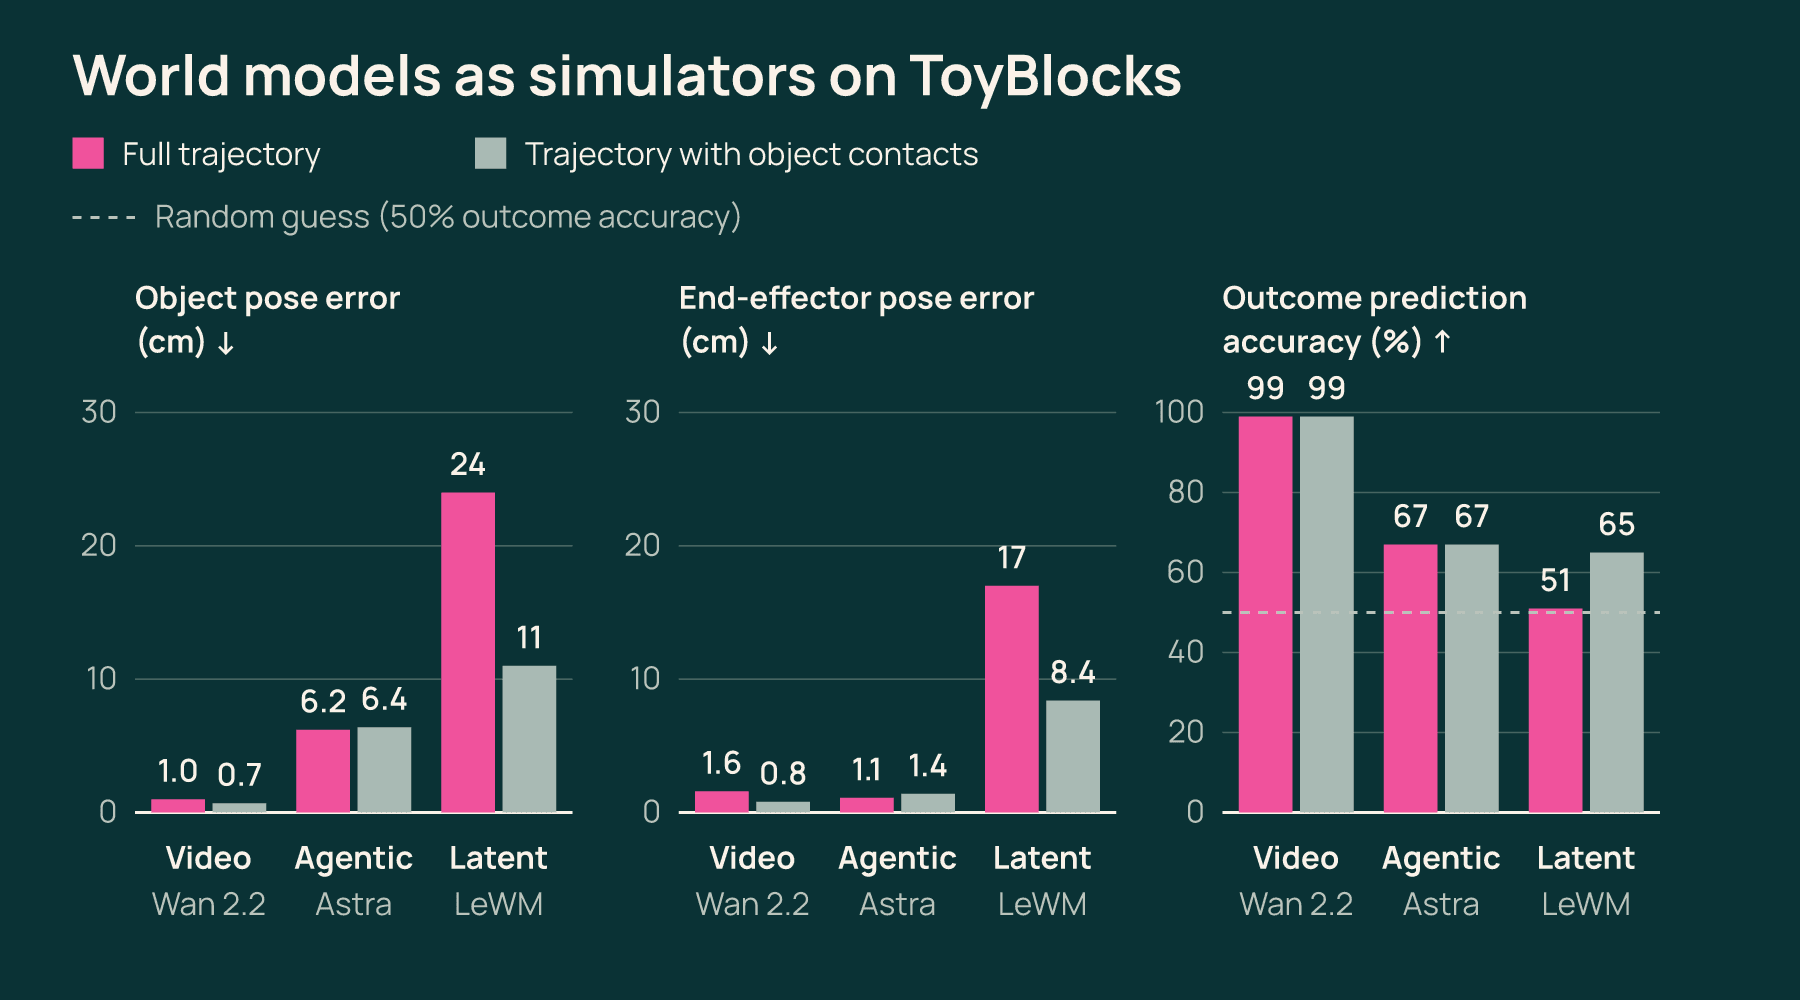
ผลทดสอบพบว่า Wan 2.2 ทำนายได้แม่นยำที่สุด และการใช้ข้อมูลที่สร้างจาก World Model เหล่านี้มาช่วยฝึก (rollouts) สามารถเพิ่มอัตราความสำเร็จของนโยบายหุ่นยนต์จาก 19% เป็น 78% ในพื้นที่ที่ไม่เคยฝึกมาก่อน
การทดลองในโลกจริงด้วย Model ระดับสูงและระดับต่ำ
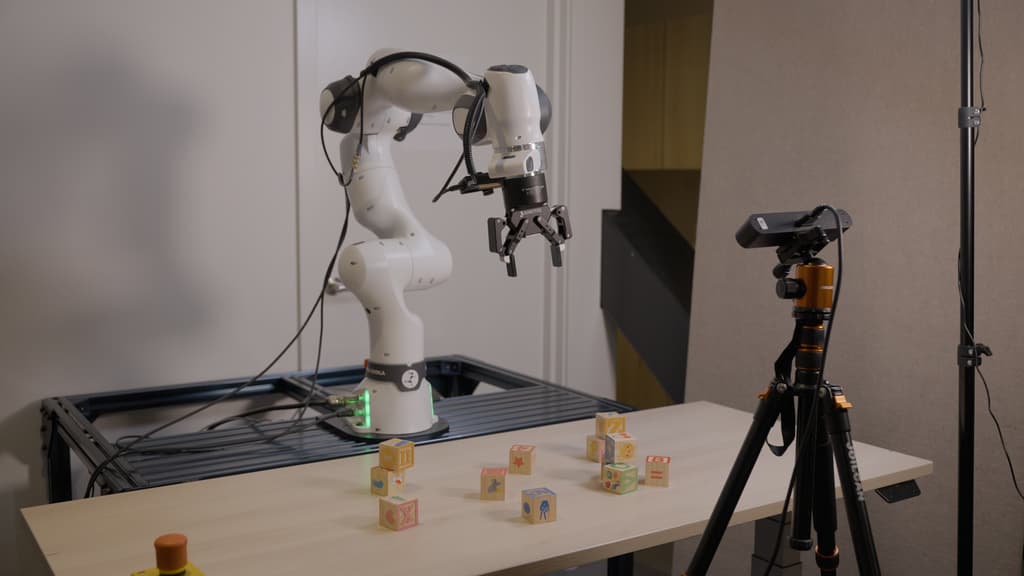
การประเมิน Sim-to-real แสดงให้เห็นว่านโยบายที่ฝึกใน ToyBlocks สามารถนำไปใช้กับหุ่นยนต์ Franka FR3 ในโลกจริงได้แบบ Zero-shot โดยให้อัตราความสำเร็จที่ใกล้เคียงกับในสถานการณ์จำลอง (ประมาณ 80% สำหรับทักษะพื้นฐาน)
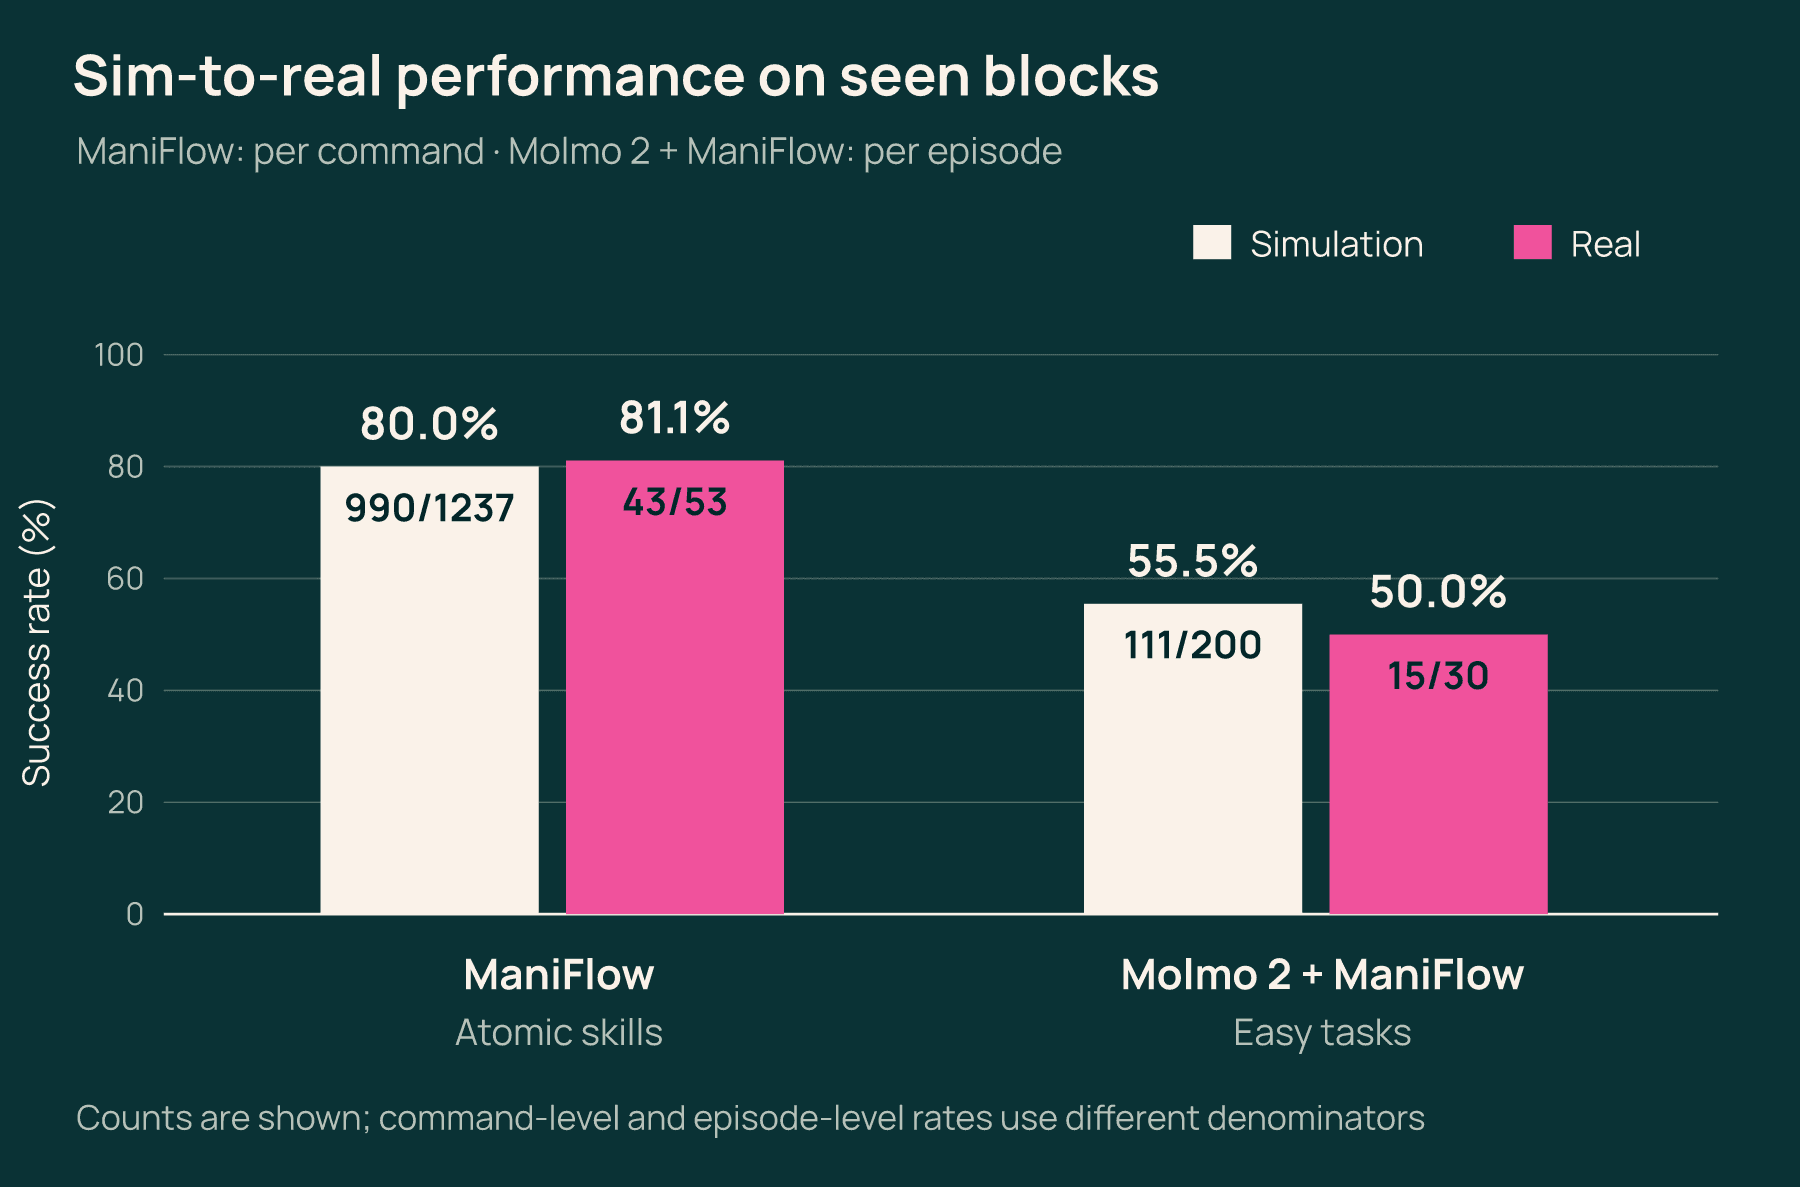
เพื่อลดช่องว่างระหว่าง Sim และ Real เราใช้เทคนิค System Identification ปรับค่าทางกายภาพให้ตรงกัน และใช้ FastFoundationStereo เพื่อสร้างข้อมูลความลึกที่สะอาดจากภาพ RGB ทำให้หุ่นยนต์ทำงานได้อย่างแม่นยำ
การเปิดเครื่องมือเพื่อการวิจัยต่อไป
เราเปิดตัวสินทรัพย์ทั้งหมดของ ToyBlocks รวมถึงชุดข้อมูลสาธิตกว่า 85,000 ชุด (เกือบ 1,600 ชั่วโมง) และโค้ดสำหรับฝึกและประเมินผล เพื่อให้ชุมชนนักวิจัยสามารถนำไปต่อยอดและศึกษาพฤติกรรมหุ่นยนต์ในรูปแบบของตนเองได้
ในอนาคตเรามีแผนจะขยาย ToyBlocks ไปสู่การจัดการแบบสองแขน (bimanual) และการใช้มือหุ่นยนต์ที่คล่องแคล่ว รวมถึงการจัดการกองวัตถุที่ไม่มีโครงสร้าง เพื่อผลักดันให้หุ่นยนต์สามารถทำงานในโลกจริงที่ไม่คุ้นเคยได้อย่างน่าเชื่อถือ
ทิศทางในอนาคต: การจัดการกองวัตถุด้วย RL
ทิศทางในอนาคต: การจัดการบล็อกด้วยสองแขน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร