
TypeSafe AI เปิดตัว Jev โมเดล System One เน้นตัดสินใจแม่นยำแทนการแชท
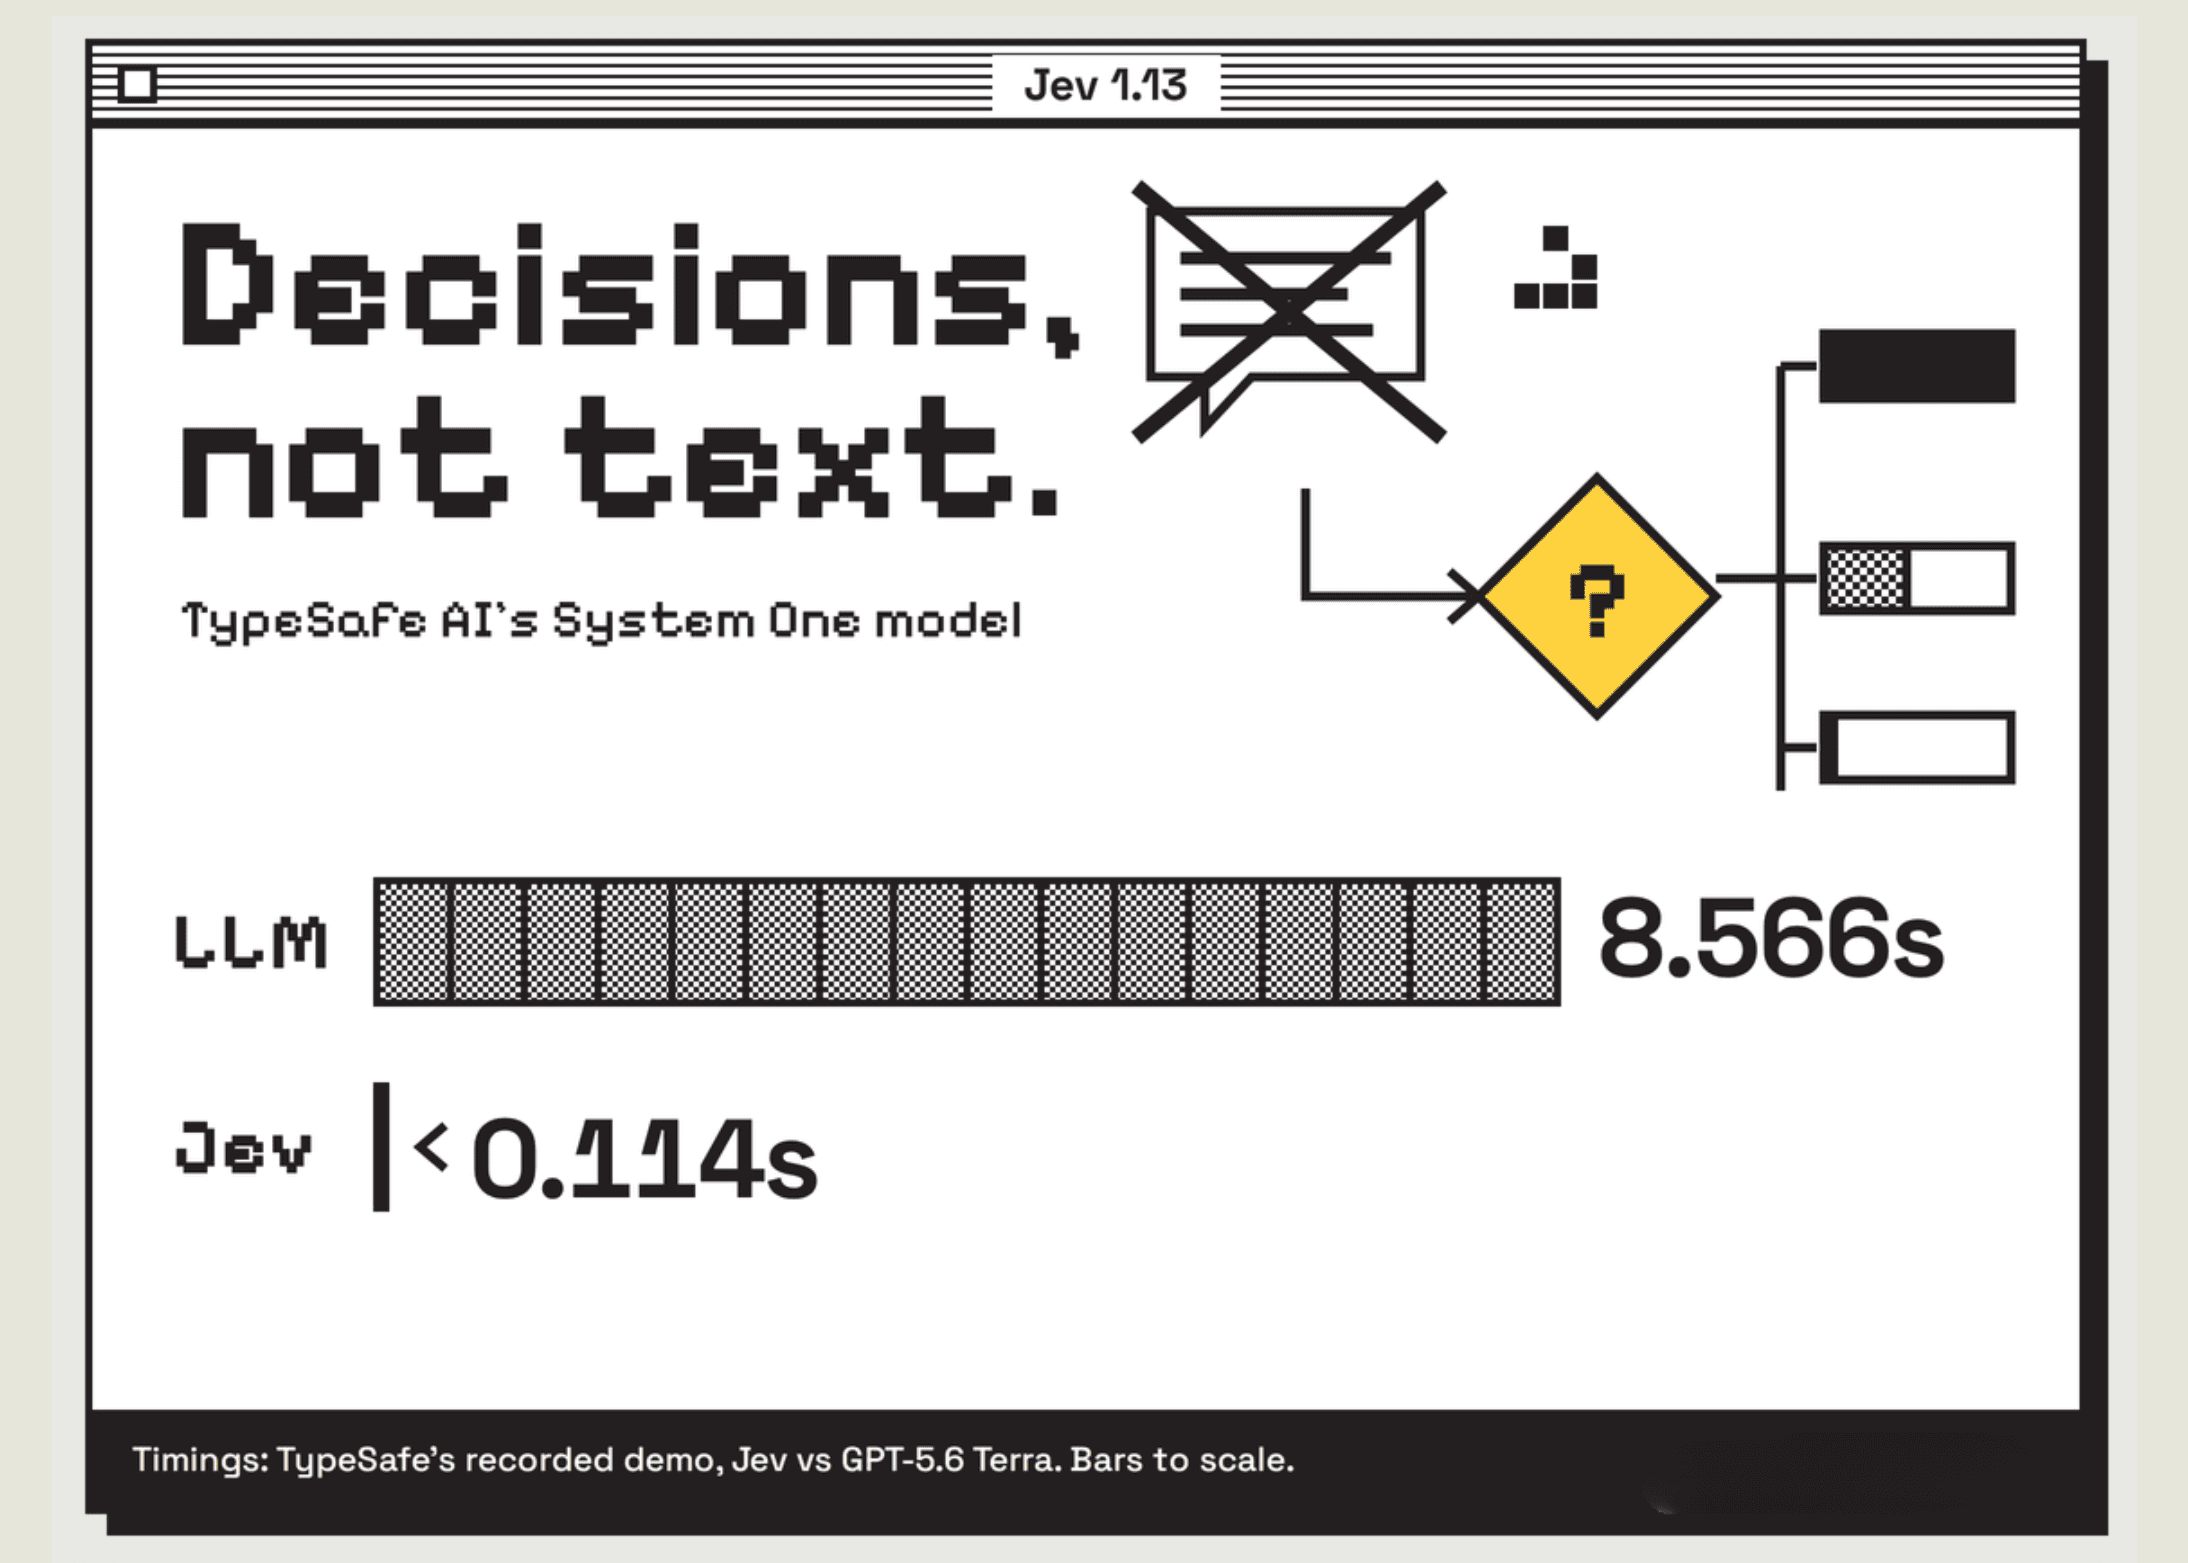
กระแส ChatGPT ในปี 2022 ได้เปลี่ยนวิธีที่มนุษย์สื่อสารกับ AI แต่ก้าวต่อไปที่สำคัญคือการทำให้ AI สื่อสารกับซอฟต์แวร์ได้อย่างมีประสิทธิภาพ TypeSafe AI จึงได้เปิดตัว Jev โมเดลที่ใช้พื้นฐานจาก transformer แต่ไม่ใช่โมเดลภาษาขนาดใหญ่ (LLM) และไม่สร้างข้อความ โดยผู้ใช้จะส่งสถานะ (state) และคำถามแบบระบุประเภทไป เพื่อให้โมเดลส่งคืนการตัดสินใจพร้อมค่าความน่าจะเป็นที่โค้ดสามารถนำไปใช้งานต่อได้ทันที
ปัจจุบัน Jev พร้อมใช้งานแล้วในรูปแบบ hosted API สำหรับผู้ที่ได้รับสิทธิ์ early access โดยต้องลงชื่อใน waitlist อย่างไรก็ตามทาง TypeSafe ยังไม่ได้เปิดเผยน้ำหนักของโมเดล (weights), จำนวนพารามิเตอร์ หรือตัวเลือกสำหรับการทำ self-hosting ในขณะนี้
โมเดล System One คืออะไร?
ชื่อของโมเดลยืมมาจากแนวคิดของ Daniel Kahneman ที่แบ่งการทำงานของสมองเป็น System 1 (สัญชาตญาณที่รวดเร็ว) และ System 2 (การใช้เหตุผลที่ช้า) ทีม TypeSafe มองว่าโมเดลที่ปรับจูนด้วย RLHF ในปัจจุบันเน้นความพึงพอใจของมนุษย์มากเกินไป จนเกิดปัญหาความมั่นใจเกินจริง (overconfidence) และสูญเสียความหลากหลายของคำตอบ ซึ่งทำให้ยังต้องมีมนุษย์คอยควบคุมดูแล
Jev จึงถูกสร้างขึ้นบนสแตกเทคโนโลยีใหม่ ประกอบด้วยสถาปัตยกรรมใหม่, ตัวสุ่มตัวอย่างแบบขนาน (parallel sampler) และเทคนิค Reinforcement Learning for Calibrated Decisions (RLCD) เพื่อให้ได้การตัดสินใจที่แม่นยำและรวดเร็วที่สุดโดยไม่ต้องผ่านกระบวนการสร้างข้อความที่ยืดเยื้อ
การทำงานของ Jev API
การใช้งานทำได้ผ่าน endpoint เดียวคือ POST https://api.typesafe.ai/v1/systemone โดยส่งข้อมูล state, model และ questions ซึ่งใน เอกสาร ระบุประเภทคำถามไว้ 3 รูปแบบหลัก ได้แก่:
| Primitive | สิ่งที่ถาม | สิ่งที่ส่งคืน |
|---|---|---|
| Choice | เลือก 1 ตัวเลือกจากรายการ | choice, probabilities, confidence |
| Score | ให้คะแนนตามระดับที่เรียงลำดับไว้ | score, probabilities, confidence |
| Noul | ข้อความนี้เป็นจริงหรือไม่? | noul ซึ่งเป็นความน่าจะเป็นตั้งแต่ 0 ถึง 1 |
จุดเด่นคือคำถามต่างๆ จะประมวลผลขนานกันภายใต้ state เดียวกัน ทำให้การเพิ่มจำนวนคำถามแทบไม่ส่งผลต่อเวลาในการตอบสนอง โดย Choice รองรับตัวเลือกได้สูงสุดถึง 255 รายการ
from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()  # reads TYPESAFE_API_KEY
r = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment issues", "technical": "Bugs"},
        ),
        "is_urgent": Noul(instructions="The message conveys urgency"),
    },
)
print(r.answers["department"].choice, r.answers["is_urgent"].noul)
นักพัฒนาสามารถติดตั้ง SDK ได้ผ่าน pip install typesafe-sdk สำหรับ Python ส่วน JavaScript จะใช้ชื่อ @typesafe-ai/sdk นอกจากนี้ในหน้า quickstart ยังมีตัวอย่างการใช้ cURL และ agent skill สำหรับ Claude Code ให้ศึกษาด้วย
ความมั่นใจคือผลิตภัณฑ์
ทุกคำตอบจาก Jev จะมาพร้อมค่า confidence หรือระดับความมั่นใจ 0 ถึง 1 ซึ่งคำนวณจากรูปทรงของการกระจายความน่าจะเป็น เช่น หากมีตัวเลือกที่สูสีกัน ค่าความมั่นใจจะต่ำลงเพื่อให้ระบบรู้ว่าควรจัดการอย่างไรต่อ
แนวทางที่แนะนำคือการแบ่งระดับการจัดการตามความมั่นใจ: ดำเนินการทันทีเมื่อความมั่นใจสูง, ตรวจสอบซ้ำเมื่อความมั่นใจระดับปานกลาง และส่งให้มนุษย์ตัดสินใจเมื่อความมั่นใจต่ำ วิธีนี้จะช่วยลดความผิดพลาดในระบบอัตโนมัติได้อย่างมีนัยสำคัญ
ราคา ความเร็ว และรายละเอียดของผลทดสอบ
Jev มีค่าบริการที่ถูกอย่างเหลือเชื่อเพียง $42 ต่อหนึ่งพันล้าน input token (หรือ $0.042 ต่อ 1 ล้าน token) ในขณะที่ LLM ทั่วไปมีราคาสูงกว่าหลายเท่าตัว จากการทดสอบของทีมงาน Jev ทำงานเสร็จในเวลาเพียง 0.114 วินาที ด้วยค่าใช้จ่ายเพียงเล็กน้อยเมื่อเทียบกับโมเดลขนาดใหญ่อย่าง GPT-5.6 Terra ที่ใช้เวลานานกว่าและแพงกว่ามาก
อย่างไรก็ตาม มีข้อควรระวังเกี่ยวกับตัวเลขเหล่านี้ เนื่องจากเป็นผลการทดสอบจาก workflow evals ของทาง TypeSafe เอง ซึ่งใช้ค่าเฉลี่ยจากโมเดลระดับสูงอย่าง GPT-6 Astra เป็นเกณฑ์อ้างอิง และยังไม่สามารถยืนยันได้ว่าราคาดังกล่าวมีการอุดหนุน (subsidized) หรือไม่
ส่วนคำว่า "Zero hallucinations" ในบริบทนี้หมายถึงการการันตีว่าผลลัพธ์จะเป็นไปตาม schema ที่กำหนด 100% แต่ไม่ได้หมายความว่าคำตัดสินใจจะถูกต้องเสมอไป ผู้ใช้งานยังคงต้องคำนึงถึงความผิดพลาดเชิงตรรกะที่อาจเกิดขึ้นได้
สิ่งที่นักพัฒนากำลังสร้างด้วย Jev
หลังการเปิดตัวเพียงไม่กี่วัน นักพัฒนาได้นำ Jev ไปประยุกต์ใช้ในหลากหลายโปรเจกต์ เช่น:
- ความปลอดภัยและประสิทธิภาพ: Guillermo Rauch CEO ของ Vercel พบว่า Jev เร็วกว่า GPT Luna ถึง 18 เท่าในการตรวจสอบความถูกต้องของคำสั่ง
- Browser & Phone agents: โปรเจกต์ jev-ultrafast ใช้ค้นหาเที่ยวบินได้ใน 7.1 วินาที และ mobile-jev ใช้สั่งการแอป Uber บน Android
- Agent Guardrails: jev-guard ใช้ตัดสินใจอนุญาตหรือปฏิเสธการเรียกใช้เครื่องมือของ AI agent
- การประยุกต์ใช้อื่นๆ: ตั้งแต่การให้คะแนนวิดีโอใน jevmeter, การควบคุมยามในเกม heist-one, ไปจนถึงการเพิ่มฟิลเตอร์ภาษาธรรมชาติให้ฐานข้อมูล Postgres ใน pg-jev
สรุปประเด็นสำคัญ
- Jev เน้นส่งคืนการตัดสินใจแบบระบุประเภท (Choice, Score, Noul) พร้อมค่าความน่าจะเป็น
- ค่าบริการ input token ราคาถูกมากและไม่คิดค่า output token
- ความเร็วในการตอบสนอง (latency) อยู่ในช่วง 70ms ถึง 500ms
- เหมาะสำหรับงานที่ต้องการความเร็วและการตัดสินใจที่แน่นอนมากกว่าการคุยโต้ตอบ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร