
5 เทคนิคบีบอัด Token และปรับแต่ง Prompt ให้ประหยัดและแม่นยำ
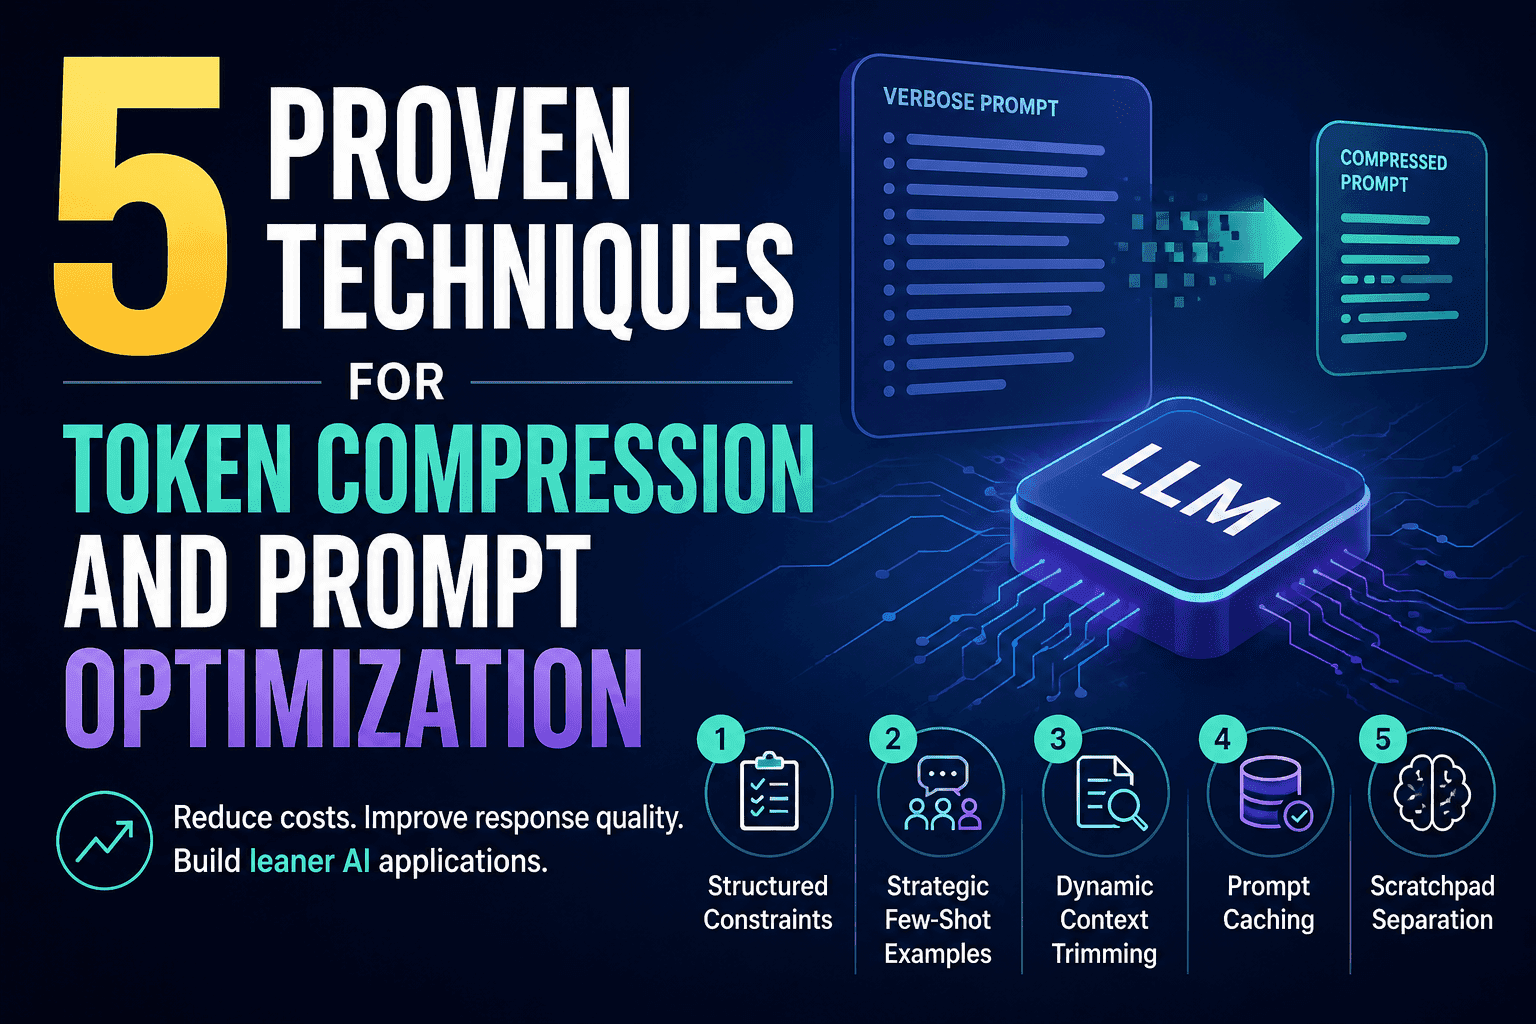
ทุกๆ Token มีความหมายเสมอ ไม่ว่าคุณจะสร้างแอปพลิเคชันสำหรับใช้งานจริงด้วย Large Language Models (LLMs) หรือรันการทดสอบใน Notebook ก็ตาม Prompt ที่พองตัวเกินจำเป็นจะค่อยๆ กัดกินงบประมาณและทำให้คุณภาพการตอบกลับลดลง การบีบอัด Token (Token compression) คือแนวทางในการส่งต่อเจตจำนง (intent) ให้มากขึ้นด้วย Token ที่น้อยลง และการปรับแต่ง Prompt (prompt optimization) คือวิธีที่คุณจัดโครงสร้างเพื่อให้ Model ตอบสนองได้อย่างแม่นยำ
คู่มือนี้ครอบคลุม 5 เทคนิคที่นำไปใช้ได้ทันทีเพื่อลดการใช้ Token โดยไม่เสียคุณภาพของผลลัพธ์ พร้อมเหตุผลเบื้องหลังและตัวอย่างโค้ดที่นำไปใช้งานได้จริง
1. การแทนที่คำสั่งที่เยิ่นเย้อด้วยข้อจำกัดแบบโครงสร้าง
System prompt ที่ยาวและมีลักษณะเหมือนการสนทนาอาจดูเป็นธรรมชาติ แต่อาจมีค่าใช้จ่ายสูงกว่ารูปแบบที่มีโครงสร้างรัดกุม วิธีแก้ไขคือการเปลี่ยนจากการบรรยายคำสั่งไปเป็นการระบุข้อจำกัดแบบประกาศ (declarative constraints) โดยใช้รูปแบบที่คล้ายกับ schema ซึ่ง Model สามารถประมวลผลได้อย่างมีประสิทธิภาพ แทนที่จะเขียนยาวๆ ว่า:
Please make sure that when you respond, you always use
bullet points and keep answers under 100 words. Do not
include any preamble or sign-off at the end of your reply.
คุณสามารถบีบอัดให้เหลือเพียง:
Format: bullet points | Max: 100 words | Omit: preamble, sign-offบรรทัดเดียวนี้ช่วยแทนที่ 36 Token ด้วย Token ประมาณ 14 ตัว เมื่อผ่านการเรียกใช้ API นับพันครั้ง การประหยัดนี้จะทวีคูณขึ้นอย่างรวดเร็ว แนะนำให้ใช้ key-value pairs ที่คั่นด้วย pipe หรือข้อจำกัดรูปแบบ YAML หรือ JSON schema snippets ตามความเหมาะสมของ Model ที่คุณใช้งาน
2. การใช้ตัวอย่าง Few-Shot อย่างมีกลยุทธ์ ไม่ใช่ใช้จนฟุ่มเฟือย
Few-shot prompting หรือการให้ตัวอย่างคู่ input-output ก่อนการร้องขอจริง ช่วยปรับปรุงความสม่ำเสมอของผลลัพธ์ได้มาก แต่ข้อผิดพลาดที่พบบ่อยคือการใส่ตัวอย่างมากเกินไป งานวิจัยจาก Anthropic และเกณฑ์มาตรฐานต่างๆ แสดงให้เห็นว่าผลตอบแทนจะเริ่มลดลงหลังจากใส่ตัวอย่างเกิน 3 ถึง 5 ตัวอย่างสำหรับงานส่วนใหญ่ นี่คือตัวอย่าง Prompt แบบ three-shot สำหรับการระบุอารมณ์ (sentiment labeling):
system = """Label sentiment. Reply with one word: Positive, Negative, or Neutral.
Examples:
Input: "Shipped on time and well packaged." -> Positive
Input: "Completely broken out of the box." -> Negative
Input: "It arrived." -> Neutral"""
ตัวอย่างเพียงสามตัวอย่างนั้นเพียงพอที่จะสร้างรูปแบบ การเพิ่มอีกสิบตัวอย่างไม่ค่อยช่วยเพิ่มความแม่นยำ และมักจะทำให้เกิดข้อขัดแย้งที่ทำให้ Model สับสน ให้ทดสอบคุณภาพที่ 1, 3 และ 5 ตัวอย่างก่อนตัดสินใจใช้ชุดตัวอย่างที่ใหญ่กว่า
3. การใช้ Dynamic Context Trimming สำหรับเอกสารยาว
เมื่อคุณใส่เอกสารยาวๆ เช่น บทสนทนาถอดความหรือเอกสารทางกฎหมาย คุณมักจะต้องจ่ายค่า Token ในส่วนที่ Model ไม่จำเป็นต้องใช้เสมอ Dynamic context trimming จะช่วยดึงมาเฉพาะส่วนที่เกี่ยวข้อง แทนที่จะส่งเอกสารทั้งหมด นี่คือตัวอย่างการทำงานโดยใช้ cosine similarity ร่วมกับ sentence embeddings:
from sentence_transformers import SentenceTransformer
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np

model = SentenceTransformer("all-MiniLM-L6-v2")

def trim_context(query, passages, top_k=3):
    q_emb = model.encode([query])
    p_embs = model.encode(passages)
    scores = cosine_similarity(q_emb, p_embs)[0]
    top_idx = np.argsort(scores)[-top_k:][::-1]
    return [passages[i] for i in top_idx]
การส่งเฉพาะเนื้อหาที่ผ่านการกรองแล้ว แทนการส่งเอกสารดิบที่มีเนื้อหาไม่เกี่ยวข้องจำนวนมาก สามารถลดค่าใช้จ่ายด้าน context ได้มากกว่า 90% ในบางกรณี
4. การทำ Caching สำหรับส่วนเริ่มต้นของ Prompt ที่ใช้ซ้ำด้วย Prompt Caching
แอปพลิเคชันส่วนใหญ่มักใช้ System prompt เดิมซ้ำๆ ในทุกการร้องขอ การส่ง Token เหล่านั้นใหม่ทุกครั้งจึงไม่จำเป็น ผู้ให้บริการหลายราย เช่น Anthropic พร้อมฟีเจอร์ prompt caching และ OpenAI พร้อมการทำ prefix caching อัตโนมัติ สามารถนำส่วนเริ่มต้นที่คงที่มาใช้ซ้ำได้ที่ฝั่ง server ในราคาที่ถูกกว่า ให้จัดโครงสร้าง Prompt โดยให้เนื้อหาที่คงที่อยู่ลำดับแรก:
[System prompt - static, 800 tokens]         <- ถูกเก็บใน Cache หลังการเรียกครั้งแรก
[Retrieved context - semi-static, 400 tokens] <- อาจถูกเก็บใน Cache
[User message - dynamic, 50 tokens]           <- ส่งใหม่เสมอ
การใช้ Prompt caching จะมีเงื่อนไขและเกณฑ์ Token ขั้นต่ำตามที่ผู้ให้บริการกำหนด ดังนั้นควรตรวจสอบเอกสารประกอบเพื่อประสิทธิภาพสูงสุด
5. การบีบอัดการให้เหตุผลแบบ Chain-of-Thought ด้วยการแยก Scratchpad
Chain-of-thought (CoT) prompting ช่วยปรับปรุงการให้เหตุผลในงานที่ซับซ้อน แต่การให้เหตุผลที่ยาวเหยียดมักจะปรากฏในคำตอบจาก API ซึ่งทำให้ค่า Token ของ output พุ่งสูงขึ้น วิธีแก้ไขคือการแยก scratchpad สำหรับการให้เหตุผลออกจากคำตอบสุดท้าย:
prompt = """Solve the problem step by step inside <thinking> tags.
Then provide only your final answer inside <answer> tags.

Problem: A warehouse ships 240 units over 6 days at an uneven rate.
Day 1-3 average: 30/day. What is the Day 4-6 average?"""
จากนั้นแอปพลิเคชันจะทำการดึงเฉพาะเนื้อหาใน <answer> มาแสดงผลและละทิ้งส่วน <thinking> สำหรับ API ที่รองรับโหมดการให้เหตุผลแบบขยาย เช่น extended thinking ของ Anthropic Token การให้เหตุผลอาจถูกเรียกเก็บเงินในอัตราที่ต่างกันและสามารถซ่อนจากการตอบกลับได้
เครื่องมือและแหล่งข้อมูลที่แนะนำ
- LangChain: มีเครื่องมือช่วยนับ Token และทำ Dynamic context trimming ผ่านระบบ RAG
- LiteLLM: อินเทอร์เฟซรวมสำหรับการติดตามการใช้งาน Token และต้นทุนจากหลายผู้ให้บริการ
- Sentence Transformers: โมเดล Embedding ประสิทธิภาพสูงสำหรับการดึงข้อมูลตามความหมาย
- tiktoken: Library สำหรับนับ Token ของ OpenAI ก่อนส่งเรียกใช้ API
- Anthropic Prompt Engineering Guide: คู่มือฟรีเกี่ยวกับ caching, structured outputs และแนวทางปฏิบัติของ CoT
บทสรุป
การบีบอัด Token คือเรื่องของความแม่นยำในการเขียน Prompt เพื่อให้สิ่งที่ Model ต้องการโดยไม่ฟุ่มเฟือย ทั้ง 5 เทคนิคนี้มุ่งเป้าไปที่การลด Token ในจุดที่พบบ่อยที่สุด เริ่มต้นด้วยการตรวจสอบ Prompt ที่คุณใช้บ่อยที่สุด และทดสอบการปรับแต่งทีละเล็กน้อย เมื่อการใช้งาน LLM ขยายตัว การประหยัดเพียงเล็กน้อยต่อการเรียกใช้จะเปลี่ยนเป็นการลดต้นทุนและเวลาตอบสนองที่เร็วขึ้นอย่างชัดเจน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร